Математические методы экономических исследований
Процесс (развитие) игры происходит в результате последовательного выполнения тех или иных ходов.
Стратегией игрока называется совокупность правил, по которым он анализирует ситуацию и делает ходы от начала игры до ее завершения.
Задание пары стратегий (А и В) (своей и противника) в парной игре полностью определяет ее исход, т.е. выигрыш одного и проигрыш другого (при случайных ходах определяются математические ожидания выигрыша и проигрыша).
Игра называется конечной, если у каждого игрока имеется лишь конечное число стратегий.
Результаты конечной парной игры с нулевой суммой (КПИНС), можно задать матрицей, строки и столбцы которой соответствуют различным стратегиям, а ее элементы есть соответствующие выигрыши одной стороны (равные проигрышам другой). Эта матрица называется платежной матрицей или матрицей игры. При этом удобно проигрыш первой стороны рассматривать как ее отрицательный выигрыш, а выигрыш второй - как ее отрицательный проигрыш.
Если первая сторона имеет m стратегий, а вторая – n, то имеем дело с игрой mґn.
Рассмотрим игру mґn со следующей матрицей:
| B1 | B2 | ... | Bj | ... | Bn | |
| A1 | a11 | a12 | ... | a1j | a1n | |
| A2 | a21 | a22 | ... | a2j | a2n | |
| ... | ... | ... | ... | ... | ... | ... |
| Ai | ai1 | ai2 | ... | aij | ain | |
| ... | ... | ... | ... | ... | ... | ... |
| Am | am1 | am2 | ... | amj | amn |
где Ai (i = 1, 2, ..., m) - стратегии первого игрока, Bj (j = 1, 2, ..., n) - стратегии второго игрока, аij - плата в сеансе игры со стратегиями Ai и Bj.
Если первый игрок применяет стратегию Аi, то другой будет стремиться к тому, чтобы выбором соответствующей стратегии свести выигрыш первого игрока к минимуму. Из "арсенала" - набора своих стратегий второй выбирает такую стратегию Вj, чтобы величина аij была бы минимальной, т.е. если i есть величина этого минимума, то:
 .
C точки зрения
первого игрока
(при любых ответах
противника)
целесообразно
стремиться
найти такую
стратегию, при
которой
i будет обращаться
в максимум.
Пусть этот
максимум равен
. Он называется
нижней ценой
игры. Так как
значение
вычисляется
по формуле:
 или
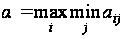 ,
то его называют
максимином.
Ему соответствует
максиминная
стратегия (их
может быть
несколько),
придерживаясь
которой первый
игрок при любых
стратегиях
противника
обеспечит себе
выигрыш, не
меньший чем
(в зависимости
от знака
это может быть
проигрыш, который
в этом случае
окажется
минимальным).
Аналогичным образом определяется минимальный проигрыш (который может быть в действительности и выигрышем) для второго игрока:
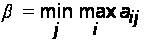 .
Величина называется верхней ценой игры или минимаксом. Ей соответствует минимаксная стратегия второго игрока.
Имеет место
неравенство:
 .
При < первый игрок может существенно увеличить свой средний выигрыш по сравнению с , если он будет пользоваться не чистой (одной единственной стратегией), а так называемой смешанной стратегией.
Смешанная стратегия С состоит в том, что при повторении игры происходит случайный выбор стратегий из некоторого множества смешиваемых стратегий и для каждой смешиваемой стратегии указывается вероятность ее выбора.
Известно, что для любой КПИНС существует пара оптимальных стратегий (вообще говоря смешанных).
Свойство оптимальности означает, что любое отступление одного из игроков от оптимальной стратегии (при условии, что второй игрок продолжает придерживаться своей оптимальной стратегии) при многократном повторении игры может только уменьшать его средний выигрыш (увеличить средний проигрыш).
Величина выигрыша (может быть, отрицательного) первого игрока при пользовании парой оптимальных стратегий называется ценой игры и обозначается .
Цена игры заключена между нижней и верхней ценой игры:
 .
Стратегии, которые смешиваются для получения оптимальной стратегии, будем называть полезными.
Решить игру - это значит найти пару оптимальных стратегий и цену игры. Решение игры обладает одним важным свойством: если один из игроков использует свою оптимальную стратегию, а другой смешивает свои полезные стратегии в любых пропорциях (не обязательно оптимальных), то средний выигрыш продолжает оставаться равным цене игры. При этом, правда, как при любых отступлениях от оптимальной стратегии, соответствующее изменение стратегии противником может привести к увеличению его среднего выигрыша.
Известно, что у игры mґn число полезных стратегий с каждой стороны не превосходит минимального из чисел m и n.
В области чистых
стратегий
решение может
быть получено
непосредственно.
Если же решение
нужно искать
в области смешанных
стратегий
 ,
то в общем случае
mґn
матрицы
 применяется
следующий
прием.
Считая все m
стратегий
первого игрока
полезными,
определяют
вероятность
их применения
в смешанной
оптимальной
стратегии (если
какая-то стратегия
в действительности
бесполезна,
то соответствующая
вероятность
обратится в
нуль). Пусть
искомые вероятности
обозначаются
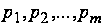 ,
а цена игры
(пока неизвестная)
- .
Так как при оптимальной стратегии средний выигрыш первого игрока не меньше при любой стратегии противника, то ищем n неравенств:
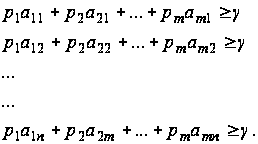
Вводим новые неизвестные:
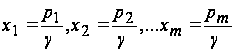 .
Чтобы исключить
деление на
нуль, можно
всегда добиться
 .
Для этой цели
достаточно
ко всем элементам
матрицы
прибавить одно
и тоже положительное
число с и все
ее элементы
сделать положительными.
Эта операция
увеличит цену
игры на с, но
не изменит
искомых оптимальных
стратегий.
Так как
 = 1, то
 .
Таким образом, имеем систему неравенств:
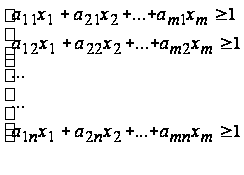 , (8.1)
где все
 .
Так как цель оптимальной стратегии – максимизация выигрыша, то при ее достижении линейная функция:
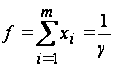
должна обратиться
в минимум. Итак,
оптимальная
стратегия
первого игрока
(т.е. набор вероятностей
 )
находятся в
результате
минимизации
функции:

при
,
удовлетворяющих
системе неравенств
(8.1).
Таким образом,
получили задачу
линейного
программирования.
Методы решения
таких задач
известны. В
результате
ее решения
находим не
только оптимальную
стратегию
первого игрока,
но и цену игры
 .
Зная цену игры,
оптимальную
стратегию (а1,
а2, ..., аn) второго
игрока можно
находить уже
без решения
задачи линейного
программирования
(хотя оптимальную
стратегию
второго игрока
можно находить
и через решение
этой задачи,
если поменять
игроков местами).
Для этого выбирается
n-1 полезных
стратегий
первого игрока
(имея возможность
менять местами
игроков можно
считать, что )
и для каждой
из них записывается
средний выигрыш,
который при
этом должен
быть обязательно
равен цене игры
.
Например, если
для первого
игрока полезна
стратегия Аi,
то ей соответствует
уравнение:
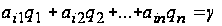 .
Кроме этого имеется еще одно уравнение:
 .
Всего имеем n уравнений для n величин q1, q2, ..., qn.
Игровые методы могут применяться для изучения ситуаций, которые не являются в строгом смысле слова конструктивными. Например, ситуации, где вторым игроком является природа.
Тема 9. Имитационное моделирование
1. Понятие имитационного моделирования.
2. Общая постановка задачи имитационного моделирования.
3. Метод Монте-Карло.
Краткое содержание темы
До сих пор рассматривались методы решения задач, в которых была известна цель (или несколько целей), достижение которой (которых) считалось желательным. Однако далеко не все ситуации таковы. Особенно ими изобилует современный этап прикладных исследований, когда приходится иметь дело со сложными системами, когда наличествует не только множество целевых функций, но далеко не все ясно с количественным выражением этих функций. В данном случае речь может идти не столько о решении тех или иных задач (хотя это присутствует и здесь), сколько об исследовании поведения сложных систем, о прогнозировании их будущих состояний в зависимости от выбираемых стратегий управления.
Итак, практике потребовался метод для исследования сложных систем, и такой метод появился - это имитационное моделирование ("simulation modeling").
Поскольку для сложных систем многие функции, параметры, характеристики носят случайный характер, то для оценки этих атрибутов, как правило, используется аппарат статистических оценок, а сам метод имитационного моделирования иногда называют методом статистических испытаний. Другими словами, это метод вероятностных оценок, а отсюда, по аналогии с игровыми ситуациями Монте-Карло, его также называют методом Монте-Карло.
Идея метода Монте-Карло чрезвычайно проста и состоит в следующем. Вместо того, чтобы описывать исследуемый процесс (как правило случайный) с помощью аналитического аппарата, производится "розыгрыш" процесса (явления) с помощью какой-либо процедуры, дающей случайный результат. Так же как и в реальности конкретное осуществление (реализация) случайного процесса складывается каждый раз по-разному, также и в результате статистического моделирования (розыгрыша) получаем каждый раз новую, отличную от других, искусственную реализацию процесса. Множество получаемых таким образом реализаций далее обрабатывается как статистический материал, и из него получаются нужные вероятностные характеристики требуемого результата.
При получении множества реализаций мы пользуемся случайностью как аппаратом исследования, заставляя случайность работать на себя.
Метод имитационного моделирования, как правило, используется для анализа функционирования сложных систем, когда возникают непреодолимые сложности при попытке построить "строгую" математическую модель изучаемого объекта, содержащего много связей между элементами, разнообразные нелинейные ограничения, огромное количество параметров и т.п. Иногда можно построить такую модель, но использовать ее из-за отсутствия математического аппарата не представляется возможным. В некоторых случаях для исследуемой системы не существует стройной теории, объясняющей все аспекты ее функционирования, а, следовательно, представляется затруднительным формулирование тех или иных правдоподобных гипотез ее поведения.
Далее, реальные системы, как правило, подвержены влиянию различных случайных факторов, учет которых аналитическим путем представляет порой непреодолимые трудности.
С другой стороны, использование математического аппарата дает возможность сопоставить модель и оригинал только в начале и после применения соответствующего аппарата, что затрудняет верификацию модели.
В основе метода имитационного моделирования лежит возможность максимального использования всей имеющейся в распоряжении исследователя информации о системе с тем, чтобы получить возможность преодолеть аналитические трудности и найти ответы на поставленные вопросы о поведении системы.
Имитационное моделирование, как правило, используется в сугубо практических целях.
Основными этапами метода являются:
1. Формулировка основных вопросов о поведении системы и задание параметров, характеризующих состояние системы, т.е. определение вектора состояния.
2. Декомпозиция (разбиение) системы на более простые части - блоки. В один блок объединяются "родственные", т.е. преобразующиеся по близким правилам, компоненты вектора состояния и процессы, их преобразую щие.
3. Формулируются правила и "правдоподобные" гипотезы относительно поведения системы в целом и ее отдельных частей. В каждом блоке может использоваться свой математический аппарат (алгебраические дифференциальные уравнения, математическое и динамическое программирование и т.п.). Именно это, т.е. блочный способ (принцип), дает возможность установить необходимые пропорции между точностью описания каждого блока, обеспеченностью его информацией и необходимостью достижения цели моделирования.
4. Вводится так называемое системное время, которое моделирует ход времени в реальной системе.
5. Формализованным образом задаются необходимые феноменологические свойства систем в целом и отдельных ее частей. (Часто эти свойства не могут быть обоснованы на современном уровне знаний, а опираются на опыт - длительное наблюдение за поведением системы). Иногда одно такое свойство оказывается эквивалентным множеству сложных математических соотношений и с успехом их заменяет, что, конечно, требует глубокого знания системы.
6. Случайным параметрам, фигурирующим в модели, сопоставляются некоторые их реализации, сохраняющиеся в течение одного или нескольких тактов системного времени. Далее отыскиваются новые реализации.
Как правило, пятый и шестой этапы наиболее просто осуществимы на ЭВМ, поэтому имитационные модели обычно реализуются с использованием специализированных программ, описывающих функционирование отдельных блоков и правила взаимодействия между ними.
Использование реализаций случайных величин требует многократного повторения экспериментов с моделью с последующим статистическим анализом полученных результатов.
Общая постановка задачи
Под имитационным
моделированием
будем понимать
пошаговое
моделирование
поведения
объекта с помощью
ЭВМ. Это означает,
что фиксируются
определенные
моменты времени
t1,t2,...,tn, и состояние
модели определяется
(вычисляется
на ЭВМ) последовательно
в каждом из
этих моментов
времени. Для
реализации
этого необходимо
задать правило
(алгоритм) перехода
модели из одного
состояния в
следующее, т.е.
преобразование:
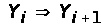 ,
где Yi - состояние
модели в i-й момент
времени.
Пусть, как обычно,
состояние
модели определяется
вектором:
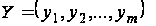 ,
т.е. m - числами,
состояние среды
вектором:
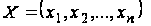 ,
n - числами, а
состояние
управления
вектором:
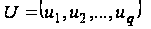 ,
q - числами.
Тогда имитационная
модель определяется
оператором
F, с помощью которого
можно определить
состояние
модели в последующий
момент времени,
т.е. определить
вектор Yi+1, зная
состояние
модели в предыдущий
момент времени
Yi и значения
Хi+1 и Ui+1, т.е.
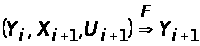 .
Таким образом, в имитационной модели состояние модели определяется рекуррентно на каждом шаге, исходя только из предыдущего шага. Этот алгоритм можно записать в виде рекуррентной формулы:
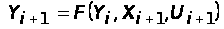 ,
где F - оператор имитаций изменения состояния модели. Он и определяет имитационную модель объекта.
Можно рассмотреть частный случай имитационной модели под воздействием окружающей среды в виде:
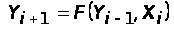 .
Но имитационное моделирование (или модели) тем и хорошо, что позволяет учитывать неконтролируемые факторы Е объекта, т.е. его стохастичность, в этом случае модель можно представить рекуррентным соотношением вида:
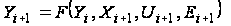 ,
i = 1,...,N, (9.1)
где необходимо знать, каким образом фактор Е влияет на состояние Y объекта, т.е. следует хорошо разобраться в объекте и указать точно, как входит неконтролируемый фактор Е в оператор объекта с тем, чтобы эти данные отразить в операторе F объекта. Для работы с такой моделью необходимо знать конкретные значения фактора E, который, как известно, ненаблюдаем. Возникает противоречие, которое решает так называемый метод Монте-Карло. Собственно, как правило, он и является основным методом имитации.
Для реализации метода Монте-Карло необходимо знать некоторые статистические свойства фактора Е (например, закон его распределения). Эти свойства, вообще говоря, могут зависеть от Y, X и U. Располагая этими сведениями, можно моделировать ненаблюдаемый фактор в виде случайных рядов:
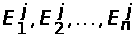 ,
j = 1, 2, ..., N,
где индекс
внизу соответствует
дискретному
времени, а верхний
номеру моделируемого
ряда (всего
моделируется
N таких статистически
эквивалентных
рядов). Естественно,
ни один из этих
рядов не является
точной реализацией
действительности,
но каждый имеет
такие же статистические
свойства, что
и реальный.
Именно поэтому
ряды
 позволяют
исследовать
статистические
свойства модели
(9.1).
Так поведение модели " в среднем" описывается как:
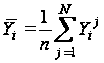 ,
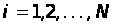 ,
где Yij - j-я реализация поведения модели в i-ый момент времени:
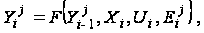 i=1,2,....,N.
Дисперсия выхода модели вычисляется по формуле:
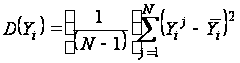 .
Таким образом, метод Монте-Карло позволяет оценить статистические свойства поведения объекта путем вероятностного "разыгрывания" поведения модели, причем одна реализация поведения отличается от другой различными значениями ненаблюдаемого фактора Е.
В сущности методом Монте-Карло может быть решена любая вероятностная задача, но оправданным он становится только тогда, когда процедура розыгрыша проще, а не сложнее аналитического расчета.
В задачах исследования операций метод Монте-Карло применяется в трех основных ролях:
1. Моделирование сложных, комплексных объектов и операций, где присутствует много взаимодействующих случайных факторов.
2. Проверка применимости более простых аналитических методов и выяснений условий их применимости.
3. В целях выработки поправок к аналитическим формулам "типа эмпирических формул" в технике.
Таким образом, этот метод является своеобразным ОТК математических методов. При этом статистические модели не требуют серьезных допущений и упрощений. В такую модель вписывается все, что угодно - любые законы распределения, любая сложность системы, множественность ее состояний.
Главный же недостаток таких моделей - их громоздкость и трудоемкость. Огромное число реализаций, необходимое для нахождения искомых параметров с приемлемой точностью, требует большого расхода машинного времени. Кроме этого, результаты такого моделирования труднее осмыслить, чем расчеты аналитическими методами и, соответственно, труднее оптимизировать решение (в основном, наощупь). Наиболее целесообразным является сочетание аналитических и имитационных методов. Как правило, аналитическими методами рассчитываются отдельные элементы и блоки сложной системы, а затем, как из "кирпичиков", строится большая сложная имитационная модель.
Основным элементом, из совокупности которых складывается статистическая модель, является одна случайная реализация моделируемого явления.
Реализация - это как бы один экземпляр случайного явления со всеми присущими ему случайностями. Этим реализации отличаются одна от другой. Отдельная реализация разыгрывается с помощью специально разработанной процедуры (алгоритма), в которой основную роль играет "жребий" или, как говорят, "бросание жребия". Каждый раз, когда в ход явления вмешивается случай, его влияние учитывается не расчетом, а жребием.
Понятие "жребия". Пусть в ходе процесса наступил момент, когда его дальнейшее развитие (а значит и результат) зависит от того, произошло или нет какое-то событие А.
Тогда нужно "бросанием жребия" решить вопрос: произошло событие или нет? Как можно осуществить этот жребий? Необходимо привести в действие какой-либо механизм случайного выбора.
Если жребий бросается для того, чтобы узнать, произошло ли событие А, его нужно организовать так, чтобы условный результат розыгрыша имел ту же вероятность, что и событие А.
Кроме случайных событий на ход и исход операции могут влиять различные случайные величины.
С помощью жребия можно разыграть как значение любой случайной величины, так и совокупности значений нескольких величин.
Условимся называть "единичным жребием" любой опыт со случайным исходом, который отвечает на один из следующих вопросов:
1. Произошло или нет событие А?
2. Какое из событий А1, А2, ..., Аk произошло?
3. Какое значение приняла случайная величина Х?
4. Какую совокупность значений приняла система случайных величин Х1, Х2, ..., Хk?
Любая реализация случайного явления методом Монте-Карло строится из цепочки единичных жребиев, перемежающихся с обычными расчетами. Ими учитывается влияние исхода жребия на дальнейший ход событий (в частности на условия, в которых будет разыгран следующий жребий).
Единичный жребий может быть разыгран разными способами, но есть один стандартный механизм, с помощью которого можно осуществить любую разновидность жребия. А именно, для каждой из них достаточно уметь получать случайное число R, все значения которого от 0 до 1 равновероятны (т.е. обладают одинаковой плотностью вероятности).
Условно назовем величиной R "случайное число от 0 до 1". С помощью такого числа можно разыграть любой из четырех видов единичного жребия.
Тема 10. Методы теории массового обслуживания
1. Основные понятия теории массового обслуживания.
2. Постановка задачи теории очередей.
3. Подходы решения задач теории очередей.
Краткое содержание темы
Практическая деятельность человека тесно связана с различного рода системами массового обслуживания. В области экономики - это банковское обслуживание, пользование объектами торговли и услугами сферы обслуживания и многие другие виды экономической деятельности.
Любая система массового обслуживания может включать в себя следующие элементы:
Входящий поток требований или заявок на обслуживание. Этот элемент является основным. Изучение входящего потока требований и его описание необходимо при организации любой системы массового обслуживания.
Очередь. В тех случаях, когда поступающие в систему массового обслуживания требования не могут быть удовлетворены немедленно, возникает очередь. В такой ситуации интерес может представлять длина этой очереди, порядок, по которому ожидающие требования направляются на обслуживание (как говорят, дисциплина очереди), время ожидания.
В отдельных случаях систем массового обслуживания очереди не допускаются, т.е. требование, заставшее систему занятой, не обслуживается (получает отказ).
Обслуживающее устройство. Этот элемент присутствует в любой системе массового обслуживания. От характеристик и параметров, способов организации обслуживающего устройства зависят не только время, необходимое на обслуживание одного требования, но и длина очереди и время ожидания.
Выходящий поток обслуженных требований. Этот элемент может оказаться очень важным в тех случаях, когда выходящий поток обслуженных требований является входящим для другой системы массового обслуживания.
Как правило, число требований на входе системы массового обслуживания за какой-либо промежуток времени и время обслуживания одного требования являются случайными величинами. Функционирование системы массового обслуживания в таком случае представляет собой случайный процесс, и методы исследования таких систем используют имитационное моделирование. Однако понять сущность задач и методов теории массового обслуживания можно на примерах детерминированных моделей систем массового обслуживания и прежде всего моделей теории очередей.
Основными компонентами модели очереди являются:
описание входящего потока требований;
описание способа, которым выполняется обслуживание (т.е. описание дисциплины обслуживания);
описание дисциплины очереди (т.е. каким образом из очереди выбираются клиенты на обслуживание: “первый пришел - первый обслужен”, “последний пришел - первый обслужен”, “по указанным приоритетам” и т.п.).
При конструировании модели очереди первоочередной задачей является символическое представление основных компонент, после чего изучаются соотношения между ними.
Принципиальными характеристиками очереди являются:
длина очереди в различные моменты времени;
общая продолжительность нахождения требования в системе обслуживания (т.е. время, потраченное на ожидание в очереди, плюс собственное время обслуживания);
время, в течение которого обслуживающее устройство было свободно.
Основной целью исследования систем массового обслуживания является установление равновесия между допустимыми нагрузками обслуживающего устройства, ограниченной пропускной способностью системы и раздражением клиента, с одной стороны, и допустимой стоимостью обслуживающих точек, с другой.
Рассмотрим систему массового обслуживания, имеющую один источник требований, проходящих через единственное обслуживающее устройство. Пусть имеют место следующие предположения:
1. Требования поступают через одинаковые интервалы времени. Каждый интервал имеет длину a единиц.
2. Требования обслуживаются за одинаковые интервалы времени, каждый интервал имеет длину b единиц. При этом, как только закончится обслуживание одного требования, обслуживающее устройство готово к обслуживанию следующего требования.
3. Дисциплина очереди устанавливается по правилу “Первый пришел - первый обслуживается”. Другими словами, ожидающие требования образуют очередь, и, когда обслуживающее устройство освободится, на обслуживание поступает требование, имеющее большее время ожидания.
Определим длину очереди как общее число требований, находящихся на обслуживании и ожидающих в очереди. Представим сформулированную задачу в виде следующей схемы:
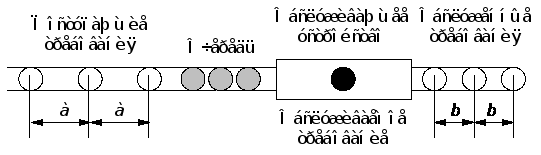
Поведение системы зависит от того, как связаны между собой величины a и b. Возможны три случая: 1) b > a; 2) b = a; 3) b < a. Рассмотрим каждый из этих случаев.
1) Случай b > a. Это значит, что скорость обслуживания 1/b меньше, чем скорость поступления требований 1/a, т.е. требования обслуживаются и покидают систему медленнее, чем прибывают. Следовательно, в этом случае будет образовываться очередь и она будет постоянно возрастать.
2) Случай b = a. Если в очереди нет требований, то первое поступившее требование сразу начнет обслуживаться. Его обслуживание закончится в тот же самый момент, в который поступит на обслуживание следующее требование. Следовательно, требований, ожидающих обслуживания, не будет.
Если же первоначально имеется очередь, то ее длина будет оставаться постоянной.
3) Случай b < a. Это значит, что скорость обслуживания больше, чем скорость поступления требований. Следовательно, какое бы ни было начальное число ожидающих обслуживания требований, длина очереди будет сокращаться до 1 или 0.
Пусть в начале процесса число требований в очереди r і 2 (если первоначально есть только одно требование (r =