Решение задач с нормальными законами в системе "Статистика"
Результаты
расчета представляются
в виде векторов
столбцов :
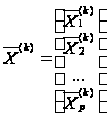
3. Для каждого обучающего подмножества рассчитываются ковариационные матрицы S(k) (размером pЧp):
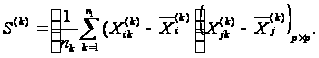
4. Рассчитывается
объединенная
ковариационная
матрица
 по
формуле:
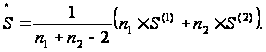
5. Рассчитывается
матрица
 обратная
к объединенной
ковариационной
матрице
 :
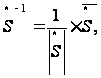
где ||—
определитель
матрицы
,
(причем ),
- присоединенная
матрица, элементы
которой являются
алгебраическими
дополнениями
элементов
матрицы
.
6. Рассчитывается
вектор-столбец
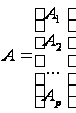 дискриминантных
множителей
с учетом всех
элементов
обучающих
подмножеств
по формуле:
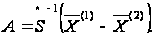
Данная расчетная формула получена с помощью метода наименьших квадратов из условия обеспечения наибольшего различия между дискриминантными функциями. Наилучшее разделение двух обучающих подмножеств обеспечивается сочетанием минимальной внутригрупповой вариации и максимальной межгрупповой вариации.
7. По каждому i-му объекту (i = 1, 2, ..., N) множества М определяется соответствующее значение дискриминантной функции:
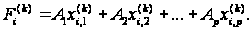
8. По совокупности найденных значений F(k) рассчитываются средние значения для каждого подмножества Mk:
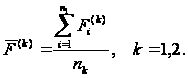
9. Определяется общее среднее (константа дискриминации) для дискриминантных функций
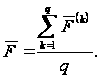
10. Выполняется распределение (дискриминация) объектов подмножества М0 подлежащих дискриминации по обучающим выборкам М1 и М2. С этой целью рассчитанные и п. 7 по каждому i-му объекту значения дискриминантных функций
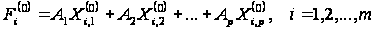
сравниваются
с величиной
 общего
среднего. На
основе сравнения
данный объект
относят к одному
из обучающих
подмножеств.
Если
 ,
то i-й объект
подмножества
М0 относят
к подмножеству
М1, при
 >0
и к подмножеству
М2 при
<0.
Если же
 <
 ,
то заданный
объект относят
к подмножеству
М1, при
<
0 и к подмножеству
М2 в противном
случае.
11. Далее делается оценка качества распределения новых объектов, для чего оценивается вклад переменных в дискриминантную функцию.
Влияние признаков на значение дискриминантной функции и результаты классификации может оцениваться по дискриминантным множителям (коэффициентам дискриминации), по дискриминантным нагрузкам признаков или по дискриминантной матрице.
Дискриминантные множители зависят от масштабов единиц измерения признаков, поэтому они не всегда удобны для оценки.
Дискриминантные нагрузки более надежны в оценке признаков, они вычисляются как парные линейные коэффициенты корреляции между рассчитанными уровнями дискриминантной функции F и признаками, взятыми для ее построения.
Дискриминантная матрица характеризует меру соответствия результатов классификации фактическому распределению объектов по подмножествам и используется для оценки качества анализа. В этом случае дискриминантная функция F формируется по данным объектов (с измеренными p признаками) обучающих подмножеств, а затем проверяется качество этой функции путем сопоставления фактической классовой принадлежности объектов с той, что получена в результате формальной дискриминации.
ПРИМЕРЫ ДИСКРИМИНАНТНОГО АНАЛИЗА3.1 Применение дискриминантного анализа при наличии двух обучающих выборок (q=2)
Имеются данные по двум группам промышленных предприятий отрасли: Х1 - среднегодовая стоимость основных производственных фондов, млн. д.ед.; Х2 — среднесписочная численность персонала, тыс. чел.; Х3 — балансовая прибыль млн. д.ед.
Исходные данные представлены в таблице 2.
Таблица 2
| Номер группы Mk (k =1, 2) |
Номер предприятия, i (i = 1, 2, ..., nk) |
Свойства (показатель), j (j = 1, 2, ..., p) |
||
| Х1 | Х2 | Х3 | ||
|
Группа 1, M1 (k = 1) |
1 | 224,228 | 17,115 | 22,981 |
| 2 | 151,827 | 14,904 | 21,481 | |
| 3 | 147,313 | 13,627 | 28,669 | |
| 4 | 152,253 | 10,545 | 10,199 | |
|
Группа 2, M2 (k = 2) |
1 | 46,757 | 4,428 | 11,124 |
| 2 | 29,033 | 5,51 | 6,091 | |
| 3 | 52,134 | 4,214 | 11,842 | |
| 4 | 37,05 | 5,527 | 11,873 | |
| 5 | 63,979 | 4,211 | 12,860 | |
| Группа предприятий M0, подлежащих дискриминации | 1 | 55,451 | 9,592 | 12,840 |
| 2 | 78,575 | 11,727 | 15,535 | |
| 3 | 98,353 | 17,572 | 20,458 | |
Необходимо провести классификацию (дискриминацию) трех новых предприятий, образующих группу М0 с известными значениями исходных переменных.
Решение:
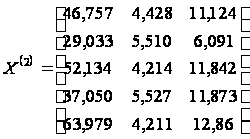
1. Значения исходных переменных для обучающих подмножеств M1 и M2 (групп предприятий) записываются в виде матриц X(1) и X(2) :
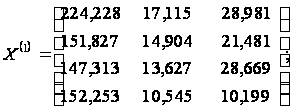
и для подмножества M0 группы предприятий, подлежащих классификации в виде матрицы X(0):
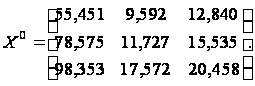
Общее количество предприятий, составляющих множество М, будет равно N = 3+4+5 = 12 ед.
2. Определяются
элементы векторов
 средних
значений по
j признакам
для i-х объектов
по каждой k-й
выборке (k = 1, 2),
которые представляются
в виде двух
векторов
 (по
количеству
обучающих
выборок):
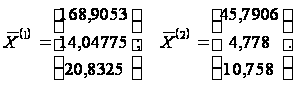
3. Для каждого обучающего подмножества M1 и M2 рассчитываются ковариационные матрицы Sk (размером рЧр):
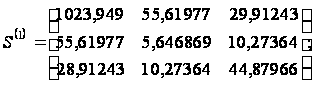
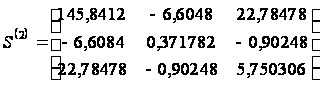
4. Рассчитывается объединенная ковариационная матрица:
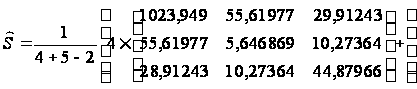
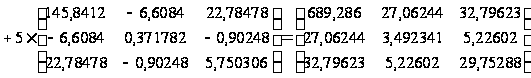
5. Рассчитывается
матрица
 обратная
к объединенной
ковариационной
матрице:
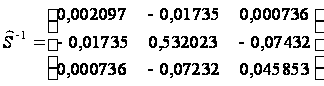
6. Рассчитываются дискриминантные множители (коэффициенты дискриминантной функции) по всем элементам обучающих подмножеств:
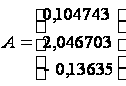
7. Для каждого i-го объекта k-го подмножества М определяется значение дискриминантной функции:
F1(1)=0,104743Ч224,228+2,046703Ч17,115+(-0,13635)Ч22,981=55,38211;
F2(1)=0,104743Ч151,827+2,046703Ч14,904+(-0,13635)Ч21,481=43,47791;
F3(1)=0,104743Ч147,313+2,046703Ч13,627+(-0,13635)Ч28,669=39,41138;
F4(2)=0,104743Ч152,253+2,046703Ч10,545+(-0,13635)Ч10,199=36,13924;
F1(2)=0,104743Ч46,757+2,046703Ч4,428+(-0,13635)Ч11,124=12,44351;
………………………………………………………………………………..
F5(2)=0,104743Ч63,979+2,046703Ч4,211+(-0,13635)Ч12,860=13,56655.
8. По совокупности
найденных
значений F(k)
рассчитываются
средние значения
 для
каждого подмножества
Mk:
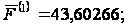
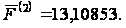
9. Определяется общее среднее (константа дискриминации) для дискриминантных функций:
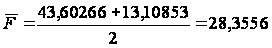
10. Выполняется распределение объектов подмножества М0 по обучающим подмножествам М1 и М2, для чего по каждому объекту (i = 1, 2, 3) рассчитываются дискриминантные функции:
F1(0)=0,104743Ч55,451+2,046703Ч9,592+(-0,13635)Ч12,840=23,68661
F2(0)=0,104743Ч78,575+2,046703Ч11,727+(-0,13635)Ч15,535=30,11366
F3(0)=0,104743Ч98,353+2,046703Ч17,572+(-0,13635)Ч20,458=23,68661
Затем рассчитанные значения дискриминантных функций F(0) сравниваются с общей средней F=28,3556.
Поскольку
 ,
то i-й объект
подмножества
М0 относят
к подмножеству
М1 при
 >
0 и к подмножеству
М2 при
<0.
С учетом этого
в данном примере
предприятия
2 и 3 подмножества
М0 относятся
к М1, а предприятие
1 относится к
М2.
Если бы выполнялось
условие
,
то объекты М0
относились
к подмножеству
М1, при
 и к подмножеству
М2 в противном
случае.
11. Оценку качества
распределения
новых объектов
выполним путем
сравнения с
константой
дискриминации
F значений
дискриминантных
функций Fi(k)=обучающих
подмножеств
М1 и М2.
Поскольку для
всех найденных
значений выполняются
неравенства ,
и
 ,
то можно предположить
о правильном
распределении
объектов и уже
существующих
двух классах
и верно выполненной
классификации
объектов подмножества
М0.
3.2 Пример решения задачи дискриминантным анализом в системе STATISTICA
Исходя из данных по 10 странам (рис. 3.1), которые были выбраны и отнесены к соответствующим группам экспертным методом (по уровню медицинского обслуживания), необходимо по ряду показателей классифицировать еще две страны: Молдавия и Украина.
Исходными показателями послужили:
Х1 – Количество человек, приходящихся на одного врача;
Х2 – Смертность на 1000 человек;
Х3 – ВВП, рассчитанный по паритету покупательной способности на душу населения (млн. $);
Х4 – Расходы на здравоохранение на душу населения ($).
Уровень медицинского обслуживания стран подразделяется на:
- высокий;
- средний (удовлетворительный);
- низкий.
|
Кол-во чел. на 1 врача |
Расх. на здрав. |
ВВП |
Смертность |
Класс |
|
|
Азербайджан |
256 | 99 | 3000 | 9,6 | низкий |
|
Армения |
198 | 152 | 3000 | 9,7 | низкий |
|
Белоруссия |
222 | 157 | 7500 | 14 | высокий |
|
Грузия |
182 | 152 | 4600 | 14,6 | удовлетворительный |
|
Казахстан |
265 | 154 | 5000 | 10,6 | удовлетворительный |
|
Киргизия |
301 | 118 | 2700 | 9,1 | низкий |
|
Россия |
235 | 159 | 7700 | 13,9 | высокий |
|
Таджикистан |
439 | 100 | 1140 | 8,6 | низкий |
|
Туркмения |
320 | 125 | 4300 | 9 | удовлетворительный |
|
Узбекистан |
299 | 116 | 2400 | 8 | низкий |
Рис. 3.1
Используя вкладку анализ, далее многомерный разведочный анализ, необходимо выбрать дискриминантный анализ. На экране появится панель модуля дискриминантный анализ, в котором вкладка переменные позволяет выбрать группирующую и независимые переменные. В данном случае группирующая переменная 5 (класс), а независимыми переменными выступят 1-4 (кол-во человек на 1 врача; расходы на здравоохранение; ВВП на душу населения; смертность).
В ходе вычислений системой получены результаты:
Вывод результатов показывает:
- число переменных в модели – 4;
- значение лямбды Уилкса – 0,0086739;
- приближенное значение F – статистики, связанной с лямбдой Уилкса – 9,737242;
- уровень значимости F – критерия для значения 9,737242.
Значение статистики Уилкса лежит в интервале [0,1]. Значения статистики Уилкса, лежащие около 0, свидетельствуют о хорошей дискриминации, а значения, лежащие около 1, свидетельствуют о плохой дискриминации. По данным показателя значение лямбды Уилкса, равного 0,0086739 и по значению F – критерия равного 9,737242, можно сделать вывод, что данная классификация корректная.
В качестве проверки корректности обучающих выборок необходимо посмотреть результаты матрицы классификации (рис. 3.2).
| Матрица классификации . Строки: наблюдаемые классы Столбцы: предсказанные классы | ||||
|
Процент |
низкий |
высокий |
удовлетв |
|
|
низкий |
100,0000 | 5 | 0 | 0 |
|
высокий |
100,0000 | 0 | 2 | 0 |
|
удовлетв |
100,0000 | 0 | 0 | 3 |
|
Всего |
100,0000 | 5 | 2 | 3 |
Рис. 3.2
Из матрицы классификации можно сделать вывод, что объекты были правильно отнесены экспертным способом к выделенным группам. Если есть объекты, неправильно отнесенные к соответствующим группам, можно посмотреть классификацию наблюдений (рис.3.3).
| Классификация наблюдений. Неправильные классификации отмечены * | ||||
|
Наблюд. |
1 |
2 |
3 |
|
|
Азербайджан |
низкий | низкий | удовлетв | высокий |
|
Армения |
низкий | низкий | удовлетв | высокий |
|
Белоруссия |
высокий | высокий | низкий | удовлетв |
|
Грузия |
удовлетв | удовлетв | низкий | высокий |
|
Казахстан |
удовлетв | удовлетв | низкий | высокий |
|
Киргизия |
низкий | низкий | удовлетв | высокий |
|
Россия |
высокий | высокий | низкий | удовлетв |
|
Таджикистан |
низкий | низкий | удовлетв | высокий |
|
Туркмения |
удовлетв | удовлетв | низкий | высокий |
|
Узбекистан |
низкий | низкий | удовлетв | высокий |
Рис. 3.3
В таблице классификации наблюдений, некорректно отнесенные объекты помечаются звездочкой (*). Таким образом, задача получения корректных обучающих выборок состоит в том, чтобы исключить из обучающих выборок те объекты, которые по своим показателям не соответствуют большинству объектов, образующих однородную группу.
В результате проведенного анализа общий коэффициент корректности обучающих выборок должен быть равен 100% (рис. 3.2).
На основе полученных обучающих выборок можно проводить повторную классификацию тех объектов, которые не попали в обучающие выборки, и любых других объектов, подлежащих группировке.
Для этого необходимо в окне диалогового окна результаты анализа дискриминантных функций нажать кнопку функции классификации. Появится окно (рис. 3.4), из которого можно выписать классификационные функции для каждого класса.
| Функции классификации | |||
|
низкий |
высокий |
удовлетв |
|
|
Кол-во чел на 1 врача |
1,455 | 2,35 | 1,834 |
|
Расх на здрав |
1,455 | 1,98 | 1,718 |
|
ВВП |
0,116 | 0,20 | 0,153 |
|
Смертность |
29,066 | 46,93 | 36,637 |
|
Конст-та |
-576,414 | -1526,02 | -921,497 |
Рис. 3.4
Таблица 3
Классификационные функции для каждого класса
| Низкий класс | = -576,414+1,455*кол-во чел на 1 врача+1,455*расх на здра+0,116*ВВП+29,066*смертность |
| Высокий класс | =-1526,02+2,35*кол-во чел на 1 врача+1,98*расх на здрав+0,20*ВВП+46,93*смертность |
| Удовлетворительный класс | =-921,497+1,834*кол-во чел на 1 врача+1,718*расх на здра+0,153*ВВП+36,637*смертность |
С помощью этих функций можно будет в дальнейшем классифицировать новые случаи. Новые случаи будут относиться к тому классу, для которого классифицированное значение будет максимальное.
Необходимо определить принадлежность стран Молдавия и Украина, подставив значения соответствующих показателей в формулы (Таблица 4).
Таблица 4
| Страна | Кол-во человек на 1 врача | Расходы на здравоохранение | ВВП на душу населения | Смертность | Высокий | Низкий | Удовлетворительный | Класс |
| Молдавия | 251 | 143 | 2500 | 12,6 | 438,29 |
653,09 |
628,64 | Низкий |
| Украина | 224 | 131 | 3850 | 16,4 | 880,23 | 863,39 |
904,27 |
Удовл. |
ЗАКЛЮЧЕНИЕ
В данной курсовой работе был рассмотрен такой метод многомерного статистического анализа как дискриминантный. В дискриминантном анализе изучены: основные понятия, цели и задачи дискриминантного анализа. А также определение числа и вида дискриминирующих функций, и классификация объектов с помощью функции расстояния.
Для данного метода приведены примеры решения задач с использованием ППП STATISTICA.
СПИСОК ИСПОЛЬЗОВАННЫХ ИСТОЧНИКОВ
1. Баранова, Т.А. Многомерные статистические методы. Корреляционный анализ. [Текст]: Метод. указания / Иван. гос. хим.-технол. ун-т. / Т.А. Баранова. – Иваново, 9 - 40 с.
2. Буреева, Н.Н. Многомерный статистический анализ с использованием ППП “STATISTICA” [Текст] / Н.Н. Буреева. - Нижний Новгород, 2007. -112с.
3. Дубров, А.М. Многомерные статистические методы и основы эконометрики. [Текст]: Учебное пособие / А.М. Дубров. - М.: МЭСИ, 2008.- 79 с.
4. Калинина, В.Н. Введение в многомерный статистический анализ [Текст]: Учебное пособие / В.Н. Калинина.- ГУУ. – М., 2010. – 66 с.