Цифровая модель местности и ее использование в современных геоинформационных системах
Существует возможность простого преобразования таблицы подобной структуры в «традиционный» вариант. Для этого достаточно в названии или комментарии к полям «классической» таблицы указывать иерархический классификатор данных (HDC) (рис. 4).
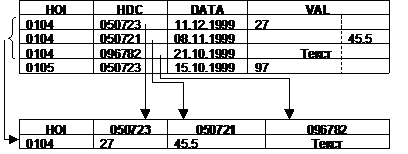
Рис. 4.
Сама возможность таких преобразований данных чрезвычайно важна, поскольку позволяет использовать стандартные, традиционные методы построения форм и отчетов, базирующихся именно на «классическом» представлении данных. В то же время благодаря обменному формату открывается возможность унифицированного межотраслевого обмена любыми данными.
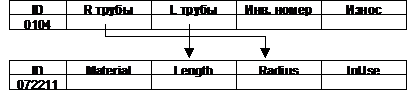
Ранее уже упоминалась проблема «восприятия» разными службами и отраслями одного и того же объекта. Каждая из служб отстраивает свою модель объекта, несущую только те характеристики и атрибутивные данные, которые необходимы для решения специализированных, отраслевых задач. Однако проблема заключается не в разнообразии возникающих моделей, а в том, что ряд характеристик объекта дублируется в различных отраслевых базах. Более того, различные отрасли для одних и тех же объектов применяют различные способы классификации и кодирования информации. Таким образом, проблема сводится к тому, каким образом осуществить обмен смежными характеристиками объекта, если имеются две различные базы данных, между которыми необходимо совершить частичную репликацию информации так, как показано на рис. 5.
|
|
Рис. 5.
Ответить на поставленный вопрос достаточно просто, если использовать обменные базы данных. Экспортируя информацию из первой таблицы в обменную, можно простым импортом из обменной таблицы заполнить вторую базу необходимыми данными. Непременным условием такого обмена информацией является одинаковая классификация типов данных. Таким образом, мы приходим к тому, что для успешного обмена межотраслевой информацией необходима одинаковая классификация типов данных. Наличие единого классификатора типов данных не является с практической точки зрения серьезным ограничением, особенно в силу того, что такого рода классификатор должен иметь иерархическую структуру. Всегда существует возможность кроме введения различных общих типов данных, например, геометрических характеристик объектов, вводить в этот классификатор специализированные отраслевые ветви, не нарушая при этом целостности системы.
Следует заметить, что если межотраслевой классификатор типов данных является вполне приемлемым решением, то с объектным классификатором возникают серьезные проблемы. Каждая отрасль производит свое деление объектов на группы и подгруппы, а как следствие – проводит свою «политику» индексации (кодирования) объектов. В результате этого два различных кода могут описывать один и тот же объект (пример показан на рис. 5, кода с точки зрения одной отрасли объект идентифицируется как 0104, а с точки зрения другой как 072211). Естественно, что для того чтобы произвести обмен данными между этими таблицами, необходимо, чтобы система импорта-экспорта могла выполнять переиндексацию информации, то есть необходимо определенным способом «уравнять» различные варианты индексации одного и того же объекта.
Для решения проблемы достаточно завести таблицу уравнивания объектов, которая содержала бы всего две колонки, в первой из которых был бы первый идентификатор объекта, а во второй – второй идентификатор. Такая таблица позволила бы в случае операции импорта из обменной таблицы производить межотраслевой обмен информации. Необходимым условием индексации объектов в этом случае является уникальность отраслевых идентификаторов объектов. Этого несложно добиться, вводя в первых разрядах идентификатора объекта код отрасли.
Однако построение таблицы уравнивания объектов приводит к проблеме, связанной с необходимостью выполнения условия транзитивности. Если [код А] = [код B], а [код B] = [код C], отсюда следует, что [код А] = [код С]. Вне сомнения, поиск всевозможных транзитивных пар кодов объектов вызовет существенные проблемы при интерпретации содержимого таблиц. Решением проблемы является введение в систему некоторого системного кода, посредством которого и происходит уравнивание объектов. В этом случае в первой колонке таблицы уравнивания содержится отраслевой код объекта, во второй – его системный идентификатор. При этом у всех отраслевых «ипостасей» объекта системный идентификатор общий. Если мы производим уравнивание объектов двух отраслей впервые, то при вставке их идентификаторов в таблицу уравнивания генерируется любое произвольное уникальное число – системный ключ. Если код одного из объектов уже присутствует в базе данных, то вновь добавляемому объекту присваивается уже существующий системный идентификатор. Это простое правило позволяет полностью избежать возможных коллизий, поскольку выбор системного ключа произволен и его можно изменять и регенерировать в любой момент. Несложно также представить объединение нескольких таблиц уравнивания в единую таблицу.
Следует отметить, что если отраслевые классификаторы типов данных велись изолировано и как следствие одна и та же характеристика имеет разные коды в разных областях, можно ввести таблицу уравнивания и для классификационных кодов типов данных. Однако это решение не является лучшим, поскольку в дальнейшем будет показано, как именно межотраслевая таблица классификаторов данных может быть использована для разрешения проблемы параллелизма информации.
Таким образом, обменная таблица и таблица уравнивания объектов, а в худшем случае и таблица уравнивания типов данных, могут являться основой обмена и интеграции информации между любыми отраслями; более того, они являются уникальным способом разрешения коллизий, порожденных несовершенством способов ведения хозяйственной деятельности и существующей системой межотраслевого документооборота.
Представление пространственной модели в рамках реляционной СУБД
Последняя проблема, решение которой приводит нас к возможности реализации полноценной цифровой модели местности, заключается в способе приведения топологической пространственной модели местности к предлагаемой выше структуре баз данных. Основой формирования любой карты являются точки. Но что такое точки в контексте проведенной выше формализации? Точки создают топографы, геодезисты, которые представляют отрасль, по сути дела, вводящую в единую цифровую модель местности новые объекты. Эти объекты имеют свои отраслевые идентификаторы и, естественно, свойства, которые выражаются координатами X, Y, Z. Геометрические характеристики точки, конечно же, являются типами данных, которые, в свою очередь, имеют классификационный код. Таким образом, цифровая модель местности фактически поглощает точки как совершенно обычные объекты. Более того, зачастую нет необходимости вводить объекты-точки, а можно сразу назначить свойства X, Y и Z для любого объекта, например трубы, моста, столба и т.д. Механизмы синхронизации, которые детально обсуждались выше, позволят избежать дублирования или недостоверности информации внутри базы данных, содержащей модель местности. Можно даже предусмотреть механизм приоритетов в случае, если, например, координата X появилась у объекта дважды со стороны разных служб. Если различным службам назначить коды, которые появляются как в идентификаторе объекта, так и в идентификаторе типа данных, то координаты объекта разумно ввести как тип данных, принадлежащих, например, геодезической службе. Если какая-либо другая организация продублирует координату в своей базе с ошибкой, то выбор правильных данных допустимо произвести автоматически, следуя правилу, что наиболее достоверные данные поставляет та служба, код которой в идентификаторе объекта и идентификаторе класса данных совпадает. Это автоматически позволит избежать возникающего параллелизма в сборе информации.
Однако конечная цель – ввод в таблицы, хранящие информацию о цифровой модели местности, топологической пространственной структуры. В этом случае точки являются только средством построения межобъектных границ. Сами границы, в свою очередь, являются атрибутами объектов. В этом случае границу можно также интерпретировать как объект, свойствами которого являются идентификаторы точек.
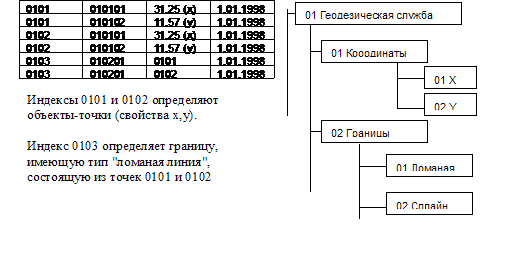
Рис. 6.
Подобная структура базы позволяет вводить любые виды границ, в том числе использовать в качестве границ трехмерные поверхности. При этом программное обеспечение, «не воспринимающее» Z-координату, будет отстраивать обычную двумерную карту, но в то же время допустимо строить и трехмерные модели. Кроме того, для точки или границы можно ввести дополнительную атрибутику, тем самым дополняя карту элементами картины (например, нечеткие границы). Аналогичным образом можно ввести в модель местности ссылки объектов на их пространственные границы. Единственной сохранившейся проблемой является упорядочение ссылок границ на точки и объектов на границы. Ведь выбрав из базы всю информацию о точках линии, мы тем не менее не решаем проблему построения самой линии. Это является следствием нерешенной проблемы приоритета атрибутов. В принципе, среди атрибутов объекта, относящихся к одному классу (в приведенном выше примере все атрибуты линии относятся к классу точек), может возникнуть необходимость в расстановке приоритетов для одинаковых атрибутов. Выход из ситуации достаточно прост – достаточно лишь ввести необязательное для заполнения поле приоритета атрибута объекта. Для равноправных атрибутов (например, диаметр и длина трубы) поле не используется, в то время как в других случаях оно может заполняться, и при запросе к базе цифровой модели местности по нему может производиться сортировка.
В результате мы приходим к простейшей структуре базы данных, когда полная информация о цифровой модели местности может храниться в таблице, состоящей всего из пяти обязательных полей, причем при добавлении таблицы уравнивания объектов цифровая модель может служить централизованным хранилищем для обмена межотраслевыми данными. Благодаря обязательному полю дата/время появляется возможность хранения и накопления архивной информации и, что особенно важно, архивной картографической информации. В этом случае, используя фильтр по дате, мы можем увидеть, каким образом изменялась местность, когда появлялись новые дома, объекты инженерной инфраструктуры, а при необходимости можно отследить даже сезонные изменения границ объектов, например рек и болот.
Таким образом, единая цифровая модель местности является принципиально новым подходом к хранению данных в геоинформационных системах, открывающим возможность построения распределенных многопользовательских хранилищ и архивов данных, с возможностью обеспечения целостности, непротиворечивости и корректности как топологической структуры модели, так и атрибутивных данных объектов.