Теория информации
Формат компрессии DivX (технология компрессии от DivXNetworks): модификация MPEG-4, использует высокую степень компрессии с приемлемым качеством.
Формат компрессии RealVideo (собственный формат компании RealNetworks): RealVideo, использует очень высокую степень сжатия видео для прямой трансляции в Интернете.
Формат компрессии Windows Media (собственный формат файлов Microsoft): аналогичен MPEG-4, собственный формат фирмы Microsoft.
Программный видеоплеер Windows Media Player: типы воспроизводимых файлов WMV, ASF, AVI. MPEG, MPG, IVF, M1V, МР1, МР2, VOB и др.
Программный видеоплеер Real Player: типы воспроизводимых файлов RM, RA, RAM, MPG, MPEG, AVI, ASF, MID, MOV и др.
Программный видеоплеер Quick Time Player: типы воспроизводимых файлов QT, MOV, PNG, AVI, FIX, MPG, MPEG, MP1, MK и др.
В комплекте Windows имеется программный пакет для домашнего видеомонтажа Movie Maker. В нем реализованы все основные этапы работы с цифровым видео: захват, монтирование и сохранение (отправление в Интернет) видеофайлов. Существует достаточно много и других профессиональных программ. Их обычно начинают применять, когда компьютер превращается в домашнюю видеостудию: с приобретением ТВ-тюнера, цифровой видеокамеры, Firewire - оборудования или специальных плат видеозахвата.
Firewire – это стандарт обмена данными между периферийными устройствами.
Видеомонтаж – программная обработка видеоматериала.
Захват видеосигнала: перенос аналогового или цифрового сигнала на жесткий диск ПК.
КОДИРОВАНИЕ ЗВУКА
Для сохранения звука пользуются специальными программами — кодаками. Хотя качество результата у всех кодаков разное, принцип работы у них один.
Поклонники того или иного кодека не могут прийти к единому мнению, какой же из них лучше. Объясняется это просто: помимо таких объективных параметров, как размер файла и качество кодирования звука, существуют и субъективные факторы — восприятие каждого человека индивидуально.
Существует два основных стандарта, которые используют любители музыки во всем мире: МРЗ и WMA. Если стандарт WMA разрабатывается исключительно фирмой Microsoft, то кодек для сжатия цифрового звука в стандарте МРЗ может создать любой программист. В результате это привело к появлению большого количества алгоритмов кодирования. В условиях конкурентной борьбы за качество МРЗ-файлов на первое место вышел проект нескольких программистов — Lame.
Кодек Lame
Кодек Lame используют с 1998 году, когда с развитием Интернета между пользователями начался активный обмен файлами с данными и возникла проблема передачи звука через Сеть.
Многие фирмы стали разрабатывать программы для кодирования аудиосигнала с наименьшими потерями в качестве. Группа специалистов (MPEG), входящая в состав Международной организации стандартов (ISO), еще в конце 80-х годов разработала стандарт MPEG, на основе которого был создан современный стандарт сжатия звука MPEG 1.0 Audio Layer III — впоследствии он стал известен как МРЗ. Так как изначально утилиты для создания МРЗ-файлов распространялись за деньги, программисты стали искать способ бесплатно использовать алгоритмы работы кодека. Так среди многих других проектов появился кодек Lame, постепенно получивший огромную популярность. Основной особенностью Lame стало то, что разработчики сделали акцент на улучшении алгоритма специальной психоакустической модели. Принцип ее действия заключается в том, что из звукового файла удаляются те частоты, которые человеческое ухо воспринимать не в состоянии.
При кодировании цифрового звука (файлы с расширением WAV) основным параметром, влияющим на качество результата, является величина битрейта. Если использовать максимальное значение этого параметра, то получают звук, наиболее соответствующий оригиналу. Примерно до 2000 года широко использовалось значение битрейта 128 Кбит/с, а затем, с возросшей пропускной способностью современных каналов связи, наиболее распространенным стал битрейт 192 Кбит/с.
Еще один параметр, который может существенно улучшить качество звука, — функция VBR, позволяющая кодировать информацию с переменным битрейтом в зависимости от характера сигнала. Например, если в музыке присутствуют различные высокочастотные звуки (качественно сжать которые труднее всего), кодек принимает решение использовать для них самый высокий битрейт 320 Кбит/с.
Кодек WMA фирмы Microsoft
Кодек WMA был разработан фирмой Microsoft как стандарт хранения сжатой аудиоинформации в операционной системе Windows. Microsoft не стала пользоваться разработками организации MPEG, поэтому стандарт WMA является закрытым для использования другими разработчиками.
Microsoft стремится максимально использовать коммерческий потенциал WMA и поэтому защищает музыку в этом формате от нелегального копирования: WMA-файлы нельзя переконвертировать в файлы с расширением WAV.
Тем не менее популярность WMA растет. Это связано с тем, что при том же качестве звука, что и у стандарта МРЗ (по заявлению самой Microsoft), этот кодек позволяет получить меньший размер файла. Такой результат достигается за счет использования более низкого значения параметров битрейта, чем у МРЗ-файлов.
В последней, девятой, версии кодека создатели значительно переработали психоакустическую модель кодирования аудиоинформации, однако на максимальных значениях битрейта кодек от Microsoft до сих пор не может сравниться по качеству с кодеком Lame.
Выбор кодека для звука
При выборе кодека нужно руководствоавться двумя соображениями: если нужно получить файлы как можно меньшего размера — используют кодек от Microsoft, а если цель — получить максимальное качество звука, невзирая на размер файлов, выбирают Lame.
Другие кодеки для звука
Программистам и компаниям хочется сделать кодек, который станет всеобщим стандартом. Однако до сих пор ни один разработанный формат, отличный от WMA и МРЗ, не смог получить широкого распространения. Это произошло по двум причинам: либо кодек не очень хорошо сжимал аудиофайлы, либо программное обеспечение для его использования было полностью платным. Список кодеков, пытавшихся заменить МРЗ, достаточно велик:
ААС — улучшенный вариант стандарта MPEG по соотношению «размер файла/качество звука». Не получил особого распространения, потому что при кодировании аудиофайлов сильно загружает ресурсы компьютера.
Liquid Audio — коммерческий кодек, в котором содержание файла шифруется для пресечения нелегального копирования. Несмотря на то, что этот кодек по качеству результата превосходит МРЗ, отсутствие бесплатных программ для кодирования файлов помешало распространению этого формата.
МРЗрго — кодек, разработанный фирмой Tomson Multimedia. Был призван улучшить качество формата МРЗ на низких битрейтах. Особой популярности не получил из-за достаточно высокой цены и узкой области применения.
OGG Vorbis — этот сравнительно недавно появившийся кодек стоит особняком среди всех перечисленных форматов. Получаемые с его помощью файлы как по качеству, так и по размеру значительно превосходят стандарт МРЗ, что дает разработчикам право надеяться на то, что в будущем файлы с расширением OGG станут единственным средством хранения и распространения музыки через Интернет. Однако ни один современный портативный МРЗ-плеер не умеет воспроизводить файлы в этом формате — так же, как и большинство программных мультимедийных проигрывателей. TwinVQ — стандарт, разработанный фирмой Yamaha. Предназначался для кодирования звука с очень низким битрейтом и более высоким качеством, чем МРЗ. Не пользовался популярностью из-за больших требований к системным ресурсам как при воспроизведении музыки в этом формате, так и при кодировании файлов.
ФОРМАТ PDF
Часто документ Word «разваливается» на компьютере с другой версией операционной системы или MS Office, так что приходится приводить его в изначальный вид, восстанавливая потерянное форматирование. Но этого можно избежать.
Назначение формата PDF
Portable Document Format или просто PDF, был создан специально для ликвидации проблем с отображением информации в файлах. В чем же его преимущество? Во-первых, документ, сохраненный в формате PDF, будет одинаково выглядеть в любой операционной системе: в Windows XP, в Windows 95, и в Linux. Во-вторых, PDF использует качественные алгоритмы сжатия: если объем файла Word, содержащего пару картинок, вряд ли получится меньше мегабайта, то точно такой же PDF вполне уместится в 300-400 Кбайт. В-третьих, PDF умеет встраивать в себя все используемые в документе шрифты — будь то рукописные, готические или славянская вязь, так что можно забыть о тех случаях, когда какого-либо шрифта не оказывается на компьютере. В-четвертых, в формат PDF можно преобразовать любой электронный документ. А для прочтения и печати PDF понадобится бесплатная программа Acrobat Reader.
Создание PDF-файла
Сделать PDF просто. Первое, что необходимо, — программа Adobe Acrobat Professional, желательно последней версии 6.0. На практике все происходит очень просто, а во всех приложениях Microsoft Office и продуктах Adobe это можно сделать одним нажатием кнопки.
После инсталляции пакета Acrobat Professional в этих программах появится новая Панель инструментов, изначально она содержит три кнопки.
Открывают файл, который нужно преобразовать в PDF-формат, нажимают кнопку Convert to Adobe PDF на вышеуказанной Панели инструментов. В открывшемся окне указывают желаемое Имя создаваемого в формате PDF файла и Путь (месторасположение), где он будет находиться. Нажимают ОК, и через некоторое время новый файл будет готов и автоматически откроется для просмотра. Не сложнее этот процесс и во многих других программах. После установки Acrobat Professional в системе появляется новый виртуальный принтер под названием Adobe PDF —можно увидеть его ярлычк, открыв папку Принтеры через Панель управления. Он называется виртуальным, потому что реально не существует и используется именно для создания PDF-файлов. Поэтому печатают на нем тоже виртуально, но результат при этом будет вполне реальным. Открывают программу, из документа которой нужно получить PDF, и выбирают опцию Файл -> Печать. Далее открывают список доступных принтеров, выбирают Adobe PDF и нажмают ОК. После этого задают имя нового файла и его месторасположение, и через несколько секунд он будет готов.
Дополнительные настройки при создании PDF-файла
Кликают по значку принтера Adobe PDF правой кнопкой мыши и выбирают Настройку печати. Все самое полезное размещено на вкладке Adobe PDF Settings.Можно выбрать шаблон, по которому будут создаваться файлы: High Quality (для создания PDF с высоким разрешением и повышенным качеством) или Smallest file size (для уменьшения объема файла). А можно создать собственные шаблоны, нажав на кнопку Edit.
Здесь же можно задать настройки безопасности. Можно установить отсутствие защиты (None) или предписать программе спрашивать об опциях безопасности при каждом создании PDF (Reconfirm security for each job) — в этом случае необходимо нажать расположенную рядом кнопку Edit и задать пароль, которым будет блокироваться доступ к новым файлам. Там же скрываются такие полезные функции, как парольный запрет некоторых возможностей работы с файлом: можно разрешить открытие файла, но запретить его печать или сохранение в др
3. Эффективное кодирование
При кодировании каждая буква исходного алфавита представляется различными последовательностями, состоящими из кодовых букв (цифр).
Если исходный алфавит содержит m букв, то для построения равномерного кода с использованием k кодовых букв необходимо удовлетворить соотношение m Ј kq , где q - количество элементов в кодовой последовательности.
Поэтому
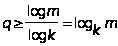
Для построения равномерного кода достаточно пронумеровать буквы исходного алфавита и записать их коды как q - разрядные числа в k-ичной системе счисления.
Например, при двоичном кодировании 32 букв русского алфавита используется q = log232 = 5 разрядов, на чем и основывается телетайпный код.
Кроме двоичных кодов, наибольшее распространение получили восьмеричные коды.
Пусть, например, необходимо закодировать алфавит, состоящий из 64 букв. Для этого потребуется q = log264 = 6 двоичных разрядов или q = log864 = 2 восьмеричных разрядов. При этом буква с номером 13 при двоичном кодировании получает код 001101, а при восьмеричном кодировании 15.
Обще признанным в настоящее время является позиционный принцип образования системы счисления. Значение каждого символа (цифры) зависит от его положения - позиции в ряду символов, представляющих число.
Единица каждого следующего разряда больше единицы предыдущего разряда в m раз, где m - основание системы счисления. Полное число получают, суммируя значения по разрядам:
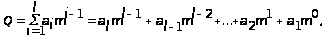
где i - номер разряда данного числа; l - количество рядов; аi - множитель, принимающий любые целочисленные значения в пределах от 0 до m-1 и показывающий, сколько единиц i - ого ряда содержится в числе.
Часто используются двоично-десятичные коды, в которых цифры десятичного номера буквы представляются двоичными кодами. Так, например, для рассматриваемого примера буква с номером 13 кодируется как 0001 0011. Ясно, что при различной вероятности появления букв исходного алфавита равномерный код является избыточным, т.к. его энтропия (полученная при условии, что все буквы его алфавита равновероятны): logkm = H0
всегда больше энтропии H = log m данного алфавита (полученной с учетом неравномерности появления различных букв алфавита, т.е. информационные возможности данного кода используются не полностью).
Например, для телетайпного кода Н0 = logk m = log232 = 5 бит, а с учетом неравномерности появления различных букв исходного алфавита Н » 4,35 бит. Устранение избыточности достигается применением неравномерных кодов, в которых буквы, имеющие наибольшую вероятность, кодируются наиболее короткими кодовыми последовательностями, а более длинные комбинации присваиваются редким буквам. Если i-я буква, вероятность которой Рi, получает кодовую комбинацию длины qi, то средняя длина комбинации

Считая кодовые буквы равномерными, определяем наибольшую энтропию закодированного алфавита как qср log m, которая не может быть меньше энтропии исходного алфавита Н, т.е. qср log m і Н.
Отсюда имеем

При двоичном кодировании (m=2) приходим к соотношению qср і Н, или
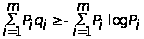
Чем ближе значение qср к энтропии Н, тем более эффективно кодирование. В идеальном случае, когда qср » Н, код называют эффективным.
Эффективное кодирование устраняет избыточность, приводит к сокращению длины сообщений, а значит, позволяет уменьшить время передачи или объем памяти, необходимой для их хранения.
При построении неравномерных кодов необходимо обеспечить возможность их однозначной расшифровки. В равномерных кодах такая проблема не возникает, т.к. при расшифровке достаточно кодовую последовательность разделить на группы, каждая из которых состоит из q элементов. В неравномерных кодах можно использовать разделительный символ между буквами алфавита (так поступают, например, при передаче сообщений с помощью азбуки Морзе).
Если же отказаться от разделительных символов, то следует запретить такие кодовые комбинации, начальные части которых уже использованы в качестве самостоятельной комбинации. Например, если 101 означает код какой-то буквы, то нельзя использовать комбинации 1, 10 или 10101.
Практические методы оптимального кодирования просты и основаны на очевидных соображениях ( метод Шеннона – Фано ).
Прежде всего, буквы (или любые сообщения, подлежащие кодированию) исходного алфавита записывают в порядке убывающей вероятности. Упорядоченное таким образом множество букв разбивают так, чтобы суммарные вероятности этих подмножеств были примерно равны. Всем знакам (буквам) верхней половины в качестве первого символа присваивают кодовый элемент 1, а всем нижним 0. Затем каждое подмножество снова разбивается на два подмножества с соблюдением того же условия равенства вероятностей и с тем же условием присваивания кодовых элементов в качестве второго символа. Такое разбиение продолжается до тех пор, пока в подмножестве не окажется только по одной букве кодируемого алфавита. При каждом разбиении буквам верхнего подмножества присваивается кодовый элемент 1, а буквам нижнего подмножества - 0.
Пример16: Провести эффективное кодирование ансамбля из восьми знаков:
Таблица 3.1.
| Буква (знак) xi | Вероят-ность Рi | Кодовые последовательности | Длина qi | рi qi | -рilog рi |
| Номер разбиения | ||||||||
| 1 | 2 | 3 | 4 | |||||
| x1 | 0,25 | 1 | 1 | 2 | 0,5 | 0,50 | ||
| x2 | 0,25 | 1 | 0 | 2 | 0,5 | 0,50 | ||
| x3 | 0,15 | 0 | 1 | 1 | 3 | 0,45 | 0,41 | |
| x4 | 0,15 | 0 | 1 | 0 | 3 | 0,45 | 0,41 | |
| x5 | 0,05 | 0 | 0 | 1 | 1 | 4 | 0,2 | 0,22 |
| x6 | 0,05 | 0 | 0 | 1 | 0 | 4 | 0,2 | 0,22 |
| x7 | 0,05 | 0 | 0 | 0 | 1 | 4 | 0,2 | 0,22 |
| x8 | 0,05 | 0 | 0 | 0 | 0 | 4 | 0,2 | 0,22 |
=
2,7
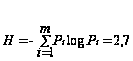
Как видно, qср = H, следовательно, полученный код является оптимальным.
Пример17: Построить код Шеннона - Фано, если известны вероятности: Р(x1) = 0,5; P(x2)= 0,25; P(x3) = 0,125; P(x4) = 0,125
Пример18: Провести эффективное кодирование ансамбля из восьми знаков (m=8), используя метод Шеннона - Фано.
Решение: При обычном (не учитывающем статистических характеристик) двоичном кодировании с использованием k=2 знаков при построении равномерного кода количество элементов в кодовой последовательности будет q і logk m = log2 8 = 3, т.е. для представления каждого знака использованного алфавита потребуется три двоичных символа.
Метод Шеннона - Фано позволяет построить кодовые комбинации, в которых знаки исходного ансамбля, имеющие наибольшую вероятность, кодируются наиболее короткими кодовыми последовательностями. Таким образом, устраняется избыточность обычного двоичного кодирования, информационные возможности которого используются не полностью.
Таблица 3.2.
| Знаки (буквы) xi | Вероятность Pi | Кодовые комбинации |
| номер разбиения | ||||||||
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | ||
| x1 | 1/2 | 1 | ||||||
| x2 | 1/4 | 0 | 1 | |||||
| x3 | 1/8 | 0 | 0 | 1 | ||||
| x4 | 1/16 | 0 | 0 | 0 | 1 | |||
| x5 | 1/32 | 0 | 0 | 0 | 0 | 1 | ||
| x6 | 1/64 | 0 | 0 | 0 | 0 | 0 | 1 | |
| x7 | 1/128 | 0 | 0 | 0 | 0 | 0 | 0 | 1 |
| x8 | 1/128 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
Так как вероятности знаков представляют собой отрицательные целочисленные степени двойки, то избыточность при кодировании устранена полностью.
Среднее число символов на знак в этом случае точно равно энтропии. В общем случае для алфавита из восьми знаков среднее число символов на знак будет меньше трех, но больше энтропии алфавита. Вычислим энтропию алфавита:
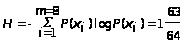
Вычислим среднее число символов на знак:
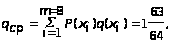
где q(xi) - число символов в кодовой комбинации, соответствующей знаку xi.
Пример19: Определить среднюю длину кодовой комбинации при эффективном кодировании по методу Шеннона - Фано ансамбля - из восьми знаков и энтропию алфавита.
Таблица 3.3.
|
Знаки (буквы) xi |
Вероятность Pi |
Кодовые комбинации | ||||
| номер разбиения | ||||||
| 1 | 2 | 3 | 4 | 5 | ||
| x1 | 0,22 | 1 | 1 | |||
| x2 | 0,20 | 1 | 0 | 1 | ||
| x3 | 0,16 | 1 | 0 | 0 | ||
| x4 | 0,16 | 0 | 1 | |||
| x5 | 0,10 | 0 | 0 | 1 | ||
| x6 | 0,10 | 0 | 0 | 0 | 1 | |
| x7 | 0,04 | 0 | 0 | 0 | 0 | 1 |
| x8 | 0,02 | 0 | 0 | 0 | 0 | 0 |
Решение: 1. Средняя длина кодовых комбинаций
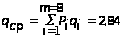
2. Энтропия алфавита
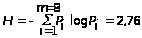
При кодировании по методу Шеннона - Фано некоторая избыточность в последовательностях символов, как правило, остается (qср > H).
Эту избыточность можно устранить, если перейти к кодированию достаточно большими блоками.
Пример20: Рассмотрим процедуру эффективного кодирования по методике Шеннона - Фано сообщений, образованных с помощью алфавита, состоящего всего из двух знаков x1 и x2 с вероятностями появления соответственно Р(х1) = 0,9; P(x2) = 0,1.
Так как вероятности не равны, то последовательность из таких букв будет обладать избыточностью. Однако, при побуквенном кодировании мы никакого эффекта не получим. Действительно, на передачу каждой буквы требуется символ либо 1, либо 0, в то время как энтропия равна
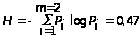 ,
т.е. оказывается
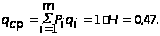
При кодировании блоков, содержащих по две буквы, получим коды:
Таблица 3.4.
| Блоки | Вероятности | Кодовые комбинации | ||
| номер разбиения | ||||
| 1 | 2 | 3 | ||
| x1x1 | 0,81 | 1 | ||
| x1x2 | 0,09 | 0 | 1 | |
| x2x1 | 0,09 | 0 | 0 | 1 |
| x2x2 | 0,01 | 0 | 0 | 0 |
Так как знаки статистически не связаны, вероятности блоков определяют как произведение вероятностей составляющих знаков.
Среднее число символов на блок
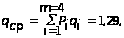
а на букву 1,29/2 = 0,645, т.е. приблизилось к Н = 0,47 и таким образом удалось повысить эффективность кодирования.
Кодирование блоков, содержащих по три знака, дает еще больший эффект:
Таблица 3.5.
| Блоки |
Вероятность Pi |
кодовые комбинации | ||||
| номер разбиения | ||||||
| 1 | 2 | 3 | 4 | 5 | ||
| x1x1x1 | 0,729 | 1 | ||||
| x2x1x1 | 0,081 | 0 | 1 | 1 | ||
| x1x2x1 | 0,081 | 0 | 1 | 0 | ||
| x1x1x2 | 0,081 | 0 | 0 | 1 | ||
| x2x2x1 | 0,009 | 0 | 0 | 1 | 1 | |
| x2x1x2 | 0,009 | 0 | 0 | 0 | 1 | 0 |
| x1x2x2 | 0,009 | 0 | 0 | 0 | 0 | 1 |
| x2x2x2 | 0,001 | 0 | 0 | 0 | 0 | 0 |
Среднее число символов на блок равно 1,59, а на знак - 0,53, что всего на 12% больше энтропии.
Следует подчеркнуть, что увеличение эффективности кодирования при укрупнении блоков не связано с учетом все более далеких статистических связей, т.к. нами рассматривались алфавиты с независимыми знаками.
Повышение эффективности определяется лишь тем, что набор вероятностей получившихся при укрупнении блоков можно делить на более близкие по суммарным вероятностям подгруппы.
Рассмотренная методика Шеннона - Фано не всегда приводит к однозначному построению кода, т.к. при разбиении на подгруппы можно сделать большей по вероятности как верхнюю, так и нижнюю подгруппы:
Таблица 3.6.
|
Знаки (буквы) xi |
Вероятность Pi |
1-е кодовые комбинации | 2-е кодовые комбинации | ||||||||
| номер разбиения | номер разбиения | ||||||||||
| 1 | 2 | 3 | 4 | 5 | 1 | 2 | 3 | 4 | 5 | ||
| x1 | 0,22 | 1 | 1 | 1 | 1 | ||||||
| x2 | 0,20 | 1 | 0 | 1 | 1 | 0 | |||||
| x3 | 0,16 | 1 | 0 | 0 | 0 | 1 | 1 | ||||
| x4 | 0,16 | 0 | 1 | 0 | 1 | 0 | |||||
| x5 | 0,10 | 0 | 0 | 1 | 0 | 0 | 1 | ||||
| x6 | 0,10 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 1 | ||
| x7 | 0,04 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 |
| x8 | 0,02 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
От указанного недостатка свободен метод Хаффмона.
Эта методика гарантирует однозначное построение кода с наименьшим для данного распределения вероятностей средним числом символов на букву.
Для двоичного кода метод Хаффмона сводится к следующему. Буквы алфавита сообщений выписывают в основной столбец таблицы в порядке убывания вероятностей. Две последние буквы объединяют в одну вспомогательную букву, которой приписывают суммарную вероятность. Вероятности букв, не участвующих в объединении и полученная суммарная вероятность снова располагаются в порядке убывания вероятностей в дополнительном столбце, а две последние объединяются.
Процесс продолжается до тех пор, пока не получат единственную вспомогательную букву с вероятностью, равной единице.
Используя метод Хаффмона, осуществим эффективное кодирование ансамбля из восьми знаков:
Таблица 3.7.
| Знаки | Вероятности | Вспомогательные столбцы |
Новая комбинация |
||||||
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | |||
| x1 | 0,22 | 0,22 | 0,22 | 0,26 | 0,32 | 0,42 | 0,58 | 1 | 01 |
| x2 | 0,20 | 0,20 | 0,20 | 0,22 | 0,26 | 0,32 | 0,42 | 00 | |
| x3 | 0,16 | 0,16 | 0,16 | 0,20 | 0,22 | 0,26 | 111 | ||
| x4 | 0,16 | 0,16 | 0,16 | 0,16 | 0,20 | 110 | |||
| x5 | 0,10 | 0,10 | 0,10 | 0,16 | 100 | ||||
| x6 | 0,10 | 0,10 | 1011 | ||||||
| x7 | 0,04 | 0,06 | 10101 | ||||||
| x8 | 0,02 | 10100 | |||||||
Для наглядности построим кодовое дерево. Из точки, соответствующей вероятности 1, направляем две ветви, причем ветви с большей вероятностью присваиваем символ 1, а с меньшей 0.
Такое последовательное ветвление продолжаем до тех пор, пока не дойдем до вероятности каждой буквы.
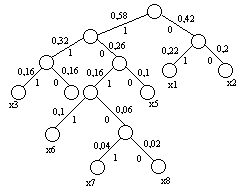
Рис. 3.1.
Двигаясь по кодовому дереву сверху вниз, можно записать для каждой буквы соответствующую ей кодовую комбинацию.
Пример21: Используя метод Шеннона - Фано и метод Хаффмона осуществить эффективное кодирование алфавита русского языка, характеризующегося ансамблем, представленным в примере 4.
4. Кодирование информации для канала с помехами
Ошибка в кодовой комбинации появляется при ее передаче по каналу связи вследствие замены одних элементов другими под воздействием помех. Например, 2-кратная ошибка возникает при замене (искажении) двух элементов. Например, если кодовая комбинация 0110111 принята как 0100110, то имеет место двукратная ошибка.
Теория помехоустойчивого кодирования базируется на результатах исследований, проведенных Шенноном и сформулированных в виде теоремы:
При любой производительности источника сообщений, меньшей, чем пропускная способность канала, существует такой способ кодирования, который позволяет обеспечить передачу всей информации, создаваемой источником сообщений, со сколь угодно малой вероятностью ошибки.
Не существует способа кодирования, позволяющего вести передачу информации со сколь угодно малой вероятностью ошибки, если производительность источника сообщений больше пропускной способности канала.
Из теоремы следует, что помехи в канале не накладывают ограничений на точность передачи. Ограничение накладывается только на скорость передачи, при которой может быть достигнута сколь угодно высокая точность передачи.
Теорема не затрагивает вопроса о путях построения кодов, обеспечивающих идеальную передачу информации, но, обосновав принципиальную возможность такого кодирования, позволяет вести разработку конкретных кодов.
При любой конечной скорости передачи информации вплоть до пропускной способности канала, сколь угодно малая вероятность ошибки достигается лишь при безграничном увеличении длительности кодируемых последовательностей знаков. Таким образом, безошибочная передача при наличии помех возможна лишь теоретически.
Обеспечение передачи информации с весьма малой вероятностью ошибки и достаточно высокой эффективностью возможно при кодировании чрезвычайно длинными последовательностями знаков.
На практике точность передачи информации и эффективность каналов связи ограничивается двумя факторами:
размером и стоимостью аппаратуры кодирования/декодирования;
временем задержки передаваемого сообщения.
4.1 Разновидности помехоустойчивых кодов
Коды, которые обеспечивают возможность обнаружения и исправления ошибки, называют помехоустойчивыми.
Эти коды используют для:
исправления ошибок – корректирующие коды;
обнаружения ошибок.
Корректирующие коды основаны на введении избыточности.
У подавляющего большинства помехоустойчивых кодов помехоустойчивость обеспечивается их алгебраической структурой. Поэтому их называют алгебраическими кодами.
Алгебраические коды подразделяются на два класса:
блоковые;
непрерывные.
В случае блоковых кодов процедура кодирования заключается в сопоставлении каждой букве сообщения (или последовательности из k символов, соответствующей этой букве) блока из n символов. В операциях по преобразованию принимают участие только указанные k символов, и выходная последовательность не зависит от других символов в передаваемом сообщении.
Блоковый код называют равномерным, если n остается постоянным для всех букв сообщения.
Различают разделимые и неразделимые блоковые коды. При кодировании разделимыми кодами выходные последовательности состоят из символов, роль которых может быть отчетливо разграничена. Это информационные символы, совпадающие с символами последовательности, поступающей на вход кодера канала, и избыточные (проверочные) символы, вводимые в исходную последовательность кодером канала и служащие для обнаружения и исправления ошибок.
При кодировании неразделимыми кодами разделить символы входной последовательности на информационные и проверочные невозможно.
Непрерывными (древовидными) называют такие коды, в которых введение избыточных символов в кодируемую последовательность информационных символов осуществляется непрерывно, без разделения ее на независимые блоки. Непрерывные коды также могут быть разделимыми и неразделимыми.
4.2 Общие принципы использования избыточности
Способность кода обнаруживать и исправлять ошибки обусловлена наличием в нем избыточных символов.
На вход кодирующего устройства поступает последовательность из k информационных двоичных символов. На выходе ей соответствует последовательность из n двоичных символов, причем n>k.
Всего может быть 2k различных входных и 2n различных выходных последовательностей.
Из общего числа 2n выходных последовательностей только 2k последовательностей соответствуют входным. Их называют разрешенными кодовыми комбинациями.
Остальные 2n-2k возможных выходных последовательностей для передачи не используются. Их называют запрещенными кодовыми комбинациями.
Искажения информации в процессе передачи сводятся к тому, что некоторые из передаваемых символов заменяются другими – неверными.
Так как каждая из 2k разрешенных комбинаций в результате действия помех может трансформироваться в любую другую, то всегда имеется 2k*2n возможных случаев передачи. В это число входят:
2k случаев безошибочной передачи;
2k(2k –1) случаев перехода в другие разрешенные комбинации, что соответствует необнаруженным ошибкам;
2k(2n – 2k) случаев перехода в неразрешенные комбинации, которые могут быть обнаружены.
Следовательно, часть обнаруживаемых ошибочных кодовых комбинаций от общего числа возможных случаев передачи составляет
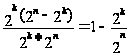 .
Пример22: Определить обнаруживающую способность кода, каждая комбинация которого содержит всего один избыточный символ (n=k+1).
Решение : 1. Общее число выходных последовательностей составляет 2k+1, т.е. вдвое больше общего числа кодируемых входных последовательностей.
2. За подмножество разрешенных кодовых комбинаций можно принять, например, подмножество 2k комбинаций, содержащих четное число единиц (или нулей).
3. При кодировании к каждой последовательности из k информационных символов добавляют один символ (0 или 1), такой, чтобы число единиц в кодовой комбинации было четным. Исполнение любого нечетного числа символов переводит разрешенную кодовую комбинацию в подмножество запрещенных комбинаций, что обнаруживается на приемной стороне по нечетности числа единиц. Часть опознанных ошибок составляет
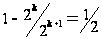 .
Любой метод декодирования можно рассматривать как правило разбиения всего множества запрещенных кодовых комбинаций на 2k пересекающихся подмножеств Mi, каждая из которых ставится в соответствие одной из разрешенных комбинаций. При получении запрещенной комбинации, принадлежащей подмножеству Mi, принимают решение, что передавалась запрещенная комбинация Ai. Ошибка будет исправлена в тех случаях, когда полученная комбинация действительно образовалась из Ai, т.е. 2n-2k cлучаях.
Всего случаев перехода в неразрешенные комбинации 2k(2n – 2k). Таким образом, при наличии избыточности любой код способен исправлять ошибки.
Отношение числа исправляемых кодом ошибочных кодовых комбинаций к числу обнаруживаемых ошибочных комбинаций равно
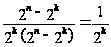 .
Способ разбиения на подмножества зависит