Разработка программно–алгоритмических средств для определения надёжности программного обеспечения на основании моделирования работы системы типа "клиент–сервер"
Статистическая модель Миллса
Описана в [11] и [20]. Программа специально "засоряется" некоторым количеством заранее известных ошибок. Эти ошибки вносятся в программу случайным образом, а затем делается предположение, что для ее собственных и искусственно внесенных ошибок вероятность обнаружения при последующем тестировании одинакова и зависит только от их количества. Тестируя программу в течении некоторого времени и отсортировывая собственные и внесенные ошибки можно оценить N – первоначальное число ошибок в программе.
Пусть: S – число специально внесенных ошибок; n – число найденных собственных ошибок в программе; u – число найденных внесенных ошибок; n+u – количество обнаруженных ошибок при тестировании.
Тогда по методу максимального правдоподобия имеем: N = S · n / u.
Основное допущение модели – распределение «посеянных» ошибок совпадает с распределением по программе собственных ошибок, и, следовательно, обнаружение, как тех, так и других ошибок равновероятно – что является существенным недостатком этой модели.
При этом можно выдвигать и проверять гипотезы об N. Пусть в программе не более k собственных ошибок и внесли нее еще S ошибок. Теперь программа тестируется, пока не будут обнаружены все специально внесенные ошибки. Причем в этот момент подсчитывается число обнаруженных собственных ошибок (обозначим его, как и раньше, как n). Введем уровень значимости C:
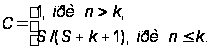 (А.24)
С – мера доверия к модели, то есть мера правильности нашего предположения о количестве k собственных ошибок и дает оценку для количества ошибок
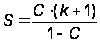 ,
которое нужно внести в программу, чтобы проверить гипотезу с заданным уровнем значимости.
Например, если мы утверждаем, что в программе нет ошибок (k = 0), и внося в программу 4 ошибки, все их обнаруживаем, не встретив ни одной собственной ошибки, то C = 0.80. А чтобы достичь уровня 95 %, надо было бы внести в программу 19 ошибок.
Этот метод не очень эффективен в случае применения его в реальной практике, так как если предположить что в программе своих ошибок n = 1000 (что более реально, чем n = 0), то для достижения уровня правдоподобия 0,95 в программу придется ввести 19019 ошибок, что само по себе уже тяжелая задача.
Формулу (А.9) можно модифицировать так, чтобы устранить недостаток, заключающийся в том, что C нельзя предсказать до тех пор, пока не будут обнаружены все искусственно внесенные ошибки (а это может и не произойти за ограниченное время, отведенное на тестирование). Модифицированной формулой можно пользоваться уже после того, как найдено j внесенных ошибок:
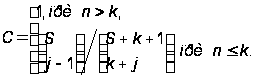 (А.24)
Это математически очень простая и интуитивно понятная модель. Процесс внесения ошибок – само слабое звено модели, так как должны вноситься "типичные" для данной программы ошибки (то есть искусственно внесенные ошибки должны иметь то же распределение вероятности, что и собственные ошибки). Кроме того, эта модель не учитывает системных ошибок, то есть ошибок вносимых на этапе проектирования, а не самого кодирования.
Модель Бейзина
Пусть ПО содержит Nk команд [20]. Случайным образом из них выбирается n команд, в которые вводятся ошибки. Затем для тестирования случайным образом выбирается r команд. Если в ходе тестирования будет обнаружено n собственных и m привнесенных («посеянных») ошибок, то полное число N0 ошибок содержащихся в программе перед началом тестирования (следует из метода максимального правдоподобия) можно определить как:
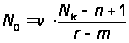 .
Простая экспоненциальная модель
В отличие от модели Джелинского–Моранды R(t) № const [20].
Пусть N(t) – число обнаруженных к моменту времени t ошибок и пусть функция риска пропорциональна числу оставшихся к моменту t в программе ошибок: R(t) = KЧ(N(0) – N(t)).
Продифференцируем обе части этого уравнения по времени:
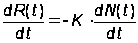 .
Учитывая, что dN(t)/dt есть R(t) (число ошибок, обнаруженных в единицу времени), получим дифференциальное уравнение:
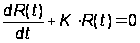
с начальными условиями N(0) = 0, R(0) = KЧN0.
Решением этого уравнения является функция:
R(t) = KЧN0Чexp(–KЧt).(А.24)
Для K и N0 получают следующие оценки (с применением МНК) для первых n ошибок:
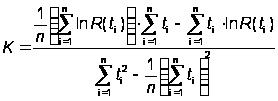 ,
 ,
где
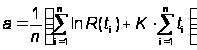 .
Используя (А.11) можно определить время необходимое для снижения интенсивности появления ошибок с R1(t) до R2(t):
 .
Дискретная модель Шика–Уолвертона
Эта модель рассмотрена в работах [12, 20, 21]. Применяется при следующих допущениях:
предполагается, что частота проявления ошибок (интенсивность отказов) линейно зависит от времени испытаний ti между моментами обнаружения последовательных i–й и (i–1)–й ошибок;
появление ошибок равновероятно и независимо;
ошибки корректируются без введения новых.
Тогда:
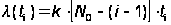 ,
где k – коэффициент пропорциональности, обеспечивающий равенство единице площади под кривой вероятности обнаружения ошибок.
В этом случае для оценки вероятности безотказной работы получается выражение, соответствующее распределению Релея:
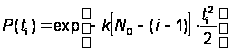 ,
где P(ti) = P(Tіti).
Отсюда плотность распределения времени наработки на отказ:
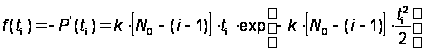 .
Использовав функцию максимального правдоподобия, получим оценку для N0 и K:
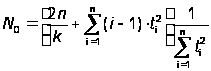 ,
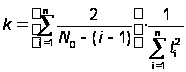 .
Модель Вейбулла
В [12] и [20] приводится модель надежности ПО с учетом ступенчатого характера изменения надежности при устранении очередной ошибки.
Функция риска для этой модели представляется в виде: R(t) = (a/b) Ч(t/b)a–1, где a > 0, и b > 0 – константы модели; t – интервал времени безошибочной работы.
Если a > 1, то интенсивность обнаружения ошибок растет со временем, если a < 1, то – падает.
Плотность распределения вероятности до появления очередной ошибки описывается распределением Вейбулла:
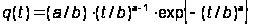 .
Наработка до отказа выражается через гамма–функцию:
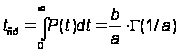 ,
где P(t) – вероятность безотказной работы и P(t) = 1 – Q(t), где Q(t) – вероятность отказа:
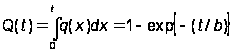 .
Для оценки параметров a и b используются следующие формулы:
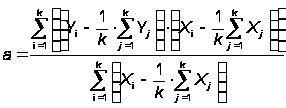 ,
где
b = exp{–b0/a},
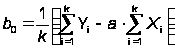 ,
k – число интервалов тестирования,
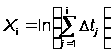 ,
Dtj – длина j–го интервала тестирования,
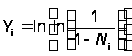 ,
Ni – нормированное суммарное число ошибок, обнаруженных к моменту ti.
Определение надежности по результатам тестирования
Рассмотрены в работе [13]. Оценку надежности ПО при стохастическом (когда входные данные выбираются согласно своим функциям распределения и основным статистическим моментам) функциональном тестировании целесообразно производить на основании заключительной серии стохастических тестов (например, при приемочных испытаниях), когда отказы программы отсутствуют. Тогда для оценки вероятности безотказной работы программы может быть использована формула (оценка безошибочности ПО производится таким же методом как оценка безотказности аппаратуры):
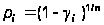 ,(А.24)
где pн – нижняя доверительная граница вероятности безотказной работы ПО при однократном прохождении набора стохастических входных данных; gн – доверительная вероятность; n – число проходов при тестировании.
Пусть, например, n=150 прохождений со случайными исходными данными. Исходы всех тестов положительные (ошибок не обнаружено), т.е. количество отказов ПО равно нулю. Необходимо определить нижнюю доверительную границу вероятности безотказной работы ПО при одном прохождении, при gн = 0,9.
Согласно (А.11) имеем pн = 0.985.
Сделанное выше допущение относительно независимости результатов отдельных тестов программы не вполне обосновано, так как наличие ошибки в ПО обнаруживается скорей всего, большим количеством тестов, чем это можно ожидать, исходя из независимости их результатов. Поэтому представляет интерес другой подход, где ПО рассматривается как сообщение, состоящее из N символов. Пусть каждый стохастический тест проверяет в среднем r символов из N и пусть один из N элементов содержит ошибку.
Пусть вероятность того, что при одном тесте ошибка не будет обнаружена, оценивается как 1 – r/N. Вероятность того, что при n независимых тестах ошибка не будет обнаружена, равна (1 – r/N)n. Если ошибочных символов в ПО больше чем один, то вероятность их обнаружения одним тестом будет еще больше, так как эта оценка является оценкой снизу.
Пусть n = 150; r/N = 0,3. Тогда вероятность обнаружения ошибки в ПО
p = 1 – (1 – r/N)150 = 1 – 1,72Ч10–20 @ 1.
Настолько высокая оценка вероятности обнаружения ошибок получается благодаря тому, что в соответствии с данной моделью каждый символ программы проверяется в среднем многократно, и вероятность того, что некоторый символ ни в одном тесте не проверяется, весьма мала.
Модель избыточности
Можно попробовать использовать подход, предложенный в статье [24] для описания эффективности защиты ПО от сбоев посредством введения в нее избыточного кода. Эффективность защиты (в расчете на которую в ПО вводится избыточный код, который снижает функциональные характеристики ПО, в частности, быстродействие и требует больших ресурсов (например, для использования образцового в этом отношении языка JAVA нужно как минимум 128 Мб ОЗУ)), априорно определим как вероятность P (являющейся функцией времени T периодичности работы программного модуля) нужности (срабатывания) защиты. Эта вероятность в рассматриваемом случае может быть выражена произведением вида:
P = Pe * Pr * Pd,(А.24)
где Pe – вероятность того, что сбой произойдет (например, закончатся ресурсы оперативной памяти и не будет выделена память);
Pr – вероятность того, что защита от этого сбоя сработает;
Pd – вероятность того, что сообщение о сбое будет получено и обработано (т.е. что диагностика сработает).
По сути данной задачи речь идет о двух типах случайных событий:
1. событии (нежелательном) состоящем в том, что произошел прогнозируемый сбой;
2. событии (желательном) состоящем в том, что защита сработает.
Рассмотрим случай, когда оба типа событий характеризуются постоянными интенсивностями (поскольку временные зависимости этих параметров обычно не известны). Пусть:
e – интенсивность (то есть вероятностью возникновения в единицу времени) возникновения ошибки (сбоя);
lr – интенсивностью отказа (не срабатывания) защиты, характеризующая надежность защиты;
ld – интенсивность срабатывания диагностики, характеризующая надежность системы диагностики Pd.
Тогда сомножители, входящие в формулу (А.13), можно представить в следующем виде:
|
|
(А.24) (А.24) (А.24) |
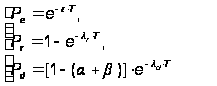
где T – периодичность работы программного модуля;
a, b – вероятности ошибок 1–го и 2–го рода диагностики.
Диагностика представляет собой устройство (или программу), обеспечивающее оповещение оператора о сбое и принятии решения о дальнейшей работе. Исправный диагностический модуль по аналогии с размыкателем характеризуется двумя ошибками: ошибка 1–го рода – ложное срабатывание (например, выключение без наличия сбоя), ошибка 2–го рода – отсутствие срабатывания при наличии сбоя. Защита не эффективна в обоих случаях.
Подстановка (А.13) – (А.15) в (А.12) дает выражение:
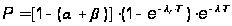 ,(А.24)
где
 .
Функция (А.16) достигает максимума при значении T равном:
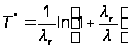 (А.24)
Значение T* представляет собой оптимальное время T защищенности программы. Таким образом, этот метод позволяет определить оптимальную периодичность работы программы, при которой защита с заданными характеристиками e, lr, ld дает оптимальный эффект. Либо можно оценить одну из характеристик e, lr, ld при заданных остальных и заданном T*.
Например, оценим T*:
e – один раз в месяц, т.е. равна 3,7e–7;
lr = e;
ld – один раз в минуту, т.е. равен 0,017.
Тогда T* = 59 с.
Теперь, оценим ld при следующих условиях:
T* = 60 с;
e – один раз в год, т.е. равна 3,3e–8;
lr = e.
Тогда из (А.17) имеем
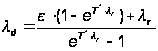 .
Получаем ld = 1,67e–02 1/с или один раз в минуту.
Модель Дюэна
Модель рассмотрена в работе [20]. Эта модель была предложена для оценки роста надежности. Для этого рассматривается отношение интенсивности обнаружения ошибок к общему времени тестирования. В основу модели положены следующие предположения:
обнаружение любой ошибки равновероятно;
общее число ошибок N(t), обнаруженных к произвольному моменту t, распределено по закону Пуассона со средним значением n(t) = aЧtb.
Из этого следует, что
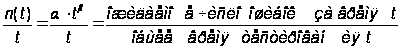 .
Из МНК получают следующую оценку для a и b:
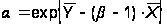 ,
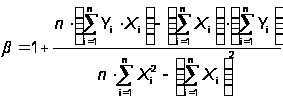 ,
где
Xi = ln(ti), Yi = ln(i/ti),
 ,
Для использования этой модели требуется только знание моментов времени ti проявления ошибок.
Метод Холстеда оценки числа оставшихся в ПО ошибок
Модель рассмотрена в работе [20]. На сегодняшний момент это единственная модель, с помощью которой можно оценить число ожидаемых (то есть потенциальных) ошибок в ПО еще на этапе составления ТЗ на ПО.
Для программы вводится понятие длины программы N и объем программы (в битах) V:
N = n1Чlog2n1 + n2Чlog2n2,
V = NЧlog2(n1 + n2),(А.24)
где n1 – число различных операций (например, таких как IF, =, DO, PRINT и т.п.); n2 – число различных переменных и констант.
Далее рассматривается потенциальный объем программы (в битах) V*:
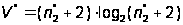 ,(А.24)
где
 – только число
входных и выходных
переменных.
Величина
может быть
выявлена уже
на стадии ТЗ
или технического
проекта на
разработку
ПО.
Еще вводится понятие уровня программы L, который определяется как отношение потенциального объема V* к объему V:
L = V*/V.
Также вводятся величины:
E = V/L = V2/V*,
l = LЧV*
– уровень языка программирования. Значения l для некоторых языков программирования: Ассемблер – 0,88; Фортран – 1,14; PL–1 – 1,53; С/С++ – 1,7; Pascal – 1,8; JAVA – 1,9.
Из этого следует, что
V = (V*)2/l.(А.24)
Оценка времени, затрачиваемое на разработку ПО:
T = E/S = (V*)3/(lЧS) (А.24)
где S – параметр Страуда (психофизиологическая характеристика времени, необходимого человеческому мозгу для выполнения элементарной мыслительной операции. S лежит в пределах от 5 до 20 различий в секунду. Холстедом используется значение S = 18, характеризующее процесс программирования как довольно напряженную умственную работу).
Используя (А.21) можно оценить выигрыш во времени разработки при переходе от одного языка программирования l1 к другому языку l2:
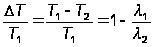 .
Например, выигрыш при переходе с C/C++ на JAVA составит около 10%, а с ассемблера на JAVA – 50%.
Основное предположения этой модели:
общее число ожидаемых ошибок N в программе определяется сложностью ее создания (и это верно, за исключением того, что в вышеперечисленные характеристики ПО не входит сложность проектирования, а учитывается только сложность кодирования!).
мозг человека может обработать одновременно и безошибочно 7±2 объектов (гипотеза Миллера).
Тогда,
взяв нижнюю
границу в 5 объектов
и добавив еще
один объект,
мы получим
максимальное
число
= 6 различных
входных и выходных
параметров
для потенциально
безошибочной
программы.
Тогда потенциальный
объем V0* по (17): V0* =
(6+2) Чlog2(6+2)
= 24 логических
бита.
Следовательно, после обработки 24 битов информации на языке программирования человек совершит одну ошибку.
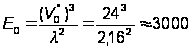 .
Это означает, что на каждые 3000 бит объема V* приходится одна ошибка. Тогда для реального объема ПО из (П1.20) следует, что число ошибок в ПО:
 (А.24)
Модель IBM
Модель рассмотрена в работе [20]. Эта модель предназначена для оценки количества вносимых ошибок в сопровождаемом ПО, находящемся в эксплуатации, при его модификации. Модель построена на данных сопровождения 19 версий ОС OS/360 фирмы IBM.
Пусть Mi – число модулей i–ой (новой) версии. Из них
СИМi – число измененных по отношению к предыдущей версии модулей,
НМi – число новых модулей (то есть Мi = Мi–1 + НМi),
МИМi – число многократно измененных и исправленных модулей (10 и более раз),
ИМi – число модулей, в которые внесено менее 10 изменений.
Из практики сопровождения OS/360 и создания ее новых версий были выявлены следующие зависимости:
ИМi = 0,9 Ч НМi + 0,15 Ч СИМi
МИМi = 0,15 Ч ИМi + 0,06 Ч СИМi.
Число ожидаемых ошибок равно:
N = 23 Ч МИМi + 2 Ч ИМi .
Основные выводы, следующие из модели IBM, таковы:
количество ожидаемых ошибок в следующей версии может увеличиться по сравнению со старой версией, если будет изменено достаточно большое количество старых модулей (СИМ) и/или будет введено достаточно большое количество новых модулей (НМ). Поэтому перед выпуском такой версии понадобятся дополнительные усилия по ее тестированию;
введение новых модулей быстрее приводит к появлению ошибок, чем исправление старых модулей. Однако, если удастся вместо изменения большого числа старых модулей создать несколько новых с требуемой функциональностью, то это приведет к уменьшению оценки ожидаемых ошибок. То