Системное автоматизированное проектирование
- за счет введения ненулевых порогов, что позволяет увеличить число устойчивых состояний системы ( их число в общем случае N находится между 1 и 2 ).
в) ХЕММИНГОВА СЕТЬ
Хеммингова сеть представлена на рис. .
Она состоит из двух частей. Нижняя подсеть служит для формирования по входу - бинарному вектору длиной N - начального состояния для нейронов верхней подсети. Число нейронов в ней M.
Веса
связей
 для нижней
подсети и
 для верхней,
а также пороги
 для нижней
подсети устанавливаются
по следующим
правилам:
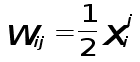 ,
= N/2 , i=1,...,N , j=1,..., M, (4)
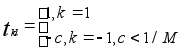 .
Пороги для
верхней подсети
устанавливаются
равными нулю.
В выражении
(4)
 - i-ый элемент
j-го вектора
памяти (число
нейронов в
среднем слое
M совпадает с
числом записанных
образов).
Рис. Схематическое изображение хемминговой сети.
В данной сети выполняются итерации для нейронов верхней подсети
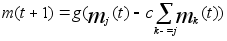
при начальном условии
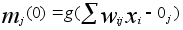 .
Функция g в этих выражениях соответствует рис.3б, причем динамика чувствительна к выбору величины переходной области а. Процесс итераций продолжается до тех пор, пока выходы всех нейронов,
за исключением одного, не станут отрицательными.
Имеется другое название сети Хемминга - сеть с латеральным торможением ( явление латерального торможения широко распространено в нейрофизиологии).
г) ПЕРЦЕПТРОНЫ
Простейший персептрон состоит из одного слоя нейронов, соединенных связями с N входами. Соответствующая схема представлена на рис. .
Веса
связей обозначены
, i=1,...,N , j=1,...,M (M - число
нейронов - пороговых
элементов в
слое). Каждый
из нейронов
осуществляет
нелинейное
преобразование
сигналов,
поступающих
на его вход,
согласно выражению
(1)
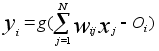 ,
(6)
где
g - пороговая
функция, изображенная
на рис.3а,
 - входные значения,
 = 0,1 - переменные
характеризующие
выходы нейронов.
Переменные
могут принимать
произвольные
значения ( в
частности,
могут быть
аналоговыми).
Согласно ( 6 ),
персептрон
разделяет все
N -мерное пространство
входных переменных
{
} на классы
посредством
гиперплоскостей.
Они определяются
уравнениями
вида:
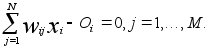
Может существовать не более 2 таких классов. Веса связей и пороги могут быть фиксированными либо изменяться адаптивно. Простейший алгоритм адаптации был предложен Розенблаттом.
Рассмотрим случай, когда М=1.
В этом случае персептрон осуществляет разбиение множества всех входов на два класса
A ( y= +1
) и B ( y= -1 ). Модификация
весов связей
 (j= 1 ) производится
после каждого
вычисления
выхода нейрона в соответствии с выражением ( 6 ) при подаче на вход сети очередного вектора обучающей выборки:
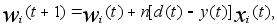
где 0 < n <= 1, y (t) - состояние выхода нейрона при входном векторе x(t), для которого желаемым вектором является d(t). Если выход совпадает с желаемым вектором, связи не изменяются.
Розенблатт показал, что если входные векторы , принадлежащие поочередно одному из двух классов, разделимы в пространстве входов некоторой гиперплоскостью, то указанный алгоритм сходится.
Недостатком простых однослойных персептронов является невозможность построить сложную разделяющую гиперповерхность в пространстве входов. Для того, чтобы это сделать, используют более
сложные модели - многослойные персептроны ( см. рис. ). В этих моделях вводятся "скрытые" слои нейронов, элементы которых не связаны непосредственно с входами и выходами системы.
Двухслойные персептроны позволяют формировать выпуклые оболочки в пространстве входов
(отвечающие тому или иному классу).
Трехслойные персептроны дают возможность построить области произвольной сложности. При этом ограничение только на число используемых в сети нейронов.
Однако, обучение таких сетей является весьма трудоемким процессом и для формирования необходимых матриц связей необходимо применять специальные алгоритмы.
АЛГОРИТМЫ ОБУЧЕНИЯ НЕЙРОННЫХ СЕТЕЙ
Возможность обучения является важнейшей отличительной особенностью нейросетевого подхода к построению систем обработки информации. Имеется большое число вариантов процедур обучения ней-
ронных сетей. Они могут быть разделены на два класса: обучение с супервизором и обучение без супервизора или самообучение. Использование того или иного алгоритма обучения в значительной мере
определяется архитектурой сети.
ОБУЧЕНИЕ С СУПЕРВИЗОРОМ
В
этом случае
формируется
обучающая
выборка - совокупность
входных векторов
{
 , s=1,...,N }, каждому из
которых поставлен
в соответствие
определенный
выходной вектор
из множества
{ , p,...M }. Размерности
входного N и
выходного M
векторов могут
не совпадать.
Процедура
обучения производится
при заданной
топологии
связей между
нейронами. При
этом необходимо
подобрать
их веса таким образом, чтобы при подаче на вход сети любого входного вектора из обучающей выборки на ее выходе формировался правильный выходной вектор.
Сеть, удовлетворяющая этому требованию, является обученной.
Одним из первых алгоритмов, предложенных для обучения персептронов еще в 60-х годах, был алгоритм Уидроу-Хоффа.
Рассмотрим его. Алгоритм предполагает выполнение последовательности шагов. Каждый шаг в свою очередь состоит из двух этапов.
ЭТАП 1. На вход сети подается один из векторов обучающей выборки. На выходе сети задается желаемый выходной вектор. Веса всех связей, соединяющих активные входные и выходные нейроны, увеличиваются на малую величину del.
ЭТАП 2. На вход сети подается тот же вектор из обучающей выборки. Нейронной сети предоставляется возможность в соответствии с имеющимися весами связей самой установить на выходе определенный вектор. Если нет соответствия между входным и выходным векторами, то веса связей, соединяющих активные входные и выходные нейроны, уменьшаются на ту же величину del.
Если сеть правильно установила выходной вектор, то обучение завершается. В противном случае - обучение продолжается.
Принципиальная трудность, присущая рассматриваемому подходу, состоит в том, что для многих обучающих выборок невозможно провести необходимое распределение связей между нейронами персептрона. Указанное ( невозможность обучения произвольному набору образов) присуще, по-видимому, всем нейронным сетям. Обратное справедливо лишь для сетей, содержащих бесконечное число нейронов,
имеющих два слоя и если выполняются ограничения на характеристики выход-вход нейрона.
Даже при существовании искомого отображения проблема обучения нейронной сети сталкивается с серьезными трудностями. Они связаны с тем, проблема обучения нейронных сетей относится к классу
NP-сложных. Т.е. не существует алгоритма, который бы за полиномиальное время ( время, растущее с размером сети не быстрее полинома конечной степени) решил задачу требуемой модификации связей
сети. Поэтому , при практическом обучении нейронных сетей ( в частности, многослойных сетей) неизбежно использование различных эвристик, позволяющих за ограниченное время найти приближенное
решение задачи обучения.
Имеется достаточное количество эвристических методов, среди них наибольшее распространение получил метод "обратного распространения ошибки" ( back- propagation error, BPE ).
Алгоритм BPE представляет собой обобщение метода наименьших квадратов применительно к многослойным персептронам. В данном методе минимизируется среднеквадратичная ошибка между фактическим выходом персептрона и желаемым выходным вектором. Начальные веса и пороги принимаются равными случайно выбранным числам. Затем на вход сети последовательно подаются векторы из обучающей выборки и модифицируются связи между нейронами, начиная с последнего слоя.
Представим ценностную функцию в виде:
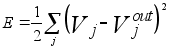
где V - фактические значения состояния нейронов, вычисленные с учетом текущих значений связей между нейронами. В этом выражении сумма распространяется на нейроны последнего ( выходного) слоя.
Изменение весов связей на каждом шаге алгоритма производится по правилу:

где > 0 - параметр. Вычисляя производную в этом выражении, для выходного слоя нейронов получим:
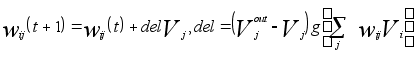 .
Затем последовательно вычисляются изменения коэффициентов на предшествующих слоях.
Такой способ модификации связей в сети позволяет значительно сократить время, необходимое для обучения сети. Вообще , время обучения существенно зависит от требуемой сложности разбиения
пространства возможных входов сети на подклассы ( например, если построить несвязные области ).
3.2. ОБУЧЕНИЕ БЕЗ СУПЕРВИЗОРА
Подобный подход применим к нейронным сетям Гроссберга-Карпентера и Кохонена. Такие сети имеют другое название - самоорганизующиеся сети. Процесс их обучения выглядит как процесс возникновения определенных свойств при взаимодействии системы с внешним миром. Сети такого типа наиболее близки по своим свойствам к неравновесным физическим, химическим или биологическим системам, в которых возможно образование диссипативных структур. Распознание образов и обучение, по-видимому, тесно связаны с вопросом о коллективном поведении систем, включающим множество частиц.
Сущность обучения без супервизора можно пояснить следующим образом. Для этого рассмотрим динамическую систему, элементы которой ( нейроны) взаимодействуют между собой и термостатом.
Состояние i-го нейрона будем описывать непрерывной переменной m (t) ( t - время ), изменяющейся в интервале - m<= m <=+m .
Предположим также, что энергия системы является квадратичной функцией вида
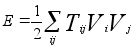 ( 7 )
Будем рассматривать величину
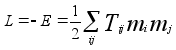 ( 8 )
В
дальнейшем
al - параметр или
лагранжиан
взаимодействия
системы, являющейся
функционалом
независимых
переменных
 и
 .
Учитывая
взаимодействие
нейронов с
термостатом,
приводящее
к появлению
"сил трения"
(m / gam ,
T/
gam ) из (8)получим
динамические
уравнения для
 и
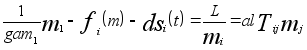 ( 9 )
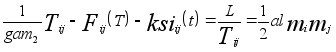 ( 10 )
Добавленные в эти уравнения нелинейные слагаемые (f, F) препятствуют неограниченному возрастанию абсолютных величин m и Т: в рамках лагранжевой схемы они могут быть включены в выражение (9 ) в виде потенциалов, быстро возрастающих вблизи точек + -m и + - T ( предельное значение для коэффициентов матрицы связей).
Величины
 и
 представляют
собой ланжевеновские
источники шума.
В нейробиологии
шум возникает
вследствие
несинаптических
взаимодействий
между нейронами
и выделением
нейромедиаторов.
В электронных
моделях нейронных
сетей источником
шума могут быть
электрические
флуктуации
в цепях. В простейшем
случае шум
можно охарактеризовать
введением
эффективной
температуры:
 > =
 >
 ,
 >
=
 >
= 0 ,
где скобки обозначают усреднение по времени.
Уравнения (9) и
(10) описывают
существенно
различные
физические
процессы, которые
в рассматриваемом
контексте
можно назвать
"обучением"
и "распознаванием
образов". Рассмотрим
первое из
них. Обучение
состоит в том,
что в (9) включается
сильное внешнее
поле, действующее
в течение времени
t . В результате
того вектор
m(t) принимает
стационарное
значение fi ,
соответствующее
"образу"
с компонентами
 m
 . После "обучения"
элементы матрицы
 , со временем
в соответствии
с уравнением
(10), получат
приращение
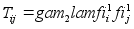 ( при этом предполагается,
что t значительно
больше времени
релаксации
на внешнем
поле вектора
m к своему стационарному
значению fi ).
Процедуру
обучения можно
повторить
многократно,
используя
образы fi
 , s=1,...,n. Считая, что
до начала обучения
= 0, после окончания
этого процесса
получим
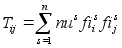 ,
где
коэффициенты
nu
зависят от
длительности
обучения. Таким
образом, уравнения
(9) и (10) описывают
процесс запоминания
поступающей
в систему информации
в виде матриц
связей хеббовского
вида.
Ранее
предполагалось,
что до начала
обучения нейронная
сеть не содержит
никакой информации,
= 0. Можно рассмотреть
противоположный
случай, когда
до начала обучения
нейронная сеть
имеет большое
число устойчивых
состояний.
Предполагается,
что доминируют
глубокие
энергетические
минимумы, которые
могут образовывать
структуру
дерева. Процедура
обучения должна
приводить к
селекции образов
. В процессе
обучения заучиваемый
образ задается
в качестве
начального
состояния сети
и эволюционирует
к некоторому
аттрактору,
энергия которого
уменьшается
за счет синоптических
изменений ( в
частности, если
время релаксации
меньше времени
обучения), а
область притяжения
смещается и
увеличивается
за счет
присоединения соседних областей. Таким образом, процесс селекции отличается от режима обучения, рассмотренного ранее тем что используется внешнее поле.
ОСНОВНЫЕ ФУНКЦИИ НЕЙРОННЫХ СЕТЕЙ
АССОЦИАТИВНАЯ ПАМЯТЬ И КАТЕГОРИЗАЦИЯ
Под ассоциативной памятью ( или памятью, адресуемой по содержанию) понимается способность системы нейронов, например, мозга млекопитающих восстанавливать точную информацию по некоторой
ее части. К этому определению близок процесс категоризации - отнесение предъявленного объекта к одному из классов. Многие из предложенных в настоящее время сетей способны фактически осуществлять эти функции. При этом критерии, по которым осуществляется отнесение объектов к тому или иному классу ( распознавание) , различны в разных моделях.
Рассмотрим в качестве примера модель Хопфилда.
Пусть
сначала n=1 b и в
матрице Т записан
всего один
образ fi . Скалярноe
произведение
произвольного
вектора m и fi
задается
выражением
(fi
, m ) = N - 2 m, где m - хеммингово
расстояние
между векторами
m и fi,
равное числу
элементов,
отличающих
эти векторы.
Подставляя
это выражение
в ( 7 ), получим
следующее
выражение для
энергии:
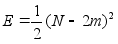 .
Из
данного выражения
видно, что Е
принимает
минимальное
значение при
m=0. При этом вектор
М совпадает
с записанным
образом
либо, когда
m=N ( в этом случае
m совпадает с
"негативом"
). Поэтому эволюция
любого начального
состояния
системы заканчивается
в состояниях
m =
fi
.
В случае n = 2 выражение для энергии имеет вид
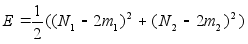 .
Здесь
N
- число позиций,
в которых компоненты
записанных
в Т векторов
совпадают: fi=
fi , N- число несовпадающих
компонент этих
векторов, для
которых