Создание макроса на языке Statistica Visual Basic для проверки гипотезы о нормальности остатков регрессии
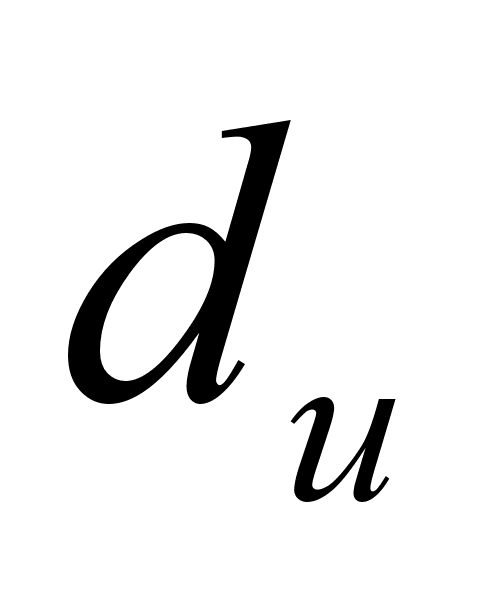 и
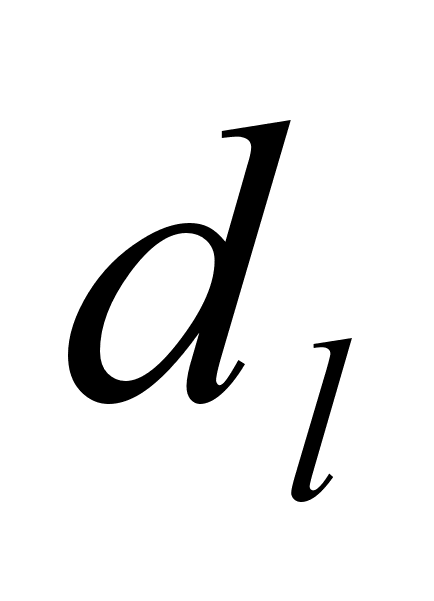 ,
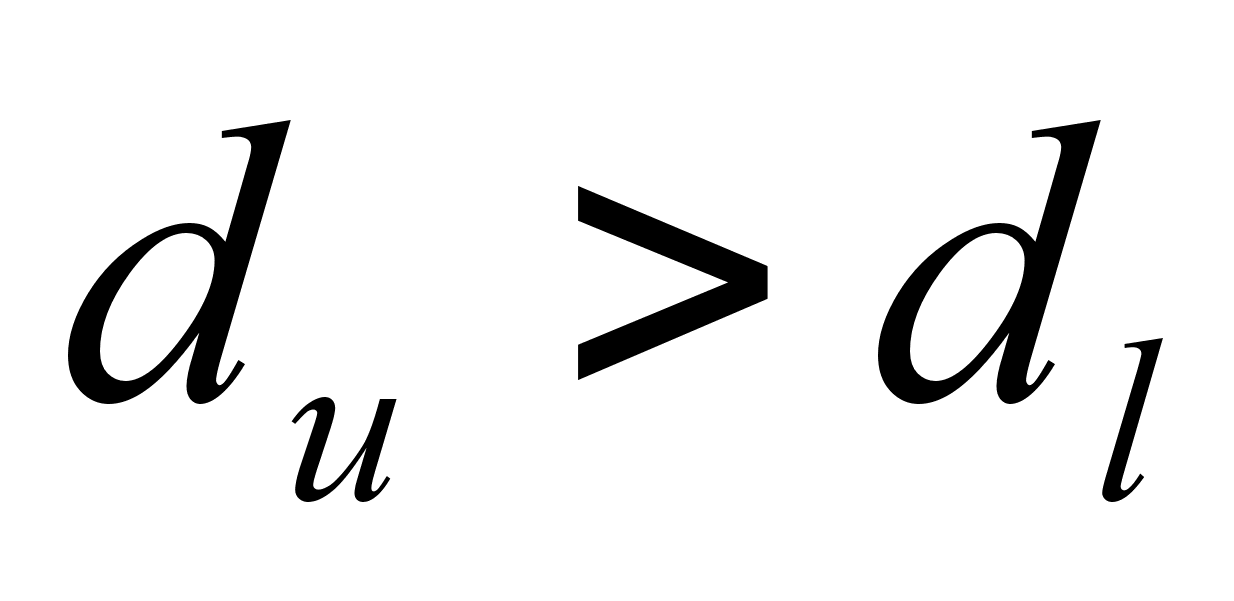 (и = upper
- верхняя, l
= low
- нижняя), которые
зависят лишь
от n,
к и уровня
значимости
(а следовательно,
могут быть
затабулированы)
и обладают
следующим
свойством:
если
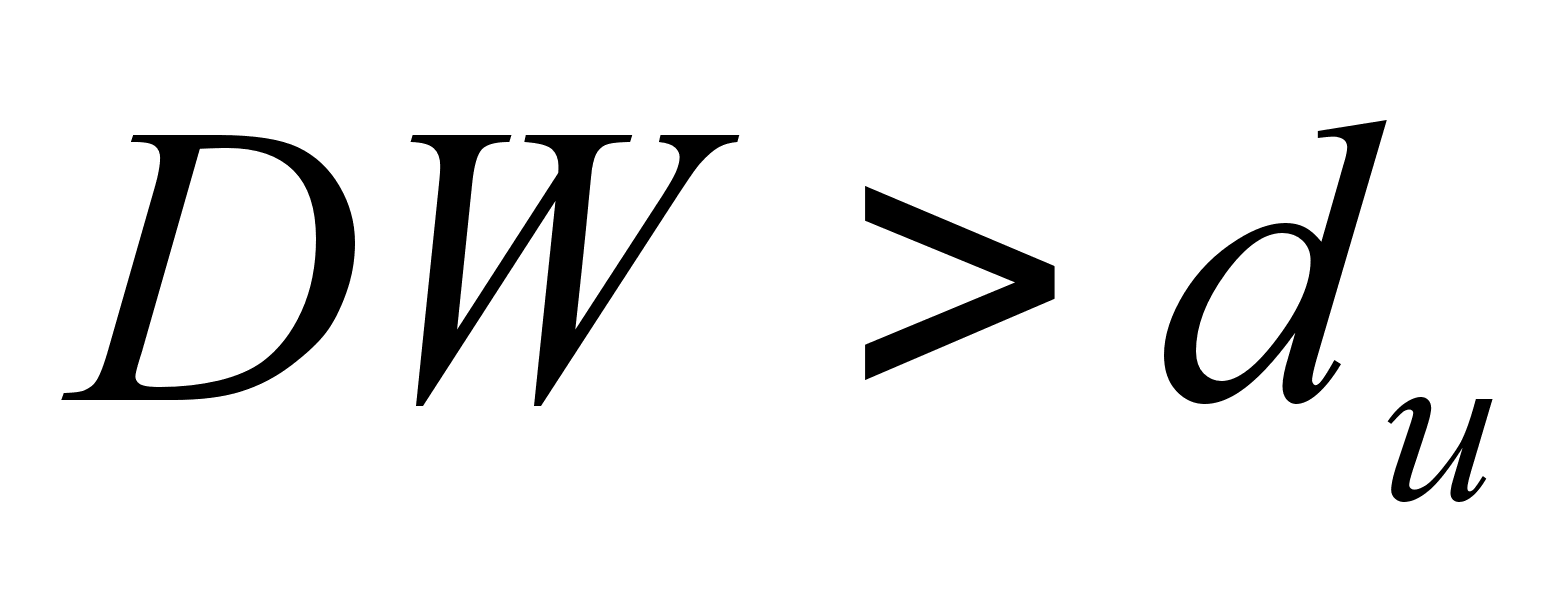 ,
то
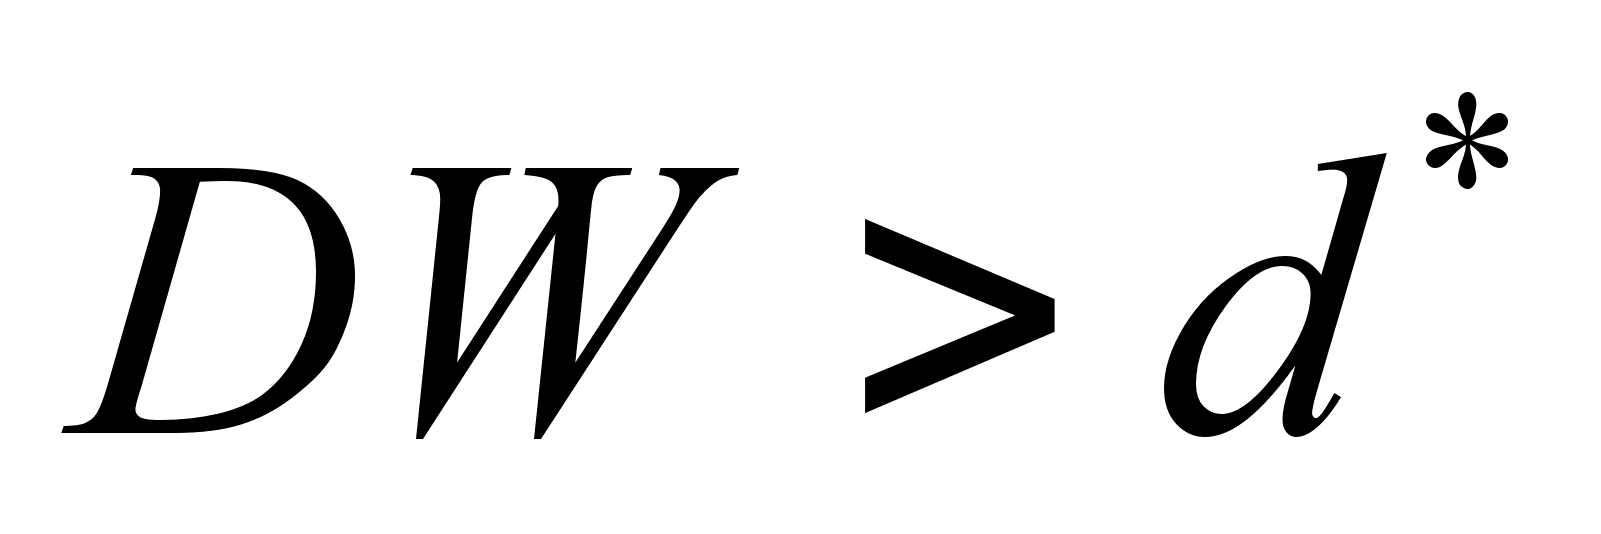 и, значит,
гипотеза H0
не отвергается,
а если
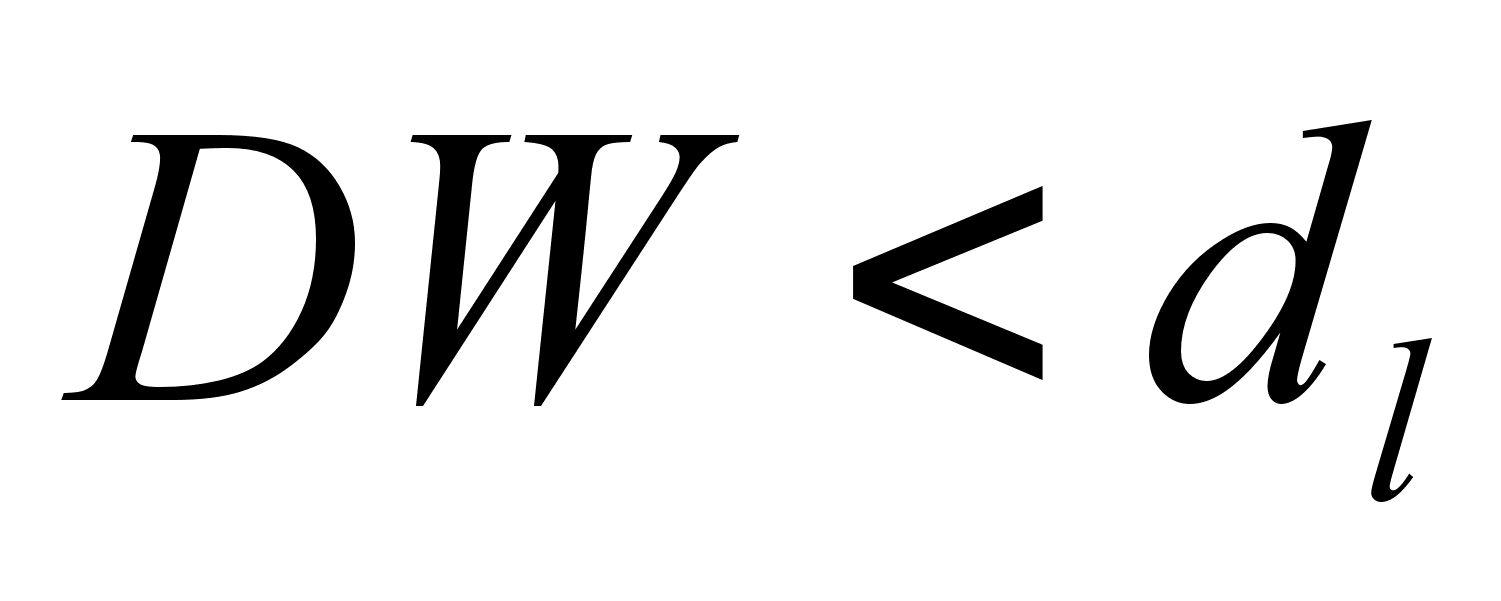 то
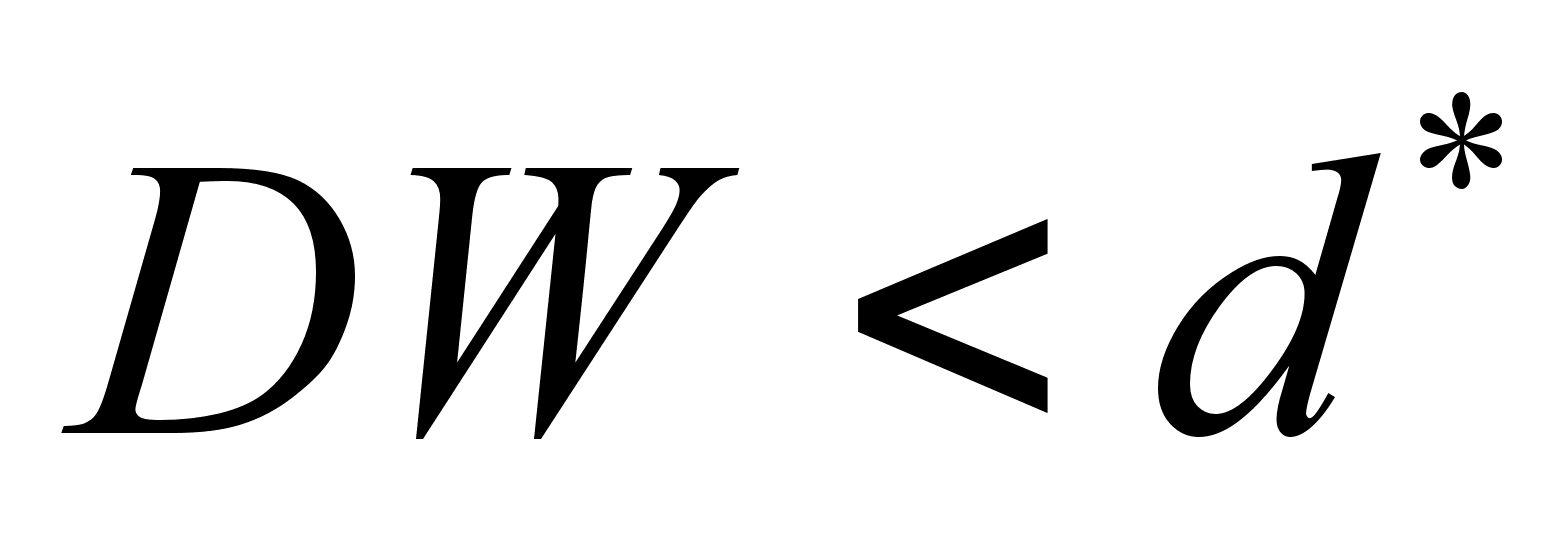 ,
и гипотеза Но
отвергается
в пользу H1.
В случае
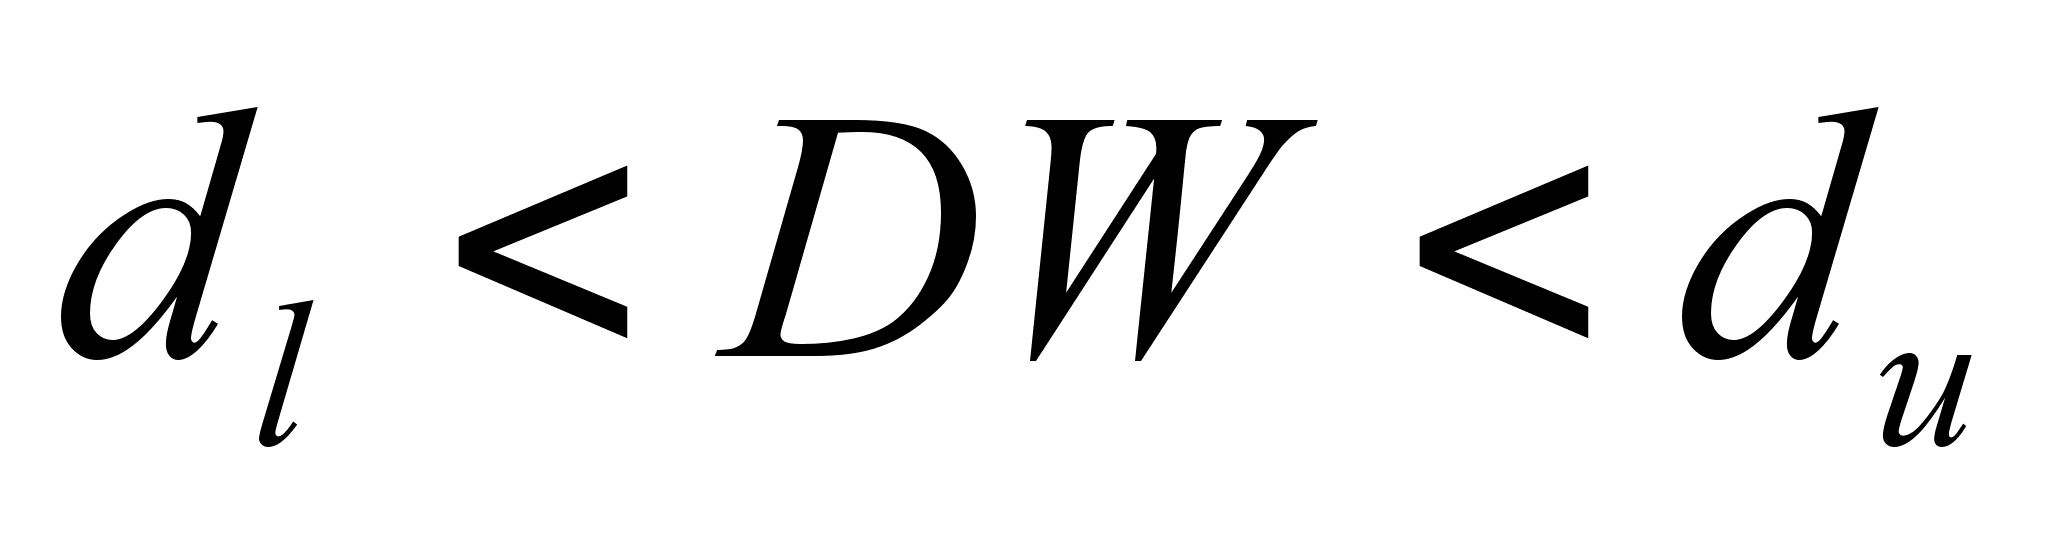 ситуация
неопределенна,
т. е. нельзя
высказаться
в пользу той
или иной гипотезы.
Если альтернативной
является гипотеза
об отрицательной
корреляции
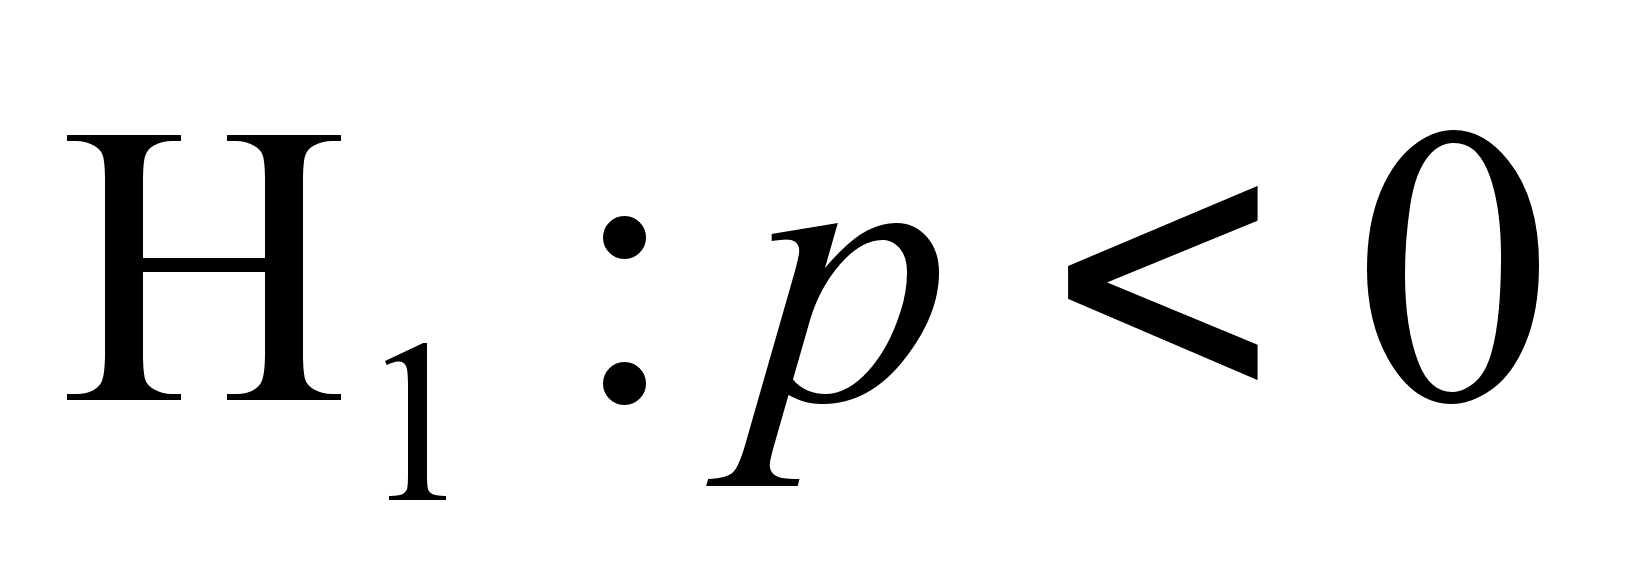 ,
то соответствующими
верхними и
нижними границами
будут 4-dl
и 4-du.
Целесообразно
представить
эти результаты
в виде следующей
таблицы.
Таблица 6.3.
Значение статистики DW
| Значение статистики DW | Вывод |
| 4 -dl< DW < 4 | Гипотеза Но отвергается, есть отрицательная корреляция |
| 4 - du < DW < 4 - dl | Неопределенность |
| du < DW < 4 - du | Гипотеза Но не отвергается |
| dl < DW < du | Неопределенность |
| 0 < DW < dl | Гипотеза Но отвергается, есть положительная корреляция |
Наличие зоны неопределенности, представляет определенные трудности при использовании теста Дарбина-Уотсона. [3]
Отсутствие автокорреляции остаточных величин обеспечивает состоятельность и эффективность оценок коэффициентов регрессии.
При несоблюдении основных предпосылок МНК приходится корректировать модель, изменяя ее спецификацию, добавлять (исключать) некоторые факторы, преобразовывать исходные данные для того, чтобы получить оценки коэффициентов регрессии, которые обладают свойством несмещенности, имеют меньшее значение дисперсии остатков и обеспечивают в связи с этим более эффективную статистическую проверку значимости параметров регрессии. [1]
2.3 Проверка гипотезы о нормальности остатков в модуле Multiple Regression Statistica
STATISTICA является интегрированной системой комплексного статистического анализа и обработки данных в среде Windows. Все методы обработки в системе разбиты на несколько групп - модулей - в соответствии с основными разделами статистического анализа. Модуль Multiple Regression -Множественная регрессия включает в себя набор средств множественной линейной и фиксированной нелинейной (в частности, полиномиальной, экспоненциальной, логарифмической и др.) регрессии, включая пошаговые, иерархические и другие методы. Система STATISTICA позволяет вычислить всесторонний набор статистик и расширенной диагностики, включая полную регрессионную таблицу, частные и частичные корреляции и ковариации для регрессионных весов, статистику Дарбина-Уотсона и многие другие. Анализ остатков и выбросов может быть проведен при помощи широкого набора графиков. [Салманов, с. 245-246]
Модуль Multiple Regression запускается из меню Statistics. Нажмите кнопку Variable на Multiple Linear Regression - Quick tab (Множественная линейная регрессия - Быстрая вкладка) (рис. 1) и выберите зависимую переменную (Dependent variable) и несколько независимых переменных (Independent variable) и затем нажмите кнопку ОК. Появится Multiple Regression Results - диалог результатов регрессионного анализа (рис. 2). [Салманов, с. 249]
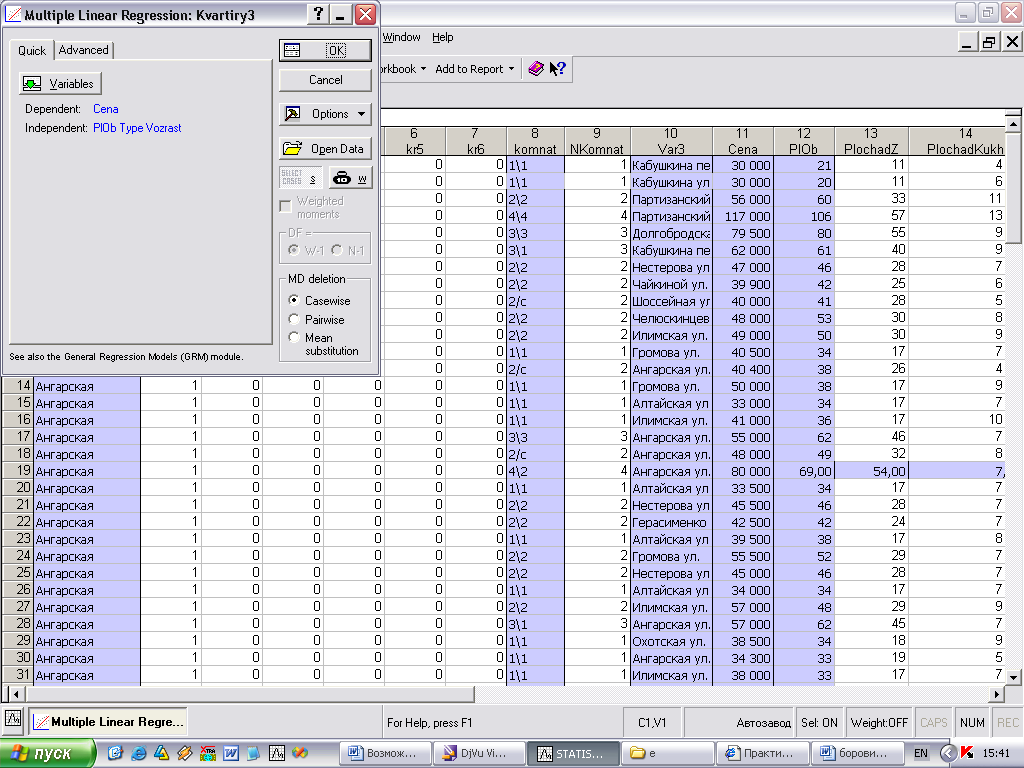
Рис. 1. Стартовая панель модуля Multiple Regression
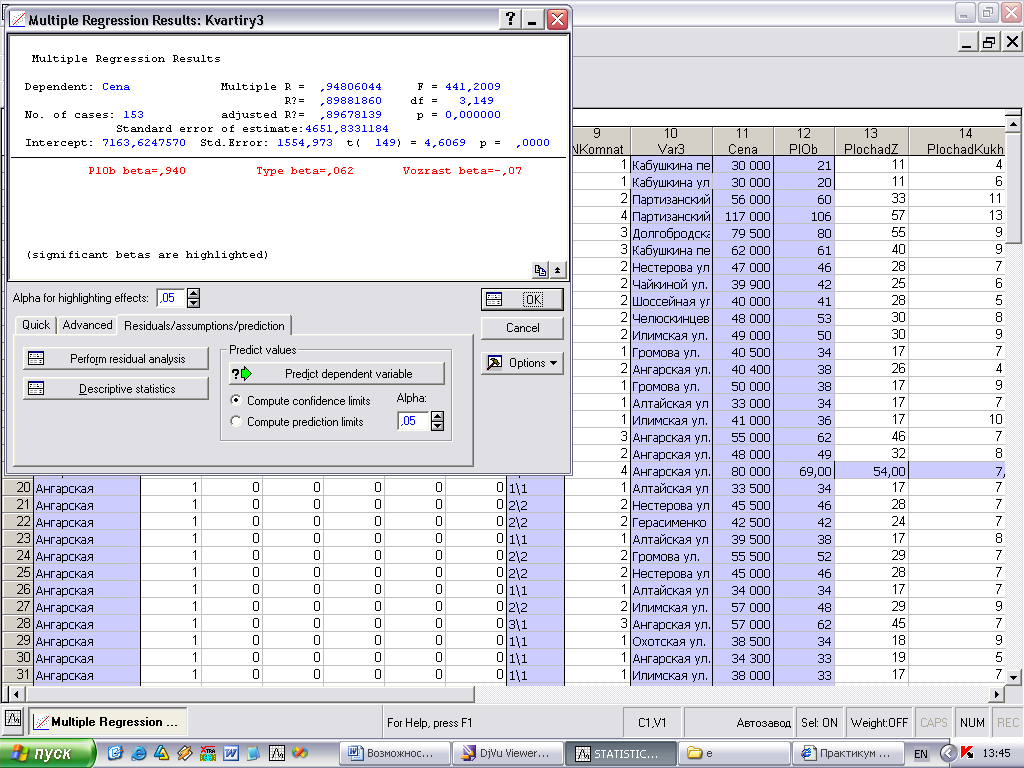
Рис. 2. Окно результатов регрессионного анализа
Окно результатов анализа (Multiple Regression Results) (рис. 2) имеет следующую структуру: верх окна - информационный. Он состоит из двух частей: в первой части содержится основная информация о результатах оценивания, во второй высвечиваются значимые регрессионные коэффициенты (significant beta's are highlighted). Внизу окна расположены три вкладки: Quick-быстрый, Advanced-продвинутый и Residuals/assumptions/ prediction, на которых находятся функциональные кнопки, позволяющие всесторонне просмотреть результаты анализа.[боровиков 136] Критерий для определения уровня статистической значимости может быть изменен в поле Alpha (значение по умолчанию 0,05) .[Салманов, с. 254]
Рассмотрим информационную часть окна. В ней содержатся краткие сведения о результатах анализа, а именно:
Dependent - имя зависимой переменной
No. of сases - число случаев, по которым построена регрессия
Multiple R - коэффициент множественной корреляции
• R2 - коэффициент детерминации (квадрат коэффициента множественной корреляции)
• adjusted R2 - скорректированный коэффициент детерминации
Standard error of estimate - стандартная ошибка оценки
Intercept - оценка свободного члена регрессии, значение коэффициента В0 в уравнении регрессии.
Std.
Error
- стандартная
ошибка оценки
свободного
члена,
стандартная
ошибка коэффициента
В0 в
уравнении
регрессии.
t(df) and p-value - значение t-критерия и уровень р. t-критерий используется для проверки гипотезы о равенстве 0 свободного члена регрессии.
F - значения F-критерия.
df - число степеней свободы F-критерия.
р - уровень значимости. [боровиков 136-138]
Нажмите на Summary: Regression results на вкладке Quick tab, чтобы отобразить электронную таблицу с бета-коэффициентами (рис. 3).
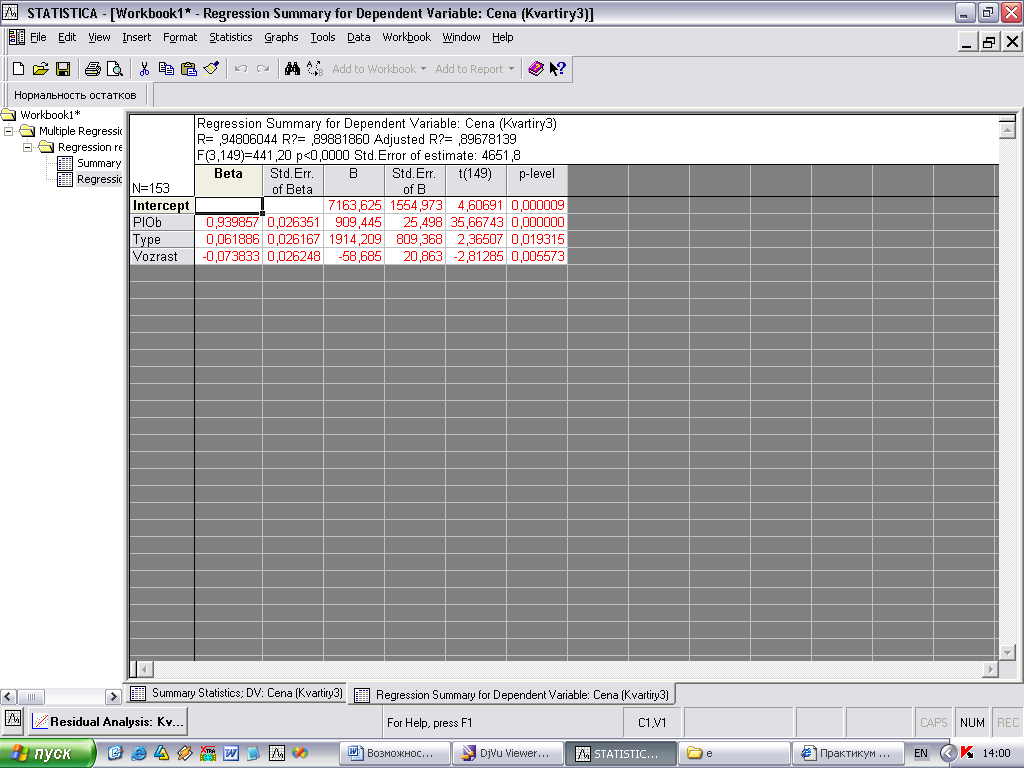
Рис. 3. Таблица коэффициентов уравнения регрессии и оценок их достоверности
Эта электронная таблица показывает стандартизированные бета-коэффициенты регрессии (Beta) и необработанные коэффициенты регрессии (В). Величина этих коэффициентов позволяет сравнивать относительный вклад каждой независимой переменной в предсказании зависимой переменной. Приводится также t-статистика и соответствующее значение вероятности (р) для проверки гипотезы о достоверности этих коэффициентов. [Салманов, с. 254-255]
После того как доказана адекватность модели, полученные результаты можно уверенно использовать для дальнейших действий. Анализ адекватности основывается на анализе остатков. [боровиков 139] Для анализа остатков на вкладке Multiple Regression Results - Residuals/assumptions/prediction tab нажмите кнопку диалога Residual Analysis (рис. 4). [Салманов, с. 256] Здесь имеется возможность рассчитать статистику Дарбина-Уотсона, удаленные остатки, доверительные интервалы для предсказанных значений и многие другие статистики. Широкие возможности анализа остатков и выбросов включают многочисленные типы графиков, диаграмм рассеяния, гистограмм, графики на нормальной и полунормальной вероятностной бумаге и др.[exponenta]
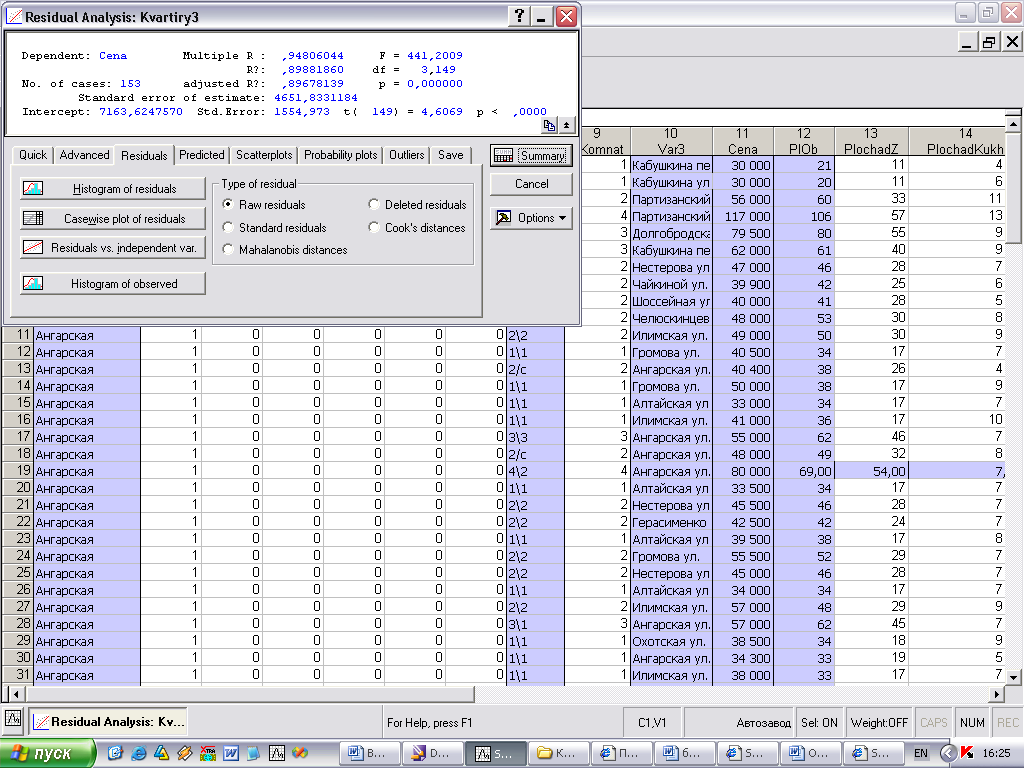
Рис. 4. Окно анализа остатков
Однако можно также применять все аналитические средства STATISTICA, чтобы далее исследовать остатки, создав автономную входную электронную таблицу остатков. [Салманов, с. 261]
3. СОЗДАНИЕ МАКРОСА ДЛЯ ПРОВЕРКИ ГИПОТЕЗЫ О НОРМАЛЬНОСТИ ОСТАТКОВ
3.1 Описание макроса
При построении модели множественной линейной регрессии особое внимание необходимо уделять проверке гипотезы о нормальном распределении остатков. Это связано с тем, что в условиях нормального распределения остатков оценки параметров модели, построенные методом наименьших квадратов, являются оптимальными. Если распределение отличается от нормального, то свойство оптимальности может быть утрачено. Например, в данных могут быть резко выделяющиеся наблюдения (выбросы), а метод наименьших квадратов чувствителен к выбросам.
В данной курсовой работе осуществлялось эконометрическое моделирование вторичного рынка жилья в г. Минске с использованием статистического пакета Statistica 6.0., обладающего широкими возможностями для построения регрессионных моделей. Пакет Statistica 6.0. содержит встроенный язык программирования VBA, позволяющий создавать дополнительные модули для статистического анализа.
В ходе выполнения множественного регрессионного анализа в модуле Multiple Regression исследование остатков на нормальность можно осуществить лишь графическими методами с использованием нормальных графиков вероятности, доступных из диалога Residual Analysis. Однако на основании графической информации можно сделать лишь предположение о виде распределения остатков. Для проверки остатков на соответствие их нормальному распределению необходимо создать автономную входную электронную таблицу остатков, а затем вызвать модуль Distribution Fitting (Подбор распределения). Нажав кнопку Graph, мы получим результаты применения критерия хи-квадрат, а также гистограмму с проведенной на ней предполагаемой нормальной кривой, на основании которых можно сделать вывод о виде распределения остатков.
Таким образом, при осуществлении множественного регрессионного анализа в пакете Statistica 6.0. необходимо использовать 2 отдельных модуля (Multiple Regression и Distribution Fitting), создавая при этом дополнительную входную электронную таблицу остатков, что требует значительных затрат времени.
Для решения всех вышеперечисленных проблем на языке VBA было написано 2 модуля. Первый модуль (CREATE_MACROS) создает пользовательскую панель инструментов (Приложение Б), а второй (regres-normal) - автоматизирует процесс проверки гипотезы о нормальности остатков регрессии (Приложение А).
После запуска программы CREATE_MACROS, новая панель инструментов CUSTOM будет добавлена к существующей инсталляционной версии STATISTICA. Созданная панель инструментов состоит из 1 главного элемента - кнопки «Нормальность остатков». Чтобы удалить новый элемент панели инструментов, выберите Настройка (Customize) из меню Сервис (Tools) для отображения диалога Настройка (Customize). На вкладке Панели инструментов (Toolbars tab), подсветите новый элемент и Удалите (Delete) его (рис. 1.1).
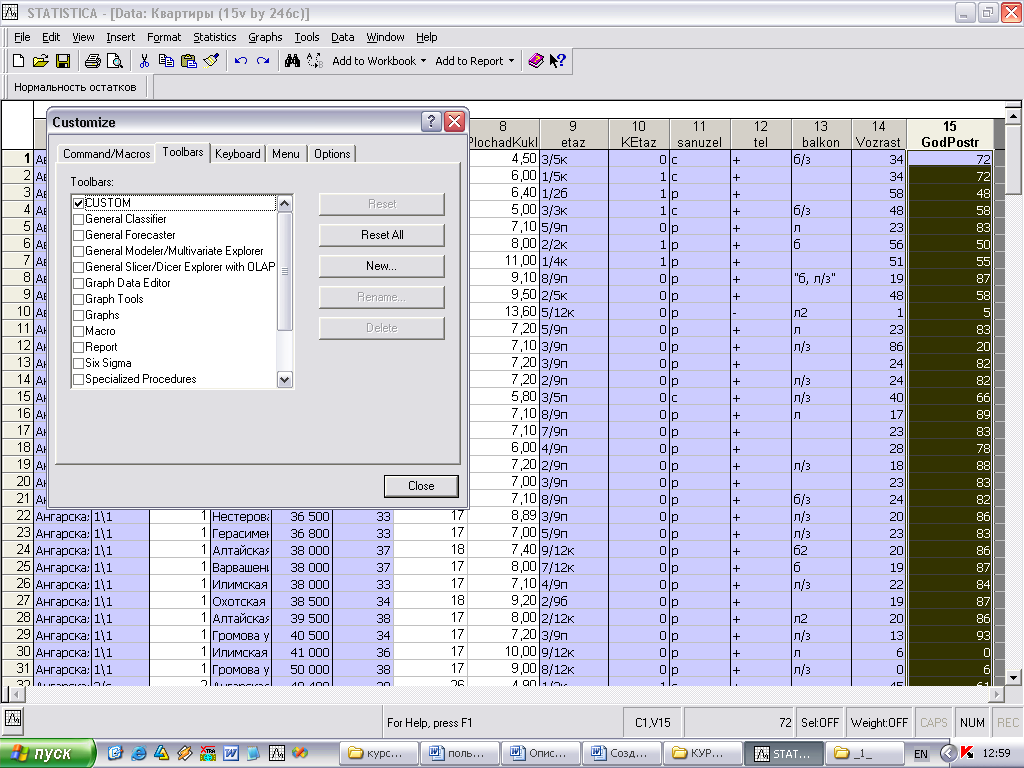
Рис. 1.1. Удаление пользовательской панели инструментов
Для запуска модуля regres-normal необходимо нажать кнопку “Нормальность остатков” на панели инструментов (рис. 1), после чего появится диалог Multiple Regression.Residual Analysis (рис. 2). Критерий для определения уровня статистической значимости может быть изменен в поле Alpha (значение по умолчанию 0,05). При нажатии кнопки Variables отобразится диалог Select dependent and independent variable lists (рис. 3) для выбора зависимой и списка независимых переменных. После нажатия кнопки OK на экране появятся результаты выполнения программы (рис.4).
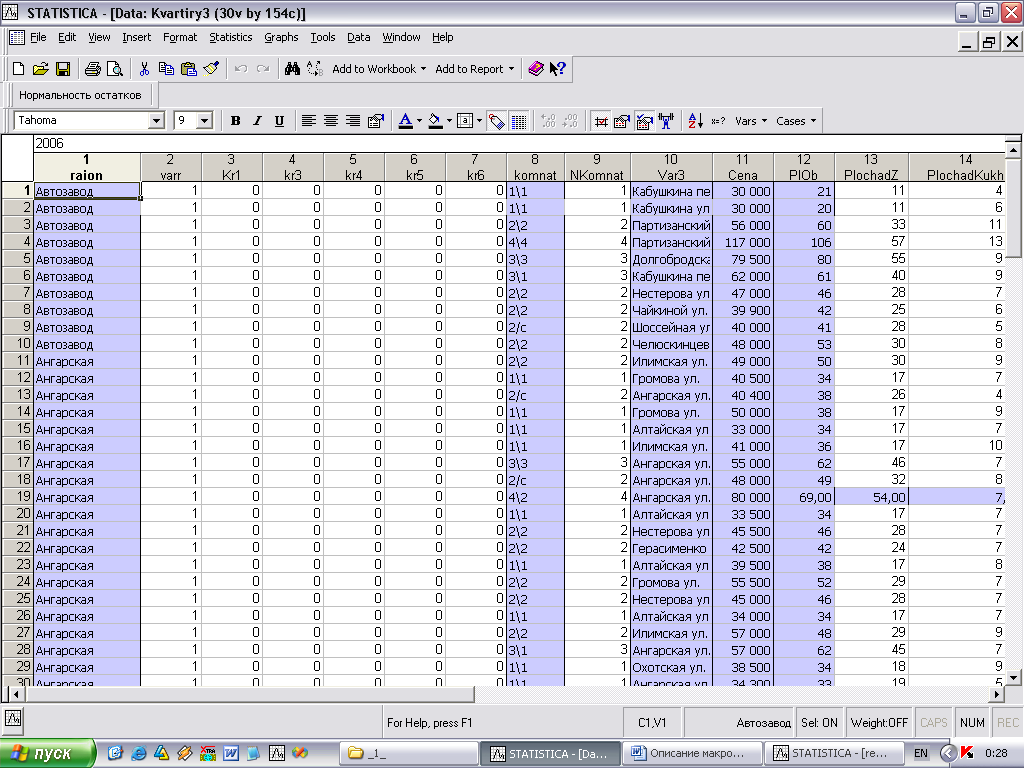
Рис. 1. Кнопка “Нормальностьостатков” для запуска модуля
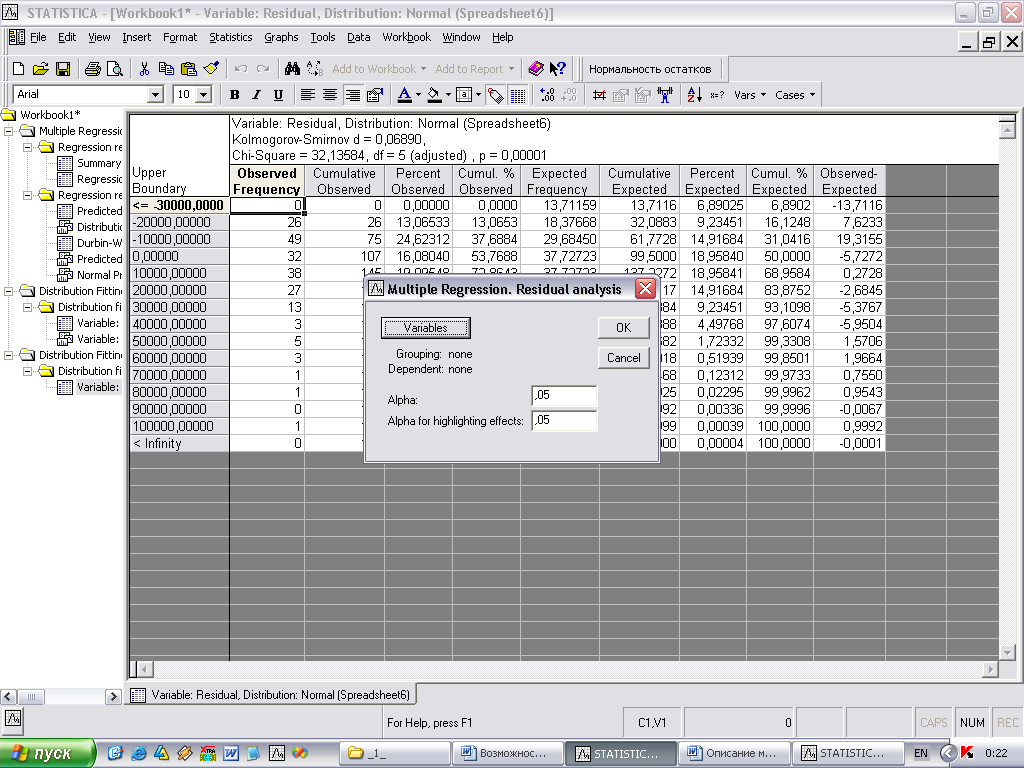
Рис. 2. Стартовая панель модуля
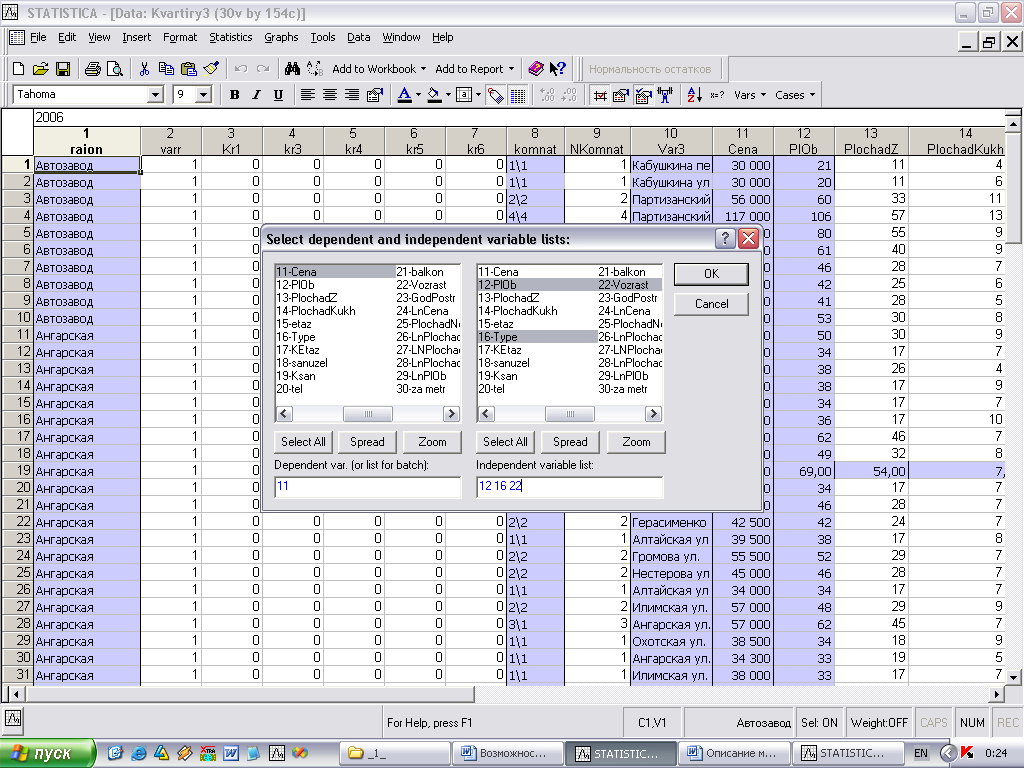
Рис. 3. Окно выбора переменных для анализа
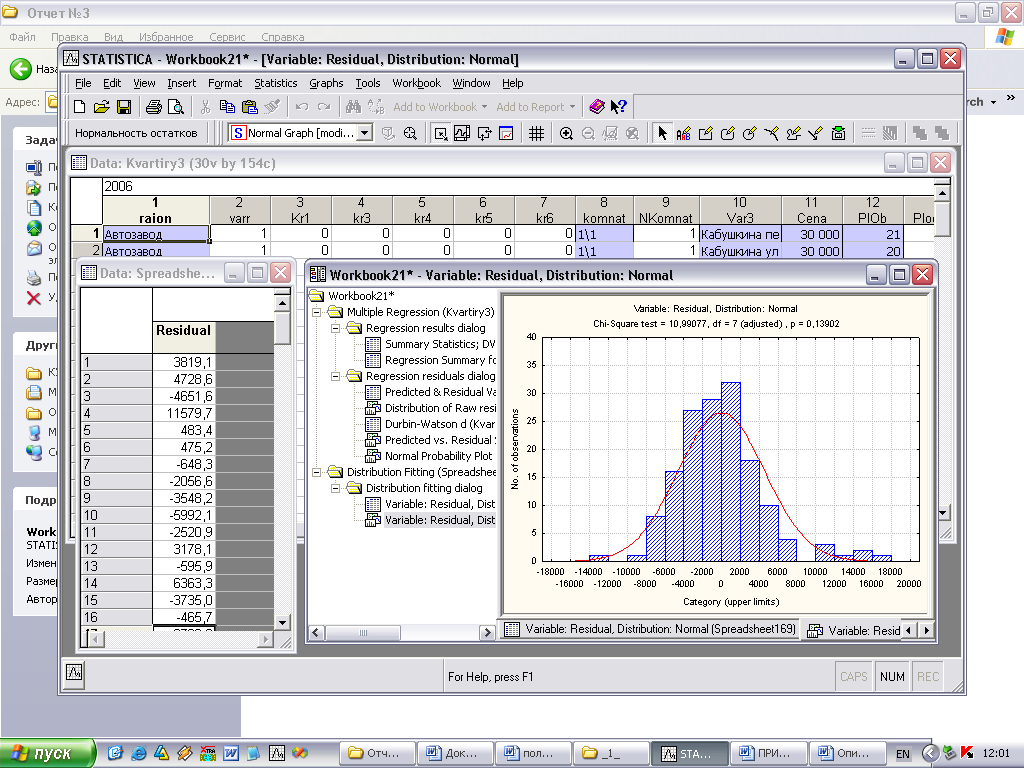
Рис.4. Результаты выполнения программы
Программа вычисляет следующий набор статистик:
Таблицы
результатов
оценивания
регрессионной
модели. Они
содержат значения
коэффициентов
модели (В),
бета-коэффициенты
(Beta),
их стандартные
ошибки, значения
критерия
Стьюдента
для проверки
гипотезы о
достоверности
этих коэффициентов
(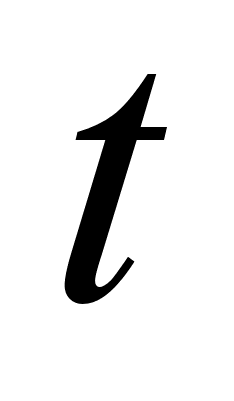 и
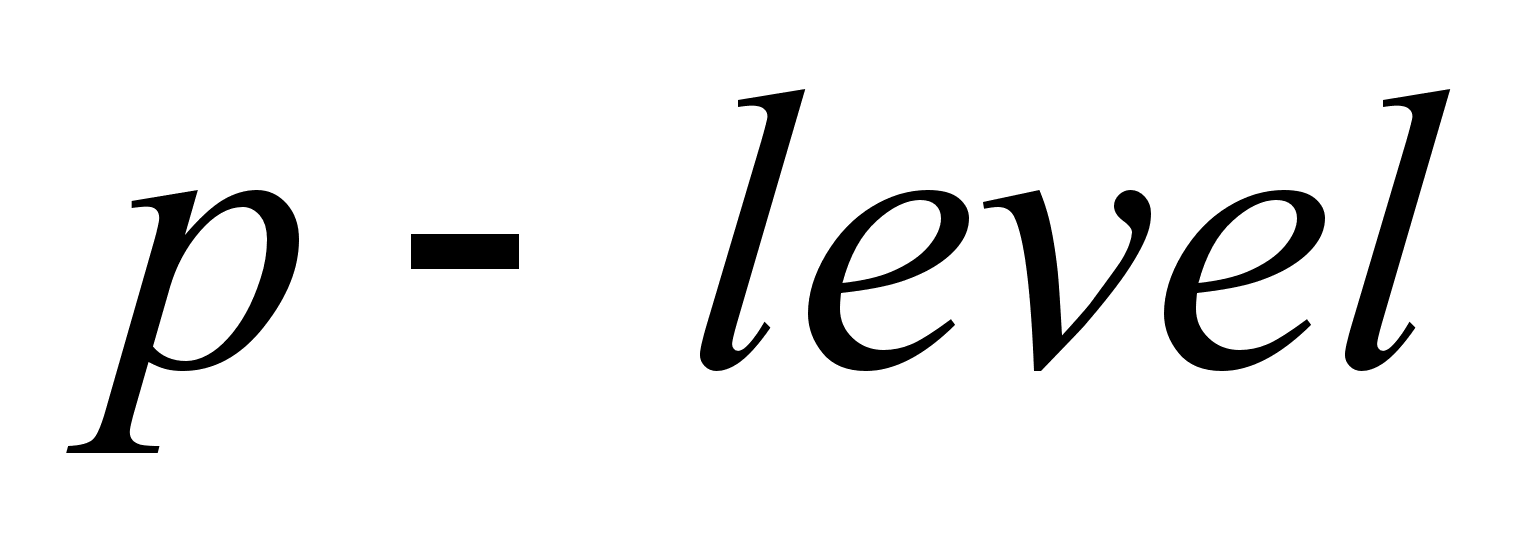 ),
коэффициенты
корреляции
R
и детерминации
R2,
значение критерия
Фишера (F,
p)
для проверки
гипотезы о
достоверности
R
и другое.
Таблицу результатов анализа остатков, содержащую наблюдаемые (Observed Value) и предсказанные по модели (Predicted Value) значения зависимой переменной, остатки (Residual) и другое.
Статистику Дарбина-Уотсона.
Графики: гистограмму остатков, диаграмму рассеяния, график на нормальной вероятностной бумаге.
Таблицу эмпирических и теоретических частот.
Оба модуля написаны на языке STATISTICA VISUAL BASIC. Рассмотрим схему работы программы regres-normal (рис. 5).
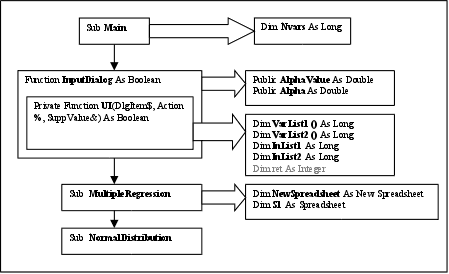
Рис. 5. Схема работы программы regres-normal
Весь блок программного кода в совокупности представляет собой модуль. Модуль regres-normal состоит из ряда операторов, организованных в шесть разделов: это раздел объявлений, начинающийся оператором Option Base 1, процедура Main, функция InputDialog, функция UI, процедуры MultipleRegression и NormalDistribution.
Переменные, содержащиеся в разделе объявлений, представляют собой глобальные переменные (Приложение В, табл. 1). Выполнение программы начинается с процедуры MAIN (рис. 5). Данная процедура вызывает функцию InputDialog, которую в свою очередь обслуживает функция UI. Функция InputDialog отображает пользовательский диалог "Multiple Regression. Residual Analysis", переменные Alpha и AlphaValue инициализируются значениями, содержащимися в соответствующих элементах управления типа TextBox. Функция UI отображает диалог выбора переменных для анализа ("Select dependent and independent variable lists:"). Здесь происходит инициализация списков зависимых и независимых переменных (VarList1(),VarList2()), а также переменных типа Long, хранящих количество элементов в этих списках (InList1, InList2). В случае отсутствия ошибок при вызове пользовательских диалогов далее в процедуре Main происходит последовательный вызов процедур MultipleRegression и NormalDistribution.
В процедуре MultipleRegression осуществляется регрессионный анализ с использованием данных из текущей таблицы (S1), а также происходит инициализация вновь созданной таблицы остатков (NewSpreadsheet). В процедуре NormalDistribution осуществляется проверка остатков из таблицы NewSpreadsheet на нормальное распределение.
3.2 Проверка гипотезы о нормальности остатков в модели вторичного рынка жилья в г. Минске
В модели исследуется зависимость стоимости вторичного жилья в г.Минске (Cena) от следующих факторов: общей площади квартиры (PlOb), возраста дома (Vozrast). Для работы использованы данные о 154 квартирах г. Минска за 2006 год. В модель также включена бинарная, «фиктивная» переменная Type, которая принимает значение 1, если квартира находится в кирпичном доме и значение 0 для всех остальных случаев.
Построенная модель стоимости квартир в г. Минске имеет вид:
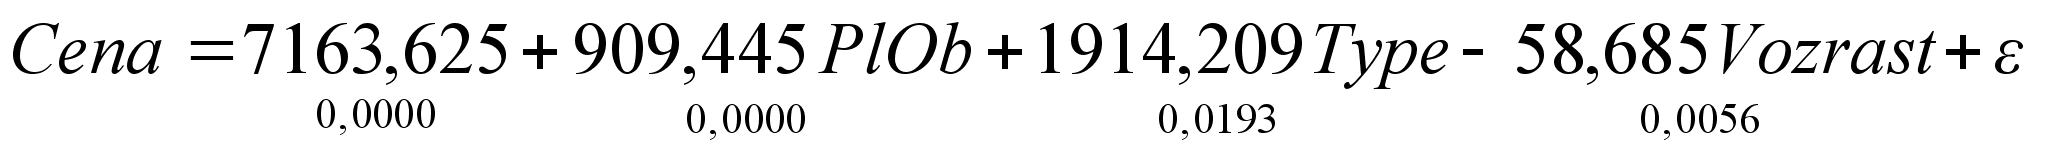 (1)
Все коэффициенты регрессии статистически значимы, что показывает t-статистика и соответствующие значения вероятности (p), которые ниже уровня статистической значимости 0,05.
Для построенной
модели (1) коэффициент
корреляции
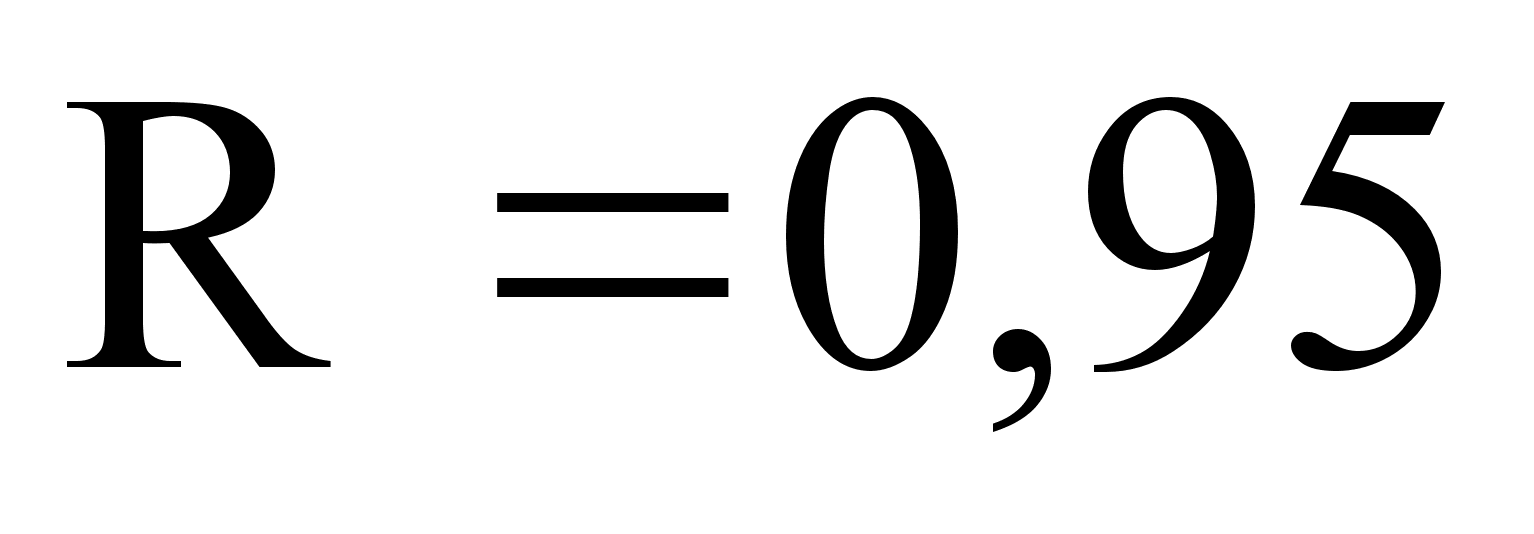 (значение близко
к 1, что указывает
на тесную свяь
между зависимой
переменной
и факторами).
Значение критерия
Фишера для
проверки гипотезы
о достоверности
коэффициента
корреляции:
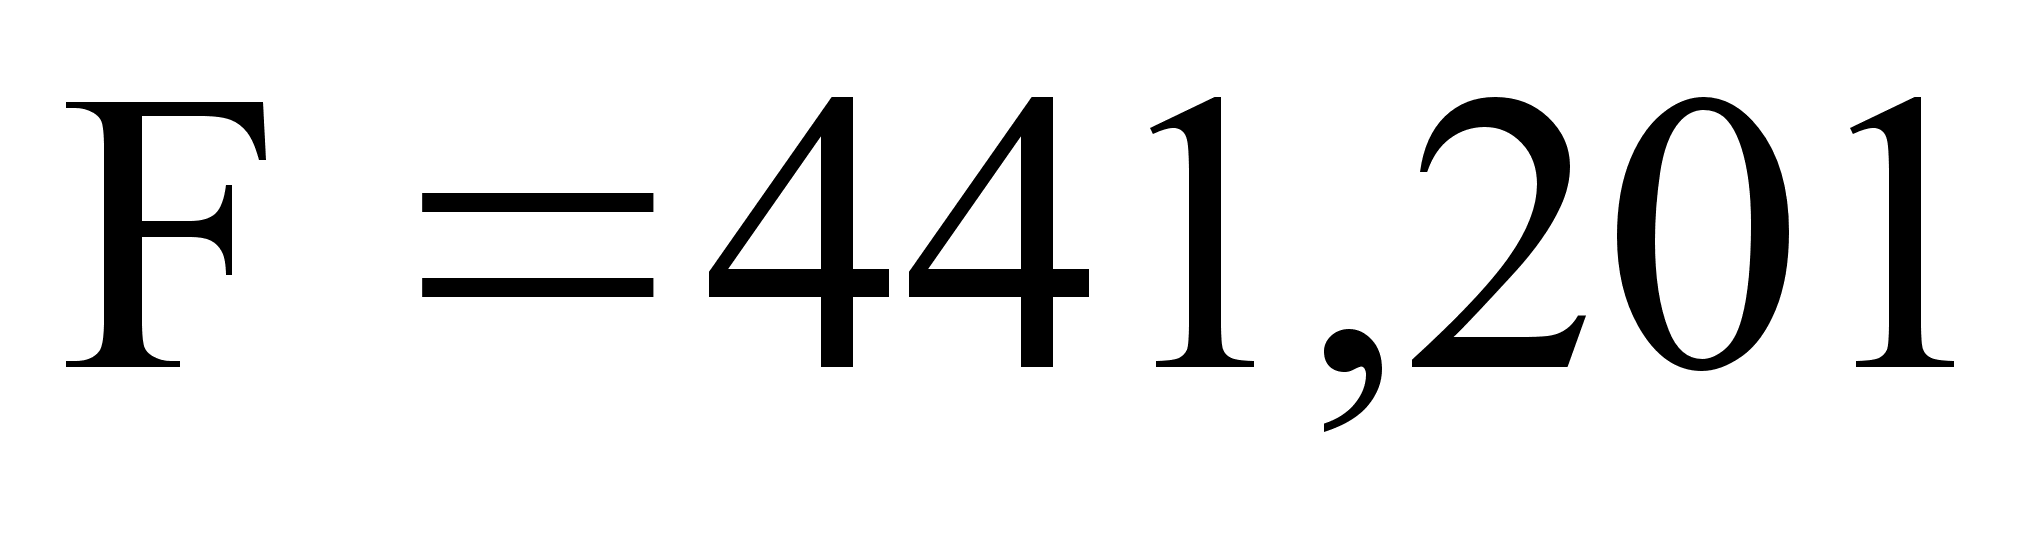 ;
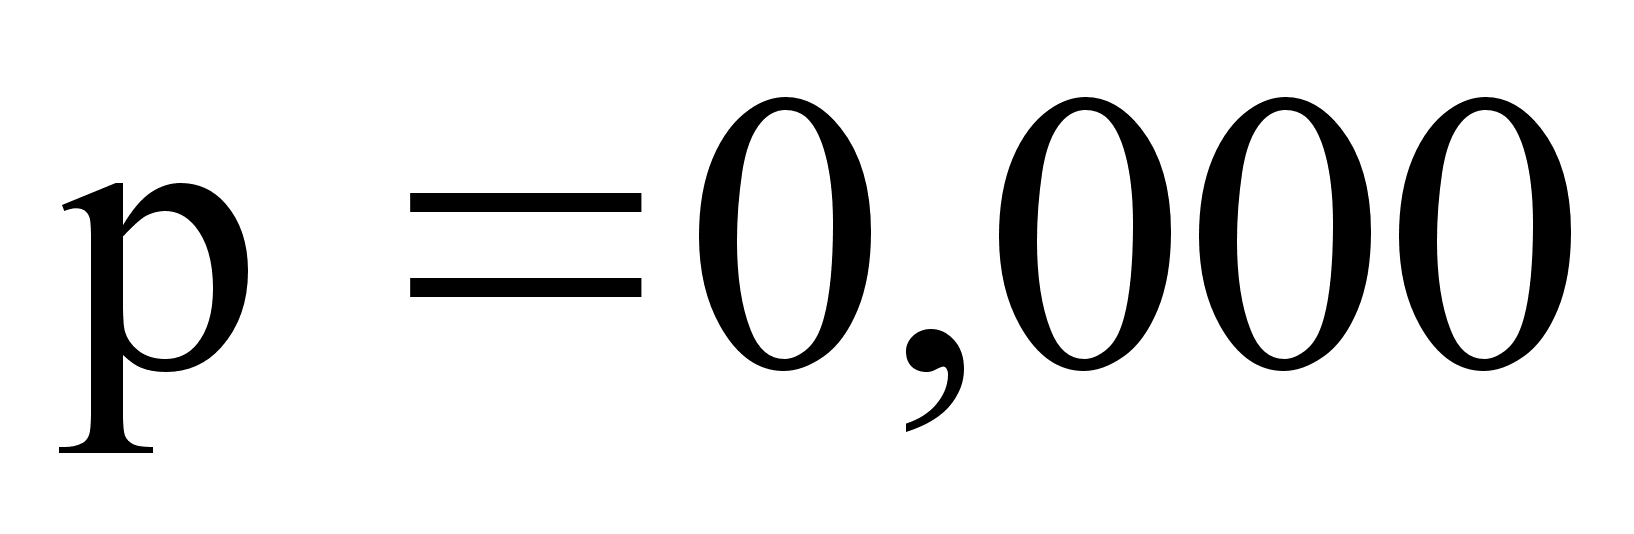 (R
достоверно
отличен от 0,
изучаемый
признак имеет
связь хотя бы
с одним из
регрессоров).
Коэффициент
детерминации
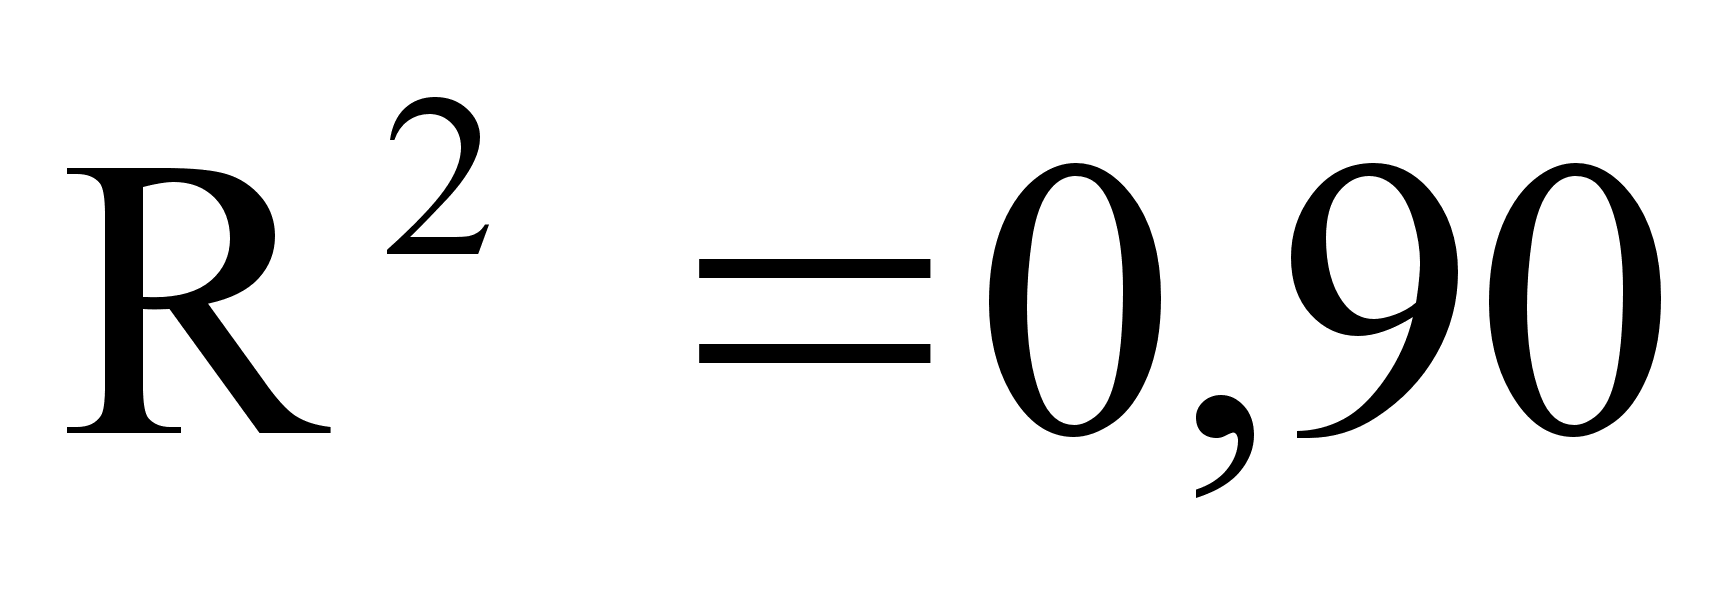 ,
т.е. 90% дисперсии
результативного
признака обусловлено
влиянием регрессии,
а 10% - другими
факторами.
Анализ остатков
произведён
при помощи
статистики
Дарбина-Уотсона
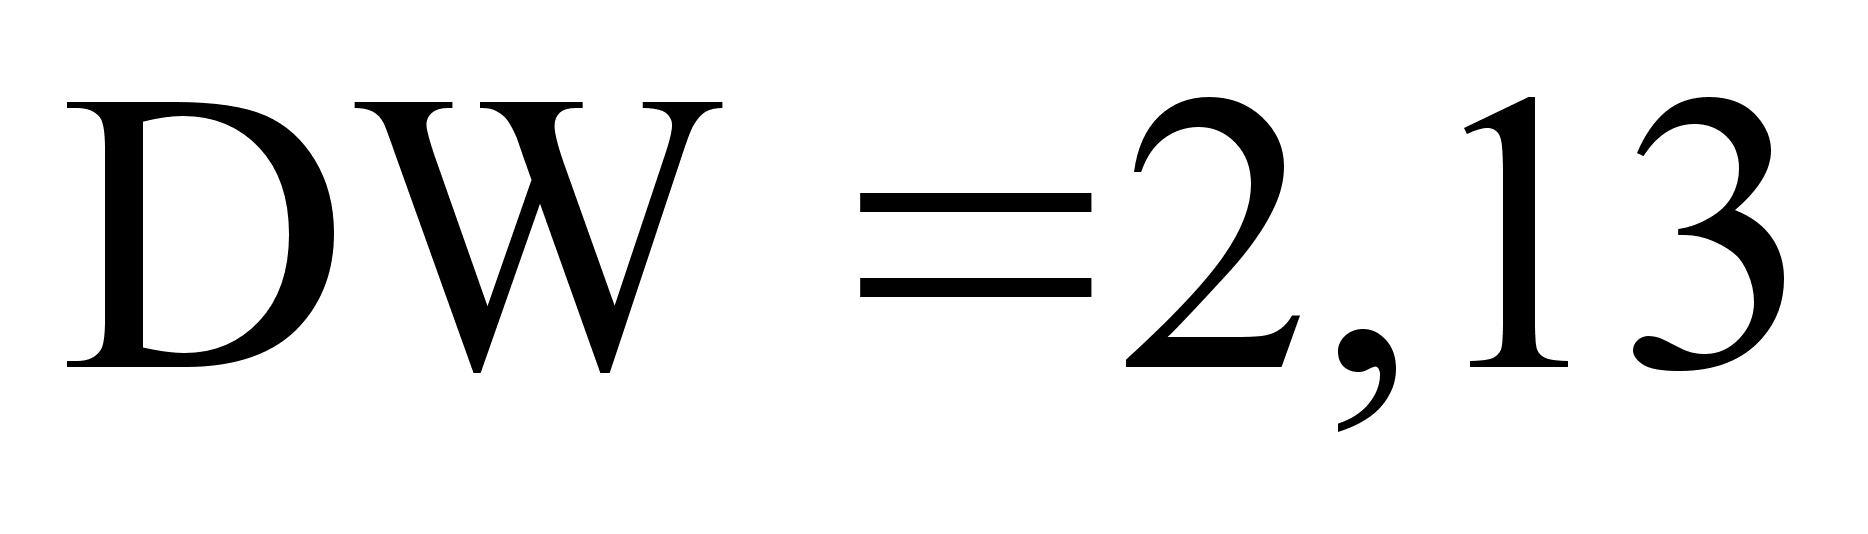 ,
коэффициент
автокорреляции
остатков
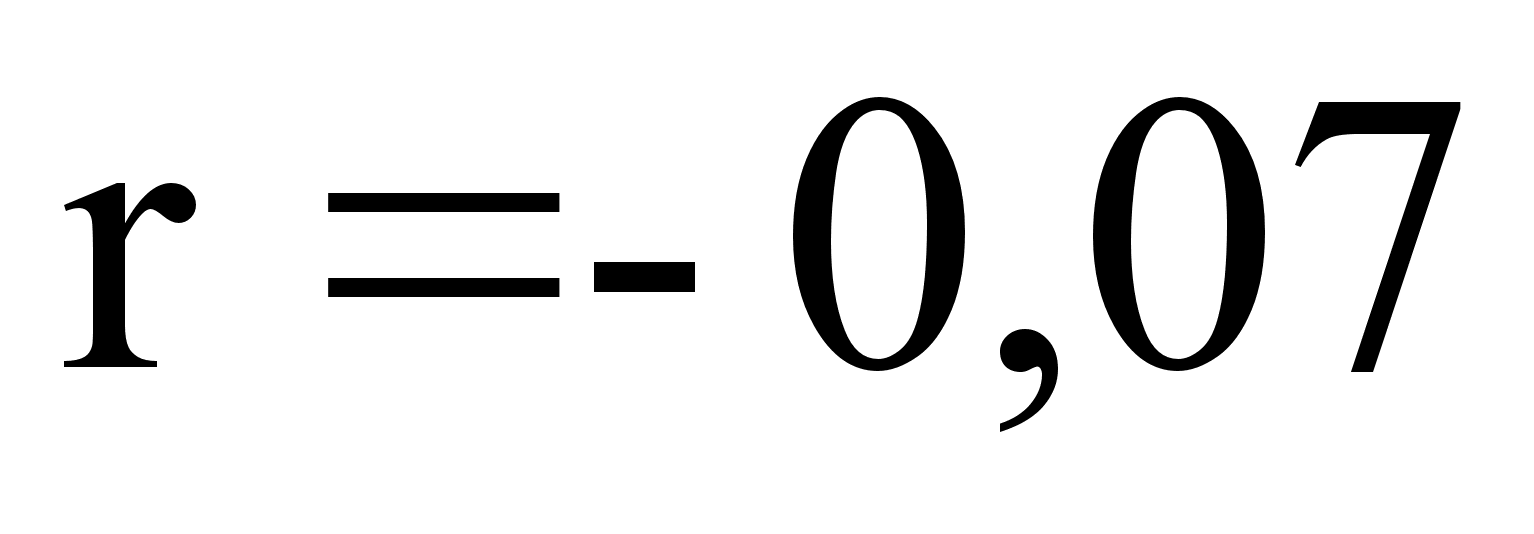 .
Значит, автокорреляция
в остатках
отсутствует.
Остатки
распределены
нормально:
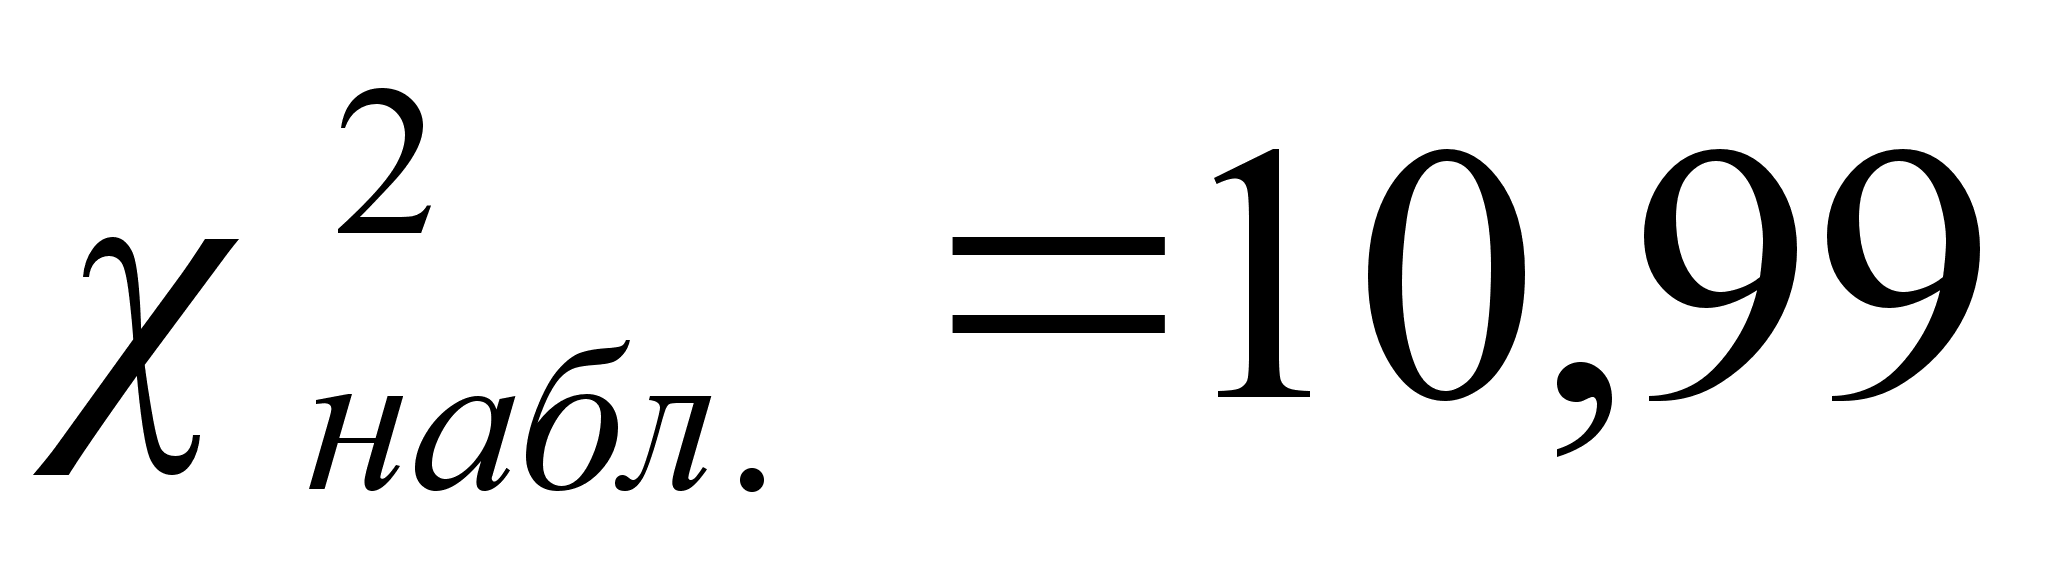 при
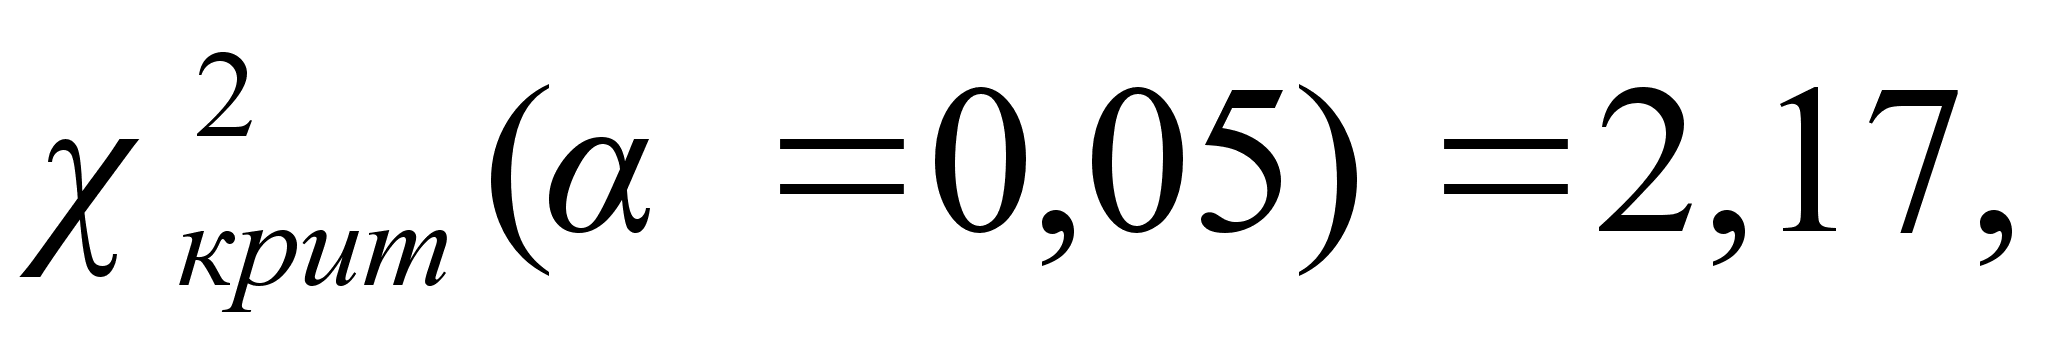
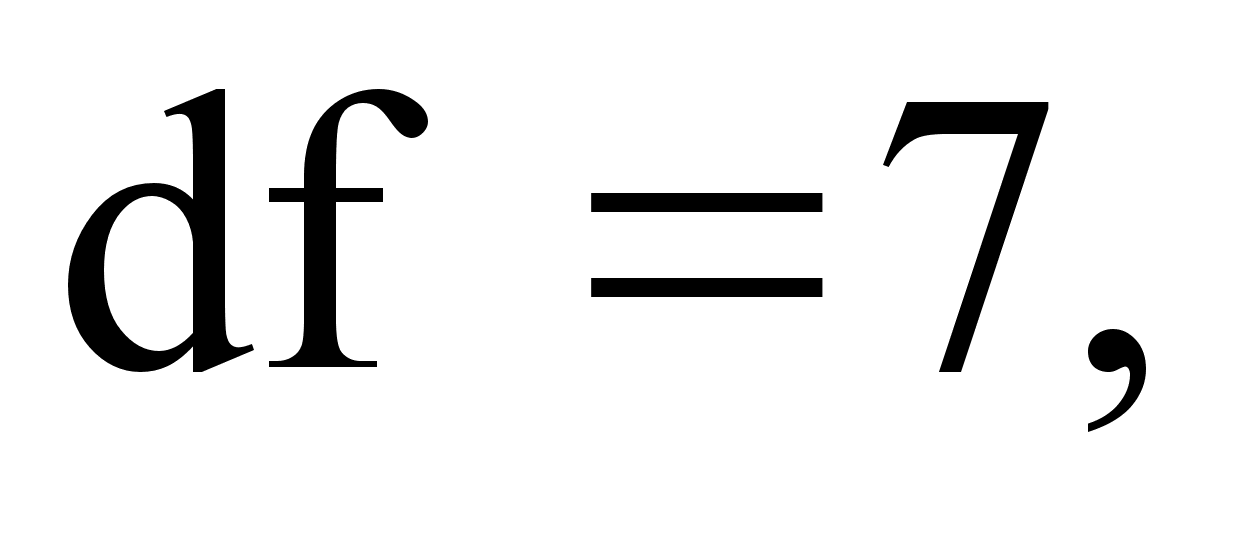
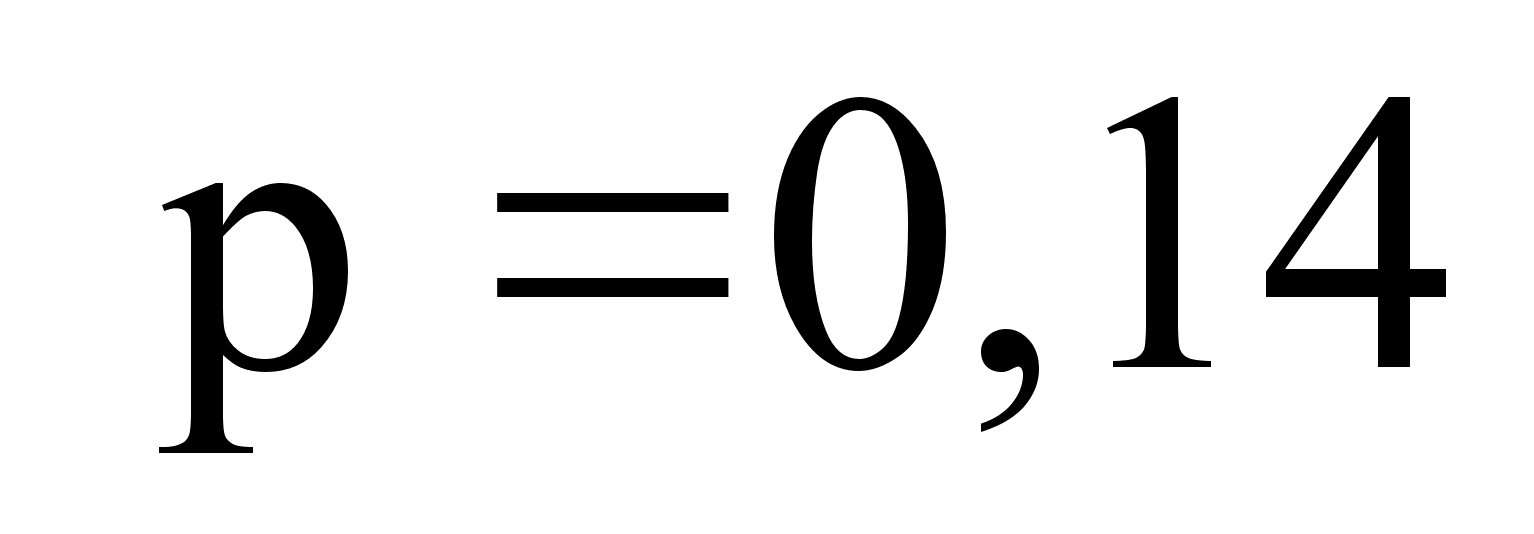 .
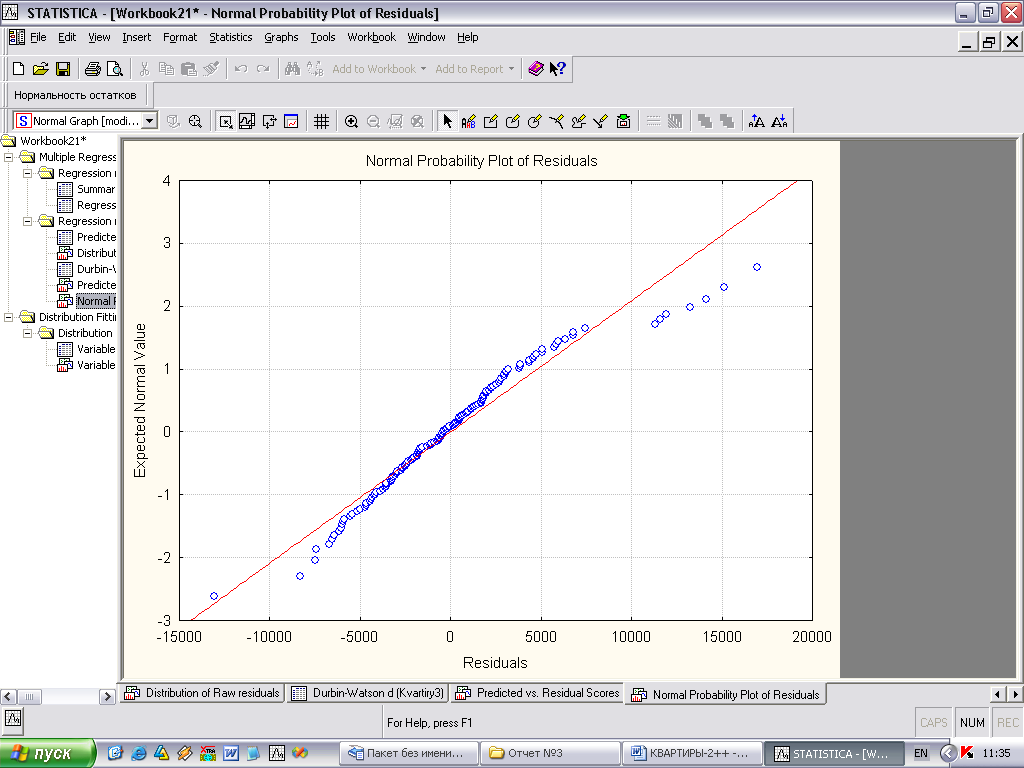
Рис. 1 График остатков на нормальной вероятностной бумаге
На рис. 1 значения по оси y представляют собой функциональное преобразование кривой нормального распределения в прямую. Если наблюдаемые остатки, представленные на оси х, распределяются по нормальному закону, то все значения попадают на прямую линию на графике. В представленном графике остатки расположены достаточно близко к линии, а следовательно можно сделать предположение об их нормальном распределении.
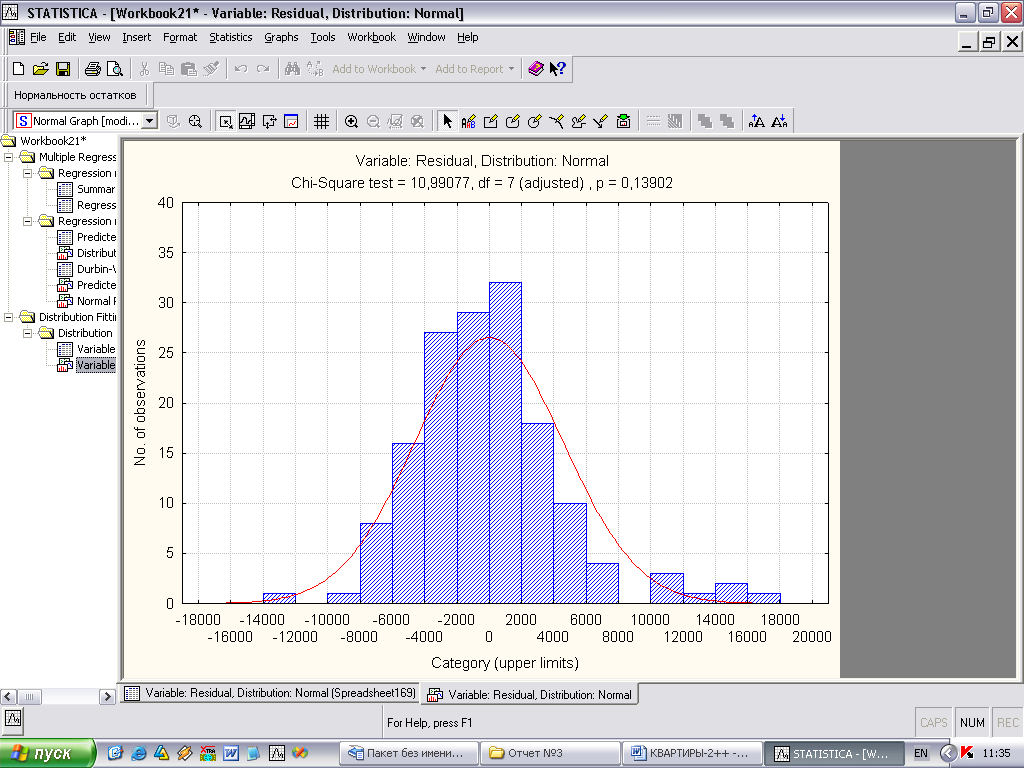
Рис. 2 Гистограмма распределения остатков
Для графической оценки вида распределения также приводится гистограмма распределения остатков (рис.2). Его можно трактовать как соответствующее нормальному.
Рассмотрим
график зависимости
остатков εi
от теоретических
значений
результативного
признака
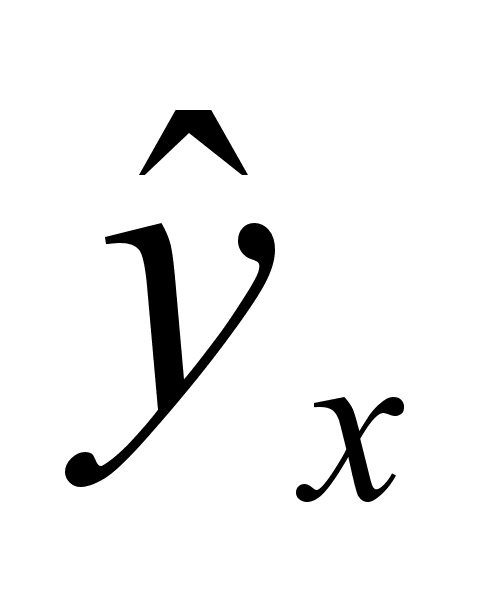 (рис. 3).
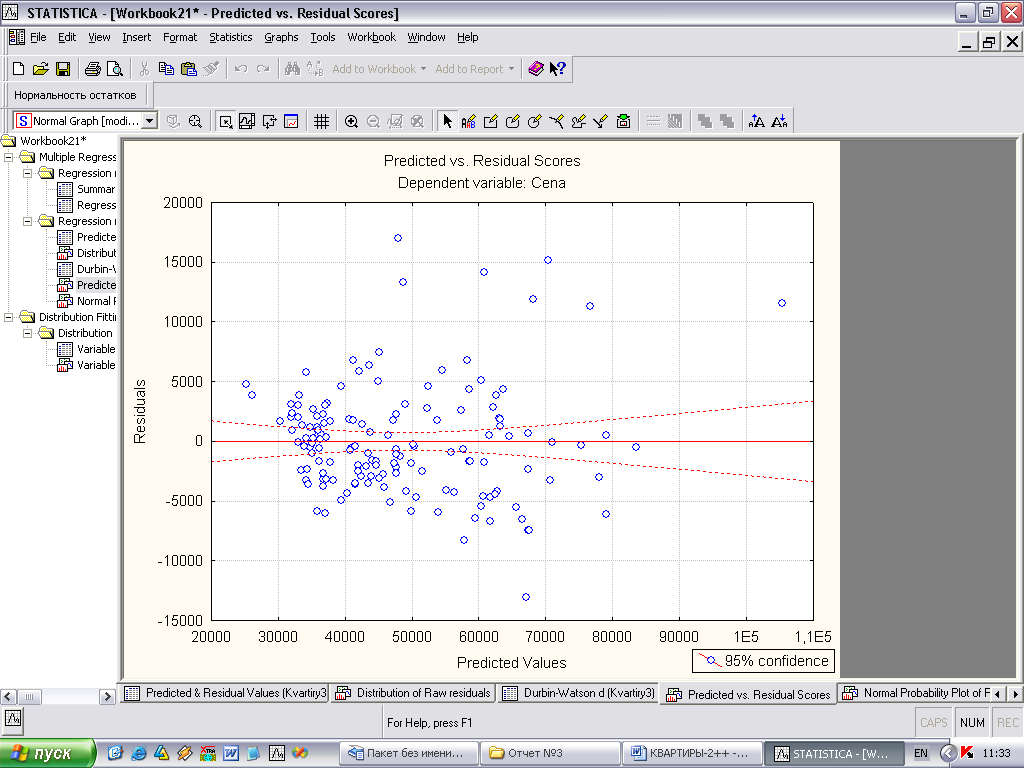
Рис. 3 График
зависимости
остатков εi
от теоретических
значений
результативного
признака
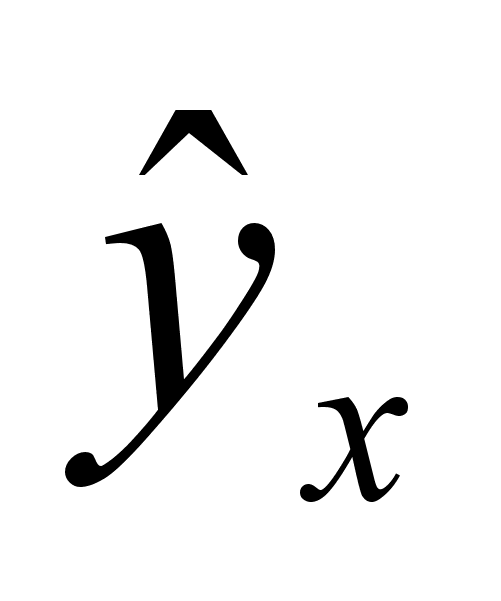 .
Из рисунка 3 можно сделать вывод о наличии гетероскедастичности: остатки εi имеют неодинаковую дисперсию.
Уравнение регрессии имеет наглядную интерпретацию. Так, увеличение общей площади квартиры на 1м2 увеличивает ее цену на 909,445 у.е. Отрицательное значение коэффициента при Vozrast (-58,685) означает, что увеличение возраста квартиры на 1год уменьшает ее цену на 58,685у.е. Квартира в кирпичном доме (Type=1) стоит дороже на 1914,209 у.е., чем аналогичная квартира, например, в панельном доме.
Использование данной модели для прогноза возможно в случае устранения гетероскедастичности, связанной с неоднородностью выборки. Для этого необходимо провести предварительный отбор однородных случаев, а затем осуществить построение модели.
ЗАКЛЮЧЕНИЕ
Математическая статистика и ее применение в экономике - эконометрика - позволяют строить экономические модели и оценивать их параметры, проверять гипотезы о свойствах экономических показателей и формах их связи. В основе методов, с помощью которых строятся экономические модели, лежит корреляционно-регрессионный анализ. Множественный регрессионный анализ заключается в определении аналитического выражения связи, в котором изменение одной величины (называемой зависимой) обусловлено влиянием нескольких независимых величин, а множество всех прочих факторов, также оказывающих влияние на зависимую переменную, принимается за постоянные и средние значения.
Наиболее распространенным в практике статистического оценивания параметров уравнений регрессии является метод наименьших квадратов (МНК). Этот метод основан на ряде предпосылок относительно природы данных и результатов построения модели. Основные из них - это некоррелированность факторов, входящих в уравнение, линейность связи, отсутствие автокорреляции остатков, равенство их математических ожиданий нулю и постоянная дисперсия (гомоскедастичность). Эмпирические данные не всегда обладают такими характеристиками, т.е. предпосылки МНК нарушаются. Применение этого метода в чистом виде может привести к таким нежелательным результатам, как смещение оцениваемых параметров, снижение их состоятельности, устойчивости, а в некоторых случаях может совсем не дать решения. В случае нарушения предпосылок МНК, необходимо корректировать модель.
После оценивания уравнения регрессии по методу наименьших квадратов нужно всегда исследовать остатки на нормальность. В случае нарушения данного предположения модель не является адекватной и не может быть использована для прогнозов.
В пакете STATISTICA имеется внутренний язык программирования Statistica Visual, который добавляет богатый арсенал из более чем 10000 новых функций к стандартному синтаксису Microsoft Visual Basic и является, таким образом, одним из самых функционально богатых и обширных интерфейсов прикладного программирования. SVB также предоставляет широкие возможности по созданию макросов.
В ходе написания данной курсовой работы был создан макрос на языке SVB для проверки гипотезы о нормальности остатков регрессии. Необходимость разработки данного приложения связана с особенностями осуществления регрессионного анализа в пакете STATISTICA. Написанный модуль был использован при эконометрическом моделировании вторичного рынка жилья в г. Минске. Разработанное программное средство может в дальнейшем применятся при построении регрессионных моделей в пакете STATISTICA.
ПРИЛОЖЕНИЕ А
Листинг программы
Option Base 1
Dim S1 As Spreadsheet
Dim NewSpreadsheet As New Spreadsheet
Public AlphaValue As Double
Public Alpha As Double
Dim VarList1 () As Long
Dim VarList2 () As Long
Dim Nvars As Long
Dim InList1 As Long
Dim InList2 As Long
Dim ret As Integer
Sub Main
On Error GoTo NoInputSpreadsheet
Nvars = ActiveDataSet.NumberOfVariables
On Error GoTo Finish
ReDim VarList1(1 To Nvars)
ReDim VarList2(1 To Nvars)
If Not InputDialog Then GoTo Finish
MultipleRegression
NormalDistribution
Finish:
Exit Sub
NoInputSpreadsheet:
MsgBox "Open a data file (Spreadsheet) for this analysis", _
vbCritical
End Sub
Function InputDialog As Boolean
On Error GoTo Finish
InputDialog=False
Begin Dialog UserDialog 390,147, _
"Multiple Regression. Residual Analysis", .UI ' %GRID:10,7,1,1
PushButton 20,14,120,21,"Variables",.VariableSelection
Text 40,42,70,14,"Grouping:",.Text1
Text 110,42,180,14,"none",.Text2
Text 30,56,80,14,"Dependent:",.Text3
Text 110,56,180,14,"none",.Text4
Text 30,84,200,14,"Alpha:",.Text5
TextBox 220,77,90,21,.AlphaValue
Text 30,104,200,14,"Alpha for highlighting effects:",.Text6
TextBox 220,100,90,21,.Alpha
OKButton 310,14,70,21,.OkButton
CancelButton 310,42,70,21,.CancelButton
End Dialog
Dim dlg As UserDialog
dlg.AlphaValue=",05"
dlg.Alpha=",05"
TryAgain:
On Error GoTo Finish
Dialog dlg
On Error GoTo BadAlphaValue
AlphaValue = CDbl(dlg.AlphaValue)
Alpha = CDbl(dlg.Alpha)
InputDialog=True
Finish:
Exit Function
BadAlphaValue:
MsgBox "Bad alpha value; please specify a valid alpha value."
GoTo TryAgain
End Function
Private Function UI(DlgItem$, Action%, SuppValue&) As Boolean
Dim ok As Boolean
Select Case Action%
Case 1 ' Dialog box initialization
Case 2 ' Value changing or button pressed
UI = True
Select Case DlgItem
Case "CancelButton"
UI=False
Case "OkButton"
ok=False
If InList1<1 Or InList2<1 Then
ok=True
GoTo DoVariables
End If
UI=False
Case "VariableSelection"
ok=False
DoVariables:
ret = SelectVariables2 (ActiveDataSet, _
"Select dependent and independent variable lists:", _
1, Nvars, VarList1, InList1, "Dependent var. (or list for batch):", _
1, Nvars, VarList2, InList2, "Independent variable list:")
If ret=0 Then GoTo Finish
If InList1>0 Then
DlgText "Text4", "Selected"
Else
DlgText "Text4", "none"
End If
If InList2>0 Then
DlgText "Text2", "Selected"
Else
DlgText "Text2", "none"
End If
End Select
End Select
Finish:
End Function
Sub MultipleRegression
Set S1 = ActiveSpreadsheet
Dim newanalysis2 As Analysis
Set newanalysis2 = Analysis (scMultipleRegression,S1)
With newanalysis2.Dialog
Variables = Array(VarList1,VarList2)
InputFile = scRegRawData
CasewiseDeletionOfMD = True
PerformDefaultNonStepwiseAnalysis = False
ReviewDescriptiveStatistics = False
ExtendedPrecisionComputations = False
BatchProcessingAndPrinting = False
End With
newanalysis2.Run
With newanalysis2.Dialog
.ComputeConfidenceLimits = True
.AlphaForLimits = AlphaValue
.PLevelForHighlighting = Alpha
End With
newanalysis2.RouteOutput(newanalysis2.Dialog.Summary).Visible = True
newanalysis2.Run
With newanalysis2.Dialog
RawResiduals = True
StandardResidualPlusMinusSigmaOutliers = True
RawPredictedValues = True
MaxNumberOfCasesInSpreadsheetsAndGraphs = 100000
End With
newanalysis2.RouteOutput(newanalysis2.Dialog.Summary).Visible = True
newanalysis2.RouteOutput(newanalysis2.Dialog.HistogramOfResiduals).Visible = True
newanalysis2.RouteOutput(newanalysis2.Dialog.DurbinWatsonStatistics).Visible = True
newanalysis2.RouteOutput(newanalysis2.Dialog.ScatterplotOfPredictedVsResiduals).Visible = True
newanalysis2.RouteOutput(newanalysis2.Dialog.NormalPlotOfResiduals).Visible = True
Set ResSpreadsheetCollection=newanalysis2.Dialog.Summary
Set ResSpreadsheet=ResSpreadsheetCollection.Item(1)
Dim n As Long
n=ResSpreadsheet.NumberOfCases-4
Set Cells=ResSpreadsheet.CellsRange( _
1, 3,n, 3)
Cells.Select
ResSpreadsheet.CopyWithHeaders
NewSpreadsheet.SetSize n, 1
NewSpreadsheet.Visible=True
Set Cells=NewSpreadsheet.CellsRange(1,1,1,1)
Cells.Select
NewSpreadsheet.Paste
End Sub
Sub NormalDistribution
Dim newanalysis3 As Analysis
Set newanalysis3 = Analysis (scDistributions, NewSpreadsheet)
With newanalysis3.Dialog
.FitContinuousDistributions = True
.ContinuousDistribution = scNonNormal
End With
newanalysis3.Run
With newanalysis3.Dialog
Variable = "1"
Distribution = scNonNormal
KolmogorvNo = True
CombineBinsForChiSquare = True
FrequencyDistribution = True
RawFrequencies = True
End With
newanalysis3.RouteOutput(newanalysis3.Dialog.Summary).Visible = True
newanalysis3.RouteOutput(newanalysis3.Dialog.PlotOfDistribution).Visible = True
End Sub
ПРИЛОЖЕНИЕ Б
Листинг программы
Sub Main
Dim bars As CommandBars
Set bars = CommandBarOptions.CommandBars(scBarTypeToolBar)
Dim