Лекции по курсу Периферийные устройства компьютеров
К существенным недостаткам накопителей на оптических дисках относятся сравнительно большое время доступа к информации по сравнению с НЖМД, низкая скорость передачи данных, наличие механических и оптических узлов, не выдерживающих ударов и вибрации.
________________________________________________________________________________________________
Курс «Периферийные устройства»
(лекции)
-
Лекция 16
Видеомониторы и видеоадаптеры
План
1. Типы видеосистем.
2. Видеоадаптеры.
2.1. Графические видеоадаптеры точечные.
2.2. Графические видеоадаптеры векторные.
2.3. Графические видеоадаптеры растровые.
3. Способы формирования цветного изображения.
1. Типы видеосистем
В общем случае видеосистема (дисплей) ПЭВМ включает монитор, преобразующий сигналы от ПЭВМ в изображение на экране в темпе их поступления без запоминания и обработки; и видеоконтроллер для обработки, передачи данных и согласования интерфейсов. В ПЭВМ применяются три основных типа построения видеосистемы:
1) ее электронные схемы без монитора входят в состав системного блока ПЭВМ и в качестве экранного ОЗУ используют основную память ПЭВМ;
2) ее электронные схемы без монитора входят в состав системного блока ПЭВМ и имеют отдельное экранное ОЗУ;
3) все ее электронные схемы и монитор выполняются в виде отдельного устройства, связанного с ПЭВМ стандартным интерфейсом.
Возможны также различные комбинации типов.
Дисплеи ПЭВМ классифицируются по ряду признаков:
по виду отображаемой информации: алфавитно-цифровые, графические и комбинированные;
по способу формирования изображения графические дисплеи ПЭВМ делятся на векторные и растровые;
по способу поддержания изображения: с регенерацией и запоминанием изображения в специальных электронных трубках;
по способу сопряжения монитора с адаптером: композитные и RGB-дисплеи. В RGB-дисплеях сигналы яркости основных цветов передаются от адаптера к монитору по трем отдельным проводам, а в композитных все три сигнала яркости подаются в монитор по одному проводу, где затем разделяются;
по виду управления: цифровые и аналоговые. В цифровых дисплеях по одному сигналу включается только один уровень яркости. В аналоговых дисплеях яркость и цвет любой точки пропорциональны уровню напряжения управляющего аналогового сигнала. Аналоговые дисплеи поддерживают больше цветов, чем цифровые.
В ПЭВМ обычно применяются растровые монохромные или цветные видеомониторы на электронно-лучевых трубках (ЭЛТ). По виду сигнала управления такие видеомониторы, как CGA и EGA, являются цифровыми, а видеомониторы PGA, VGA, SVGA - аналоговыми. Цветной универсальный монитор Multisync может настраиваться на цифровой или аналоговый сигнал управления.
2. Видеоадаптеры
Видеоадаптеры (дисплейные процессоры) представляют собой специализированные процессоры с собственным набором команд, специфическими форматами данных и собственным счетчиком команд.
Алфавитно-цифровые видеоадаптеры, так же как и принтеры, имеют ПЗУ для хранения постоянного знакогенератора и ОЗУ - для переменного знакогенератора. Страница текста, отображаемая на экране, записывается в видеопамять и координаты каждого символа однозначно определяются его местонахождением в видеопамяти.
Графические видеоадаптеры разделяются на адаптеры с произвольным сканированием и адаптеры растрового типа.
2.1. Графические видеоадаптеры точечные
Графические видеоадаптеры с произвольным сканированием разделяются на точечные и векторные. В точечных дисплеях любая картинка рисуется из отдельных точек, координаты которых в произвольном порядке задаются в графическом файле. В векторных дисплеях изображение составляется из отдельных векторов, которые задаются в файле координатами начальных и конечных точек.
Для управления точечными дисплеями используются два типа команд: команда рисования точки и команда безусловного перехода. При выполнении каждой команды рисования луч перемещается от точки к точке по указанным в команде координатам, активизируя их. Последней командой графического файла является команда безусловного перехода на начало файла, что обеспечивает регенерацию изображения. При такой организации вычислений адаптер содержит два ЦАП, которые преобразует цифровые координаты точки в напряжения отклонения луча ЭЛТ по координатам X и Y (рис. 16.1).
О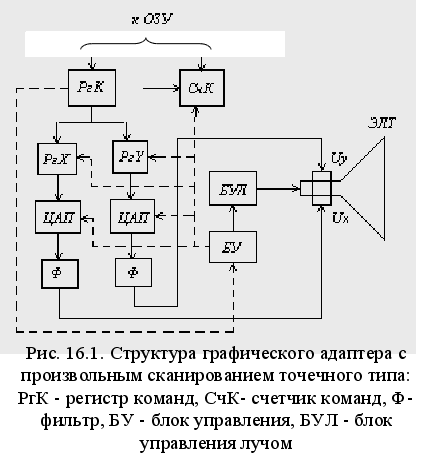
сновным
недостатком
точечных графических
адаптеров
является то,
что координаты
каждой точки
вычисляются
ЦП. От этого
недостатка
свободны векторные
адаптеры.
2.2. Графические видеоадаптеры векторные
В векторных графических адаптерах команды начальной и конечной точки вектора вычисляются ЦП, а рисование векторов осуществляется автоматически специальным блоком - генератором векторов или генератором напряжения развертки (рис. 16.2).
Для задания координат начала и конца вектора используются абсолютные или относительные координаты. Если используются относительные координаты, то в структуре адаптера добавляется сумматор для сложения базовых координат с относительными. В таких адаптерах используются команды следующего типа: загрузить Х; загрузить Y и переместить луч в позицию Х, Y; загрузить Y, переместить луч в позицию X,Y и нарисовать точку; загрузить Y и нарисовать вектор от начальной до конечной точки; безусловный переход.
Е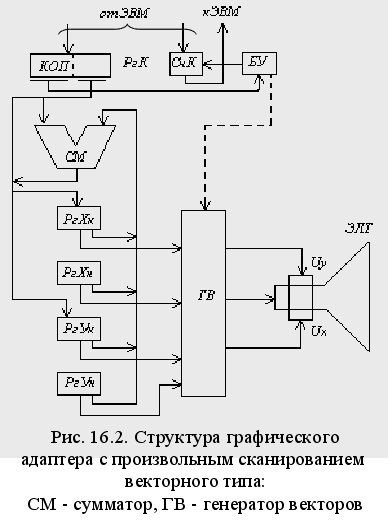
сли
адаптер работает
в абсолютных
координатах,
то ЦП сильно
загружен в
режиме редактирования
или перемещения
изображения.
2.3. Графические видеоадаптеры растровые
Графические адаптеры растрового типа позволяют создавать изображение с непрерывным уровнем яркости, т.к. вывод содержимого видео-ЗУ на экран всегда производится с постоянной частотой и обеспечивается одинаковая яркость для векторов разной длины. Адаптеры такого типа обладают отсутствием мерцания, возможностью наложения изображения из видео-ЗУ на стандартное телевизионное изображение от телекамеры или видеомагнитофона.
В растровых адаптерах каждая точка изображения вычисляется и записывается в видео-ЗУ. Такое ЗУ должно быть большой емкости и его быстродействие должно быть соизмеримо с работой монитора. Графический файл преобразуется сначала в векторный, где осуществляется масштабирование и перемещение изображения, а затем векторный файл преобразуется в растровую форму, где каждый вектор заменяется последовательностью пиксель, записываемых в видео-ЗУ. С учетом этого в структуре растровых адаптеров выделяют два процессора - векторный и растровый (рис. 16.3).
Р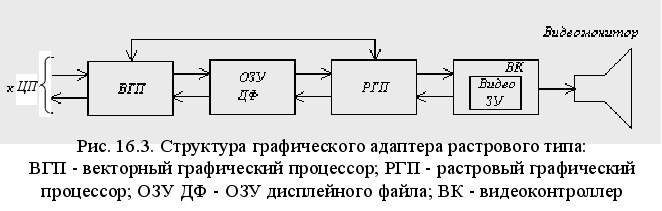
астровый
графический
процессор
работает под
управлением
своей
программы.
Входными данными
для него являются
команды, записанные
в ОЗУ ДФ и описывающие
вектора, которые
программным
или аппаратным
способом должны
быть преобразованы
в пикселы.
Вычисленные
точки вектора
между его начальными
и конечными
точками записываются
в видео-ЗУ.
Видеоконтроллер
формирует
видеосигналы
на видеомонитор,
для чего производится
периодический
опрос ячеек
видео-ЗУ. РГП
выполняет также
кодирование
изображения
- вычисление
пиксель по
полученному
списку векторов,
определяющему
небольшую часть
изображения
(окно), которое
можно перемещать
по экрану. В
связи с этим
РГП должны
обладать большим
быстродействием.
Для черно-белых адаптеров для задания атрибутов пиксела отводится один бит, если он установлен, то это означает черный цвет.
Для создания тонового черно-белого изображения видео-ЗУ имеет несколько плоскостей, число которых определяется количеством градаций черно-белого тона. Разрядность задания атрибутов пикселя n и число градаций тона L связаны между собой соотношением n=log2L. Считанный из видео-ЗУ двоичный код пикселя преобразуется на ЦАП в напряжение, соответствующее требуемому уровню тона.
3. Способы формирования цветного изображения
Цветные изображения могут быть получены двумя способами. Первый способ основывается на первичной форме изображения в графическом файле с постоянно заданным цветом. В ячейки видео-ЗУ записываются все атрибуты цвета, например, красный (R), синий (B) и зеленый (G) цвет. Затем двоичные коды интенсивности каждого цвета преобразуются ЦАП в уровни напряжения (рис. 16.4, а). Для простого изображения достаточно иметь три слоя атрибутов пиксела. Цвет изображения можно поменять, только изменив графический файл.
В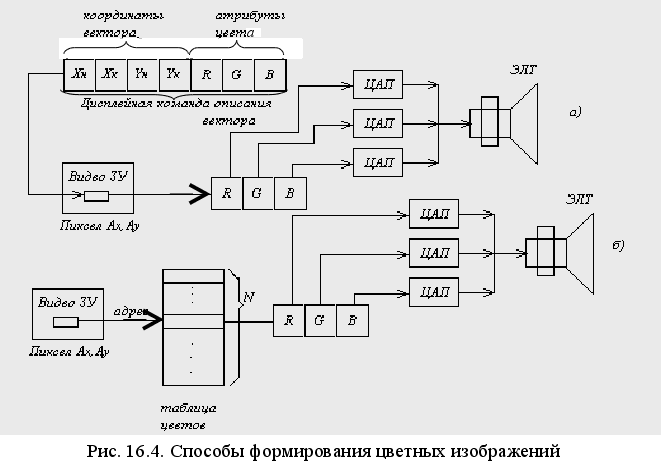
торой
способ
позволяет
выводить цветные
изображения
с изменяемым
цветом. В состав
видеоконтроллера
вводится специальное
ЗУ, в котором
записывается
таблица цветов
(рис. 16.4, б). Каждый
пиксель содержит
адрес этой
таблицы. Меняя
адреса таблицы
цветов можно
изменить цвет
изображения.
Вопросы к лекции
1. От каких характеристик зависит формат дисплейной команды: для черно-белых тоновых графических адаптеров; для графических адаптеров с возможностью формирования цветных изображений по первому и второму способу?
2. Нарисуйте подробную схему взаимодействия программных и аппаратных компонент и блоков ПЭВМ при отображении информации: а) на алфавитно-цифровом мониторе с постоянным знакогенератором, б) на графическом мониторе с произвольным сканированием точечного; в) векторного типа и г) растрового типа.
________________________________________________________________________________________________
Курс «Периферийные устройства»
(лекции)
-
Лекция 17
Устройства и системы ввода-вывода
текстовой и графической информации
Принцип кодирования текстовой информации
План
1. Кодирование текстовой информации в ЭВМ.
2. Ручной ввод текстовой информации с клавиатуры.
1. Кодирование текстовой информации в ЭВМ
Текстовая информация представляется последовательностью алфавитно-цифровых символов, каждый из которых определённым образом кодируется. Существуют четыре основных принципа кодирования символов.
1. Символы кодируются в виде последовательности двоичных цифр. Количество разрядов на один символ определяется по формуле
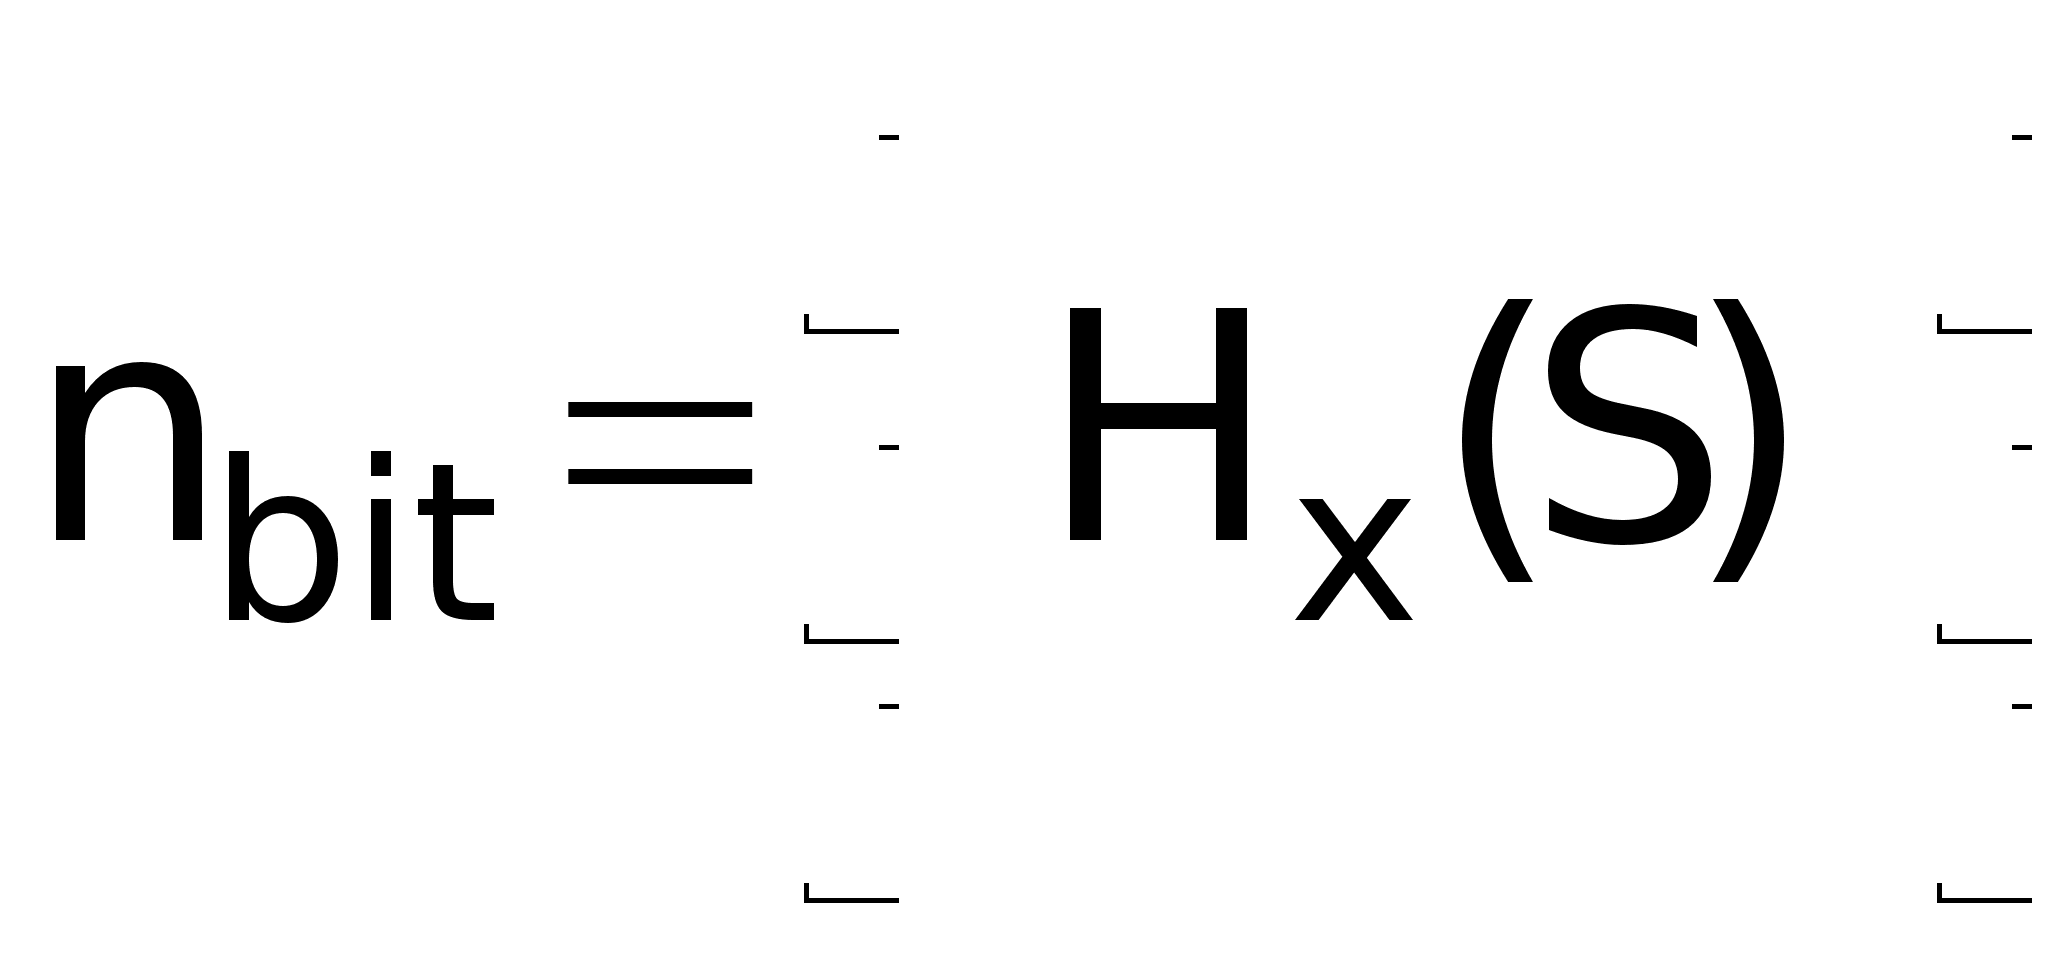 ,
(17.1)
где S - множество всех символов, используемых для кодирования текста; HХ(S) - энтропия по Хартли (мера неопределённости). Эта величина характеризует количество информации в каком-либо сообщении.
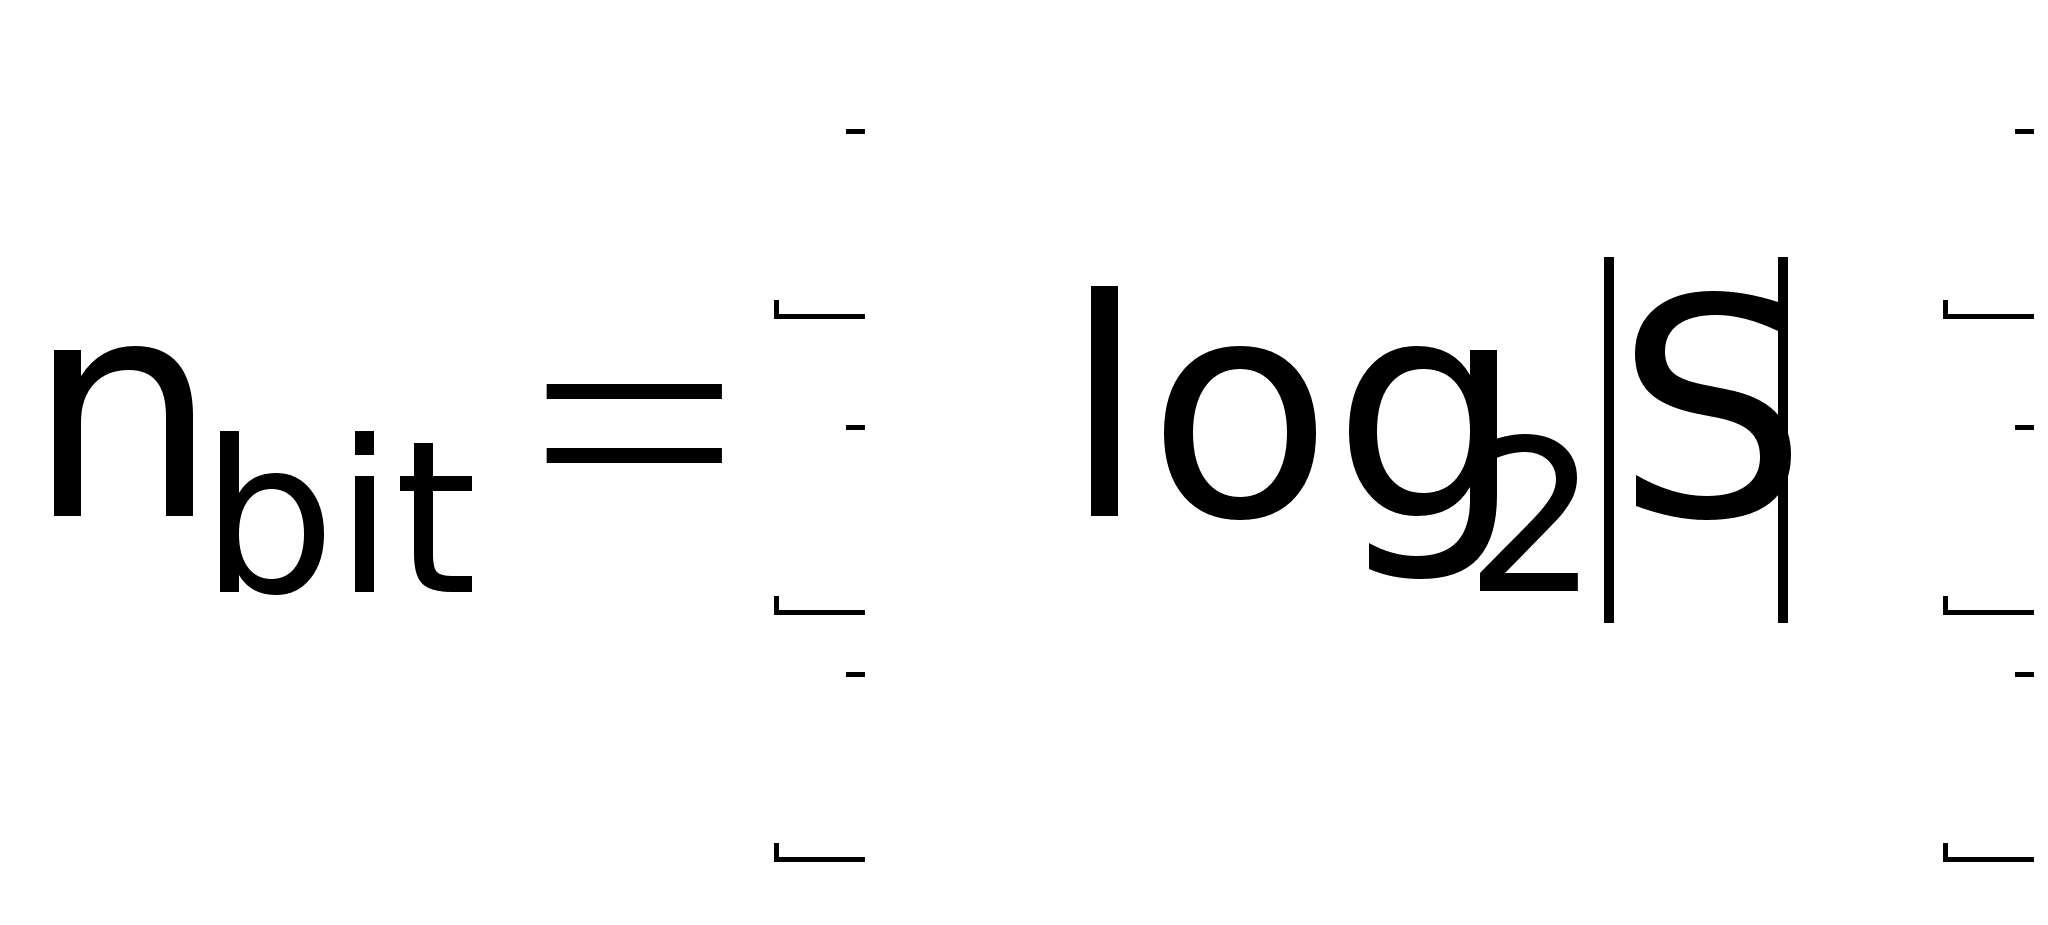 ;
(17.2)
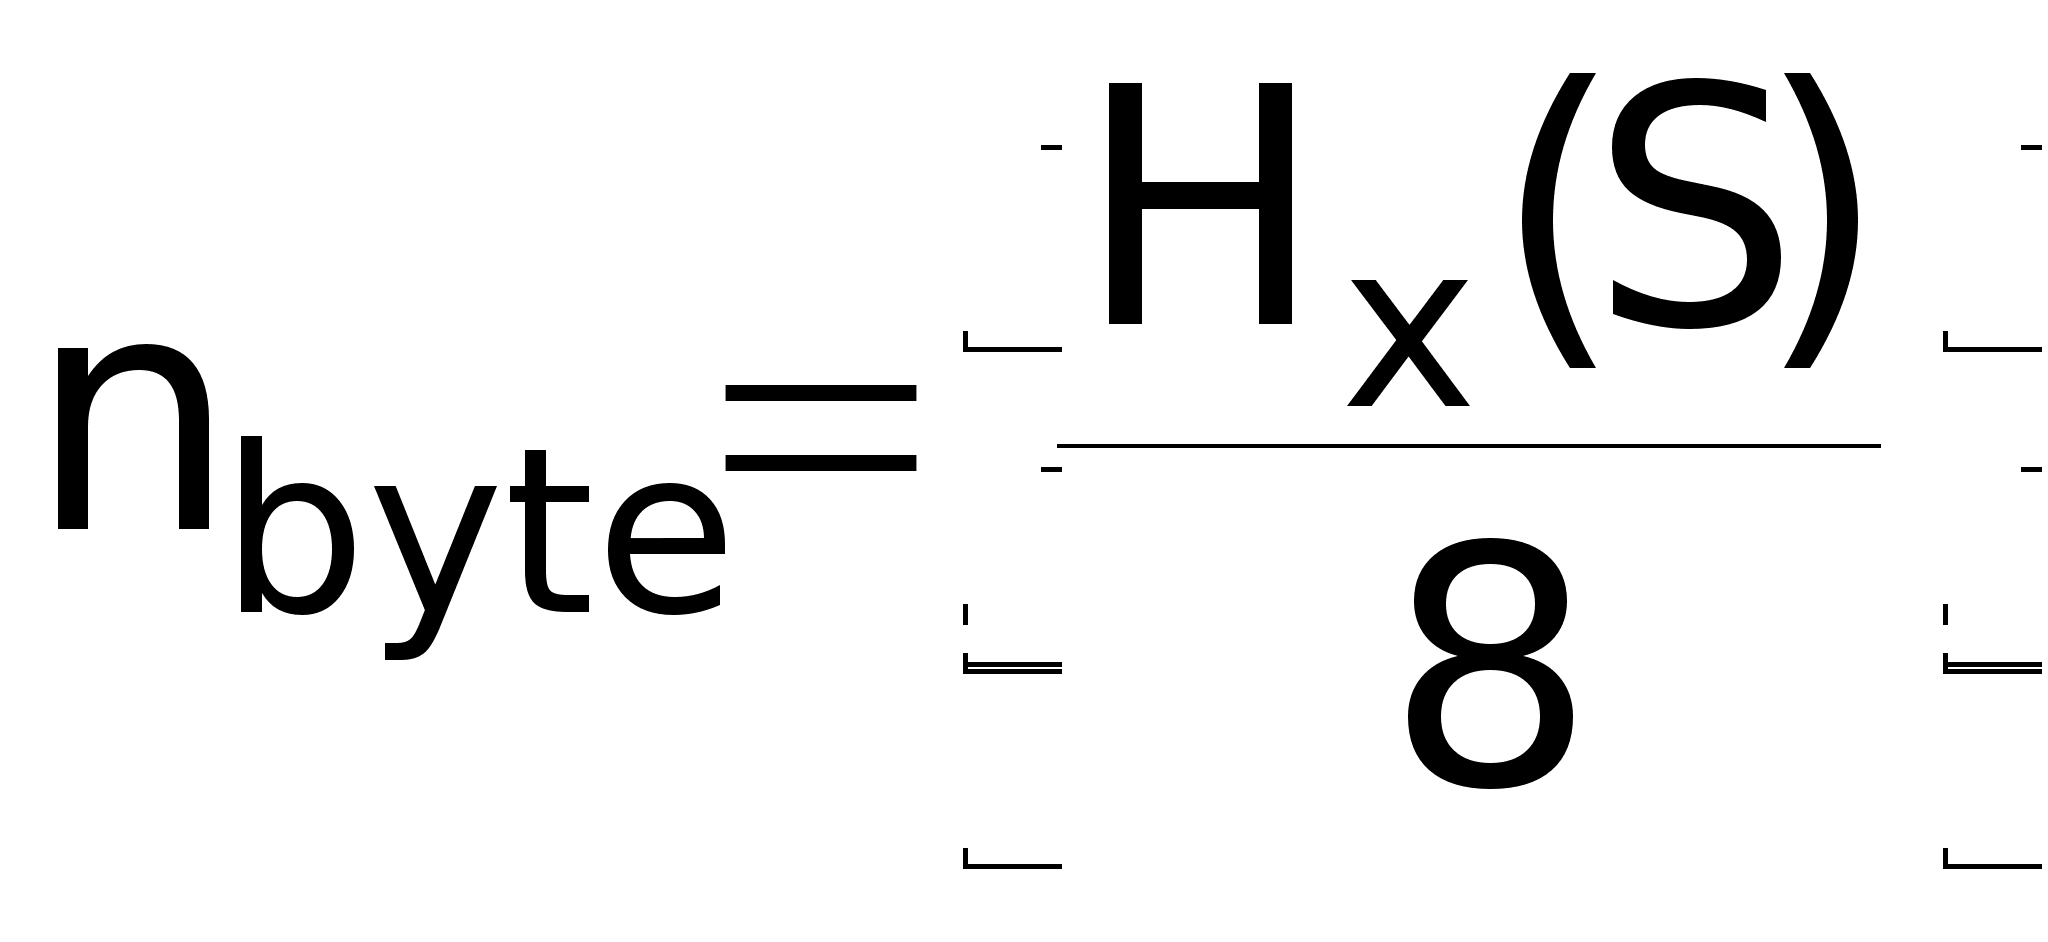 .
Эта
энтропия обладает
свойством
адитивности,
т.е.
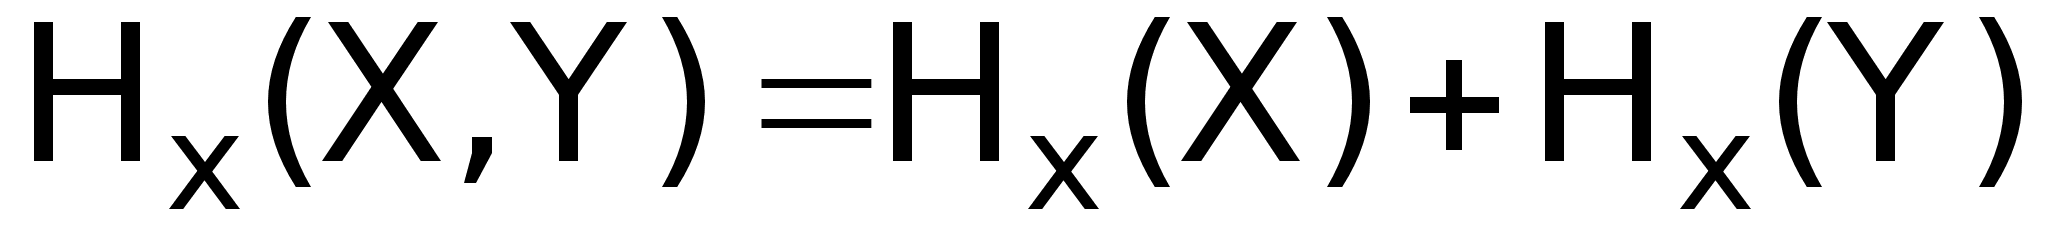 .
Например, код
символа складывается
из буквенного
обозначения
и цифрового
X={A, B, C, D}, Y={1, 2, 3, 4, 5, 6, 7, …, 16}; тогда
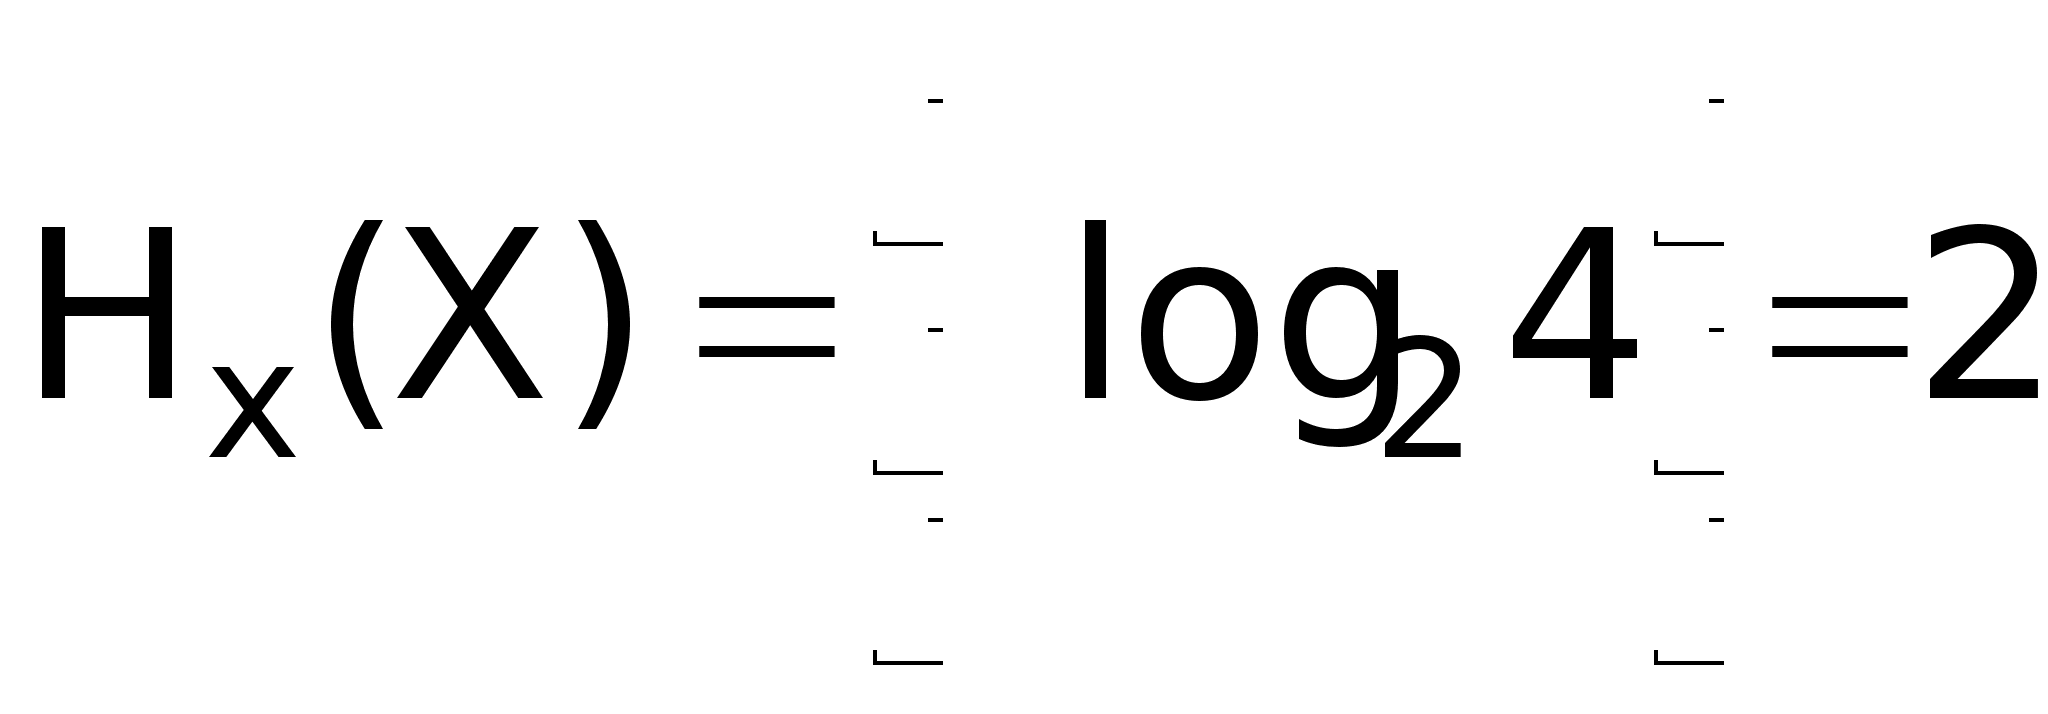 ,
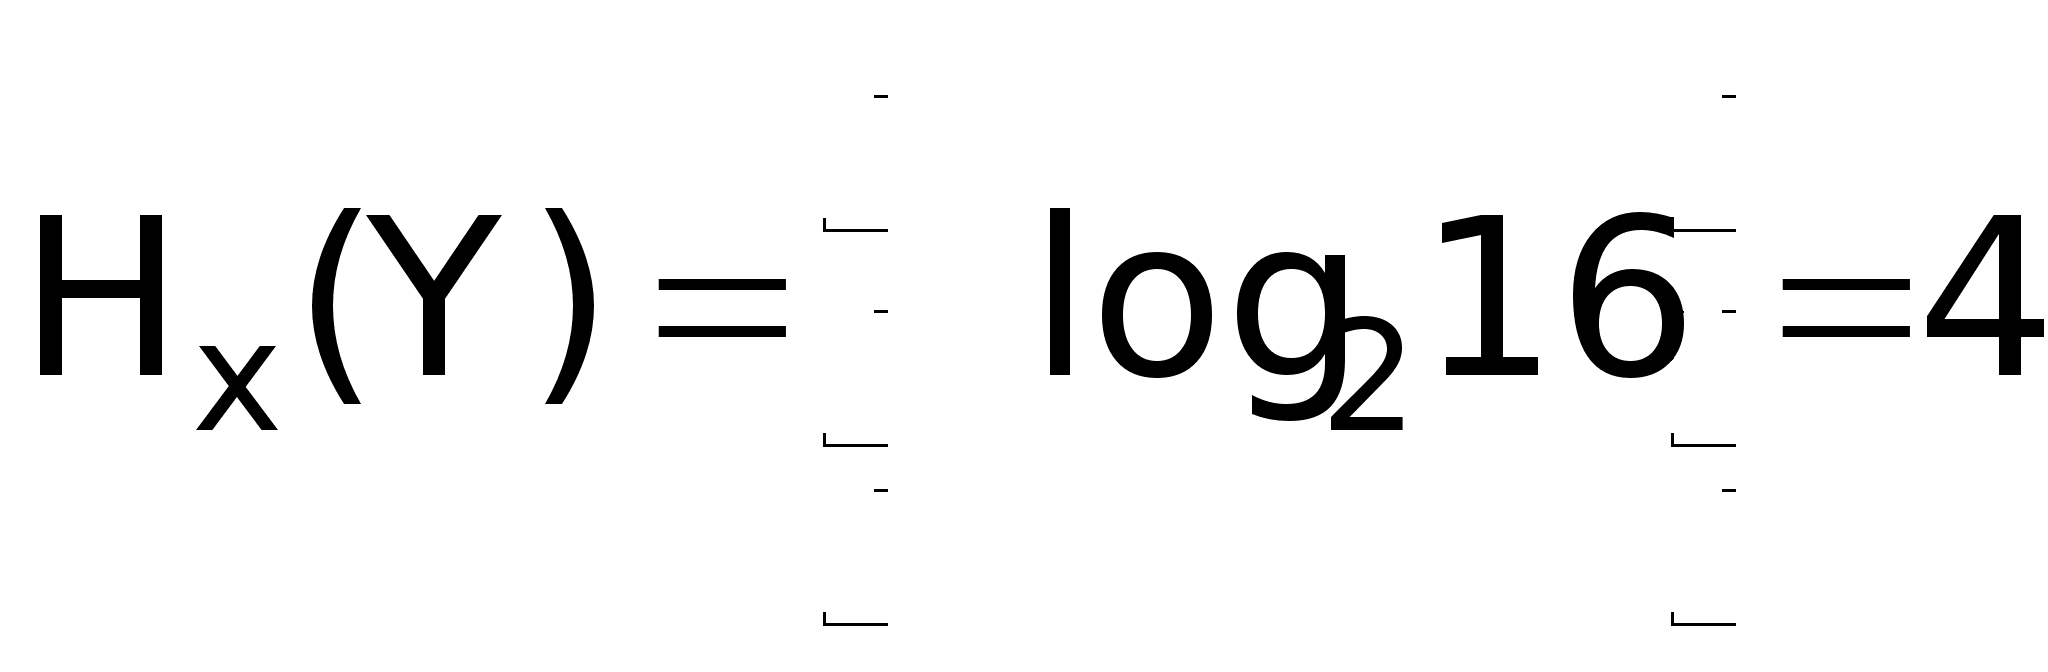
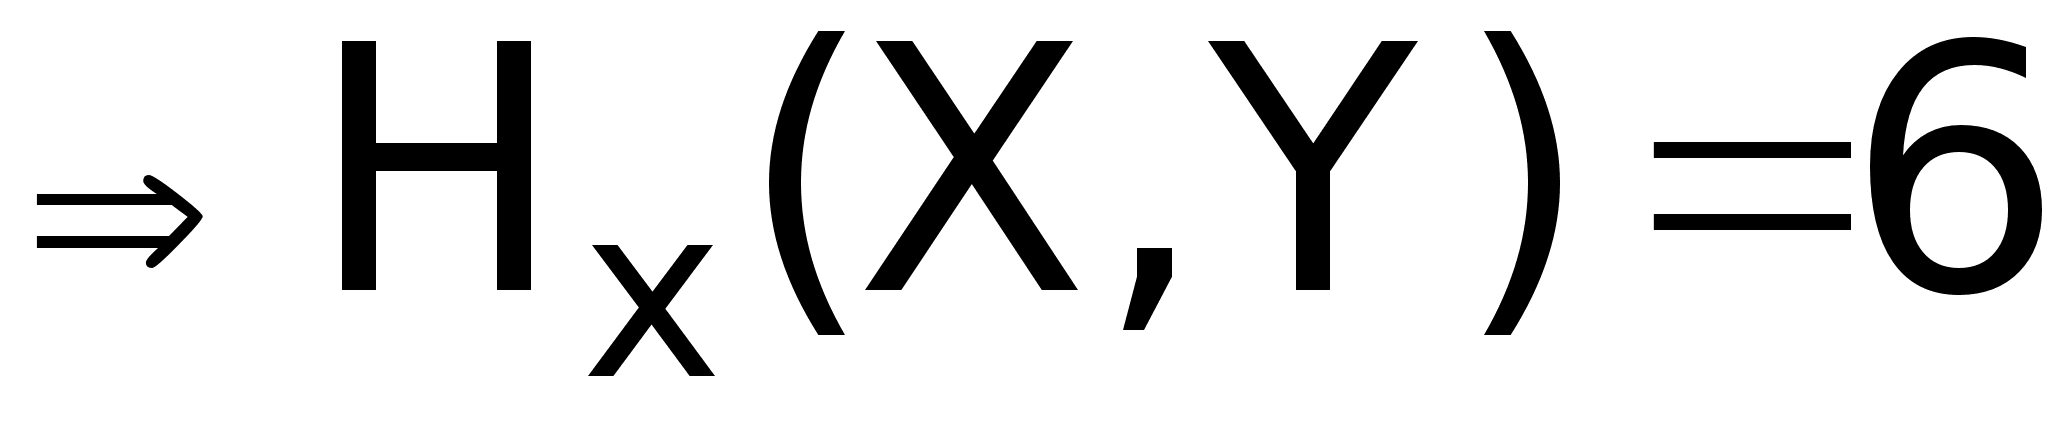 .
Большинство кодировок используют один байт для кодирования символов.
2. Символы, относящиеся к одной группе по каким-либо признакам желательно кодировать в виде односвязного множества в одномерном пространстве кодов (рис. 17.1).
Р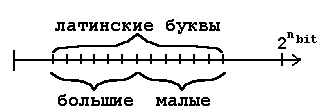
ис.
17.1. Одномерное
пространство
кодов символов
3. Коды символов должны отражать порядок следования букв в алфавите.
4. Желательно, чтобы преобразование строчных букв в прописные и обратно сводилось к прибавлению или вычитанию некоторой константы или к гашению/записи некоторых бит.
Принцип 2 и 4 не всегда соблюдаются.
Для кодирования символов в качестве внутреннего кода ЭВМ наиболее часто используется двоичный код обработки информации (ДКОИ), построенный на основе международного кода EBCDIC.
Наиболее часто символы в тексте в пределах информационных блоков встречаются с различной вероятностью, что позволяет сократить затраты разрядов на кодирование. Для этого количество информации рассчитывается при помощи энтропии по Шеннону HS(X), и в общем случае HS(S)< HX(S).
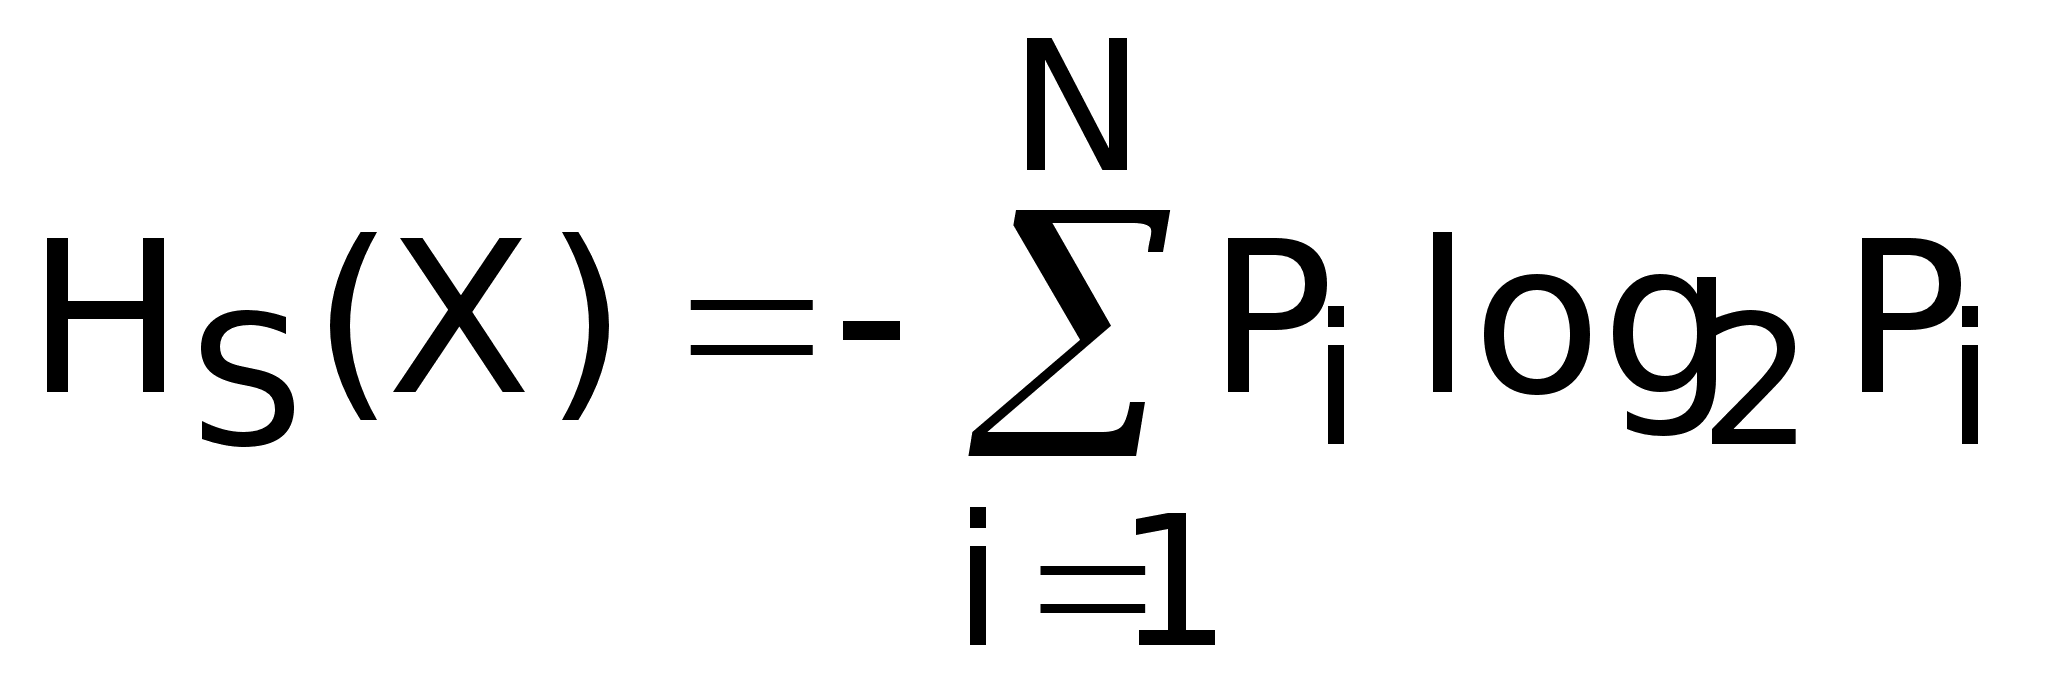 ,
(17.3)
где
N – мощность
множества
X(N=|X|); Pi
– вероятность
поступления
событий (встречаемость
символов в
тексте);
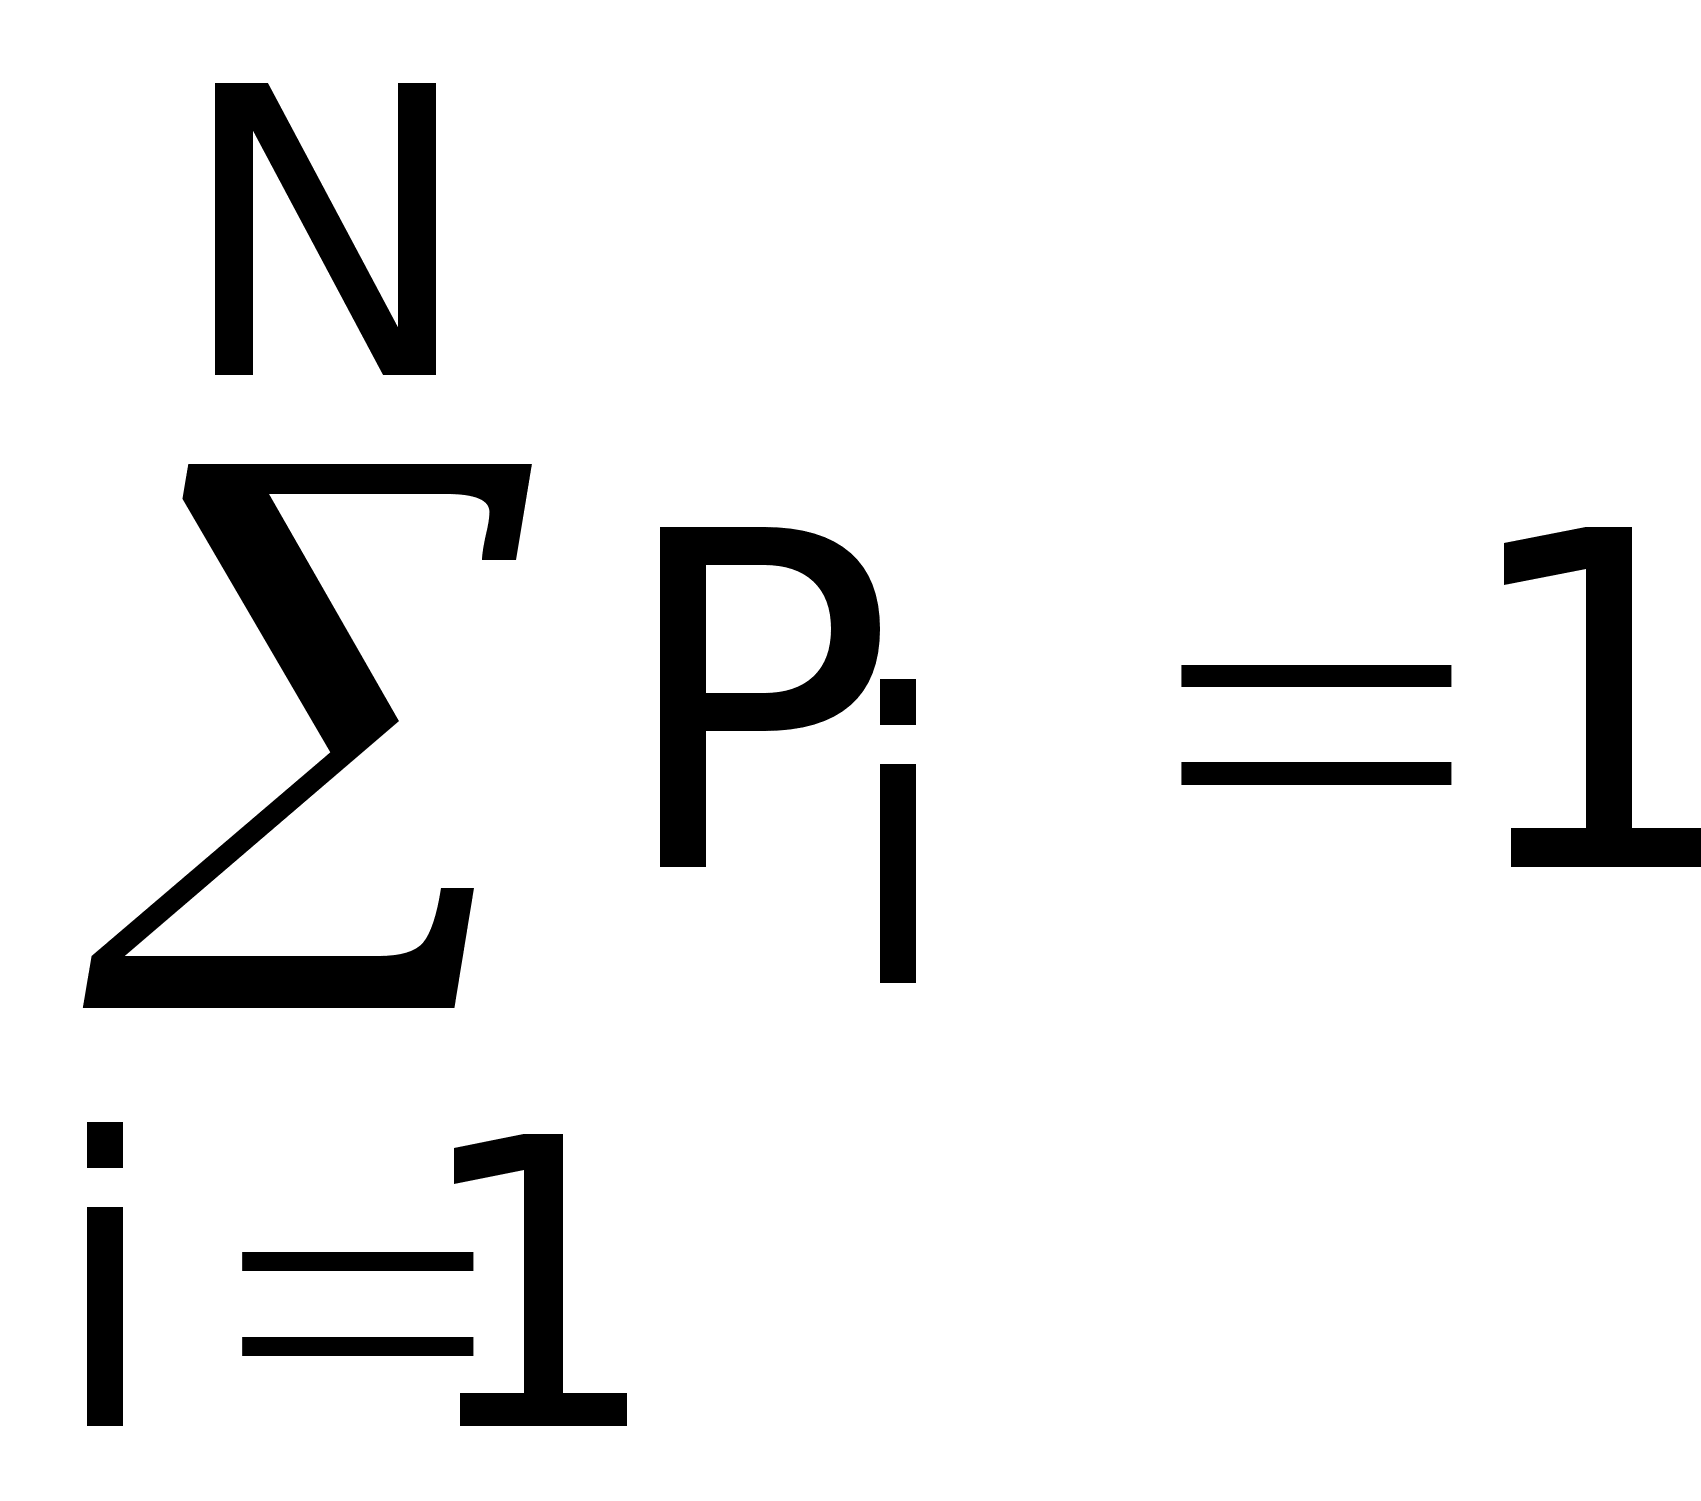 .
Если события равновероятны, то Pi = 1/N =>
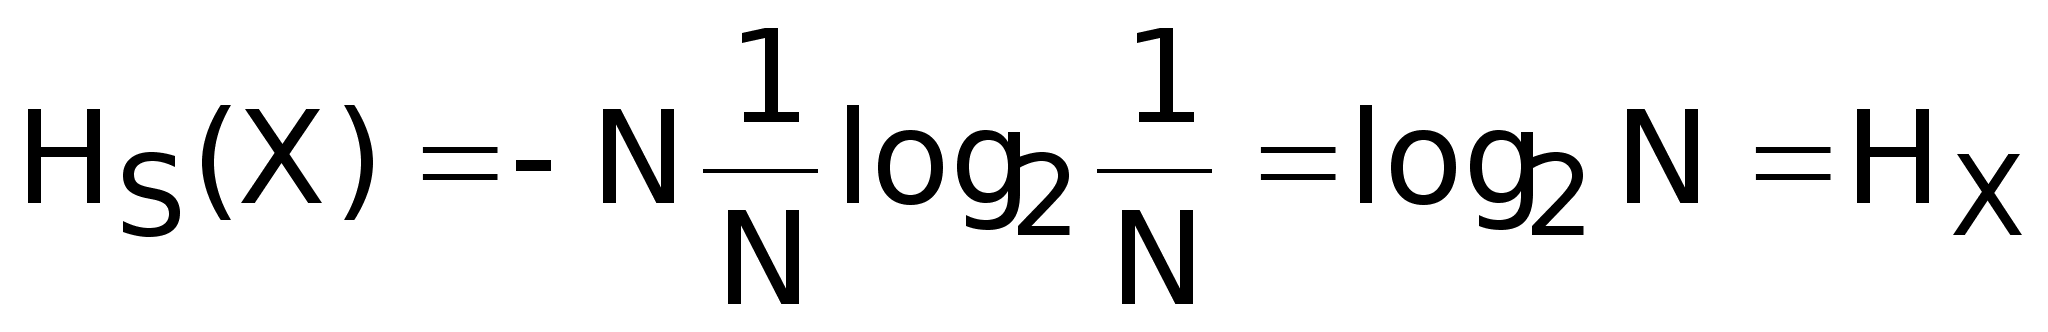 .
(17.4)
Свойства энтропии по Шеннону:
а) она всегда положительна;
б) она максимальна, т.е. равна энтропии по Хартли, когда события равновероятны;
в) для независимых событий из множеств X и Y, энтропия произведения X и Y равна сумме отдельных энтропий
HS(XY)=HS(X)+ HS(Y).
Энтропия по Шеннону и энтропия по Хартли также используются для теоретического анализа каналов передачи информации.
Разобьем
множество
символов S на
m
подмножеств
(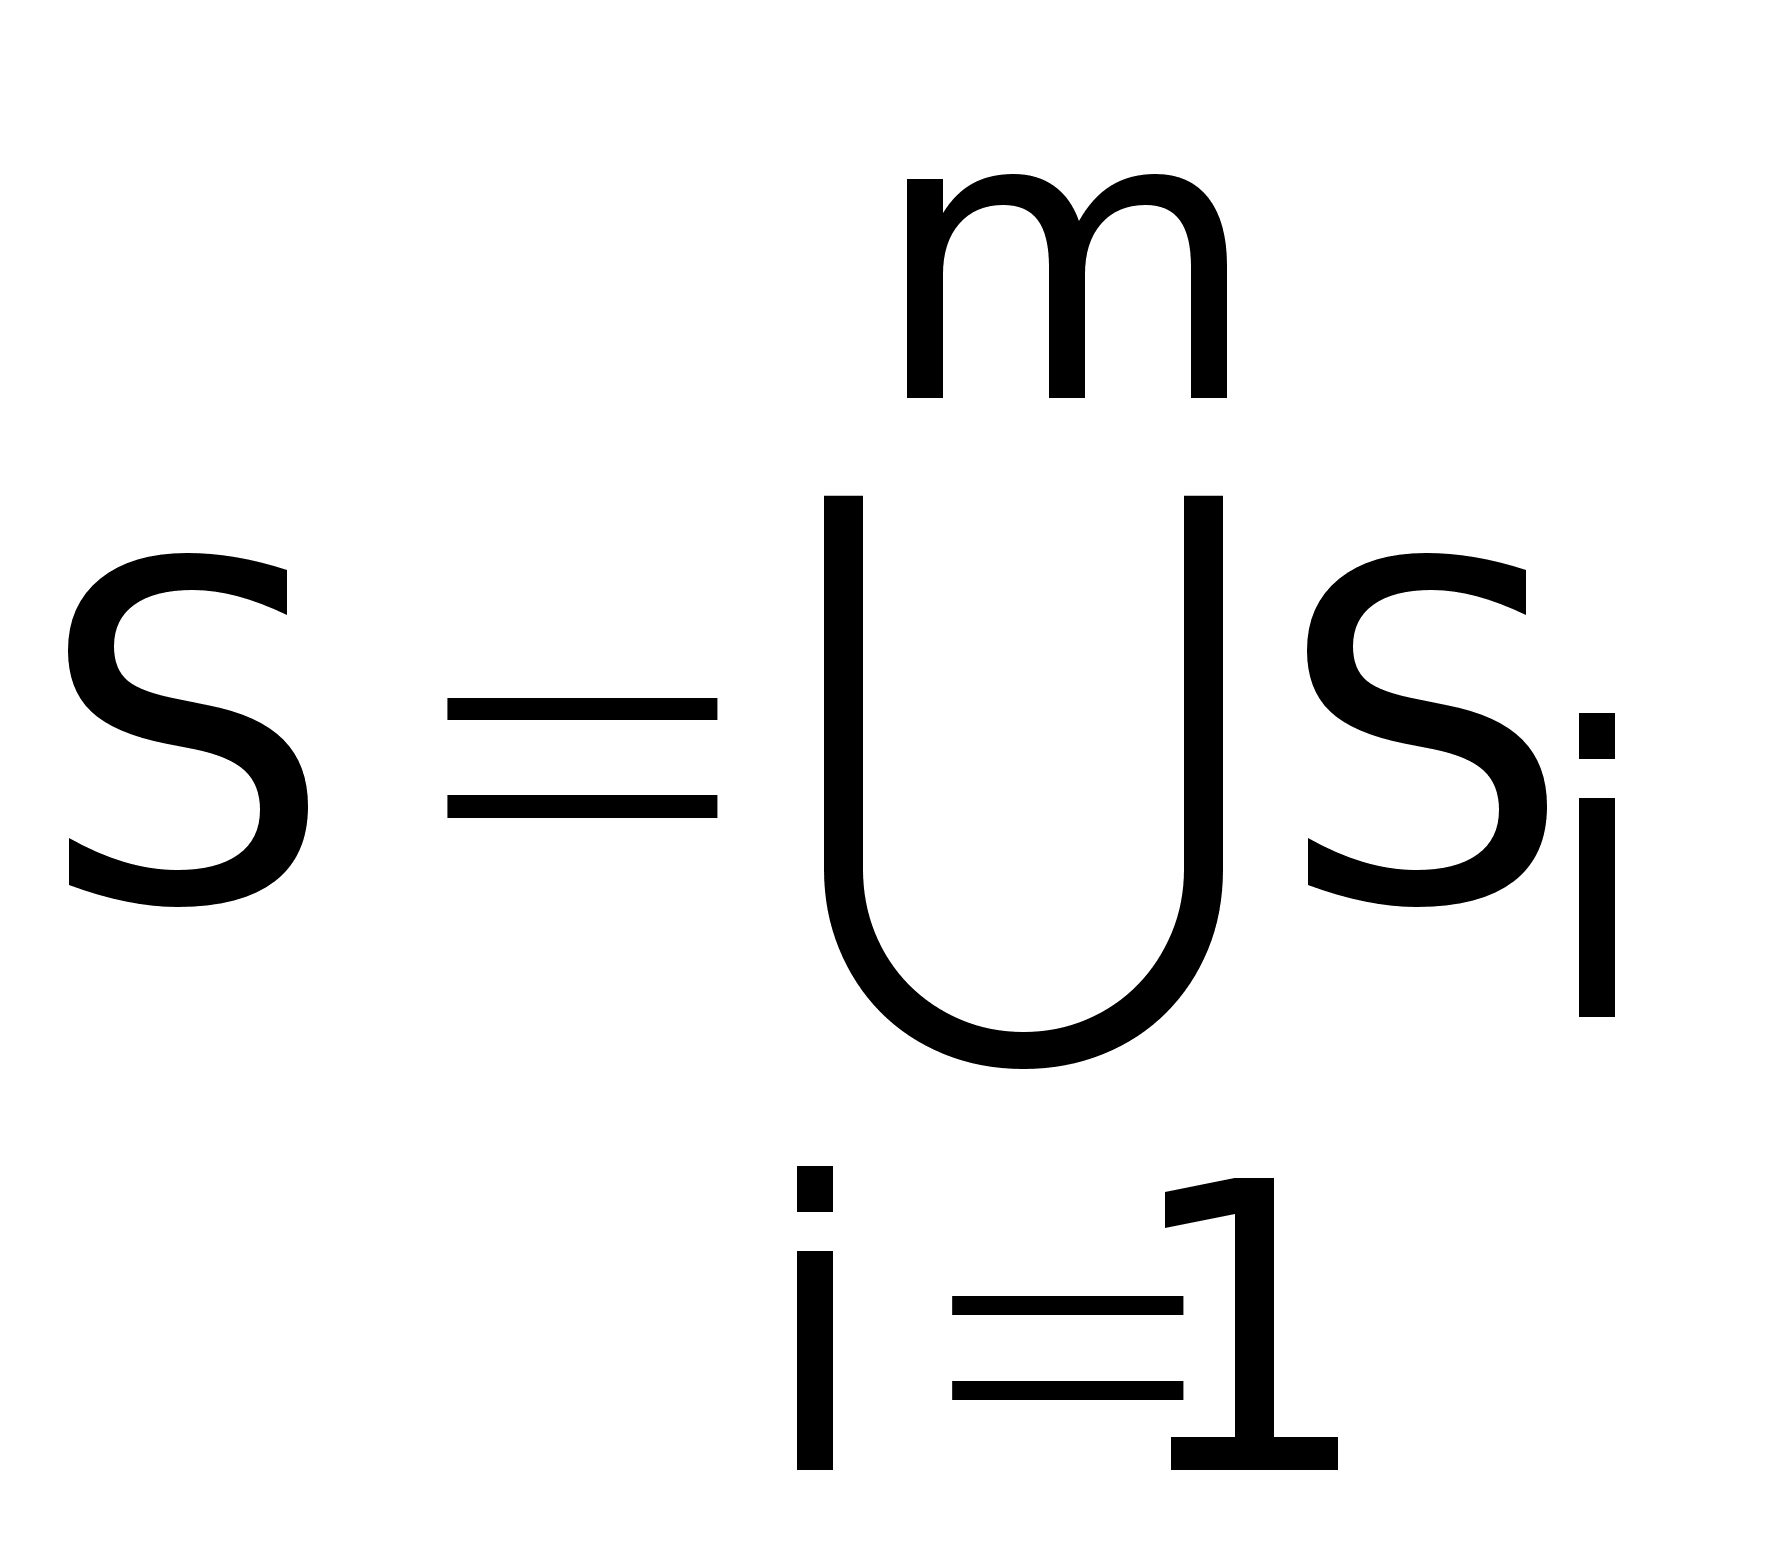 ),
в которых символы
встречаются
с равной вероятностью.
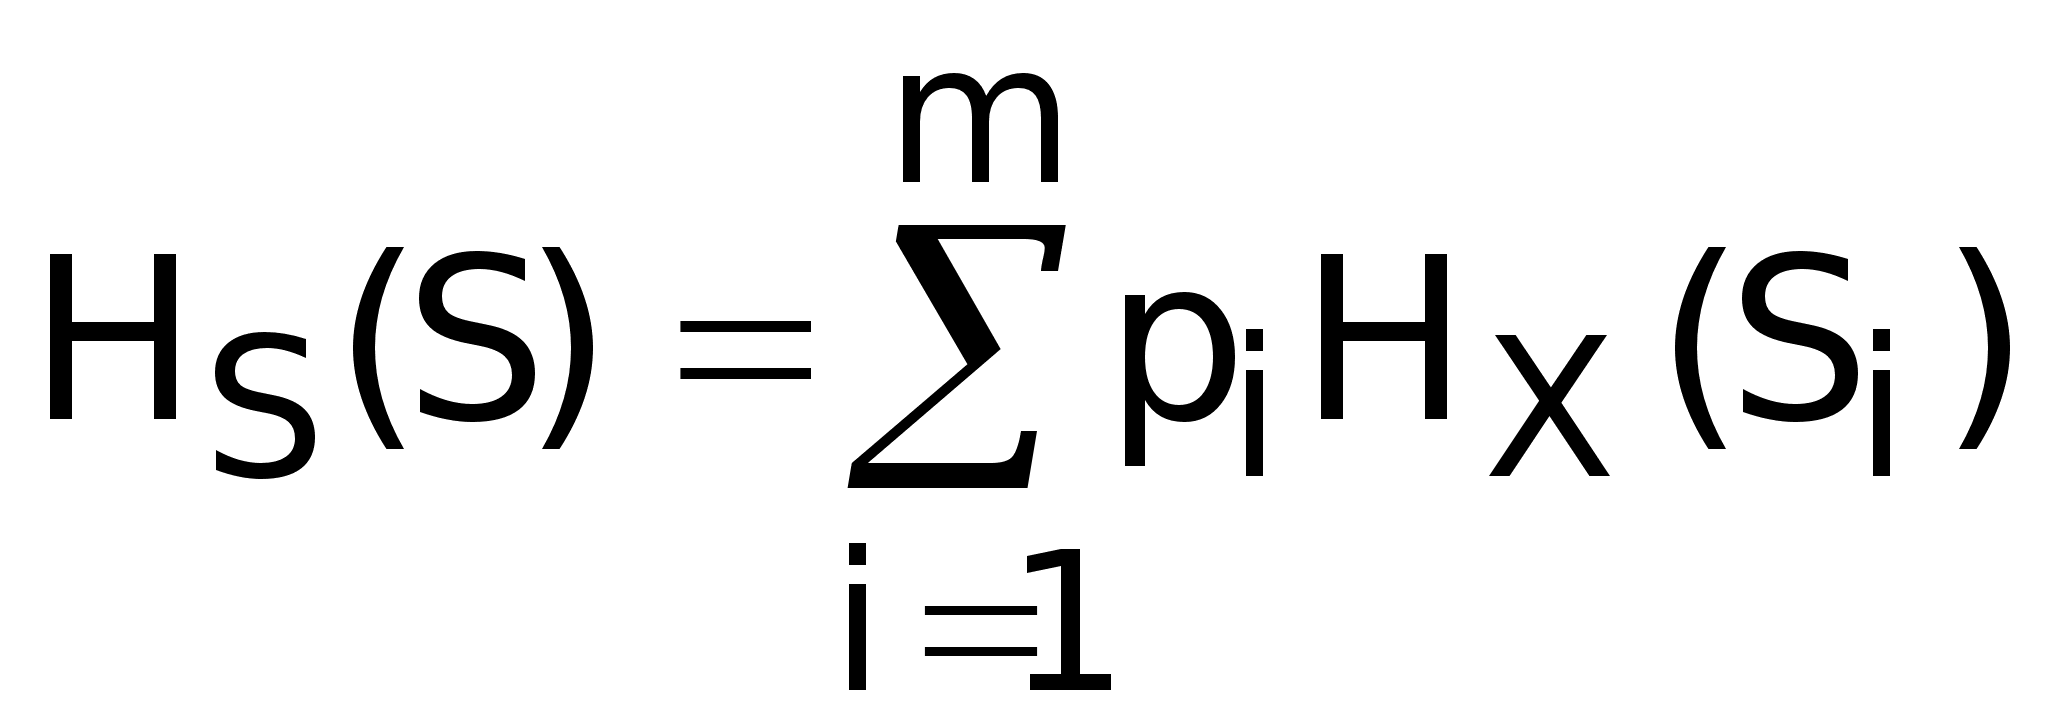 ,
(17.5)
где рi – вероятность встретить символ, принадлежащий подмножеству Si.
Количество бит для кодирования одного символа определяется как
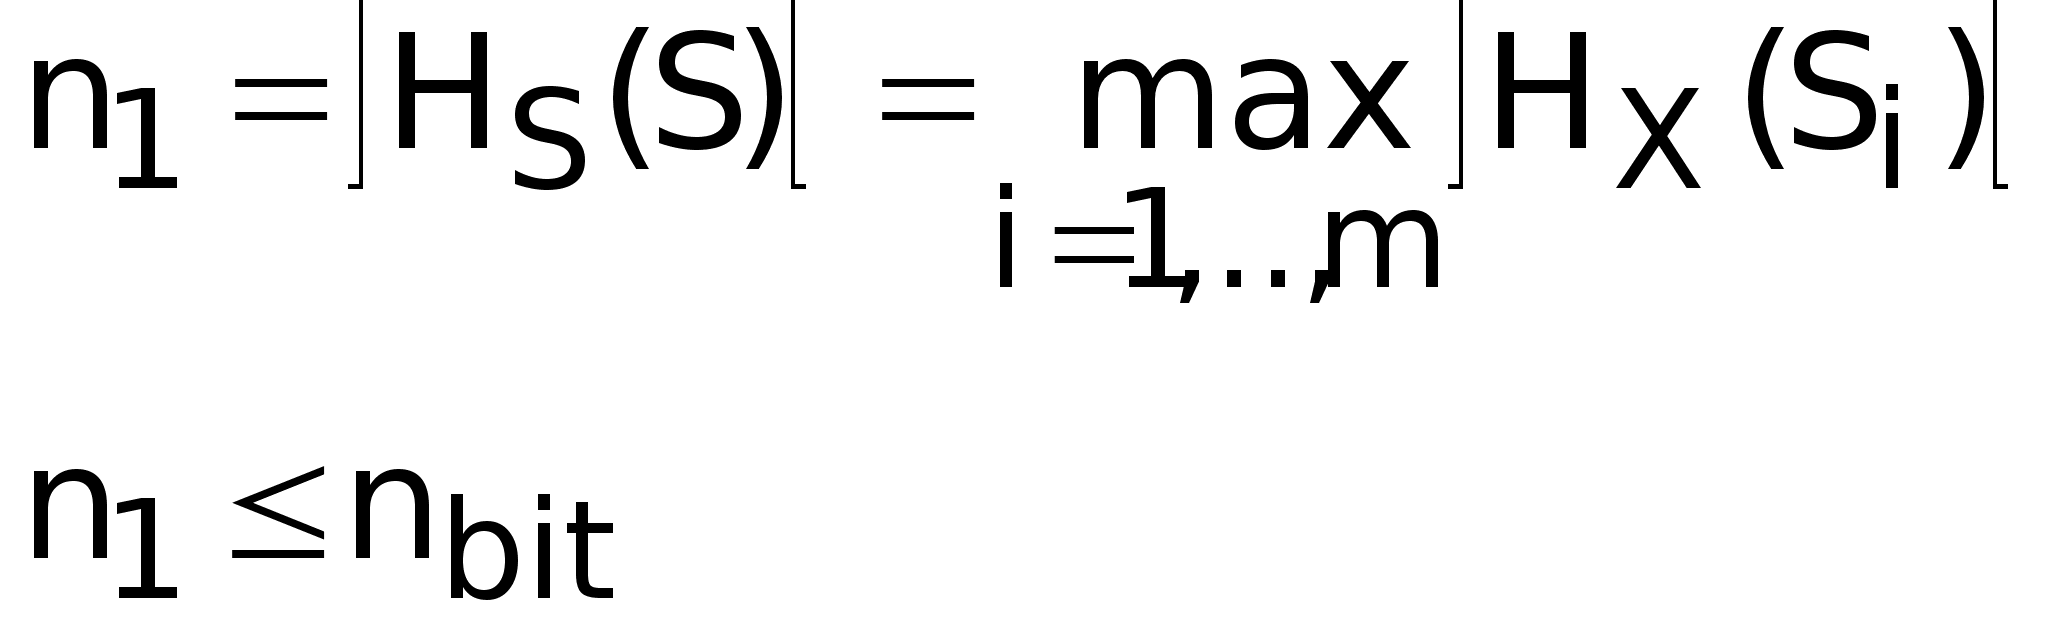 .
(17.6)
Экономия
в разрядах на
один символ
проявляется,
когда n1
Если условие
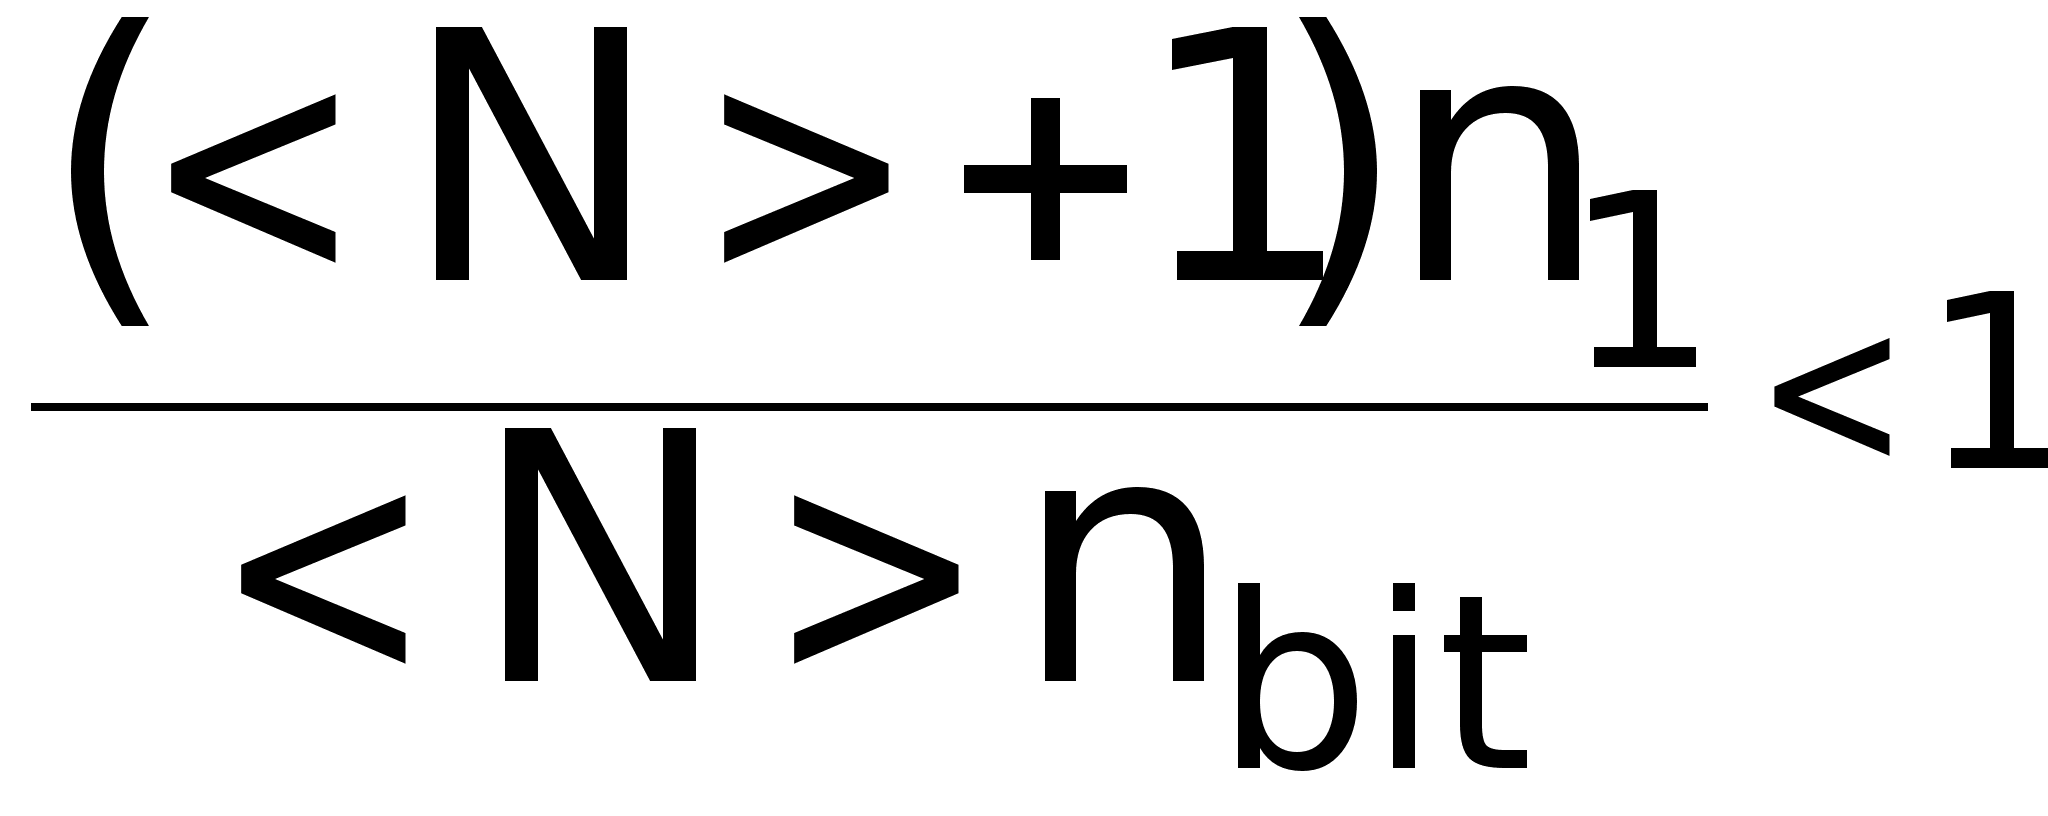 ,
(12.7)
где
2. Ручной ввод текстовой информации с клавиатуры
Клавиатуры могут характеризоваться:
1) эксплуатационными характеристиками:
а) количество типов клавиш;
б) количество клавиш каждого типа;
в) расположение клавиш. По расположению клавиш наибольшее распространение получила клавиатура QWERTY, однако, возможны и другие варианты расположения символов клавиатуры (Дворака и Делея);
2) механическими характеристиками, основной из которых является функция упругости клавиш.
По способу обнаружения нажатия клавиш выделяют три типа клавиатур:
1) с гальваническим контактом или с открытым (не герметичным контактом). Для них характерна низкая стоимость и малое время наработки на отказ;
2) с магнитным принципом обнаружения (на основе магниточувствительных и проводниковых структур). Для них характерна большая стоимость, но очень высокая надёжность;
3) с ёмкостным принципом обнаружения нажатия. Для них характерна высокая износостойкость, низкая надёжность и сложность настройки.
Принцип кодирования клавиш клавиатуры не зависит от кодирования символов. В системное устройство ПЭВМ посылается не код символа, которому соответствует данная клавиша, а позиционный код клавиши. Переход к коду символа осуществляется специальной схемой управления клавиатурой, которую можно перепрограммировать.
К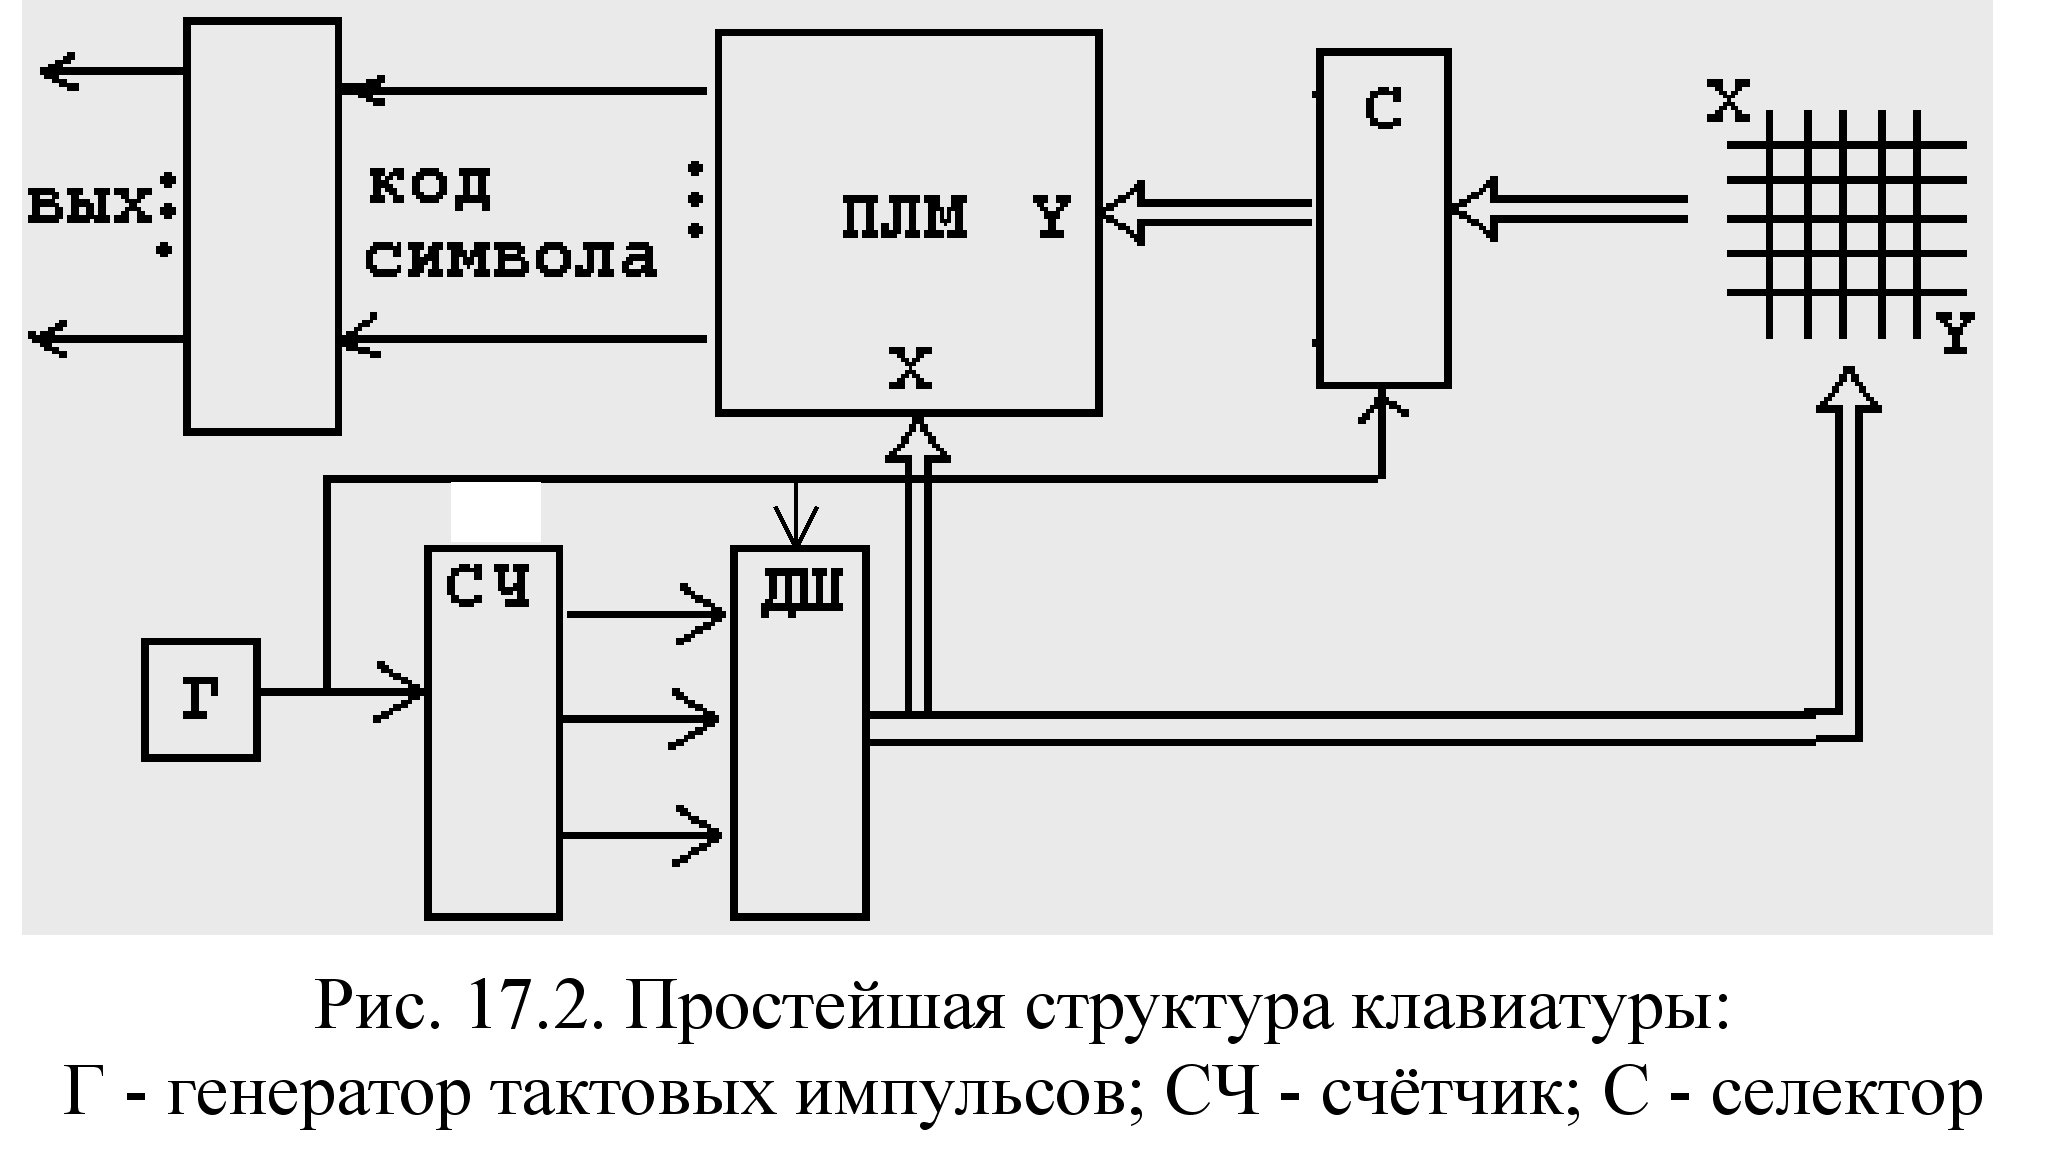
лавиатура
включает в себя
совокупность
ключей клавиш
и схемы управления
для формирования
кода при замыкании
ключа, исключения
неоднозначности
кодирования
из-за “дребезга”
контактов и
выполнения
других управляющих
функций. Клавиатура
проектируется
как конечный
автомат (рис.
17.2)
Д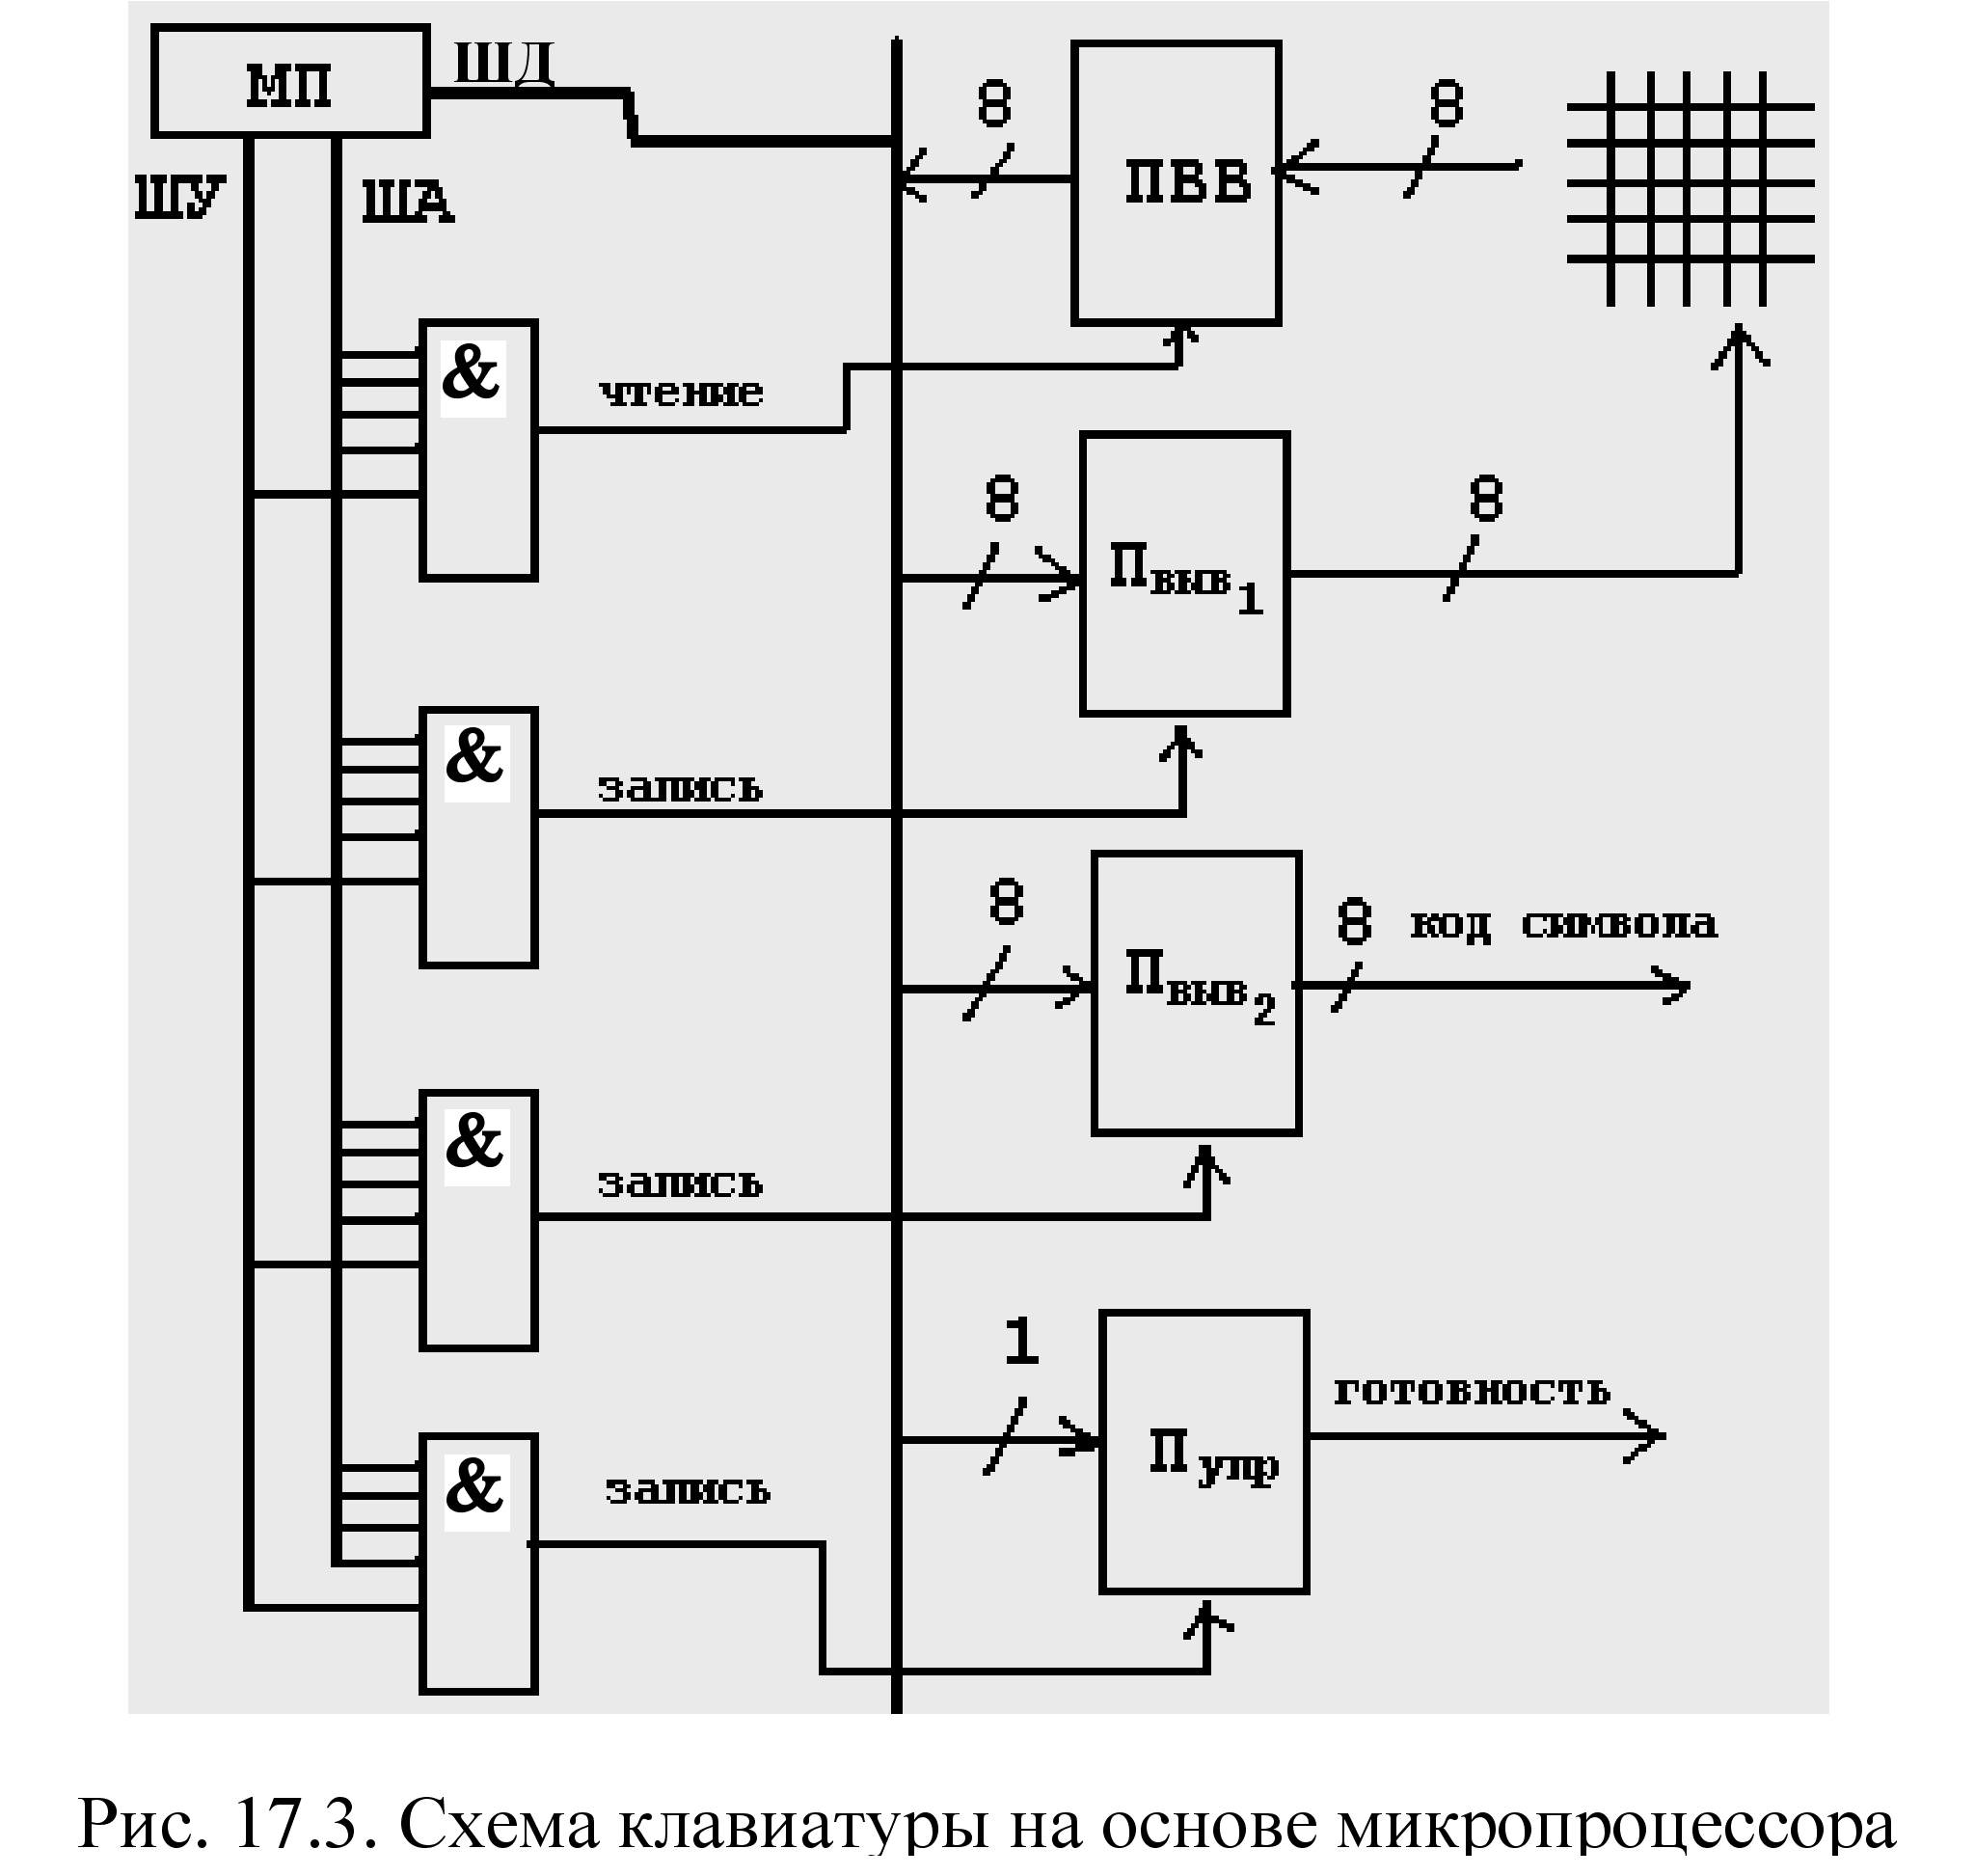
ешифратор
последовательно
опрашивает
состояние
ключей, расположенных
с столбцах X
матрицы клавиатуры.
Если какая-либо
клавиша нажата,
то сигнал через
замкнутый
контакт поступает
на соответствующую
горизонтальную
шину Y и через
селектор (регистр)
поступает на
вход ПЛМ. Сигналы
с дешифратора
и селектора
образуют адресный
вход ПЛМ, в ячейках
которой записаны
коды символов
(их младшие
разряды). Код
символа записывается
в выходной
регистр. Старшие
разряды кода
определяются
содержимым
специального
регистра, изменяющего
своё значение
только при
нажатии клавиши
изменения
регистров
(Shift, Alt и др.).
Проблема “дребезгов” клавиатуры решается использованием вместо ПЛМ микропроцессора. Вертикальные и горизонтальные шины матрицы контактов подключаются, соответственно, к портам вывода и ввода (Пвыв) и (Пвв), для передачи в ЭВМ сформированного кода символа используется второй порт вывода микропроцессора (см. рис. 17.3).
Для устранения “дребезгов” используется накопление веса нажатой клавиши за несколько циклов опроса, образующих период опроса. Если в период опроса координаты клавиши не совпали, то инициируется сброс счётчика веса и начинается новый период опроса.
Вопросы к лекции
1. Проверить эффектность кодирования символом кодом КОИ-7, в котором |S|=128, все символы разбиты на 8 групп m=8 с равной вероятностью встречаемости символов в группе. Определить, сколько разрядов в этом коде отводится под специальные коды переключения между группами.
________________________________________________________________________________________________
Курс «Периферийные устройства»
(лекции)
-
Лекция 18
Устройства ввода-вывода текстовой информации
с промежуточного носителя
План
1. Читающие автоматы.
2. Сканеры.
3. Алгоритмы контрастирования.
4. Алгоритм сканирования информации.
4.1. Метод идентификации контуров.
4.2. Распознавание символов аппаратными структурами с помощью нейронных сетей.
5. Интерфейсы читающих устройств.
На всех специальных носителях текстовая информация храниться в двоичной форме, понятной ЭВМ. Однако существуют устройства автоматического ввода, так называемые читающие автоматы (ЧА), предназначенные для ввода текстовой информации с первичного документа.
1. Читающие автоматы
При проектировании читающего автомата большое значение имеет выбор типов распознаваемых шрифтов. Кроме обычных шрифтов (рукописных или машинописных) существуют специальные шрифты:
кодированные - на основе комбинации точек и штрихов различного тона и ширины (для идентификации изделий);
стилизованные - изображение символа специально искажено с целью придания каждому символу уникального интегрального свойства. Примером ЧА, использующих стилизованные шрифты, могут служить магнитные ЧА 1259 и 1419 фирмы IBM, обеспечивающих считывание информации при обработке банковских документов со скоростью до 1600 документов в минуту (объём алфавита 14 символов в коде EI3B);
нормализованные для заполнения от руки символов по выделенным позициями, как шрифты индексов на конвертах.
Все ЧА разделяют на оптические (ОЧА) и магнитные (МЧА). Магнитные читающие автоматы ориентированы на чтение стилизованных шрифтов, нанесённых на носитель при помощи специальных магнитных чернил, которые имеют добавки, придающие чернилам ферромагнитные свойства. Для таких ЧА существует таблица стилизованных шрифтов для различных типов считывания. Считывающая магнитная головка (МГ) по ширине превышает высоту символа и с постоянной скоростью перемещается вдоль строки (рис. 18.1).
Амплитуда А сигнала на выходе МГ пропорциональна площади магнитных чернил, находящихся под головкой в каждый момент, т.е. суммарной ширине всех горизонтальных отрезков в изображении символа для текущего положения Х головки относительно изображения. Полученный сигнал преобразуется в цифровую форму и каждому изображению символа ставится в соответствие фиксированное количество чисел.
Оптические ЧА разделяются на специализированные и общего назначения. Специализированные ОЧА предназначены для ввода только текстовой информации с бумажного носителя. Они позволяют считывать информацию с формата А4, написанного шрифтом РОСА с вероятностью ошибки 0,5% при скорости 300знак/сек. Читающий автомат EC 6037 позволяет считывать с формата А3 и А4 с шрифтом пишущих машинок с вероятностью ошибки 0,1%. ОЧА общего назначения строятся на базе сканеров, для которых используется специальное математическое обеспечение для распознавания изображений AI-READER.
2. Сканеры
И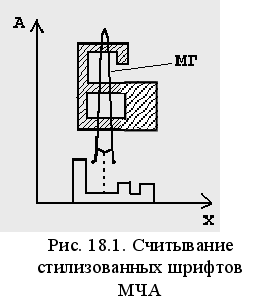 ручные и автоматические
сканеры строятся
по принципу
сканирования
бумажного
носителя отрезком
аппаратуры.
Обязательными
компонентами
сканеров
являются рабочий
элемент считывания,
система закрепления
или перемещения
вводимого
документа,
контроллер
и программные
средства.
Принцип работы сканеров подобен принципу работы печатающих устройств (рис. 18.2).
В большинстве случаев источник света (светодиоды или лазер) освещает рабочее поле вводимого документа. Чувствительный к свету рабочий элемент двигается вдоль изображения или изображение двигается относительного него. Этот элемент за счёт отражённого света считывает фрагменты изображения, которые затем распознаются ПЭВМ и преобразуются в файл. Датчики на приборах с зарядной связью (ПЗС) преобразуют оптическое изображение в электрический сигнал с разрешающей способностью 10 … 30 точек/мм и выше.
Р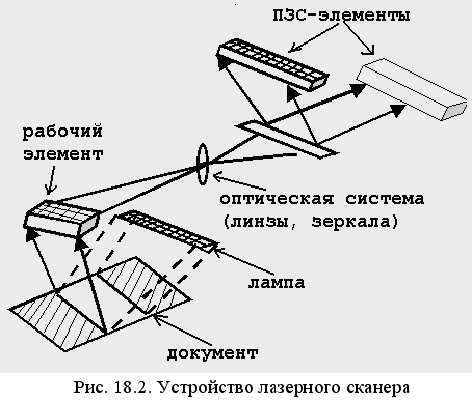
азделяют
три основных
этапа
автоматического
чтения ОЧА:
1. Осмотр и восприятие изображения, в процессе которых вырабатывается электрический сигнал, соответствующий графическому начертанию вводимого символа.
1.1. Захват документа, отделение от других.
1.2. Перемещение документа в позицию осмотра.
1.3. Выравнивание.
1.4. Дискретизация изображения - разбиение на пикселы и присвоение им кодов.
2. Выделение существенных признаков и составление описания воспринимаемого изображения символа.
2.1. Контрастирование.
2.2. Отделение строк.
2.3. Подвод к строке.
3. Распознавание символов.
Качество выполнения двух последних этапов во многом зависит от программного обеспечения ЧА. Ниже подробнее рассмотрим способы реализации выделенных функций этих этапов.
3. Алгоритмы контрастирования
К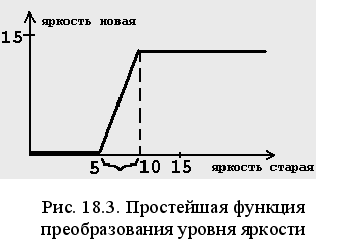 ак
при повышенной,
так и при пониженной
контрастности
восприятие
изображения
осложняется.
Поэтому при
повышенной
контрастности
используется
новая оцифровка,
т.е. изображение
вводится повторно,
а при пониженной
контрастности
её повышают,
используя
различные
методы.
Метод точечных преобразований основан на “растягивании” уровня яркости по всему диапазону, используя функцию преобразования (рис. 18.3).
Функция преобразования может иметь более сложный вид. Такой метод не всегда даёт положительный эффект, т.к. использует информацию только об одной точке.
М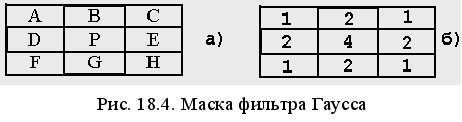 етоды
локальных
операторов.
При использовании
данного метода
новое значение
яркости вычисляется
не только на
основе старого
значения, но
и с использованием
значений яркости
рядом лежащих
точек. Самый
простейший
метод из этой
группы - это
фильтр
Гаусса.
Он использует
маску типа
квадратной
матрицы степени
3 (рис. 18.4, а) с весами
пикселей (рис.
18.4, б), сумма которых
равна 16. Новое
значение яркости
пикселя Р
определяется
по формуле
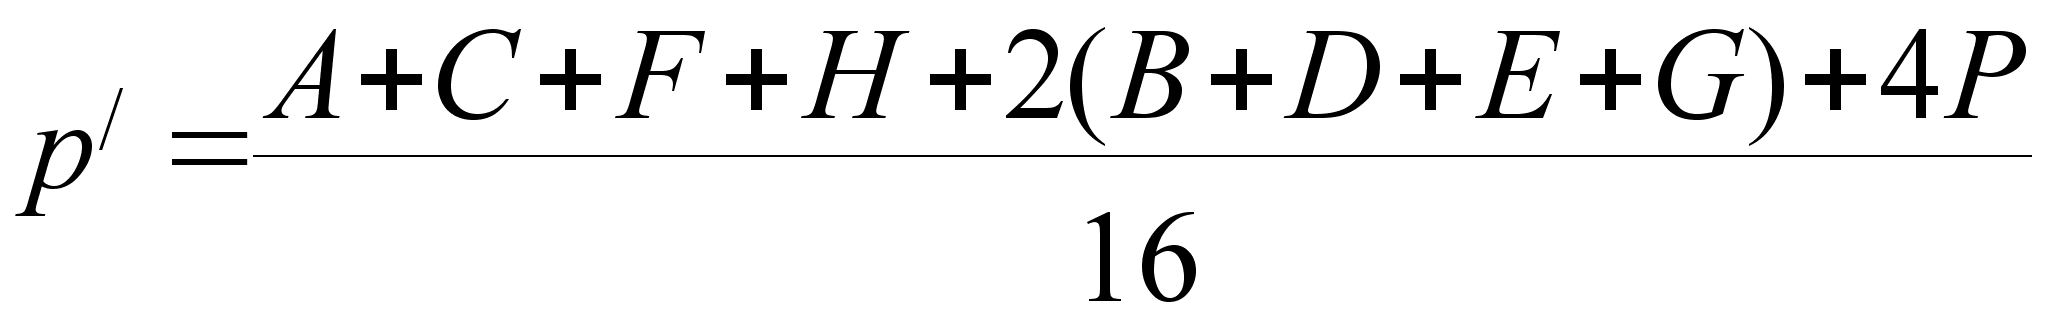 (18.1)
Такая маска удобна при программной и аппаратной реализации (рис. 18.5).
Для непосредственной реализации этого метода используется двойной объём памяти для хранения исходного поля и поля с результатом обработки. Это является неудобным. Поэтому новое значение яркости пикселей сдвигается в направлении, откуда начата обработка на половину окна в пикселях. После завершения обработки выполняется сдвиг обратно. При этом информация теряется только по границам окна.
Ф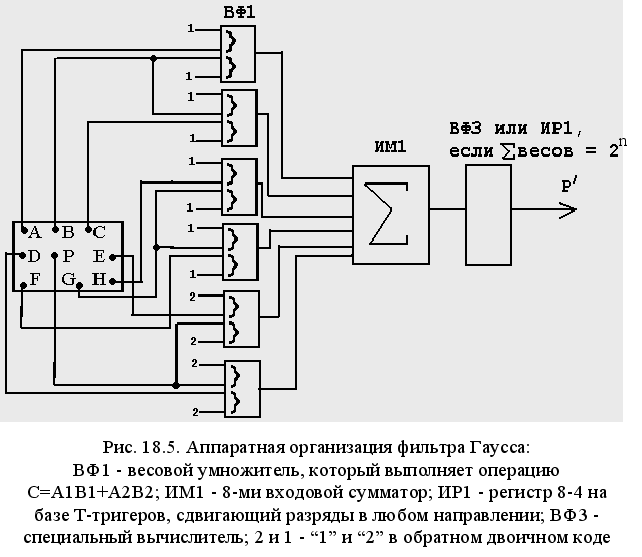
ильтр
Гаусса используется
для “размазывания”
изображения
с целью снижения
дифракционных
и прочих краевых
шумов и с целью
снижения зернистости
изображения.
Многие алгоритмы распознавания символов работают на основе распознавания контуров, поэтому контура выделяют фильтром Собеля. Этот фильтр реализуется посредством использования масок 2-х типов (рис. 18.6). Яркость пикселя определяется по следующей формуле
 X=(F+2G+H)-(A+2B+C)
Y=(C+2E+H)-(A+2D+F); (18.2)
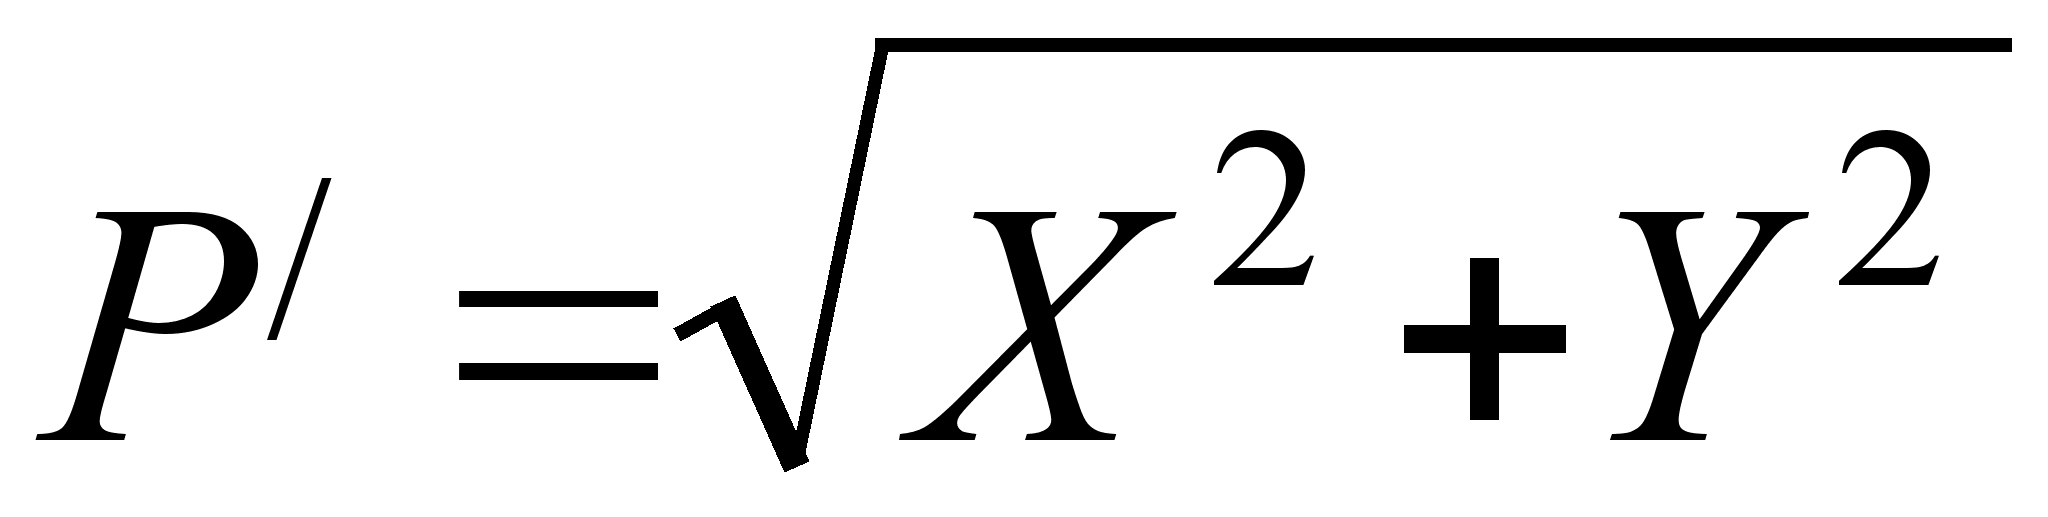 .
К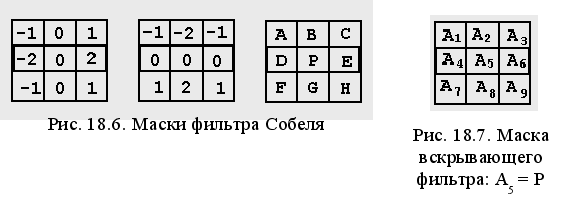 роме
рассмотренных
выше фильтров
используется
ещё и вскрывающий
фильтр
(рис. 18.7). Он реализуется
в виде двух
локальных
операторов.
Первый из них
вызывает эрозию
- снятие одного
слоя пиксела
с объекта, а
второй вызывает
наращивание
слоя пикселей:
ЭН-1 - вскрывающий оператор уровня 1;
ЭЭНН-2 - вскрывающий оператор уровня 2.
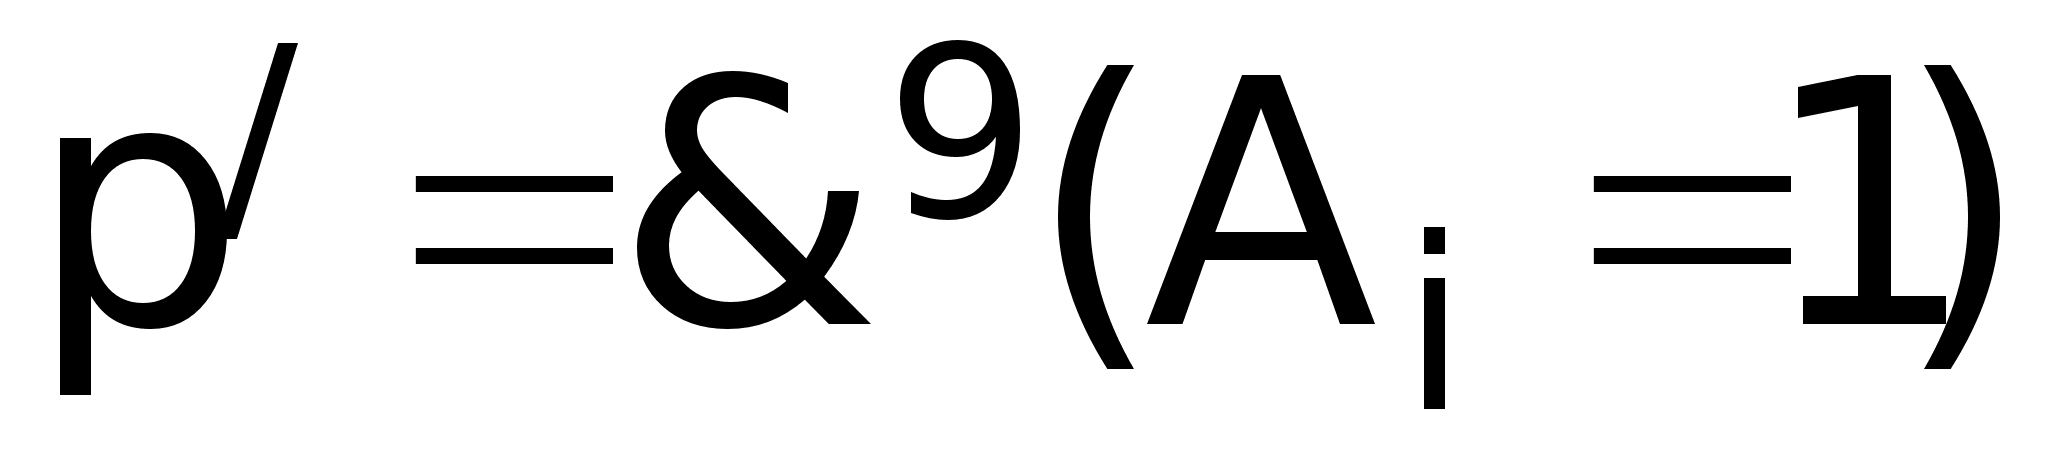 -
эррозия (Э);
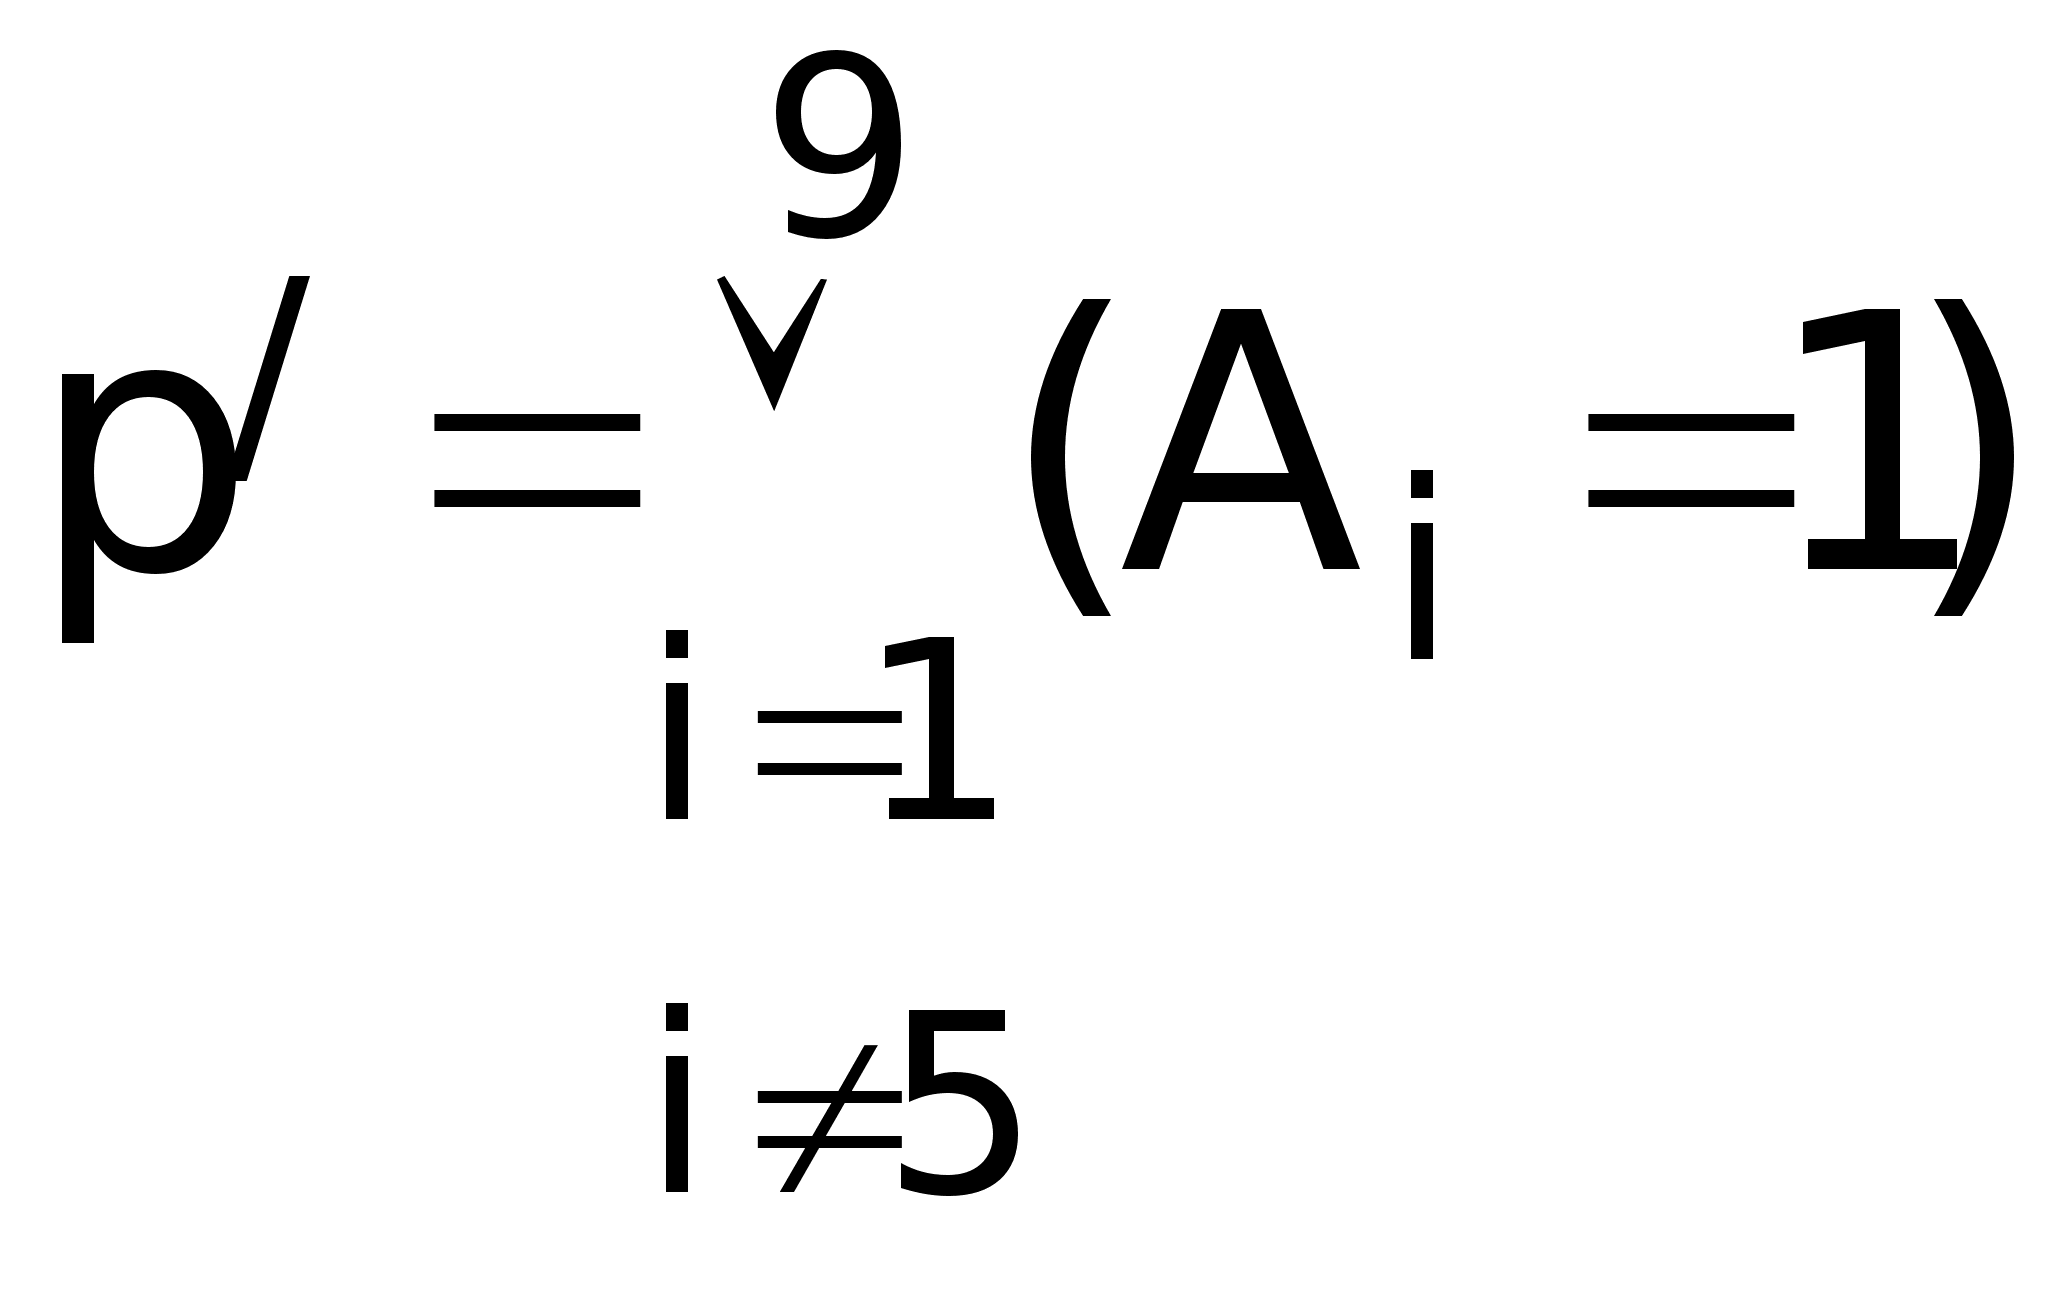 - наращивание
(Н) (18.3)
Чем глубже уровень вскрытия, тем чище изображение, но если глубина вскрытия соизмерима с шириной символа, то символ может потеряться.
4. Алгоритм сканирования информации
Определение строк реализуется программой распознавания информации AI-READER совместно с аппаратурой ScanJet.
Исходными данными для процедуры отделения строк являются: исходный читаемый текст, размер букв и средний размер в пикселях интервалов межбуквенных и межстрочных. Алгоритм этой процедуры состоит из 4-х основных этапов:
1. Подвод к первой строке текста.
1.1. Сканирование документа, начиная с верхней границы горизонтальной апертурой (линией) параллельно верхней границе листа до встречи первого засвеченного пикселя.
1.2. Сканирование строки вертикальной апертурой, размер которой определяется как средний размер буквы плюс половина размера интервала между строками. Сканирование начинается с правой границы документа до первого засвеченного пикселя.
1.3. Сканирование буквы линейно вертикальной апертурой той же высоты, в результате которого формируется матрица образа буквы в пикселях [pij].
2. Проверка истинности выражения
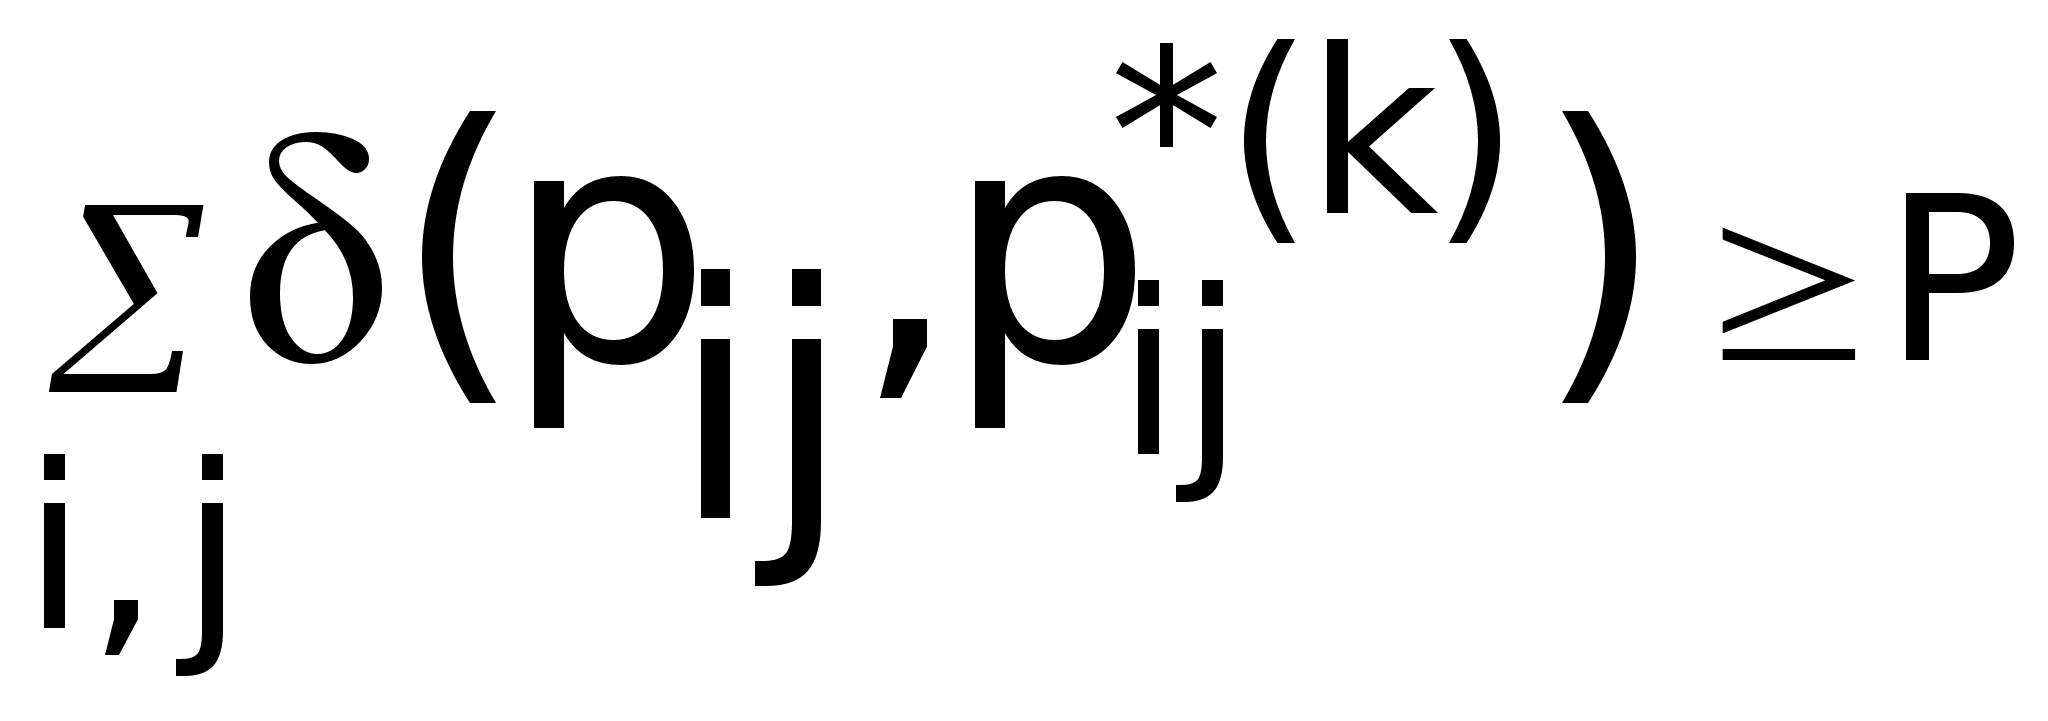 ,
(18.4)
где
[pij] - матрица изображения
просканированного
символа;
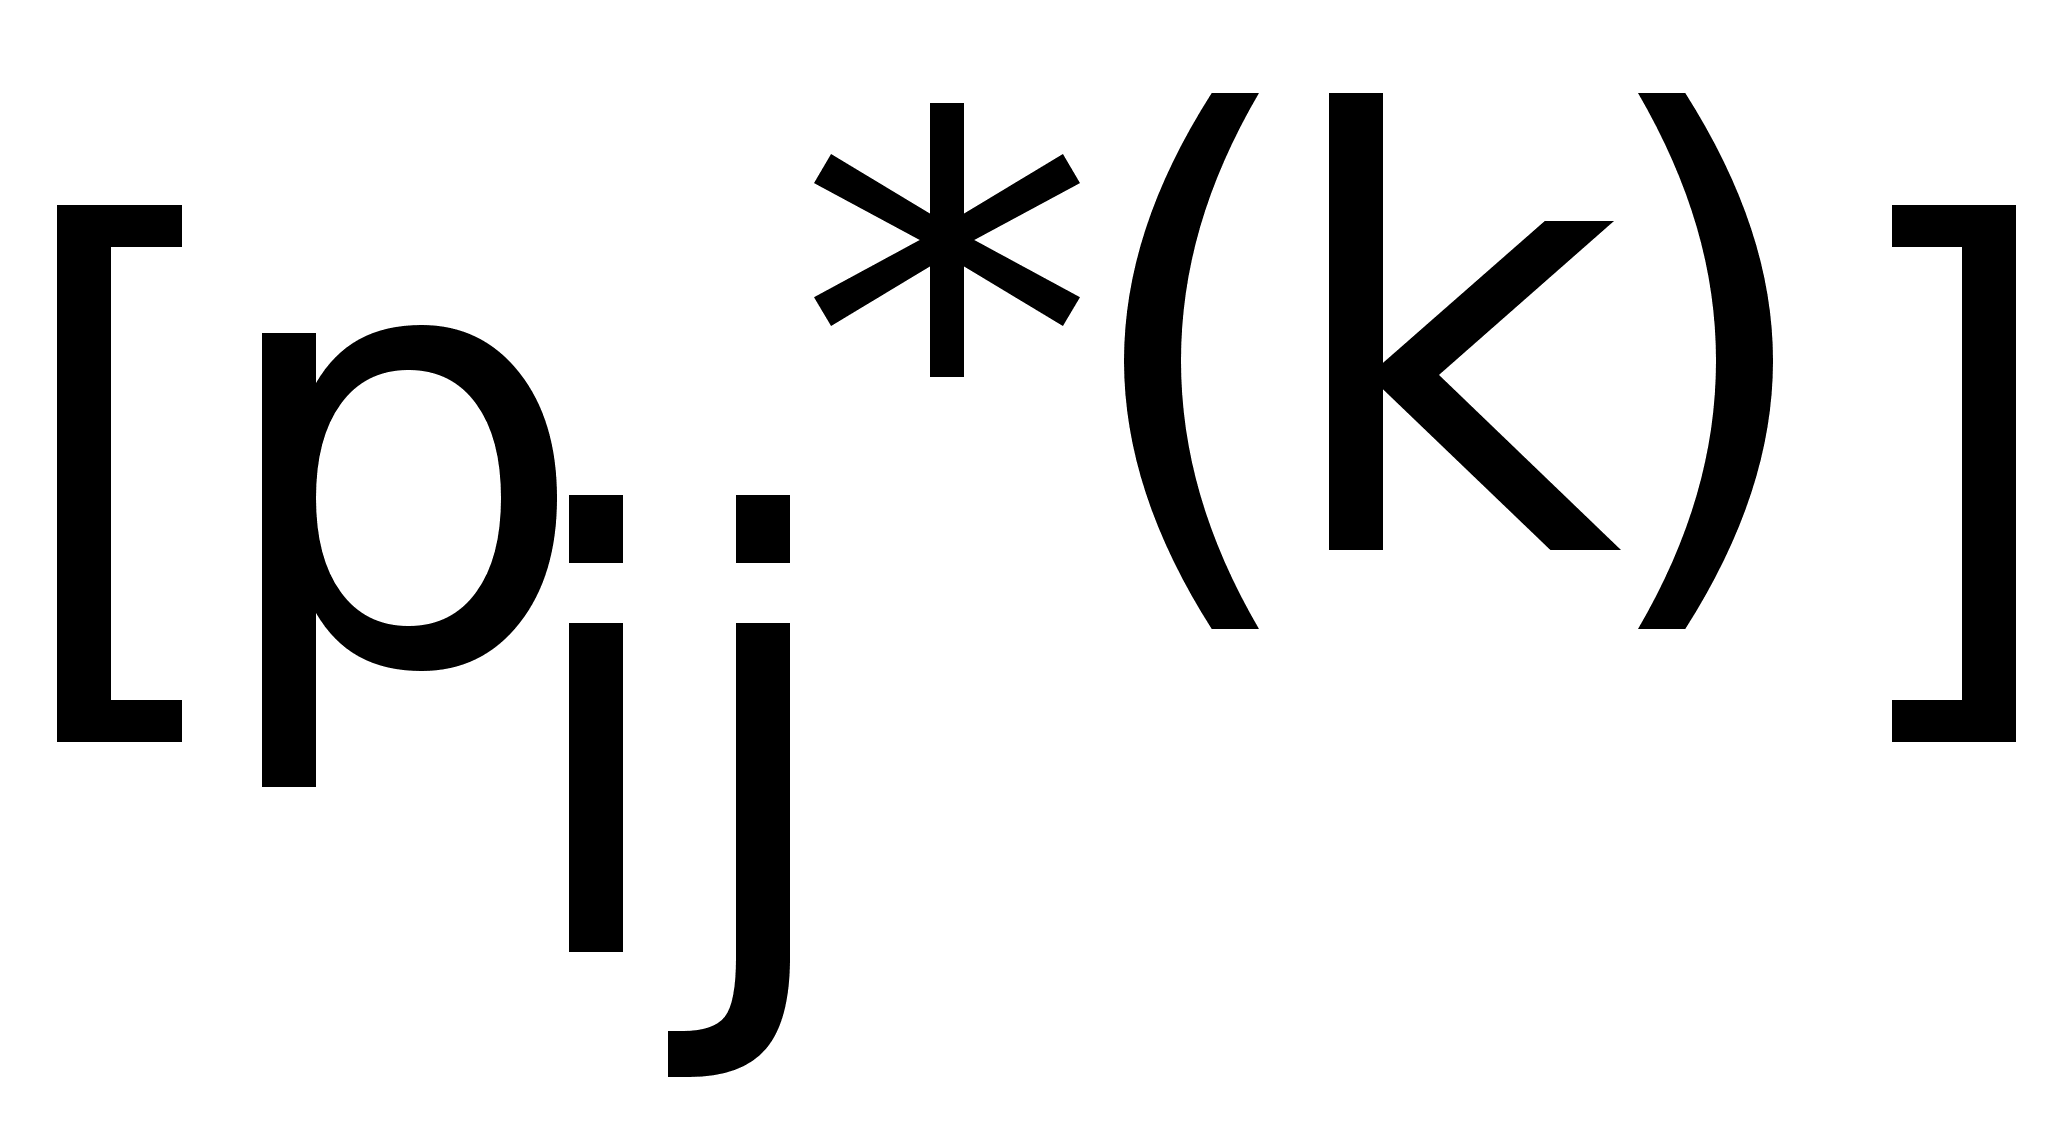 - матрица изображения
эталонного
к-го символа;
- функция, которая
определяется
как
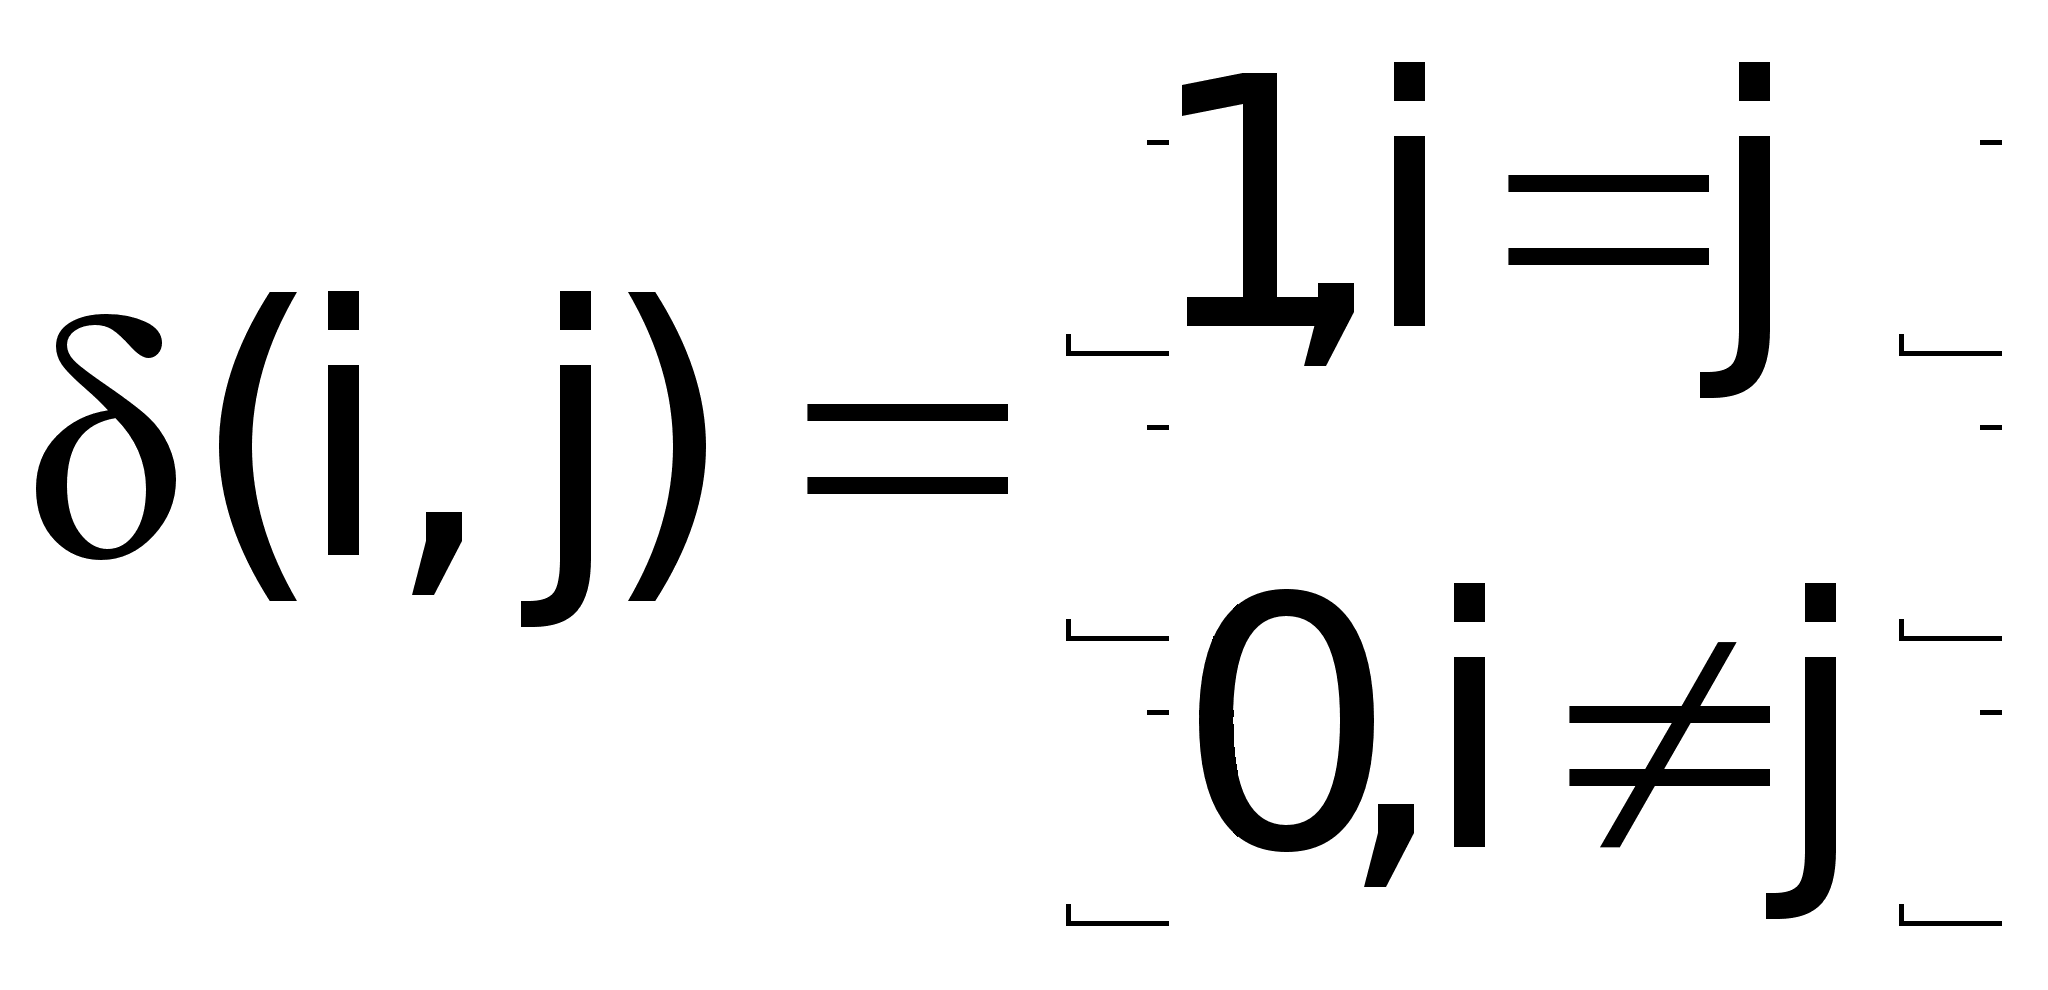 - функция совпадения;
Р - порог принятия
решения (80% от
количества
пикселей в
эталоне).
Чем больше совпадений тем ближе символ к этому эталону, если порог Р превышен, то это означает, что символ распознан. Если символ не находит своего эталона, то возможно два варианта:
а) в режиме обучения программа запрашивает, что это за символ и запоминает его как эталонный для данного кода;
б )
в рабочем режиме
программа
выдаёт отказ
распознавания
и символ заменяется
на символ а
.
3. Переход к следующему символу к п. 1.2.
4. Переход к следующей строке к п. 1.1.
Недостатком данного алгоритма является то, что формируется код для перехода на следующую страницу.
Для распознавания символов существуют специальные методы:
метод сравнения;
корреляционный метод. Он похож на рассмотренный выше метод, но вычисляется не функция сравнения, а коэффициент корреляции, который сравнивается с порогом Р;
метод распознавания по вторичным признакам для стилизованных шрифтов;
методы распознавания, основанные на нейросетях.
4.1. Метод идентификации контуров
Этот метод основан на выделении контура по алгоритму Фримена с последующей идентификацией контура. Цепной код Фримена позволяет представить контур произвольной формы в виде последовательности коротких векторов (рис. 18.8).
А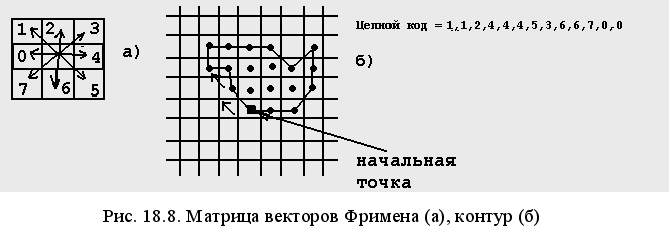
лгоритм
Фримена.
Поиск начальной точки. Сканирование вертикальной линейной апертурой и развёртка горизонтальной апертуры до первого засвеченного пиксела.
Проверка всех примыкающих пикселей по направлению, начиная с вектора 0, до тех пор, пока не встретится засвеченный пиксель. Поворот от исходной точки осуществляется по возрастанию номеров векторов. Если примыкающих пикселей не найдено, то считается, что обнаружен отдельный пиксель и его не рассматривают.
Направление последнего вектора отмечается как текущее, а его конец считается текущим пикселем.
Повторяют сканирование примыкающих пикселей до обнаружения засветки, начиная от пикселя, расположенного слева от текущего вектора по часовой стрелке.
Алгоритм повторяют с п. 3 до тех пор, пока положение текущего пикселя не совпадёт с начальным.
Недостатком этого метода является то, что распознавание символа зависит от его поворота.
Если вектор кодировать комплексным числом: 0 - (1); 1 - (-1+i) …, то на вращение контура можно не обращать внимание.
Условие распознавания:
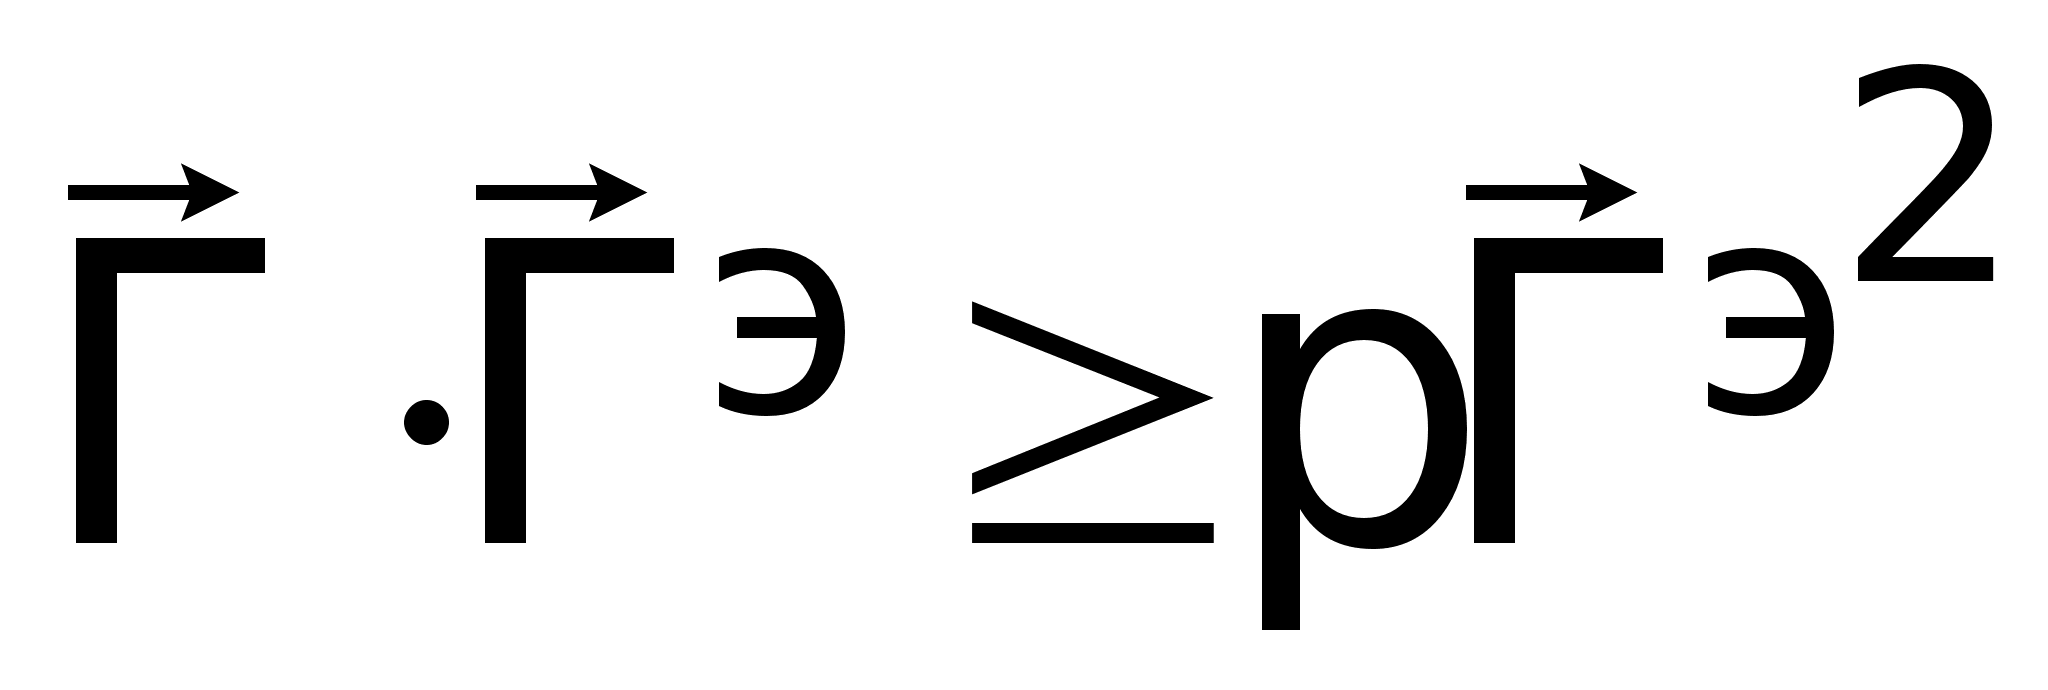 ,