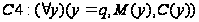Логическое и функциональное программирование


Этот метод неэффективен и избыточен. Можно показать, что высказывание S противоречиво, если исследовать меньшее число моделей. Достаточно ограничиться атомами A1 и A3, то есть провести присваивание значений истинности только этим атомам, а значит использовать только четыре модели.
 Теорема
Эрбрана – Сколема
– Геделя. В этой
теореме утверждается,
что можно найти
частичное
присваивание,
приписывающее
значение ложь
любому противоречивому
множеству
предложений.
4.2 Доказательство от противного
4.2.1 Неаксиоматическое описание процедуры
В логике предикатов используется формальный метод доказательства теорем, допускающий возможность его машинной реализации. Но для упрощения рассмотрим сначала процедуру доказательства неаксиоматическим путем.
Пусть в качестве е задана группа логических формул следующего вида:
Отец(x, y) : x является отцом y;
Брат(x, y) : x, y – братья;
Кузен(x, y) : x, y – двоюродные братья;
Дедушка(x, y) : x – дедушка y.
Используя эти предикаты можно записать следующие утверждения:
(1) ("x1)("y1)("z1)((отец(x1, y1) Щ отец(y1, z1)) ® дедушка(x1, z1)):
если x1 отец y1, а y1 отец z1, то x1 дедушка z1.
(2) ("x2, y2, z2, w2)((отец(x2, y2) Щ брат(x2, z2) Щ отец(z2, w2)) ® кузен(y2, w2)) .
(3) ("x3,
y3, z3)((отец(x3,
y3) Щ
отец(x3,
z3) Щ
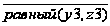 )
® брат(y3,
z3)).
Предположим также, что помимо этих логических формул заданы следующие факты:
(4) Отец(Александр, Сергей),
(5) Отец(Сергей, Ричард).
(6) Отец(Сергей, Иван).
Сначала неаксиоматически зададим процедуру, которая из логических формул выводит заключение. Вывод формулы C из логических формул A, B будем задавать в виде схемы:
А: Все люди смертны
В: Сократ – человек
С: Сократ – смертен.
Если в переменную подставляется значение, то слева от наклонной черты запишем имя переменной, а справа – значение. Например, если в переменную x подставляется значение Сократ, то будем это записывать как x/Сократ.
Предположим, теперь, что требуется доказать – истинна или ложна логическая формула. В ее истинности или ложности можно убедиться логической процедурой, применив ранее заданные логические формулы. Эта процедура выглядит аналогично процедуре доказательства теорем, когда выдвигается некоторая теорема, а справедливость ее устанавливается из известных аксиом.
Например, предположим, что задан вопрос: «Кто дедушка Ричарда?». Его можно записать в виде:
($x)(дедушка(x, Ричарда)).
Ответ может быть получен в следующей последовательности:
Поскольку заключение получается из комбинации уже существующих правил, ответ является результатом процедуры восходящего вывода.
С другой стороны можно осуществить и нисходящий вывод. Нисходящий вывод начинается с того заключения, которое должно быть получено, и далее в базе проводится поиск информации, которая последовательно позволяет прийти к данному заключению.
В логике предикатов такая процедура полностью формализована и носит название метода резолюции.
Для применения этого метода исходную группу логических формул преобразуют в нормальную форму. Преобразование проводится в несколько стадий.
4.2.2 Процесс нормализации
4.2.2.1Префиксная нормальная форма
Рассмотрим фразу «любой человек имеет отца». Ее можно представить в логике предикатов в следующем виде:
("x)(человек(x) ® ($y)(отец(y, x))).
$ находится внутри ППФ. Это не всегда удобно, поэтому целесообразно вынести все кванторы за скобки, чтобы они стояли перед ППФ. Такая форма носит название префиксной нормальной формы.
Преобразование к префиксной нормальной форме произвольной ППФ можно легко выполнить машинным способом, используя для этого несколько простых правил.
Во-первых, необходимо исключить связки ® и ». По определению:
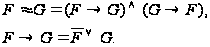
Следовательно, во всех комбинациях ППФ можно ограничиться тремя связками Ъ, Щ и ` .
Предикат, не содержащий переменных, аналогичен высказыванию, поэтому такие предикаты будем обозначать F, G. Когда некоторое выражение выполняется для любого квантора " и $ будем записывать такой квантор Q.
Легко показать:
1.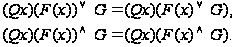
Это соответствует: высказывание не имеет отношения к квантору переменной, которая включена в другой предикат.
Между предикатами существует следующее соотношение:
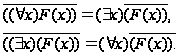
Таким образом, «необязательно F(x) выполняется для всех x» є «существует такое x, что F(x) не выполняется»; «не существует такое x, что выполняется F(x)» є «для всех x не выполняется F(x)».
Далее имеем:
2.("x)F(x)Щ("x)H(x) = ("x)(F(x)ЩH(x))
($x)F(x)Ъ($x)H(x) = ($x)(F(x)ЪH(x)).
Это означает, что квантор " обладает дистрибутивностью относительно Щ, а $ - относительно Ъ.
С другой стороны:
("x)F(x)Ъ("x)H(x)№("x)(F(x)ЪH(x)).
($x)F(x)Щ($x)H(x)№($x)(F(x)ЩH(x)).
Это легко показать. Пусть для первого выражения x определен на множестве D ={а, б, в}, при этом истиной являются F(а), F(б), H(в). Тогда левая часть не выполняется, а правая истинна. На самом деле справедливо:
("x)F(x)Ъ("x)H(x)®("x)(F(x)ЪH(x)).
($x)F(x)Щ($x)H(x)®($x)(F(x)ЩH(x)).
Смысл этих формул в том, что описание для двух разделенных предикатов не совпадает с описанием, использующим эти предикаты одновременно как одно целое и с одинаковыми переменными. Поэтому, изменив все переменные в их правых частях, получим:
("x)F(x)Ъ("x)H(x) = ("x)F(x) Ъ ("y)H(y),
($x)F(x) Щ($x)H(x) = ($x)F(x) Щ ($y)H(y).
Теперь H(y) не содержит переменной x и поэтому не зависит от связывания x. Отсюда:
3. ("x)F(x)Ъ("x)H(x) = ("x)("y)(F(x) Ъ H(y)),
($x)F(x) Щ($x)H(x) = ($x)($y)(F(x) Щ H(y)).
Таким образом, процесс получения префиксной нормальной формы можно представить как последовательность шагов:
Используя формулы для ®, », заменим их на Щ, Ъ, ѕ.
Воспользовавшись выражениями
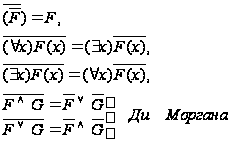
внесем отрицания внутрь предикатов.
Вводятся новые переменные, где это необходимо.
Используя 1, 2, 3 получаем префиксную нормальную форму.
В качестве примера рассмотрим следующее выражение:
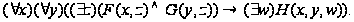
Шаг1:
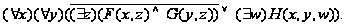
Шаг2:
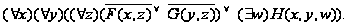
Шаг 3: нет необходимости.
Шаг 4: используем выражение 1 по переменной z –
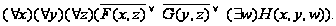
Теперь применяем выражение 1 по переменной w –
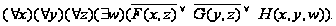
4.2.2.2 Скалемовская нормальная форма
Дальнейшее преобразование предполагает полное исключение из формулы кванторов. При этом необходимо сохранить семантику. Это достигается за счет введения скалемовских функций. Для описания этой функции рассмотрим следующий пример: ("x)($y)подсистема(x,y), для каждого x существует y такой, что x его подсистема.
Это означает, что если выделить конкретное x, то для этого x существует y, удовлетворяющее функции подсистема(x, y). Иными словами, y зависит от x, то есть, если задано x, то и существует соответствующее ему y. Отсюда следует, что y можно заменить на функцию f(x), которая задает отношение между x и y. Поскольку f(x) возникло из-за того, что переменная y квантифицирована $, при подстановке функции на место y, квантор $ уже не требуется. Таким образом, исходную логическую формулу можно переписать: ("x) подсистема(x, f(x).
Такая функция называется скалемовской.
Приоритетность действия кванторов, имеющихся в префиксной форме, определяется слева направо. Например: ("x)($y)("z)F(x, y, z) Ю ("x)("z)F(x, f(x), z). А для случая: ("x)("z)($y)F(x, y, z) Ю ("x)("z)F(x, f(x, y), z).
Таким образом, переменной, которая в логической формуле влияет на связанную квантором существования переменную, является любая переменная с квантором общности, которая стоит левее переменной из квантора существования. Если переменная связанная квантором существования является крайней слева, такую формулу можно заменить функцией без аргументов (константой):
($x)("y)подсистема(x, y) =подсистема.
Если проделать эту операцию для примера, получим:
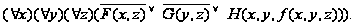
В случае, когда в одной логической формуле имеется более двух связанных квантором существования переменных, то сколемовская функция также будет распадаться на различные функции.
("x)($y)("z)($w)F(x ,y ,z, w) = ("x)("z)F(x, f(x), z, g(x, z)).
Если подобным образом исключить связанные квантором существования переменные, то любые другие переменные будут связаны только квантором общности и не надо пояснять, что преременные связаны этим квантором. Следовательно, квантор общности можно исключить. Для примера получим:
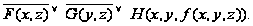
Такое представление и есть сколемовская нормальная форма.
Теперь можем определить алгоритм получения сколемовской формы:
Составить список L переменных, связанных квантором общности. Сначала список L пуст.
Пусть Ci – рассматриваемое предложение, j – номер использующейся сколемовской функции Sij. Положим j = 1.
Удалить кванторы , начиная с самого левого и применяя в зависимости от необходимости правила а или б.
а. Если рассматривается квантор "x, то удалить его и добавить x к списку L.
б. Если рассматривается квантор $x, то удалить его и заменить x во всем предложении Ci термом Sij(x1, …, xk), где x1, …, xk переменные, находящиеся в этот момент в списке L. Увеличить j на 1.
Следующим шагом является переход к конъюнктивной нормальной форме, а затем к клаузальной форме, то есть форме предложений.
Приведение
к конъюнктивной
нормальной
форме осуществляется
заменой пока
это возможно
(AЩB)ЪC
на (AЪC)Щ(BЪC).
В результате
получим выражения
вида A1Щ
… ЩAn,
где Ai
имеет вид ( ,
причем
 есть терм или
атомарный
предикат или
атомарная
формула или
их отрицание.
Целесообразно
осуществить
и минимизацию
по следующим
правилам:
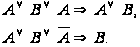
Наконец, исключаем связку Щ, заменяя AЩB на две формулы A, B. В результате многократной замены получим множество формул, каждая из которых является предложением. Это и есть клаузальная нормальная форма.
4.2.2.3 Предложения Хорна
Все клаузальные формулы (предложения) представляют собой несколько предикатов, то есть:
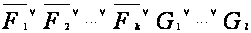
Эти формулы в зависимости от k, l классифицируются по нескольким типам.
Тип 1: k = 0, l = 1.
Предложение представляет собой единичный предикат, и оно может быть записано как ®F(t1, t2, …, tm), где t1, t2, …, tm – термы. В случае когда все термы представляют собой константы, они описывают факты, которые соответствуют данным из БД. Если термы содержат переменные, то они задают общезначимые представления, высказываемые для группы фактов. Например, таким представлением является:
® текучесть(x): все течет, все изменяется.
Тип 2: kі1, l = 0.
Этот тип можно записать в виде:
F1ЩF2Щ…ЩFk®.
Обычно используется для описания вопроса. Причина, по которой данный тип предложения представляется вопросом, является то, что ответ на вопрос реализуется в виде процедуры доказательства, однако для этого доказательства используется метод опровержения, при котором создается отрицание вопроса и доказывается, что отрицание не выполняется.
Тип : kі1, l=1.
Этот тип соответствует записи в форме «Если ___, то ____.».
F1ЩF2Щ…ЩFk®G1.
Тип: k=0, l>1.
Этот тип имеет вид:
®G1ЪG2Ъ…ЪGl
и используется при представлении информации, содержащей нечеткость. Обычно нечеткость возникает при неполноте информации. В этой формуле появляется неполнота информации в том смысле, что из нее нельзя определить, какой из предикатов G1, …, Gl является истиной.
Тип: kі1, l>1.
Это наиболее общий тип.
В системе предложений Хорна среди всех перечисленных типов предложений допустимы типы предложений 1, 2, 3, а 4, 5 запрещены.
4.2.3Формализация процесса доказательств
Доказательство демонстрирует, что некоторая ППФ является теоремой на заданном множестве аксиом S (то есть результатом логического вывода из аксиом).
Положим, что S есть множество из n ППФ, а именно, A1, A2, …, An, и пусть ППФ, для которой требуется вычислить является ли она теоремой, есть B. В таких случаях можно сказать, что доказательство показывает истинность ППФ вида:
(A1Щ…ЩAn®B) (1)
при любой его интерпретации. Можно сказать по другому: это определение эквивалентно тому, что отрицание формулы:
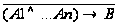 (2)
не выполняется (ложно) при любой интерпретации.
Поскольку эта формула является ППФ, то ее можно преобразовать к клаузальной форме, используя для этого приведенный выше алгоритм. Пусть преобразованная ППФ есть S.
Основная идея метода, называемого методом резолюции, состоит:
В проверке содержит или не содержит S пустое предложение.
В проверке выводится или не выводится пустое предложение из S, если пустое предложение в S отсутствует.
Любое предложение Ci, из которого образуется S, является совокупностью атомарных предикатов или их отрицаний (предикат и его отрицание называются литералами), соединенных символами дизъюнкции, вида:
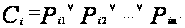
Сама же S является конъюнктивной формой, то есть имеет вид:
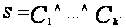
Следовательно, условием истинности S является условие истинности всех Ci в совокупности.
Условием
ложности S
является ложность
по крайней мере
одного Ci.
Однако, условием,
что Ci
будет ложным
в какой-нибудь
интерпретации,
является то,
что множество
 будет пустым.
Это легко показать.
Положим, что
это не так, тогда
среди всех
возможных
интерпретаций
имеется такая,
что какой-нибудь
из литералов
этого множества
или все они
будут истиной
и тогда Ci
не будет ложью.
Следовательно,
если S
содержит пустые
предложения,
формула (2) является
ложью, а это
показывает,
что B выводится
из группы предикатов
A1, … , An,
то есть из S.
4.2.3.1 Метод резолюций для логики высказываний
Предикат, который не содержит переменных, совпадает с высказыванием. Для упрощения рассмотрим сначала резолюцию для высказываний.
Предположим,
что в множестве
предложений
есть дополнительные
литералы (которые
отличаются
только символами
отрицания L
и
 )
вида:
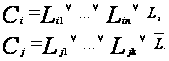
Исключим из этих двух предложений дополнительные литералы и представим оставшуюся часть в дизъюнктивной форме (такое представление называется резольвентой):
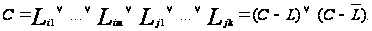
После проведения
этой операции
легко видеть,
что C является
логическим
заключением
Ci
и Cj.
Следовательно,
добавление
C к множеству
S не влияет
на вывод об
истинности
или ложности
S. Если
выполняется
Ci
= L,
 то C пусто.
То что C
является логическим
заключением
из S и C
пусто, указывает
на ложность
исходной логической
формулы.
Приведем простой пример такого доказательства:
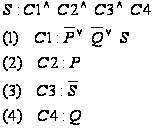
Получим доказательство принципом резолюции:
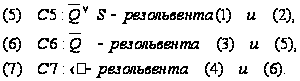
 -
пустое предложение.
Такой вывод теорем из аксиоматической системы носит название дедукции. Алгоритм дедуктивного вывода удобно представлять с помощью древовидной структуры:
Такая структура называется дедуктивным деревом или деревом вывода.
4.2.3.2 Принцип резолюции для логики предикатов
Поскольку в логике предикатов внутри предикатов содержатся переменные, то алгоритм доказательства несколько изменяется. В этом случае, перед тем как применить описанный алгоритм, будет проведена некоторая подстановка в переменные и вводится понятие унификации с помощью этой подстановки. Унификацию проиллюстрируем следующим простым примером.
Рассмотрим два предиката – L(x) и L(a). Предположим, что x – переменная, a - константа. В этих предикатах предикатные символы одинаковы, чего нельзя сказать о самих предикатах. Тем не менее подстановкой a в x одинаковыми (эта подстановка и называется унификацией).
Целью унификации является обеспечение возможности применения алгоритма доказательства для предикатов. Например, предположим имеем:
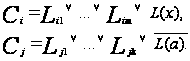
В данном
случае L(x)
и
 не находятся
в дополнительном
отношении. При
подстановке
a вместо
x будут
получены,
соответственно,
 и
,
и поскольку
эти предикаты
отличаются
только символами
отрицания, то
они находятся
в дополнительном
отношении.
Однако, операцию
подстановки
нельзя проводить
при отсутствии
каких-либо
ограничений.
Подстановку t в x принято записывать как {t/x}. Поскольку в одной ППФ может находиться более одной переменной, можно оказаться необходимо провести более одной подстановки. Обычно эти подстановки записываются в виде упорядоченных пар {t1/x1, …, tn/xn}.
Условия, допускающие подстановку:
xi – является переменной,
ti – терм (константа, переменная, символ, функция) отличный от xi,
для любой пары элементов из группы подстановок, например (ti/xi и tj/xj) в правых чачтях символов / не содержится одинаковых переменных.
Унификация
Обозначим группу подстановок {t1/x1, …, tn/xn} через q . Когда для некоторого представления L применяется подстановка содержащихся в ней переменных {x1, …, xn}, то результат подстановки, при которой переменные заменяются соответствующими им термами t1, …, tn принято обозначать Lq.
Если имеется группа различных выражений на основе предиката L, то есть L1, …, Lm}, то подстановка q, такая, что в результате все эти выражения становятся одинаковыми, то есть L1q = L2q = … = Lmq, q - называется унификатором {L1, …, Lm}. Если подобная подстановка q существует, то говорят, что множество {L1, …, Lm} унифицируемо.
Множества {L(x), L(a)} унифицируемо, при этом унификатором является подстановка (a/x).
Для одной группы выражений унификатор не обязательно единственный. Для группы выражений {L(x, y), L(z, f(x)} подстановка q = {x/z, f(x)/y} является унификатором, но является также унификатором и подстановка q = {a/x, a/z, f(a)/y}. Здесь a – константа, x – переменная. В таких случаях возникает проблема, какую подстановку лучше выбирать в качестве унификатора.
Операцию подстановки можно провести не за один раз, а разделив ее на несколько этапов. Ее можно разделить по группам переменных, проведя, например, подстановку {t1/x1, t2/x2, t3/x3, t4/x4} сначала для {t1/x1, t2/x2}, а затем для {t3/x3, t4/x4}. Допустимо также подстановку вида a/x разбить на две подстановки u/x и a/u. Результат последовательного выполнения двух подстановок q и l также подстановка и обозначается l°q.
Если существует несколько унификаторов, то среди них непременно найдется такая подстановка s, что все другие унификаторы являются подстановками, выражаемыми в виде s°l, как сложная форма, включающая эту подстановку. В результате подстановки переменные будут замещаться константами и описательная мощность ППФ будет ограничена.
Чтобы унифицировать два различных выражения предиката, необходима такая подстановка, при которой выражение с большей описательной мощностью согласуется с выражением с меньшей описательной мощностью. Такую подстановку принято называть «наиболее общим унификатором» (НОУ). Метод отыскания НОУ из заданной группы предикатов выражений называется алгоритмом унификации.
Этот алгоритм состоит в том, что сначала упорядочиваются выражения, которые подлежат унификации. Когда каждое выражение будет упорядочено в алфавитном порядке, среди них отыскивается такое, в котором соответствующие термы не совпадают межде собой.
Положим, что при просмотре последовательно всех выражений в порядке слева направо несовпадающими термами оказались x, t. Например, получено {L(a, t, f(z)), L(a, x, z)}. В этом случае, если:
x является переменной;
x не содержится в t, к группе подстановок добавляется {t/x}.
Если повторением этих операций будет обеспечено совпадение всех изначально заданных выражений, то они унифицируемы, а группа полученных подстановок является НОУ.
В приведенном примере третий терм в одном случае z, а в другом – f(z), первое условие выполняется, а второе – нарушается. Поэтому подстановка недопустима. Если в группе предикатных выражений остается хотя бы одно такое, для которого никакими подстановками нельзя получить совпадения с другими выражениями, такая группа называется неунифицируемой.
Рассмотрим другой пример:
P1 = L(a, x, f(g(y))),
P2 = L(z, f(z), f(u)).
Первые несовпадающие члены: {a, z}.
Подстановка: a/z. Имеем:
P1 = L(a, x, f(g(y))),
P2 = L(a, f(a), f(u)).
Первые несовпадающие элементы {x, f(a)}. Подстановка: [f(a)/x]. Имеем:
P1 = L(a, f(a), f(g(y))),
P2 = L(a, f(a), f(u)).
Первые несовпадающие элементы {g(y), u}. Подстановка: [g(y)/u]. Получаем совпадение. Следовательно, НОУ: [a/z, f(a)/x, g(y)/u].
Алгоритм доказательства
Пусть заданы:
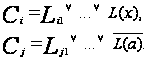
Предикаты
 делаются
дополнительными
с помощью подстановки
[a/x].
Суждение о том,
становятся
ли два выражения
дополнительными,
выносится:
По различию используемых символов.
По существованию НОУ для двух выражений, в которых удалены одинаковые символы.
Далее все делается рекуррентно.
Пример 1. Милиция разыскивает всех въехавших в страну, за исключением дипломатов. Шпион въехал в страну. Однако, распознать шпиона может только шпион. Дипломат не является шпионом.
Оценим вывод: среди милиционеров есть шпион.
Воспользуемся следующими предикатами:
Въехал(x): x въехал в страну.
Дипломат(x): x – дипломат.
Поиск(x, y): x разыскивает y.
Милиционер(x): x – милиционер.
Шпион(x): x – шпион.
Если выразим через эти предикаты посылку и вывод в форме ППФ, то получим:
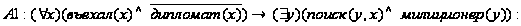
для всех x, если x не является дипломатом, но въехал в страну, найдется милиционер y, который его разыскивает.
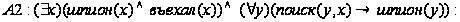
Если существует шпион x, который въехал в страну, и некоторый y разыскивает его, то он сам шпион.
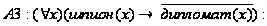
Для всех x справедливо, что если x является шпионом, то он не дипломат.
Заключение:
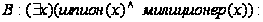
Существует x такой, что он является шпионом и милиционером.
Если эти формулы преобразовать в клаузальную нормальную форму, то получим:
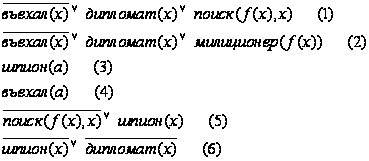
Заключение преобразуем в свое отрицание:
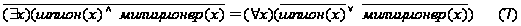
и затем в клаузальную форму без квантора общности.
Последующий процесс доказательства имеет вид:
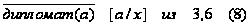
дипломат(а)Ъмилиционер(f(а)) [a/x] из 2,4 (9)
милиционер(f(а)) [a/x] из 8,9 (10)
дипломат(а)Ъпоиск(f(а),а) [a/x] из 1,4 (11)
поиск(f(а),а) [a/x] из 8,11 (12)
шпион(f(a)) [a/x] из 12,5 (13)
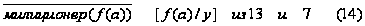
р [f(a)/x)] из 10 и 14 (15)
Еще одной возможностью метода резолюции является возможность получать конкретные значения переменных, содержащихся в заключении.
4.2.3.3 Задачи, использующие равенства
Новые предложения получались до сих пор двумя способами: подстановкой и резолюцией. При резолюции пары предложений, отображаются в новые предложения, а подстановка заменяет терм в предложении другим термом той же синтаксической формы. Иногда возникает необходимость заменить терм равным ему термом, который не является термом, для которого возможна подстановка (подстановочным случаем) в первом терме. Рассмотрим простой пример. Положим f(x, y) = x + y. При сравнении предложений:
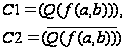
у нас нет способа обнаружить противоречие, поскольку резолюция не допускает замены термов разных синтаксических форм. Поэтому имеет смысл, включить в программу, использующую принцип резолюции, специальные правило вывода, которое должно применяться, когда возникает необходимость в операции равенства. Чтобы это правило было совместимо с остальной частью программы, оно должно удовлетворять двум условиям:
Работать с предложениями, в которых равенство выражено в виде атомов.
Быть операцией, превращающей два предложения в третье.
Это специальное правило вывода называется парамодуляцией.
Пусть A, B и т.д. будут множествами литералов, а a, b, g - термами, то есть константами, переменными или функциональными выражениями. В дополнении к обычному определению атомов и литералов будем записывать атомы равенства в виде a=b (терм a равен терму b). К таким термам можно применять подстановку.
Правило парамодуляции
Если для заданных предложений C1 и C2 = (a’ = b’, B) (или C2’ = (b’ = a’, B)), не имеющих общих переменных в общей части B выполняются условия:
C1 содержит терм d.
У d и a’ есть наиболее общий унификатор:
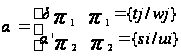 ,
где ui и wj – переменные соответственно из a’ и d,
то надо построить
предложения
 =C1p1,
а затем C#,
заменяя a’
на b’p2
для какого-то
одного вхождения
a’ в C1*.
Наконец вывести:
C3=(C#, Bp).
Формулировка весьма сложна, но ее реализация очень проста. В простейшем случае B пусто, так что предложения, содержащие высказывания с равенством, состоят из единственного атома выражающего равенство. Таким образом, из:
C1={Q(a)},
C2={a=b}
можно вывести:
C3={Q(b)}.
Несколько более сложный случай:
C1={Q(x)},
C2={(a=b)}.
Подстановка p = (a/x) дает:
C1*={Q(a)},
C3={Q(b)}.
При одном применении парамодуляции подстановка a=bp2 применяется в С1* только один раз. Таким образом, если заданы предложения:
C1={Q(x), P(x)},
C2={(a=b)},
то одно применение парамодуляции с подстановкой p = (a/x) дает сначала
C1*={Q(a), P(a)},
а затем или
C3={Q(a),P(b)},
либо
C3={Q(b), P(a)}.
Для получения C4={Q(b), P(b)} требуется повторное применение парамодуляции.
Рассмотрим пример по сюжету известной сказки Андерсона «Принцесса на горошине», который может служить тестом на наличие королевской крови.
Определения для примера:
x, y, z – переменные, принимающие значения на множестве людей.
M(x): x – мужчина.
C(x): x – простолюдин.
D(x): x может почувствовать горошину через перину.
x = k: x – король.
x = q: x – королева.
d(x,y): дочь x и y.
x = p: x – принцесса.
Исходные предложения:
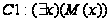 - существует
мужчина.
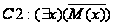 - существует
женщина.
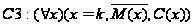 - любой мужчина
не простолюдин
король.