Протокол HTTP
Курсовая работа
На тему: Протокол HTTP
Содержание
Содержание
Введение
1. Исследовательский раздел
1.1 Постановка задачи
1.2 Передача данных
1.2.1 Протоколы передачи данных
1.2.2 Протокол TCP
1.2.3 Протокол HTTP
1.3 Системная информация ОС Linux
1.3.1 Расположение системной информации
1.3.2 Файловая система /proc
2. Технологический раздел
2.1 Выбор языка программирования
2.2 Программные средства
2.2.1 Потоки
2.2.2 Семафоры и мьютексы
2.2.3 Сокеты
2.2.4 Сигналы
2.3 Структура модулей программы
2.3.1 Система инициализации
2.3.2 Сервер и система управления динамическими библиотеками
2.3.3 Система журналирования
2.3.3 Система безопасности
2.4 Динамические библиотеки
2.4.1 PROCESSES – информация о процессах
2.4.2 MEMINFO – информация о системной памяти
2.4.3 DISKFREE – информация о свободном месте на дисках
2.4.4 NETWORK – информация о сетевых устройствах
2.4.5 VERSION – версия операционной системы
2.4.6 INDEX – страница помощи
2.5 Использование программы
2.5.1 Настройка сервера
2.5.2 Доступ к серверу
2.5.3 Завершение работы сервера
Заключение
Список использованной литературы
Введение
В настоящее время наблюдается тенденция к переносу большого количества приложений в среду Интернет – это позволяет более эффективно организовывать совместную работу с данными, коммуникацию удаленных пользователей и быстрое реагирование на возникающие события. Распределенные приложения, доступ к которым осуществляется посредством линий связи, оказались очень удобными – появилась возможность разделять места хранения данных и эффективно организовывать доступ к ним персонала из любой точки земного шара. Разумеется, активное использование распределенных веб-приложений накладывает крайне высокие требования на платформу, на которой происходит их выполнение – должна обеспечиваться надежная и бесперебойная работа серверов, высокая скорость доступа и возможность динамического обновления программного обеспечения на серверных компьютерах.
В последние несколько лет все большую популярность приобретают серверы, работающий под управлением операционных систем семейства UNIX: FreeBSD, OpenBSD, Solaris, Linux. Все эти системы спроектированы в соответствии со стандартом POSIX и имеют идентичный программный интерфейс, что позволило с легкостью переносить приложения, написанные в одной системе, на другую. Кроме того, все эти системы показали себя крайне надежными и отказоустойчивыми, по большей части из-за постоянного совершенствования, которое, зачастую, выполняется бесплатно энтузиастами со всего мира.
UNIX-системы не прижились в качестве пользовательских операционных систем в силу своей сложности и необходимости изучить большое число команд, однако в сфере серверов Интернета подобные системы постепенно вытесняют серверные версии Microsoft Windows.
С появлением большого числа серверов под управлением операционных систем семейства UNIX встал вопрос об администрировании этих серверов и, в частности, производить административные действия удаленно, посредством сетей передачи данных. Необходимость подобных действий вызвана тем, что физически сервер не всегда может быть доступен: администратор может обслуживать сразу несколько серверов, физически отстоящих друг от друга на значительное расстояние, что не позволяет получить непосредственный доступ к каждой машине; также администратор не может находиться на рабочем месте постоянно, тогда как неполадки могут возникнуть в любой момент. Кроме того, серверные компьютеры, к которым предъявляются повышенные требования надежности и безопасности, часто располагают в закрытых помещениях, доступ в которые разрешен только специальному обслуживающему персоналу. Все это привело к созданию ряда программных средств, служащих одной цели – возможности осуществлять удаленное администрирование компьютера.
Одним из первых появился программный продукт под названием telnet. Он состоял из клиентской и серверной частей и позволял клиентской части подключаться к серверной, находящейся на удаленном компьютере. После этого пользователь получал в свое распоряжение так называемый виртуальный терминал – он мог набирать стандартные команды UNIX, которые затем транслировались через сеть на удаленный компьютер telnet-серверу, выполнялись, а результаты выполнения передавались обратно на клиентскую машину. Таким образом, осуществлялась удаленная работа с компьютером, аналогичная по функциональности непосредственному доступу.
Основной проблемой данной программной системы являлась безопасность доступа. Авторизация пользователя осуществлялась стандартными средствами UNIX, что приводило к передачи по сетям в открытом виде информации об учетных записях системы. Эта информация, в свою очередь, могла быть перехвачена злоумышленниками и использована в целях вывода системы из строя или получения над ней полного контроля.
Следующим шагом стало создание так называемой защищенной оболочки (secure shell или, сокращенно, ssh). Этот программный комплекс по своей структуре был похож на telnet – также выделялись клиентская и серверная часть и пользователь получал в свое распоряжение виртуальный терминал при подключении. Однако в данном случае при авторизации пользователя использовались уже не стандартные ученые записи UNIX, а собственная база данных пользователей, информация о которых передавалась в зашифрованном виде. Шифровались также и команды, передаваемые на сервер, и ответная информация. Все это сделало удаленное администрирование достаточно безопасным и привело к росту популярности ssh.
Однако все еще оставалось некоторое неудобство при работе с указанными вые программами – они не позволяли оперативно получать информацию о системе в удобном для восприятия виде. Для получения данных о состоянии системы необходимо было знать определенные команды оболочки UNIX, а также расположение структур данных, содержащих нужную информацию. Длительность процедуры подключения и получения информации сделала неудобным постоянное наблюдение за состоянием системы и наложила высокие требования на квалификацию обслуживающего персонала.
Программа, разработанная в рамках курсового проекта, отчасти решает данную проблему. Она позволяет получать доступ к информации о состоянии Linux-системы (как самой распространенной среди UNIX-систем) через сеть Интернет, предоставляя данные в удобочитаемом виде, что позволяет пользоваться программой не только персоналу с высокой квалификацией и детальным знанием внутреннего устройства UNIX, но и обычным пользователям.
Функциональность программы может быть легко расширена – она использует динамически подключаемые модули, что позволяет добавлять необходимые возможности без перезапуска самой программы. Хотя изначально программа была предназначена для наблюдения за системой, добавлением необходимых модулей можно обеспечить и возможность воздействия на систему.
Программа обеспечивает высокую безопасность подключения: для получения доступа к информации о системе используется собственная база учетных записей, причем данные пользователя передаются в зашифрованном виде. Кроме того, с помощью программы невозможно повредить удаленной системе, так как, в отличие от виртуального терминала, она предоставляет доступ только к действиям, определенным администратором при настройке программы.
Подключение к программе, находящейся на удаленном компьютере, может быть произведено из любой операционной системы, в комплект которой входит Интернет-браузер, поддерживающий стандарты HTTP и HTML, в том числе из пользовательских систем, таких как Microsoft Windows и MacOS.
Таким образом, разработанная в рамках курсового проекта программа не претендует на роль полноценной замены традиционным виртуальным терминалам, однако предоставляет функции, которые могут быть полезными при удаленном администрировании: быстрое получение в удобочитаемом виде информации о состоянии системы, возможность подключения к удаленной машине из любой операционной системы с установленным Интернет-браузером, а также возможность настройки и усовершенствования программы в соответствии с потребностями администратора.
1. Исследовательский раздел
1.1 Постановка задачи
При разработке серверного программного обеспечения необходимо учитывать ряд требований, которые могут не учитываться в процессе разработки пользовательских приложений. Это и повышенные требования к устойчивости работы, и необходимость рассмотрения вопроса безопасности передачи данных, и наличие надежной системы ограничения доступа, и минимизация используемых программой ресурсов операционной системы.
В случае разработки серверной программы наблюдения за состоянием Linux-системы был выделен ряд требований, которые в процессе разработке в той или иной степени были удовлетворены:
Должна быть возможность подключения к программе посредством программного обеспечения, установленного на большинстве компьютеров и самых разнообразных операционных системах, например, Интернет-браузера; это приводит к тому, что программой должны в определенной степени поддерживаться распространенные протоколы передачи данных;
Программа должна поддерживать возможность одновременного подключения нескольких клиентов; при этом не должно быть взаимного влияния между частями программы, отвечающими за обработку запросов от различных клиентов: ошибка при работе с одним из клиентов не должна приводить к краху всей программы и не должна влиять на работу с другими клиентами;
Доступ подключаемых пользователей к информации о системе должен быть ограничен с помощью механизма учетных записей, причем данные о пользователях должны храниться в зашифрованном виде;
Модули, использующиеся для получения информации о системе, должны быть динамически подключаемыми с целью возможности добавлять новые модули, не прерывая работу программы и, тем более, без ее повторной компиляции;
Программа должна соответствовать стандарту POSIX и использовать только стандартные библиотеки, входящие в состав большинства UNIX-систем.
1.2 Передача данных
1.2.1 Протоколы передачи данных
Протоколом передачи данных называется ряд правил и утверждений, предназначенных для создания унифицированного интерфейса между взаимодействующим программным обеспечением. Это позволяет разрабатывать приложения, взаимодействие между которыми определяется не операционной системой, под управлением которой они работают, а протоколами, учтенными при разработке.
Все современные протоколы передачи данных классифицированы организацией ISO на уровни, в результате чего появилось понятие модели OSI (open systems interconnection – соединение открытых систем). Согласно этой модели, существует семь уровней рассмотрения передачи данных:
Физический (physical) – представлен линиями связи и коммуникационным оборудованием.
Связи (datalink) – представлен драйверами сетевого оборудования и программным обеспечением нижнего уровня.
Сетевой (network) – представлен протоколами IPv4 и IPv6.
Транспортный (transport) – представлен протоколами транспортного уровня, такими как TCP, UDP, ICMP и другими.
Сеансовый (session) – представлен программными средствами, поддерживающими сеансы связи.
Представления данных (presentation) – представлен программными средствами, обеспечивающими независимость интерпретации данных от используемой системы.
Прикладной (application) – представлен множеством протоколов, направленных на передачу определенных данных – файлов, гипертекстовых документов и т.д. К этим протоколам относятся HTTP, FTP, SMTP и др.
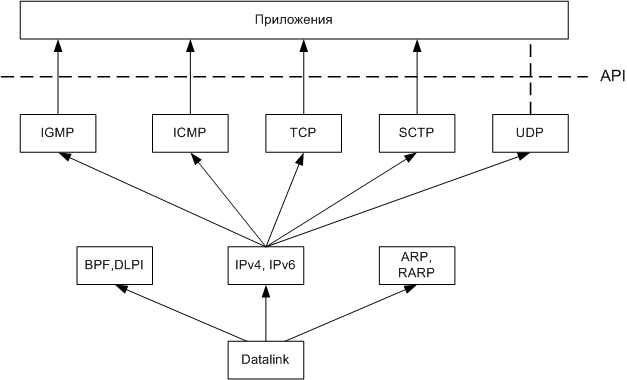
Приложения, как правило, не используют прямое обращение к программным средствам, реализующим протоколы нижних уровней – вплоть до сетевого. Для протоколов транспортного уровня в современных операционных системах предусмотрены специальный интерфейс – сокеты.
Наиболее распространенные протоколы и взаимосвязь между ними отображены на рисунке 2.1.
1.2.2 Протокол TCP
При разработке программы основным протоколом передачи информации был выбран протокол транспортного уровня – TCP (Transmission Control Protocol – протокол контроля передачи). Этот протокол является надстройкой над протоколом IP и предоставляет некоторую дополнительную функциональность:
Протокол обеспечивает надежную передачу данных, осуществляя, если необходимо повторную отправку или прием пакетов, делая это прозрачно для приложения, в отличие от протокола IP;
Последовательность получения пакетов строго контролируется: пакеты приходят в том же порядке, в каком и были отправлены; эта особенность отличает TCP от дейтаграммных протоколов, таких как UDP;
Протокол TCP имеет принятый в большинстве операционных систем программный интерфейс, называемый сокетами (sockets), что сильно упрощает его применение при разработке приложений.
Протокол TCP имеет долгую историю – он был разработан Министерством обороны США для создания ее внутренней оборонной сети ARPAnet и изначально предназначался для объединения приложений в составе разнородной вычислительной среды. Впервые протокол был реализован университетом Беркли в операционной системе BSD4.2. В силу популярности этой системы протокол быстро распространился на остальные UNIX-системы и фактически стал основой современной сети Интернет, а также большинства локальных сетей. Несмотря на свои преимущества по сравнению с протоколом IP, TCP имеет и свои негативные стороны – он крайне требователен к вычислительным ресурсам компьютера в силу того, что поток байтов, которым оперирует программа, при передачи посредством TCP разбивается на множество пакетов, каждый из которых может быть отправлен несколько раз, до тех пор, пока не будет получен ответ о его приеме. Кроме того, гибкая система адресации требует наличия в сети специализированных серверов, таких как DNS, DHCP и других.
1.2.3 Протокол HTTP
Протокол HTTP (HyperText Transfer Protocol – протокол передачи гипертекста) – это протокол уровня приложения, осуществляющий связь приложений в пределах распределенных, совместных или разнородных информационных систем. Протокол позволяет приложениям обмениваться данными, представленными в понятном для восприятия человеком виде.
Как следует из его названия, первоначально HTTP предназначался для передачи между приложениями так называемого гипертекста (hypertext), представляющего собой особый вид данных, созданный в соответствии со стандартом HTML (HyperText Markup Language – язык разметки гипертекста). Гипертекстовый документ состоит из данных, размеченных с помощью тегов (tag) языка HTML, и представляет собой комбинацию текста, изображений, гиперссылок и прочих средств представления данных. Гиперссылки – одна из важнейших составляющих HTML-документа – представляют собой интерактивные области, воздействие на которые приводит к получению связанных с гиперссылкой данных. Это позволяет пользователю, работающему с гипертекстовой информацией, осуществлять навигацию в пределах набора документов или даже всей сети Интернет, получая интересующую его информацию с помощью контекстных гиперссылок.
Протокол HTTP является надстройкой над протоколом TCP и является средством контроля содержания передаваемых данных. В отличие от TCP, который не учитывал структуру передаваемых пакетов, HTTP внедряет в данные метаинформацию, позволяющую получателю корректно интерпретировать полученные данные. На основе HTTP функционирует глобальная сеть Интернет (называемая также World Wide Web или WWW). Первая версия протокола – HTTP/0.9 – обладала достаточно ограниченными возможностями, но с активным развитием всемирной сети появились новые версии: HTTP/1.0 и HTTP/1.1, позволяющие контролировать передачу по вычислительным сетям не только гипертекстовой информации, но и произвольные бинарные файлы: звуковые, графические, архивные и пр.
В силу того, что HTTP является надстройкой над протоколом TCP, при передачи данных также выделяются две стороны: клиент и сервер.
Клиент является инициатором соединения и запрашивает у сервера некоторые данные или услуги. Клиентом, как правило, является программа, называемая браузером (browser), позволяющая как отображать гипертекстовую информацию, так и принимать файлы иных форматов. Чтобы получить некоторую интересующую информацию, клиент посылает серверу запрос (request), содержащий описание запрашиваемой информации.
Сервер при передаче данных через HTTP называют веб-сервером (web-server). Эта программа осуществляет обработку запросов от клиентов, передавая запрошенные данные в виде ответов (response), содержащих помимо искомых данных метаинформацию, их описывающую.
Получение пользователем интересующих его данных состоит из следующих этапов:
Пользователь вводит в строке браузера адрес интересующего его ресурса.
Браузер на основе информации, полученной от пользователя, а также учитывая свои настройки и конфигурацию операционной системы, формирует запрос.
Браузер подключается к серверу, расположенном, возможно, на удаленном компьютере, и передает ему запрос.
Сервер, анализируя запрос, выполняет необходимые действия: формирует ответ, включая в него тело запрошенного документа. Если это гипертекстовый документ, он загружается из файла или же генерируется динамически посредством сценария. В ответ также включается информация о содержащихся в нем данных.
Сервер передает ответ браузеру.
Браузер анализирует ответ и либо сохраняет полученные данные в файл, либо, в случае гипертекстового документа, анализирует теги HTML и отображает документ на экране.
Следует заметить, что клиентской программой может быть не только браузер, тем не менее, все шаги, за исключением, может быть, первого, выполняются в любом случае.
Следует заметить, что здесь рассматривается непосредственное подключение клиента к серверу, содержащему интересующую информацию, однако, это не всегда возможно в силу различных обстоятельств. В таком случае подключение может осуществляться посредством одной или более промежуточных точек подключения. Можно разделить эти промежуточные точки на три группы:
Прокси-серверы (proxy-server) – программа-посредник, выполняющая функции как клиента, так и сервера с целью создания запросов от имени других клиентов. Запросы обслуживаются прокси-сервером, или пересылаются им с внесением в них изменений (в этом случае прокси-сервер называется непрозрачным) или без изменений (в этом случае прокси-сервер называется прозрачным). Прокси-сервер позволяет группе компьютеров выступать в качестве одного клиента, что часто применяется при подключении к Интернету локальных сетей.
Шлюз (gateway) – как и прокси-сервер, осуществляет трансляцию запросов, однако, не подвергаю их изменению. Шлюз получает от клиента запрос, как к серверу, содержащему искомый ресурс. Таким образом, клиент не может определить, подключается ли он через шлюз или непосредственно к содержащему ресурс серверу.
Туннель (tunnel) – программа-посредник, поддерживающая соединение. Хотя после установки соединения туннель не рассматривается в качестве элемента передачи через протокол HTTP, соединение, как правило, инициируется именно HTTP-запросом. Туннель прерывает свою работу, если хотя бы один из участников обмена данными закрывает соединение.
Для сохранения функциональности передачи данных при подключении через промежуточные точки не требуется внесения изменений в запросы и ответы, за исключением случая прокси-сервера: в этом случае в клиентском запросе должны содержаться дополнительные поля. Однако, с точки зрения сервера, обмен данными производится непосредственно с клиентом, следовательно, никаких изменений в запросах не происходит. Поэтом при разработке программы возможность подключения через промежуточные точки не учитывалась.
Запрос, отправляемый клиентом серверу, служит для точной идентификации запрашиваемого ресурса, а также содержит сведения, необходимые для корректной обработки запроса.
По своей структуре запрос состоит из трех частей:
Строка запроса
Блок заголовков
Объект
Строка запроса состоит из трех полей, разделенных символами пробела (ASCII-код 20h, далее SP), и заканчивается комбинацией из двух символов: возврат каретки (ASCII-код 0Dh, далее CR) и перевод строки (ASCII-код 0Ah, далее LF). Элементы строки запроса представлены следующими полями:
Метод (method) – определяет метод обработки, применяемый к запрашиваемому ресурсу. В зависимости от указанного метода формат запроса может быть различным. Допустимые методы:
OPTIONS
GET
HEAD
POST
PUT
DELETE
TRACE
При разработке программы была введена поддержка только метода GET, в силу того, что именно этот метод браузер указывает в запросе, создаваемом по умолчанию.
URI (Universal Resource Identifier) ресурса (resource URI) – указывает местоположение запрашиваемого ресурса в стандартизованном формате, то есть является адресом ресурса. При использовании метода GET данная строка может включать в себя набор параметров, передаваемых серверу в виде строк формата «имя_параметра = значение_параметра», разделенных символами амперсанда ‘&’. Блок параметров находится в конце строки URI и отделяется от адреса символом вопросительного знака ‘?’.
Версия протокола HTTP – при разработке программы была реализована поддержка приема запросов, соответствующих версиям 1.0 и 1.1, которым соответствуют строки «HTTP/1.0» и «HTTP/1.1» соответственно.
Блок заголовков, следующий за строкой запроса, может состоять из одного или более заголовков:
Заголовок запроса – содержит поля, служащие модификаторами запроса и содержащие информацию о запросе и о конфигурации клиентской машины.
Заголовок объекта – в случае, если запрос включает в себя некоторый объект (произвольный набор данных), поля этого заголовка описывают объект, указывая его формат, кодировку и другие параметры.
Общий заголовок – содержит служебные параметры, необходимые для обеспечения корректности передачи и включения дополнительных услуг, таких, как кэширование.
Раздел заголовков оканчивается двумя парами символов CR и LF, что позволяет легко определить факт окончания приема запроса в силу того, что сам запрос подобную комбинацию символов содержать не может.
Ответ, отправляемый сервером клиенту, может быть создан только в результате обработки клиентского запроса. Он содержит описание результатов выполнения запроса и, если были запрошены данные, включает в себя запрошенный ресурс.
По своей структуре ответ состоит из следующих частей:
Строка состояния
Блок заголовков
Объект
Строка состояния состоит из трех полей, разделенных символами SP, и содержит в конце последовательность символов CR, LF. Элементы строки состояния:
Версия протокола HTTP – разработанная программа всегда использует строку «HTTP/1.1».
Код состояния (status code) – трехсимвольный цифровой код, который идентифицирует результат выполнения запроса. Хотя стандартом определен достаточно большой набор кодов состояния, в программе используются следующие коды:
200 – успешное выполнение;
400 – некорректный запрос;
401 – несанкционированный доступ;
404 – ресурс не найден;
405 – неприменимый метод;
505 – неподдерживаемая версия HTTP.
Фраза состояния (reason phrase) – короткая фраза, поясняющая код состояния выполнения запроса. Стандартом предложен стандартный набор фраз, однако в программе этот набор был несколько модифицирован.
Блок заголовков, следующий за строкой состояния, может состоять из одного или более заголовков:
Заголовок запроса
Заголовок объекта
Общий заголовок
Подробное рассмотрение заголовков было произведено в п. 2.2.3.3.
Раздел заголовков оканчивается двумя парами символов CR и LF, после чего следует произвольный набор символов – объект. При работе программы такими объектами могут являться только гипертекстовые документы в формате HTML, динамически генерируемые подключаемыми модулями.
1.3 Системная информация ОС Linux
1.3.1 Расположение системной информации
Всю системную информацию об операционной системе Linux можно разделить на две группы – по признаку расположения этой информации в системе:
Статическая информация – к этой группе можно отнести все текстовые конфигурационные файлы, оказывающие влияние на процесс загрузки системы, функционирование ее компонент. Подобная информация, как правило, расположена в каталоге /etc и его подкаталогах.
Динамическая информация – описывает текущее состояние системы. Подобная информация может быть получена чтением контекста памяти ядра операционной системы; доступ к этой информации осуществляется через файловую систему /proc (см. п. 2.3.2).
Методы получения информации можно также разделить на несколько групп по способу организации взаимодействия с системой:
Чтение файлов конфигурации и файлов, расположенных в /proc, с помощью системных вызовов.
Вызов системных утилит, предоставляющих соответствующую информацию.
Получение информации посредством выполнения специальных системных вызовов.
1.3.2 Файловая система /proc
Как было указано в п. 2.3.1, для получения динамической информации о системе необходимо получить доступ к контексту памяти ядра. В операционной системе Linux память ядра отображается на устройство /dev/kmem. Однако, чтение непосредственно из этого устройства может представлять достаточно большую сложность в силу того, что возникает необходимость знать расположение структур данных в памяти ядра. В ранних версиях UNIX-систем доступ к информации осуществлялся именно так.
Впоследствии был предложен механизм доступа к структурам памяти ядра, который существенно облегчал получение системной информации: большинство структур данных были отображены в файлы и каталоги, составляющие иерархию, фактически существующую в структурах данных ядра. Все эти файлы и каталоги были объединены в специальную файловую систему - /proc.
Адреса структур данных ядра заносятся в /proc на этапе компиляции системы. Соответственно, программы, обращающиеся к /proc, должны учитывать возможность ее модификации при установке более новой версии ядра с, возможно, измененной структурой /proc.
Обращение к файловой системе /proc происходит тем же путем, что и к обычной дисковой файловой системе – с помощью системных вызовов read() и write(). Следует, однако, заметить, что /proc не связана с каким-либо физическим устройством: содержимое файлов /proc генерируется непосредственно при чтении этих файлов, что приводит к невозможности определить их размер обычными средствами, а попытка узнать время создания и модификации любого файла приведет к получению текущего времени.
Некоторые файлы системы /proc могут быть использованы и для записи в них данных для изменения состояния системы, однако эта возможность не предусматривалась при разработке программы.
Файловая система /proc содержит по одному каталогу для каждого выполняющегося в данный момент процесса. Именем каталога является идентификатор процесса; в некоторых UNIX-системах идентификатор дополняется нулями для придания именам каталогов процессов одинаковой длины, однако, в ОС Linux подобные действия не производятся.
Каталоги процессов динамически создаются и уничтожаются по мере запуска и завершения соответствующих процессов. В каждом каталоге имеются файлы, предоставляющие доступ к различной информации о процессе.
Каждый каталог процесса содержит следующие файлы:
cmdline – содержит список аргументов, переданный процессу при запуске; первым аргументом является имя исполняемого файла; в случае, если процесс выгружен (например, находится в состоянии зомби), файл будет пуст;
cwd – является символической ссылкой на текущий рабочий каталог процесса;
environ – содержит переменные среды процесса;
exe – является символической ссылкой на исполняемый файл процесса; ее чтение является практически единственным способом определить каталог, содержащий исполняемый файл;
fd – подкаталог, содержащий символические ссылки на файлы, открытые процессом;
maps – содержит информацию о файлах, отображаемых в адресном пространстве процесса; к числу отображаемых файлов относится исполняемый файл процесса, а также загруженные библиотеки;
root – является символической ссылкой на корневой каталог процесса;
stat – содержит статистическую информацию о процессе;
status – содержит те же данные, что и stat, но в отформатированном виде.
Из соображений безопасности права доступа к некоторым файлам каталогов процесса предоставлены только владельцу процесса или суперпользователю.
В файловой системе /proc есть дополнительный элемент, позволяющий программам находить информацию о своем собственном процессе. Файл /proc/self является символической ссылкой на каталог, соответствующий текущему процессу. Разумеется, содержимое ссылки зависит от того, какой процесс к ней обращается.
Информация об аппаратуре, установленной на компьютере, может быть получена из следующих файлов файловой системы /proc:
/proc/cpuinfo – содержит информацию о центральном процессоре (или процессорах, если их больше одного); файл содержит информацию в отформатированном виде; помимо указания модели процессора, файл содержит указание доступных процессорных функций, таких как расширенные инструкции MMX;
/proc/devices – содержит список старших номеров всех символьных и блочных устройств, установленных в системе;
/proc/pci – содержит информацию обо всех устройствах, подключенных к шине PCI, включая устройства, встроенные в материнскую плату;
/proc/ide – каталог, содержащий файлы, которые описывают устройства, подключенные к шинам IDE и SCSI.
/proc/net/dev – содержит информацию о сетевых платах и их конфигурации.
Информация о конфигурации и состоянии ядра системы представлена в следующих файлах:
/proc/version – содержит строку, описывающую номер версии и модификации ядра; в нее также включена дополнительная информация: имя пользователя, осуществившего компиляцию, дата компиляции и версия компилятора;
/proc/meminfo – хранит сведения об использовании системной памяти; указываются данные как о физической памяти, так и об области подкачки;
/proc/modules – полный список установленных модулей ядра в текстовом виде.
Информация о файловых системах представлена следующими файлами:
/proc/filesystems – список файловых систем, поддерживаемых ядром;
/proc/mounts – содержит перечень смонтированных файловых систем; каждая строка файла содержит имя устройства, имя точки монтирования, тип файловой системы и флаги монтирования.
2. Технологический раздел
2.1 Выбор языка программирования
В настоящее время в UNIX-подобных операционных системах представлено большое количество самых разнообразных языков программирования, каждый из которых обладает своими преимуществами. При разработке программы был выбран язык C и соответствующий ему компилятор из пакета gcc (GNU compilers collection) по следующим причинам:
В силу того, что само ядро операционной системы написано на языке C, компилятор языка, входящий в состав пакета gcc, постоянно обновляется и исправляется, что практически исключает ошибки при компиляции с его стороны; в свою очередь, это приводит к генерации наиболее оптимизированного кода;
Язык C предполагает использование простых конструкций, что выгодно отличает его от остальных языков, особенно интерпретируемых и объектно-ориентированных, с точки зрения скорости выполнения программ;
Язык C предоставляет программисту наиболее полный доступ ко всем возможностям программного интерфейса POSIX, что позволяет наиболее эффективно организовывать взаимодействие программы с операционной системой.
2.2. Программные средства
2.2.1 Потоки
Разработанная программа имеет возможность параллельной обработки запросов от нескольких клиентов. Это достигнуто за счет использования более чем одного потока управления, осуществляющих обработку запросов.
Потоки в системе Linux реализуются посредством программного интерфейса, предоставляемого входящей в состав Linux библиотеки потоков libpthread.
Создание потока разбивается на несколько этапов:
Описание функции, которая будет выполняться в рамках потока. Эта функция не должна содержать статических переменных.
Создание экземпляра описателя атрибутов потока – структуры типа pthread_attr_t, – и заполнение ее полей в соответствии с необходимыми свойствами создаваемого потока.
Создание переменной типа pthread_t, которая будет служить идентификатором создаваемого потока.
Создание потока с помощью функции pthread_create(), в которую передается указатель на идентификатор потока, указатель на описатель атрибутов потока, а также адрес поточной функции и ее аргумент.
После создания поток выполняется параллельно с остальными потоками процесса и завершает свою работу при выполнении в поточной функции оператора return или принудительном завершении извне.
2.2.2 Семафоры и мьютексы
Для обеспечения безопасности доступа выполняющихся потоков к разделяемым переменным, коими являются, например, переменные состояния систем журналирования и безопасности, используется механизм взаимоблокировки потоков с помощью объекта ядра – мьютекса.
Мьютекс представляет собой переменную типа pthread_mutex_t, к которой применимы две операции:
pthread_mutex_lock – захват мьютекса; при применении этой операции к захваченному другим потоком мьютексу вызвавший поток блокируется до освобождения мьютекса.
pthread_mutex_unlock – освобождение мьютекса.
Для контроля числа одновременно обслуживаемых запросов в серверном модуле применяется объект ядра – семафор.
Семафор представляет собой переменную типа sem_t, к которой применимы две основных операции:
sem_wait – уменьшает на 1 текущее значение семафора; если текущее значение равно 0, поток блокируется;
sem_post – увеличивает на 1 значение семафора.
Начальное значение семафора задается при его инициализации с помощью функции sem_init().
2.2.3 Сокеты
Сокет представляет собой объект, предоставляющий программный интерфейс к протоколу TCP/IP и являющийся конечной точкой подключения. Использование сокета ничем не отличается от использования операций ввода-вывода применительно к файловому дескриптору – к сокету применяются те же функции read() и write(), что и при файловом вводе-выводе. Существуют, однако, специфические функции send() и recv(), расширяющие функциональность стандартных read() и write(), но их использование не является обязательным.
Перед началом процесса передачи данных через сокет необходимо совершить ряд действий:
Создать переменную типа int, которая будет выступать в качестве дескриптора сокета.
Создать описатель адреса сокета – структуру типа sockaddr_in, – и заполнить ее поля в соответствии с адресом и портом, через которые планируется устанавливать соединение.
Создать объект «сокет» с помощью функции socket(). Значение, возвращенное функцией, присваивается дескриптору сокета.
Привязать сокет к адресу и порту с помощью функции bind().
Начать прослушивание адреса и порта на предмет входящих соединений с помощью функции listen().
Принимать соединения с помощью функции accept().
Следует заметить, что процедура инициализации клиентского сокета выполняется несколько иначе и не рассматривалась в силу того, что разработанная программа не выступает в качестве клиента.
2.2.4 Сигналы
Контроль сигналов используется в программе для прекращения работы сервера. При поступлении определенного сигнала обнуляется переменная-условие, в результате чего цикл приема сообщений прерывается.
Установка некоторой функции в качестве обработчика сигнала производится следующим образом:
Определение функции – обработчика сигнала.
Создание и заполнение описателя параметров обработчика – структуры типа sigaction. Одно из полей описателя содержит адрес функции-обработчика.
Назначение обработчика сигнала с помощью функции sigaction().
2.3 Структура модулей программы
Для достижения наибольшей эффективности работы программы, возможности контроля исключительных ситуаций и легкости внесения модификаций, при разработке программы применялись элементы концепции структурного программирования, что привело к необходимости выделять ряд модулей, содержащих функции, сгруппированные по выполняемым ими задачам.
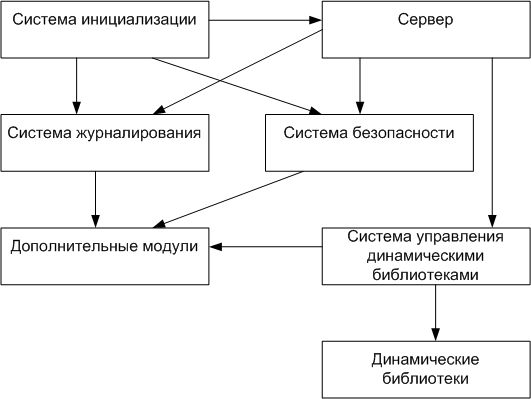
Все модули программы можно разделить на несколько групп:
Система инициализации – обеспечивает настройку всех систем и запуск сервера.
Сервер – обеспечивает настройку сетевых средств, принятие входящих подключений и передачу данных.
Система управления подключаемыми библиотеками – предоставляет серверному модулю интерфейс загрузки динамических библиотек и выполнения содержащихся в них функций.
Система журналирования – предоставляет всем модулям интерфейс для записи событий во внешний файл (журнал).
Система безопасности – обеспечивает управление учетными записями и проверку авторизации пользователя.
Динамические библиотеки – подключаются во время работы программы по запросам и реализуют получение системной информации.
Дополнительные модули – содержат вспомогательные функции.
Системы и их взаимодействие представлены на рисунке 3.1:
2.3.1 Система инициализации
Система инициализации предназначена для конфигурирования программы и запуска сервера. С нее начинается выполнение программы в силу того, что она включает в себя функцию main().
При разработке программы были определены следующие параметры:
LogMode – режим журналирования, может принимать значения short (краткий режим журналирования) и verbose (вывод расширенных сообщений).
LogDir – каталог, в который будет осуществляться запись журнальных файлов.
Address – адрес в формате xxx.xxx.xxx.xxx, который будет использован для привязки серверного сокета.
Port – номер порта, который будет использован для привязки серверного сокета.
MaxClients – максимальное число одновременно обслуживаемых клиентов.
AccountFile – путь к файлу, содержащему учетные записи пользователя.
ModulesDir – каталог, содержащий подключаемые модули (в виде динамических библиотек).
Система инициализации производит трехшаговую установку параметров:
Устанавливаются значения по умолчанию.
Загружаются значения из файла конфигурации.
Загружаются значения из аргументов командной строки.
Каждый последующий шаг имеет приоритет над предыдущим; это означает, что если для параметра существует строка в файле конфигурации, то