Диагностика локальных сетей
Ранние версии систем управления совмещали все функции в одном компьютере, за которым работал администратор. Для небольших сетей или сетей с небольшим количеством управляемого оборудования такая структура оказывается вполне удовлетворительной, но при большом количестве управляемого оборудования единственный компьютер, к которому стекается информация от всех устройств сети, становится узким местом. И сеть не справляется с большим потоком данных, и сам компьютер не успевает их обрабатывать. Кроме того, большой сетью управляет обычно не один администратор, поэтому, кроме нескольких серверов в большой сети должно быть несколько консолей, за которыми работают администраторы сети, причем на каждой консоли должна быть представлена специфическая информация, соответствующая текущим потребностям конкретного администратора.
Поддержка разнородного оборудования - скорее желаемое, чем реально существующее свойство сегодняшних систем управления. К числу наиболее популярных продуктов сетевого управления относятся четыре системы: Spectrum компании CabletronSystems, OpenView фирмы Hewlett-Packard, NetView корпорации IBM и Solstice производства SunSoft - подразделения SunMicrosystems. Три компании из четырех сами выпускают коммуникационное оборудование. Естественно, что система Spectrum лучше всего управляет оборудованием компании Cabletron, OpenView - оборудованием компании Hewlett-Packard, а NetView- оборудованием компании IBM.
При построении карты сети, которая состоит из оборудования других производителей, эти системы начинают ошибаться и принимать одни устройства за другие, а при управлении этими устройствами поддерживают только их основные функции, а многие полезные дополнительные функции, которые отличают данное устройство от остальных, система управления просто не понимает и, поэтому, не может ими воспользоваться.
Для исправления этого недостатка разработчики систем управления включают поддержку не только стандартных баз MIB I, MIB II и RMON MIB, но и многочисленных частных MIB фирм-производителей. Лидер в этой области - система Spectrum, поддерживающая около 1000 баз MIB различных производителей.
Другим способом более качественной поддержки конкретной аппаратуры является использование на основе какой-либо платформы управления приложения той фирмы, которая выпускает это оборудование. Ведущие компании - производители коммуникационного оборудования - разработали и поставляют весьма сложные и многофункциональные системы управления для своего оборудования. К наиболее известным системам этого класса относятся Optivity компании BayNetworks, CiscoWorks компании CiscoSystems, Transcend компании 3Com. Система Optivity, например, позволяет производить мониторинг и управлять сетями, состоящими из маршрутизаторов, коммутаторов и концентраторов компании BayNetwork, полностью используя все их возможности и свойства. Оборудование других производителей поддерживается на уровне базовых функций управления. Система Optivity работает на платформах OpenView компании Hewlett-Packard и SunNetManager (предшественник Solstice) компании SunSoft. Однако, работа на основе какой-либо платформы управления с несколькими системами, такими как Optivity, слишком сложна и требует, чтобы компьютеры, на которых все это будет работать, обладали очень мощными процессорами и большой оперативной памятью.
Тем не менее, если в сети преобладает оборудование от какого-либо одного производителя, то наличие приложений управления этого производителя для какой-либо популярной платформы управления позволяет администраторам сети успешно решать многие задачи. Поэтому разработчики платформ управления поставляют вместе с ними инструментальные средства, упрощающие разработку приложений, а наличие таких приложений и их количество считаются очень важным фактором при выборе платформы управления.
Открытость платформы управления зависит также от формы хранения собранных данных о состоянии сети. Большинство платформ-лидеров позволяют хранить данные в коммерческих базах данных, таких как Oracle, Ingres или Informix. Использование универсальных СУБД снижает скорость работы системы управления по сравнению с хранением данных в файлах операционной системы, но зато позволяет обрабатывать эти данные любыми приложениями, умеющими работать с этими СУБД.
В таблице представлены наиболее важные характеристики наиболее популярных платформ управления
Таблица 2.1 - Характеристики популярных платформ диагностики
| Характеристики | OpenView Network Node Manager 4.1 (Hewlett- Packard) | Spectrum Enterprise Manager (Cabletron Systems) | NetView forAIX SNMPManager (IBM) | Solstice Enterprise Manager (SunSoft) | ||
|
Автообнаружение |
||||||
| Ограничение по числу промежуточных маршрутизаторов | - | - | + | + | ||
| Определение имени хоста по его адресу через сервер DNS | + | + | + | + | ||
| Возможность модификации присвоенного имени хоста | + | - | + | + | ||
| Распознавание сетевых топологий | Любые сети, работающие по TCP/IP | Ethernet, TokenRing, FDDI, ATM, распределенные сети, сети с коммутацией | распознавание по интерфейсам устройств | Ethernet, Token-Ring, FDDI, распределен- ные сети | ||
| Максимальное рекомендуемое число обслуживаемых узлов | 200 - 2000, наибольшее известное - 35000 | Программных ограничений не существует | Программных ограничений не существует | 10000 - 50000 | ||
| Поддержка баз данных | Ingres, Oracle | файлы | Собств., Oracle, Sybase, ... | Informix, Oracle, Sybase | ||
|
Распределенное управление |
||||||
| Один сервер / | много | клиентов | ||||
| Число клиентов | до 15 | Нет программного ограничения | Протестиро- вано более 30 | Нет программного ограничения | ||
| Клиент использует X-Window | + | - | - | + | ||
| Система с GUI запускается на клиенте | + | + | + | + | ||
| Собственная карта сети у клиента | + | + | + | - | ||
| Задание доступных для просмотра объектов сети | С помощью дополнительного продукта Operations Center (HP) | + | + | - | ||
| Много серверов / | много | клиентов | ||||
| текущее состояние | +/- | +/+ | +/- | +/+ | ||
| планируется | +/+ | +/+ | +/+ | +/+ | ||
| Число приложений третьих фирм | 220 | 180 | > 200 | 400 | ||
| Число поддерживаемых MIB третьих фирм | 218 | > 1000 | 193 | Нет данных | ||
|
Поддержка протокола SNMP: |
||||||
| через IP | + | + | + | + | ||
| через IPX | + | - | - | - | ||
| Поддержка MIB, утвержденных IETF | Большинство, но нет RMON | Все | 20 | MIB-II | ||
| Поддержка протокола CMIP | Дополнительно оплачиваемый продукт - Open View HP Distributed Management Platform | Дополнительно оплачиваемый продукт | + | + | ||
| Взаимодействие с мейнфреймами | При помощи приложений третьих фирм | По SNA через Blue Vision | Может обращаться к NetView на мейнфрейме | + | ||
| Поддержка ОС | HPUX, SunOS, Solaris | IBM AIX, Sun OS, HP UX, SGI IRIX, Windows NT | AIX, OSF/1, Windows NT | SolarisSPARC | ||
3 Организация диагностики компьютерной сети
Основных причин неудовлетворительной работы сети может быть несколько: повреждения кабельной системы, дефекты активного оборудования, перегруженность сетевых ресурсов (канала связи и сервера), ошибки самого прикладного ПО. Часто одни дефекты сети маскируют другие. И чтобы достоверно определить, в чем причина неудовлетворительной работы, локальную сеть требуется подвергнуть комплексной диагностике. Комплексная диагностика предполагает выполнение следующих работ (этапов).
- Выявление дефектов физического уровня сети: кабельной системы, системы электропитания активного оборудования; наличия шума от внешних источников.
- Измерение текущей загруженности канала связи сети и определение влияния величины загрузки канала связи на время реакции прикладного ПО.
- Измерение числа коллизий в сети и выяснение причин их возникновения.
- Измерение числа ошибок передачи данных на уровне канала связи и выяснение причин их возникновения.
- Выявление дефектов архитектуры сети.
- Измерение текущей загруженности сервера и определение влияния степени его загрузки на время реакции прикладного ПО.
- Выявление дефектов прикладного ПО, следствием которых является неэффективное использование пропускной способности сервера и сети.
Мы остановимся подробнее на первых четырех этапах комплексной диагностики локальной сети, а именно на диагностике канального уровня сети, так как наиболее легко задача диагностики решается для кабельной системы. Как уже было рассмотрено во втором разделе, кабельная система сети полноценно может быть протестирована только специальными приборами - кабельным сканером или тестером. AUTOTEST на кабельном сканере позволит выполнить полный комплекс тестов на соответствие кабельной системы сети выбранному стандарту. При тестировании кабельной системы хотелось бы обратить внимание на два момента, тем более что о них часто забывают.
Режим AUTOTEST не позволяет проверить уровень шума создаваемого внешним источником в кабеле. Это может быть шум от люминесцентной лампы, силовой электропроводки, сотового телефона, мощного копировального аппарата и др. Для определения уровня шума кабельные сканеры имеют, как правило, специальную функцию. Поскольку кабельная система сети полностью проверяется только на этапе ее инсталляции, а шум в кабеле может возникать непредсказуемо, нет полной гарантии того, что шум проявится именно в период полномасштабной проверки сети на этапе ее инсталляции.
При проверке сети кабельным сканером вместо активного оборудования к кабелю подключаются с одного конца - сканер, с другого - инжектор. После проверки кабеля сканер и инжектор отключаются, и подключается активное оборудование: сетевые платы, концентраторы, коммутаторы. При этом нет полной гарантии того, что контакт между активным оборудованием и кабелем будет столь же хорош, как между оборудованием сканера и кабелем. Неоднократно встречаются случаи, когда незначительный дефект вилки RJ-45 не проявляется при тестировании кабельной системы сканером, но обнаруживался при диагностике сети анализатором протоколов.
Диагностика сетевых устройств (или компонента сети) также имеет свои тонкости. При ее проведении применяют различные подходы. Выбор конкретного подхода зависит от того, что выбирается в качестве критерия хорошей работы устройства. Как правило, можно выделить три типа критериев и, следовательно, три основных подхода.
Первый основан на контроле текущих значений параметров, характеризующих работу диагностируемого устройства. Критериями хорошей работы устройства в этом случае являются рекомендации его производителя, или так называемые промышленные стандарты де-факто. Основными достоинствами указанного подхода являются простота и удобство при решении наиболее распространенных, но, как правило, относительно несложных проблем. Однако бывают случаи, когда даже явный дефект большую часть времени не проявляется, а дает о себе знать лишь при некоторых, относительно редких режимах работы и в непредсказуемые моменты времени. Обнаружить такие дефекты, контролируя только текущие значения параметров, весьма затруднительно.
Второй подход основан на исследовании базовых линий параметров (так называемых трендов), характеризующих работу диагностируемого устройства. Основной принцип второго подхода можно сформулировать следующим образом: “устройство работает хорошо, если оно работает так, как всегда”. На этом принципе основана упреждающая (proactive) диагностика сети, цель которой — предотвратить наступление ее критических состояний. Противоположной упреждающей является реактивная (reactive) диагностика, цель которой не предотвратить, а локализовать и ликвидировать дефект. В отличие от первого, данный подход позволяет обнаруживать дефекты, проявляющиеся не постоянно, а время от времени. Недостатком второго подхода является предположение, что изначально сеть работала хорошо. Но “как всегда” и “хорошо” не всегда означают одно и то же.
Третий подход осуществляется посредством контроля интегральных показателей качества функционирования диагностируемого устройства (далее — интегральный подход). Следует подчеркнуть, что с точки зрения методологии диагностики сети между первыми двумя подходами, которые будем называть традиционными, и третьим, интегральным, есть принципиальное различие. При традиционных подходах мы наблюдаем за отдельными характеристиками работы сети и, чтобы увидеть ее “целиком”, должны синтезировать результаты отдельных наблюдений. Однако мы не можем быть уверены, что при этом синтезе не потеряем важную информацию. Интегральный подход, наоборот, дает нам общую картину, которая в ряде случаев бывает недостаточно детальной. Задача интерпретации результатов при интегральном подходе, по существу, обратная: наблюдая целое, выявить, где, в каких частностях заключается проблема.
Из сказанного следует, что наиболее эффективен подход, совмещающий функциональность всех трех описанных выше подходов. Он должен, с одной стороны, основываться на интегральных показателях качества работы сети, но, с другой — дополняться и конкретизироваться данными, которые получаются при традиционных подходах. Именно такая комбинация позволяет поставить точный диагноз проблемы в сети.
3.1 Документирование сети
Ведение документирования сети дает сетевому администратору целый ряд преимуществ. Документирование сети может выступить:
- Инструментом для устранения неисправностей – в том случае, если что-нибудь идет не так как надо, документация может служить руководством при поиске и устранении неисправности. Она сохранит время и деньги.
- Помощью в подготовке нового персонала – новый сотрудник будет скорее готов к работе, если доступна документация по тому участку работы, где ему предстоит работать, что снова сбережет время и деньги.
- Помощью для поставщиков и консультантов - услуги этих людей, как правило, весьма дороги, если им нужно знать какие-либо детали сетевой инфраструктуры, то наличие документации позволит им выполнить свою работу быстрее, что, опять же, приводит к экономии времени.
Каждая сеть имеет свои уникальные особенности, но обладает и многими общими элементами, которые должны быть включены в документацию:
Топология сети - обычно эта информация представляется в форме диаграмм, на которых показаны основные сетевые узлы, такие как маршрутизаторы, коммутаторы, файерволы, сервера и как они взаимосвязаны. Принтеры и рабочие станции обычно сюда не включаются.
Информация о серверах - то есть, та информация, которая необходима вам для управления и администрирования серверами, такая как имя, функции, IP адреса, конфигурация дисков, ОС и сервис-паки, дата и место покупки, гарантия и т.д...
Назначение портов коммутаторов и маршрутизаторов - сюда включается детальная информация о конфигурации WAN, VLAN-ов или даже назначение портов сетевым узлам через патч-панель.
Конфигурация сетевых служб — сетевые службы, такие как DNS, WINS, DHCP, и RAS, критичны для операций в сети, следует детально описать, как они структурированы. Данную информацию всегда можно получить с серверов, но документация ее заранее в легкочитаемом формате позволяет сэкономить время.
Политики и профили доменов – можно ограничить возможности пользователей с помощью Policy Editor в Windows NT или с помощью Group Policies в Windows 2000. При этом существует возможность создать профили пользователей, хранимые на сервере, а не на локальной машине. Если такие возможности используются, то такая информация должна быть документирована.
Критически важные приложения - необходимо включить в документацию как такие приложения поддерживаются, что бывает с ними чаще всего не так и как решать такие проблемы.
Процедуры — это само по себе может быть большим проектом. В основном процедуры — средство для реализации политик и могут быть достаточно обширными. В частности, политика может устанавливать, что «Сеть должна быть защищена от неавторизованных пользователей». Однако, для реализации такой политики, потребуется масса усилий. Существуют процедуры для файерволов, сетевых протоколов, паролей, физической безопасности и т.д. Можно также иметь отдельные процедуры для обработки проблем, о которых сообщают пользователи, и процедуры для регулярного обслуживания серверов.
Как показывает практика, большинство средний предприятий, особенно государственных учреждений используют ручной способ ведения документирования сети т.е для них вполне достаточно списков Excel и знаний ответственного за IT специалиста. Однако использование специальных систем документирования сети, позволит значительно снизить риски в случае отказа компонентов или физического повреждения инфраструктуры в результате строительных работ, пожара или наводнения, внезапного увольнения или исчезновения ответственного специалиста и уменьшить время при восстановлении инфраструктуры.
Система документирования инфраструктуры сети (CMS) - это интегрированная система, позволяющая хранить в едином месте и иметь удобный доступ к информации обо всех объектах сети (будь то отдельные компьютеры, соединительные кабели, системы теленаблюдения, пожарной сигнализации и т. п.) и соединениях между ними.
Основной задачей современных систем документирования сети на базе программного обеспечения является достижение гибкости и точности документации, а также управление сетями при низких затратах и минимальных трудностях. Система документирования сети хранит данные о всех пассивных (кабели, разъемы, панели переключений, распределительные шкафы) и активных (маршрутизаторы, коммутаторы, серверы, , ПК, УАТС) компонентах сети, включая информацию о соединениях и их состоянии (Connectivity) в центральной реляционной базе данных (к примеру, Oracle, SQL, DB2), и визуализирует всю систему как в алфавитно-цифровой, так и в графической форме. Кроме того, основываясь на планах зданий и земельных участков, можно отобразить расположение отдельных компонентов и маршруты прокладки кабеля Информация о компонентах и их изображения хранятся в библиотеке компонентов, которая постоянно обновляется. Многие современные системы уже предлагают клиенты Web, позволяющие получать доступ к документации по сети через Internet. Так, обслуживающие техники могут на месте напрямую запрашивать рабочие задания посредством мобильных устройств, а после выполнения квитировать их в производственной системе. Некоторые системы документирования сети даже обладают функцией обнаружения (Discovery) для автоматического выявления посредством SNMP новых активных компонентов и включения их в документацию.
При наличии системы документирования сети пользователь в любое время может получить актуальный и целостный обзор всех сетевых ресурсов инфраструктуры организации. Согласно подсчетам Международной организации управления службами IT (IT Service Management Forum, ITSMF), на протяжении всего жизненного цикла системы IT затраты на ее содержание сокращаются в результате на 80%. Система документирования сети позволяет осуществлять большее (чем при обработке вручную) количество действий, необходимых для функционирования инфраструктуры сети, и при этом значительно экономит время на их выполнение. Вдобавок предотвращаются ошибки при вводе данных или их дублирование. В систему можно вводить автоматизированные процессы для изменения инфраструктуры (Change Requests) и, наконец, автоматически создавать рабочие задания, к примеру, при ремонтных работах или переездах. Деятельность обслуживающего персонала на местах становится намного эффективнее, за счет чего существенно упрощаются процессы обслуживания и изменения компьютерной сети. Расчеты показали, что сокращение усилий, а соответственно, и финансовых затрат на планирование и документирование необходимых изменений в сети может достигать 90%.
Согласно статистике по Network Operating Centers (NOC), около 80% всех неполадок в сети вызваны неисправностью проводки. При использовании системы документирования сети предприятия могут быстро локализовать проблемную зону и, таким образом, оперативно устранить неполадки. Более того, посредством системы документирования сети можно планировать и организовывать избыточные маршруты передачи сигнала, с тем чтобы в случае неполадок просто подключить их.
В настоящее время системы документирования сети используют преимущественно крупные компании, а также поставщики энергии и муниципальные предприятия, обладающие протяженной и сложной инфраструктурой ИТК. Ведение документации вручную превратилось бы для них в непосильную ношу. Системы документирования применяют и телекоммуникационные предприятия, которые обязаны обеспечивать доступность инфраструктуры для своих клиентов и подтверждать это фактически. Все чаще делают ставку на системы документирования сети больницы и другие учреждения, в которых доступность и надежность структуры сети являются жизненной необходимостью. Для повседневной деятельности эксплуатационных организаций и владельцев зданий, предоставляющих сеть для нескольких предприятий на одной территории, системы документирования сети тоже имеют огромное значение.
В качестве примера рассмотри некоторые из подобных систем.
Friendly Pinger - это мощное и удобное приложение для администрирования, мониторинга и инвентаризации компьютерных сетей. Представляет следующие возможности:
Визуализация компьютерной сети в красивой анимационной форме с отображением, какие компьютеры включены, а какие нет;
Оповещение об остановке/запуске серверов;
Просмотр, кто, к каким файлам обращается на компьютере по сети;
Автоматический сбор информации о программном и аппаратном обеспечении компьютеров в сети.
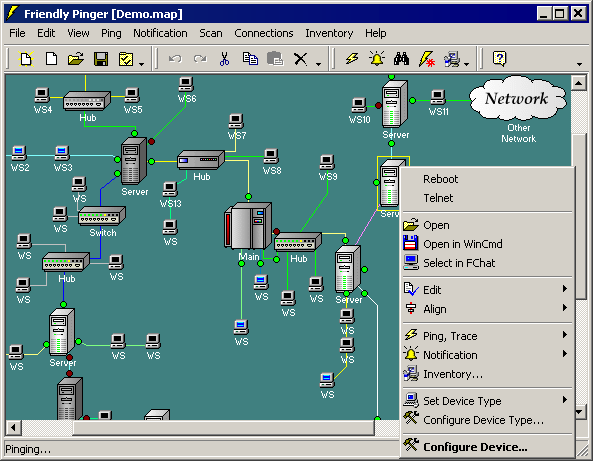
Рисунок 3.1- Карта сети
10-Strike LANState - программа для администраторов и простых пользователей сетей Microsoft Windows. С помощью LANState можно наблюдать текущее состояние сети в графическом виде, управлять серверами и рабочими станциями, вести мониторинг удаленных устройств с помощью периодического опроса компьютеров, отслеживать подключения к сетевым ресурсам, получать своевременные оповещения о различных событиях.
LANState содержит множество полезных функций для администраторов и пользователей сети, например, отправка сообщений, перезагрузка и завершение работы удаленных компьютеров, пинг, определение имени по ip адресу, трассировка маршрута, сканирование портов и хостов. Также имеется возможность получения различной информации об удаленных компьютерах (без инсталляции серверной части на них). Например, просмотр реестра по сети, просмотр удаленного event log'а, просмотр списка установленных программ. Поддерживаются Windows 95/98/Me/NT/2000/XP.
Для пользователей сети: программа позволяет наглядно видеть какие компьютеры в сети включены, а какие - нет. В любой момент программу можно вызвать из трея Windows и быстро обратиться к ресурсам нужного компьютера (замена окна сетевого окружения). Можно настроить сигнализацию на включение/выключение определенных компьютеров и серверов в сети, на доступность файлов и папок, на запуск web- и FTP-серверов, и на другие события. LANState осуществляет контроль подключений к общим ресурсам и отслеживает обращения к файлам из сети. Есть возможность выяснить, кто и к каким файлам на компьютере обращается по сети, в том числе и через административные ресурсы.
Для администраторов: управление компьютерами в сети, получение разнообразной информации об удаленных компьютерах (списки пользователей, запущенные службы и приложения, установленные программы, доступ к реестру и журналу событий), удаленное администрирование, перезагрузка, включение/выключение, и т.п. Сигнализация позволяет своевременно узнать о включении/выключении компьютеров и серверов в сети, разрыве VPN-подключений, изменении размеров или доступности файлов и папок.
Рассмотрим процесс создания схемы локальной сети с помощью этой программы. LANState поддерживает сканирование SNMP-устройств и может рисовать схему сети автоматически с созданием линий, соединяющих хосты. При этом номера портов коммутаторов проставляются в подписях к линиям. Для автоматического построения схемы сети:
1. SNMP должен быть включен на коммутаторах. Программа должна быть разрешена в брандмауэре для успешной работы по протоколу SNMP.
2. Запустить Мастер Создания Карты Сети.
3. Выбрать сканирование сети по диапазону IP-адресов. Указать диапазоны. Устройства с SNMP должны находиться внутри указанных диапазонов.
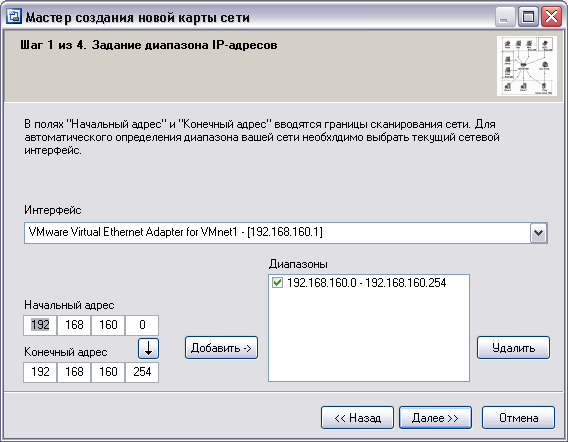
Рисунок 3.2 - Задание диапазона адресов
4. Выбрать методы сканирования и настроить их параметры. Поставить галочку рядом с опцией "Поиск устройств с SNMP..." и указать правильные community strings для подключения к коммутаторам.
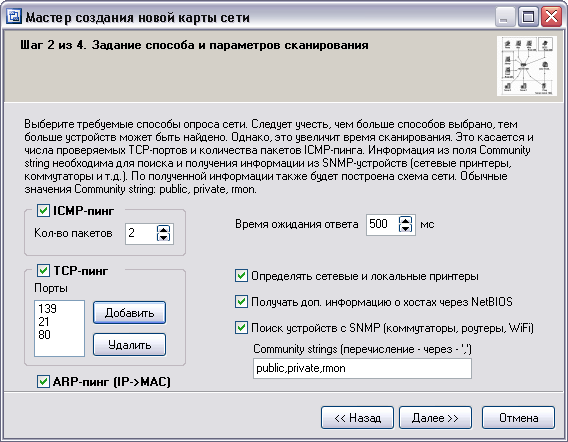
Рисунок 3.3 - Параметры и способы сканирования
5. После сканирования программа должна нарисовать схему сети. Если сканирование SNMP прошло успешно, соединения между сетевыми устройствами будут нарисованы автоматически.
Схема сети может быть выгружена в картинку, либо в схему Microsoft Visio
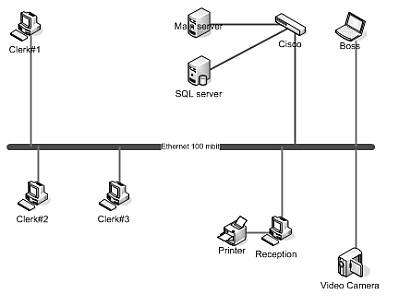
Рисунок 3.4 - Укрупненная схема сети
3.2 Методика упреждающей диагностики
Методика упреждающей диагностики заключается в следующем. Администратор сети должен непрерывно или в течение длительного времени наблюдать за работой сети. Такие наблюдения желательно проводить с момента ее установки. На основании этих наблюдений администратор должен определить, во-первых, как значения наблюдаемых параметров влияют на работу пользователей сети и, во-вторых, как они изменяются в течение длительного промежутка времени: рабочего дня, недели, месяца, квартала, года и т. д.
Наблюдаемыми параметрами обычно являются:
- параметры работы канала связи сети - утилизация канала связи, число принятых и переданных каждой станцией сети кадров, число ошибок в сети, число широковещательных и многоадресных кадров и т. п.;
- параметры работы сервера - утилизация процессора сервера, число отложенных (ждущих) запросов к диску, общее число кэш-буферов, число "грязных" кэш-буферов и т. п.
Зная зависимость между временем реакции прикладного ПО и значениями наблюдаемых параметров, администратор сети должен определить максимальные значения параметров, допустимые для данной сети. Эти значения вводятся в виде порогов (thresholds) в диагностическое средство. Если в процессе эксплуатации сети значения наблюдаемых параметров превысят пороговые, то диагностическое средство проинформирует об этом событии администратора сети. Такая ситуация свидетельствует о наличии в сети проблемы.
Наблюдая достаточно долго за работой канала связи и сервера, можно установить тенденцию изменения значений различных параметров работы сети (утилизации ресурсов, числа ошибок и т. п.). На основании таких наблюдений администратор может сделать выводы о необходимости замены активного оборудования или изменения архитектуры сети.
В случае появления в сети проблемы, администратор в момент ее проявления должен записать в специальный буфер или файл дамп канальной трассы и на основании анализа ее содержимого сделать выводы о возможных причинах проблемы.
3.2 Организация процесса диагностики
Не подвергая сомнению, важность упреждающей диагностики, приходиться констатировать, что на практике она используется редко. Чаще всего (хоть это и неправильно) сеть анализируется только в периоды ее неудовлетворительной работы. И обычно в таких случаях локализовать и исправить имеющиеся дефекты сети требуется быстро. Предлагаемую нами методику можно даже рассмотреть, как частный случай методики упреждающей диагностики сети.
Любая методика тестирования сети существенно зависит от имеющихся в распоряжении системного администратора средств. По мнению некоторых администраторов, в большинстве случаев необходимым и достаточным cредством для обнаружения дефектов сети (кроме кабельного сканера) является анализатор сетевых протоколов. Он должен подключаться к тому домену сети (collision domain), где наблюдаются сбои, в максимальной близости к наиболее подозрительным станциям или серверу
Если сеть имеет архитектуру с компактной магистралью (collapsed backbone) и в качестве магистрали используется коммутатор, то анализатор необходимо подключать к тем портам коммутатора, через которые проходит анализируемый трафик. Некоторые программы имеют специальные агенты или зонды (probes), устанавливаемые на компьютерах, подключенных к удаленным портам коммутатора. Обычно агенты (не путать с агентами SNMP) представляют собой сервис или задачу, работающую в фоновом режиме на компьютере пользователя. Как правило, агенты потребляют мало вычислительных ресурсов и не мешают работе пользователей, на компьютерах которых они установлены. Анализаторы и агенты могут быть подключены к коммутатору двумя способами.
При первом способе (см. рисунок 3.5) анализатор подключается к специальному порту (порту мониторинга или зеркальному порту) коммутатора, если таковой имеется, и на него по очереди направляется трафик со всех интересующих портов коммутатора.
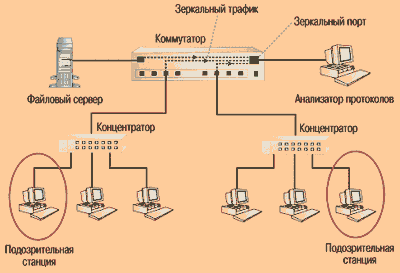
Рисунок 3.5 – Первый способ подключения анализатора
Если в коммутаторе специальный порт отсутствует, то анализатор (или агент) следует подключать к портам интересующих доменов сети в максимальной близости к наиболее подозрительным станциям или серверу (см. рисунок 3.6 ). Иногда это может потребовать использования дополнительного концентратора. Данный способ предпочтительнее первого. Исключение составляет случай, когда один из портов коммутатора работает в полнодуплексном режиме. Если это так, то порт предварительно необходимо перевести в полудуплексный режим.
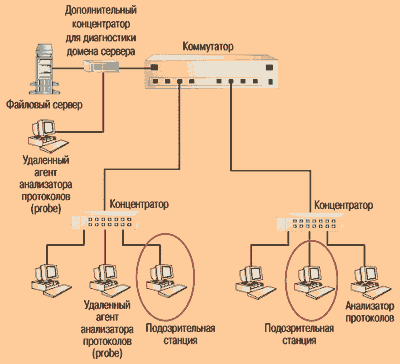
Рисунок 3.6 - Второй способ подключения анализатора
На рынке имеется множество разнообразных анализаторов протоколов - от чисто программных до программно-аппаратных. Несмотря на функциональную идентичность большинства анализаторов протоколов, каждый из них обладает теми или иными достоинствами и недостатками. В этой связи надо обратить внимание на две важные функции, без которых эффективную диагностику сети провести будет затруднительно.
Во-первых, анализатор протоколов должен иметь встроенную функцию генерации трафика Во-вторых, анализатор протоколов должен уметь "прореживать" принимаемые кадры, т. е. принимать не все кадры подряд, а, например, каждый пятый или каждый десятый с обязательной последующей аппроксимацией полученных результатов. Если эта функция отсутствует, то при сильной загруженности сети, какой бы производительностью ни обладал компьютер, на котором установлен анализатор, последний будет "зависать" и/или терять кадры. Это особенно важно при диагностике быстрых сетей типа Fast Ethernet и FDDI.
Предлагаемую методику мы будем иллюстрировать на примере использования чисто программного анализатора протоколов Observer компании Network Instruments - это мощный анализатор сетевых протоколов и средство для мониторинга и диагностики сетей Ethernet, беспроводных сетей стандарта 802.11 a/b/g, сетей Token Ring и FDDI. Observer позволяет в режиме реального времени измерять характеристики работы сети, осуществлять декодирование сетевых протоколов (поддерживается более 500 протоколов), создавать и анализировать тренды характеристик работы сети.
Рассмотрим поэтапно действия системного администратора для проведения диагностики сети в случае, когда прикладное программное обеспечение в сети Ethernet стало работать медленно, и необходимо оперативно локализовать и ликвидировать дефект.
Первый этап: Измерение утилизации сети и установление корреляции между замедлением работы сети и перегрузкой канала связи.
Утилизация канала связи сети - это процент времени, в течение которого канал связи передает сигналы, или иначе - доля пропускной способности канала связи, занимаемой кадрами, коллизиями и помехами.
Параметр "Утилизация канала связи" характеризует величину загруженности сети. Канал связи сети является общим сетевым ресурсом, поэтому его загруженность влияет на время реакции прикладного программного обеспечения. Первоочередная задача состоит в определении наличия взаимозависимости между плохой работой прикладного программного обеспечения и утилизацией канала связи сети. Предположим, что анализатор протоколов установлен в том домене сети (collision domain), где прикладное ПО работает медленно. Средняя утилизация канала связи составляет 19%, пиковая доходит до 82%. Но сделать на основании этих данных достоверный вывод о том, что причиной медленной работы программ в сети является перегруженность канала связи нельзя.
Часто можно слышать о стандарте де-факто, в соответствии с которым для удовлетворительной работы сети Ethernet утилизация канала связи "в тренде" (усредненное значение