Интерпретация блок-схем
 i класс
символа k
г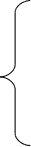 де
1, если si буква
2, если si цифра
3, если si `
k= 4, если si “ или ”
5, если si верный знак
0, если si ошибочный символ
Тогда диаграмма состояний имеет вид: (смотри в приложении).



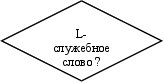
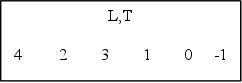
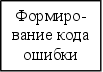



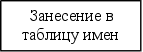
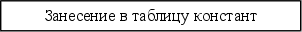

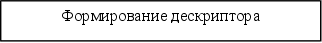
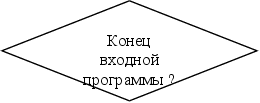

Рис.3. Блок схема лексического анализа.
ЗАМЕЧАНИЕ:
В каждом состоянии сканер может выполнять дополнительные действия по контролю правильности лексемы и преобразования во внутреннюю форму.
Сканер выделяет самую длинную лексему пока возможно, а при выходе указатель стоит на начале следующей лексемы.
Изобразим блок - схему работы лексического анализатора (рис.3.).
Так как сканер строится по диаграмме состояний, то для простоты программирования был построен конечный автомат. Матрица переходов состояний сканера приведена в приложении.
4.3.3. Синтаксический и семантический анализ
Анализаторы выполняют действительно сложную работу по расчленению исходной программы на составные части, формированию ее внутреннего представления и занесению информации в таблицу символов и другие таблицы. При этом также выполняется полный синтаксический и частичный семантический контроль программы.
Обычный анализатор представляет собой синтаксически управляемую программу. В действительности стремятся отделить синтаксис от семантики настолько, насколько это возможно. Когда синтаксический анализатор (распознаватель) узнает конструкцию исходного языка, он вызывает соответствующую семантическую процедуру, или семантическую программу, которая контролирует данную конструкцию с точки зрения семантики и затем запоминает информацию о ней в таблице символов или во внутреннем представлении программы. Например, когда распознается описание переменных, семантическая программа проверяет идентификаторы, указанные в этом описании, чтобы убедиться в том, что они не были описаны дважды, и заносит их вместе с атрибутами в таблицу символов.
Когда встречается инструкция присваивания вида:
<переменная> = <выражение>
семантическая программа проверяет переменную и выражение на соответствие типов и затем заносит инструкцию присваивания в программу во внутреннее представление.
Синтаксический анализ можно представить диаграммой состояний, так же как и сканер. Поэтому их частично объединяют и если возможно то совмещают полностью. В данной работе процесс лексического, синтаксического и семантического анализа для всех блоков разделен. Матрицы состояний конечных автоматов синтаксического анализа блоков приведены в приложении. Семантический анализ выполняется в процессе интерпретации.
4.3.4. Польская инверсная запись (ПолИЗ)
Первые процедурно-ориентированные языки программирования высокого уровня предназначались для решения инженерных и научно – технических задач, в которых широко применяются методы вычислительной математики. Значительную часть программ решения таких задач составляют арифметические и логические выражения. Поэтому трансляцией выражений занимались очень многие исследователи и разработчики трансляторов. На данное время разработано большое число таких трансляторов. Сейчас классическим стал метод трансляции выражений, основанный на использовании промежуточной обратной польской записи, названной так в честь польского математика Яна Лукашевича, который впервые использовал эту форму представления выражений в математической логике.
Цель польской инверсной записи – представить операции исходного выражения в порядке их выполнения (вычисления). В данной работе был использован алгоритм построения ПолИЗа, который был предложен Дейкстрой.
Пример ПолИЗа:
Исходное выражение : x=a+f*c;
Выражение на ПолИЗе :xafc*+=.
Очевидно, что обрабатывать такую последовательность операций значительно легче, так как они расположены в порядке их выполнения. Рассмотрим алгоритм Дейкстры для формирования ПолИЗа.
4.3.4.1. Алгоритм Дейкстры формирования ПолИЗа
ПРИОРИТЕТ ОПЕРАЦИИ – это целое число, означающее старшинство операции по отношению к другим операциям. Приоритет операций изменяется с использованием скобок ( и ).
Исходная последовательность просматривается слева на право, как входная последовательность элементов.
АЛГОРИТМ:
Если элемент операнд, то он заносится в ПолИЗ.
Если элемент операция, то она заносится в ПолИЗ через СТЕК по правилу.
2.1. Если СТЕК пуст, то знак операции заносится в СТЕК,
2.2. Иначе: если приоритет входного знака равен 0, то он заносится в СТЕК, иначе сравниваются приоритеты входного знака и знака в вершине СТЕКа.
2.3.Если приоритет входного знака больше приоритета знака в вершине СТЕКа, то он заносится в СТЕК.
2.4. Иначе из СТЕКа выталкиваются все знаки с приоритетом больше или равным приоритету входного знака в вершине СТЕКа и приписываются к ПолИЗу, затем входной знак заносится в СТЕК.
Особо обрабатываются ( и ).
( - имея приоритет 0 сразу же заносится в СТЕК по 2.2.
) – имея приоритет равный 1 выталкивает из СТЕКа все знаки до ближайшей открывающей скобки (, затем они взаимно уничтожаются.
При появлении признака конца выражения ( в нашем случае ;) СТЕК очищается : все оставшиеся знаки выталкиваются и приписываются к ПолИЗу.
Так же ПолИЗу соответствует так называемое дерево ПолИЗа.
Пример: (x+a)*(x-b)+3;
Дерево:


x a x b
ПолИЗ: x a + x b - * 3 +.
Построение ПолИЗа по дереву осуществляется обходом дерева по правилу левое поддерево, правое поддерево, корень.
4.3.4.2. ПолИЗ выражений, содержащих переменные синтаксиса
Кроме операций сложения и умножения любая программа содержит операции вычисляющие адреса элементов массива в зависимости от индексных выражений. Например:
a[i+1]-b[i,j-1]*a[2*i+1]


Индексные выражения.
Выведем формулы вычисления адресов элементов массива.
Для одномерного массива а, описание которого на Паскале и Си имеет вид:
a: array [1..n] of integer; // Pascal
int a[n]; // C/C++
и каждый элемент имеет массива занимает k-байт.
Адрес первого элемента равен A . Выясним чему будут равны адреса других элементов. Для этого рассмотрим расположение элементов массива в физической памяти ЭВМ.
A +k
+2k
+3k
A+k*(i-1)…
k байт
т огда
a[i] А+k*(i-1)
для языка
программирования
Паскаль, а для
языка программирования
C/C++ a[i] A+k*i.
Тогда если
элемент занимает
k – байт, то
a[i] -----> A+k*(i-1) (1)
a[i] -----> A+k*i (1’)
Для двумерного массива:
b: array [1..m,1..n] of integer;// Pascal
int b[m][n];//Си
Адрес элемента с индексами i,j вычисляется по правилу:
b[i,j] -----> B+k*((i-1)*n+(j-1)) (2)
b[i,j] -----> B+k*(i*n+j) (2’)
Для формирования ПолИЗа введем операцию АЭМ (адрес элемента массива) с операндами:
Идентификатор массива, ему после распределения памяти транслятором будет соответствовать адрес первого элемента массива.
Индексное выражение.
Результат: адрес элемента массива вычисленный по формулам (1)-(2’).
ПолИЗ: a i 1 + А.Э.М. b i j 1 – А.Э.М. a 2 i * 1 + А.Э.М. * -
Анализ ПолИЗа говорит о том, что у операции АЭМ переменное число операндов и их количество надо задавать явно. Сделаем следующую замену: АЭМ – k], где k - количество операндов.
Тогда ПолИЗ: a i j + 2] b i j 1 – 3] a 2 i * 1 + 2] * -.
Изобразим дерево выражения: (смотри рисунок )
-


А.Э.М. *


 а + А.Э.М. А.Э.М.


i 1 b i – a +


i j * 1

2 i
Следовательно, алгоритм Дейкстры дополнится следующими правилами:
ПРАВИЛА:
[, имея приоритет 0 заносится в СТЕК [k, где k – минимальное число операндов операции А.Э.М.
, , имея приоритет 1 выталкивает из СТЕКа все ближайшие знаки до ближайшей [k и увеличивает k на 1: k=k+1; , никуда не заносится.
], имея приоритет 1 выталкивает из СТЕКа все знаки до ближайшей [k, которая удаляется из СТЕКа, а в ПолИЗ заносится k].
4.3.4.3. Алгоритм перевода ПолИЗа в машинные команды
Известно, что в обратной польской записи операнды располагаются в том же порядке, что и в исходном выражении, а знаки операций при просмотре записи слева направо встречаются в том порядке, в котором нужно выполнять соответствующие действия. Отсюда вытекает основное преимущество обратной польской записи перед обычной записью выражений со скобками: выражение можно вычислить в процессе однократного просмотра слева направо.
Правило вычисления выражения в обратной польской записи состоит в следующем. Обратная польская запись просматривается слева направо. Если рассматриваемый элемент – операнд, то рассматривается следующий элемент. Если рассматриваемый элемент – знак операции, то выполняется эта операция над операндами, записанными левее знака операции. Результат операции записывается вместо первого (самого левого) операнда, участвовавшего в операции. Остальные элементы (операнды и знак операции), участвовавшие в операции, вычеркиваются из записи. Просмотр продолжается.
В результате последовательного выполнения этого правила будут выполнены все операции, имеющиеся в выражении, и запись сократится до одного элемента – результата вычисления выражения.
Рассмотрим пример: a+b*c-d/(a+b)
ПолИЗ: abc*+dab+/-
Выполнение правила для нашего примера приводит к последовательности строк, записанных во второй графе таблицы № 2 (смотрите следующую страницу). Рассматриваемый на каждом шаге процесса элемент строки отмечен курсивом. В третьей графе таблицы записаны соответствующие действия, а в четвертой графе – эквивалентные команды трехадресной машины.
Результат выполнения операции фиксируется в виде рабочей переменной вида rj . После очередной операции рабочая переменная r1 или r2 вычеркивается, освободившуюся рабочую переменную можно использовать вновь для записи результата операции. Использование каждый раз свободной рабочей переменной с минимальным номером экономит количество занятых рабочих переменных. Такой пример экономии рабочих ячеек приведен в таблице № 2. Это же правило используют в трансляторах.
Аналогичным способом можно записывать и вычислять булевские выражения.
Последовательность машинных команд в таблице № 2 есть, по существу, результат трансляции выражения, записанного в обратной польской записи, в машинные команды. Если для каждого операнда, включая рабочие переменные rj, известен адрес, для получения окончательных машинных команд остается
Таблица № 2
| № | Состояние строки | Действие | Машинная команда |
| 1 | 2 | 3 | 4 |
| 1 |
a bc*+dab+/- |
Просмотреть следующий элемент | - |
| 2 |
a b c*+dab+/- |
Просмотреть следующий элемент | - |
| 3 |
ab c *+dab+/- |
Просмотреть следующий элемент | - |
| 4 |
abc * +dab+/- |
r1=b*c |
* b c r1 |
| 5 |
ar1 + dab+/- |
r1=a+ r1 |
+ a r1 r1 |
| 6 |
r1 d ab+/- |
Просмотреть следующий элемент | - |
| 7 |
r1d a b+/- |
Просмотреть следующий элемент | - |
| 8 |
r1da b +/- |
Просмотреть следующий элемент | - |
| 9 |
r1dab + /- |
r2=a+b |
+ a b r2 |
| 10 |
r1dr2 / - |
r2= d/r2 |
/ d r2 r2 |
| 11 |
r1 r2 - |
r1 =r1 –r2 |
- r1 r2 r1 |
| 12 |
rl |
- | - |
лишь заменить знаки операций машинными кодами операций, а операнды – адресами. Пример показывает, что в данном случае трансляция выполняется достаточно просто. Однако правило вычисления значения выражения по ПолИЗу, которое можно считать одновременно правилом трансляции выражения в машинные команды, недостаточно детализировано и формализовано для непосредственной реализацией на машине, хотя бы потому, что в нем не определен способ записи выражения в памяти машины и порядок использования рабочих ячеек. Для машинной реализации требуется более формальное правило.
В рассмотренном примере встречались двухместные операции. Каждая такая операция, как правило, заменяется одной или двумя машинными командами (в зависимости от адресации машины). В общем случае операция R может иметь k операндов (k1). На ЭВМ такая операция должна заменяться группой машинных команд. Будем считать, что к моменту генерирования машинных команд проведено распределение памяти, и каждый операнд представлен соответствующей ссылкой на таблицу имен, содержащую адрес операнда. Аналогично, для каждой рабочей переменной известен ее адрес.
Для трансляции выражений из обратной польской записи в машинные команды используется стек операндов (СО) с указателем i. В исходном состоянии стек операндов пуст, а указатель i=1. Будем также считать, что в исходном состоянии номер первой свободной рабочей переменной j=1.
Алгоритм трансляции состоит в следующем.
1. Взять очередной символ S из обратной польской записи выражения.
2. Если S – операнд, то занести S в СО[i] , выполнить i=i+1 и перейти к пункту 1, иначе к пункту 3.
3. Если S – не знак операции, то перейти к пункту 4, иначе, если S – знак операции R, выполнить следующее
Среди элементов стека СО[i-k], где k – число операндов операции R, найти рабочую переменную с минимальным номером l. Если в рассматриваемых элементах стека нет рабочих переменных, то положить l=j.
Записать машинные команды, реализующие оператор присваивания rl=R(СО[i-k],…,СО[i-1]). Здесь R(x1, … , xk) – результат выполнения операции R над операндами x1, … , xk.
Занести символ rl в СО[i-k].
Выполнить: i=i-k+1 и j=l+1. Перейти к пункту 1.
Если запись выражения исчерпана, то трансляция закончена. Стек операндов должен содержать только переменную rl, в противном случае нужно записать информацию об ошибке в таблицу ошибок.
Вход
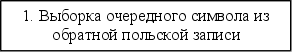
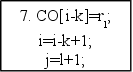


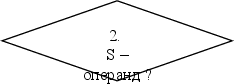
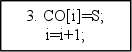

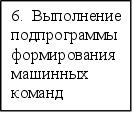
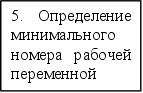
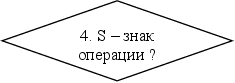
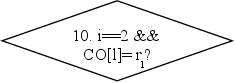

Рис.4. Блок-схема перевода обратной польской записи в машинные команды.
Для реализации пункта 3.2. приведенного алгоритма используются заранее подготовленные заготовки групп машинных команд, в которые требуется лишь подставить адреса операндов, взятые из стека операндов. Эту подстановку выполняет подпрограмма, соответствующая рассматриваемой операции R.
Надо, однако, отметить, что используемая подпрограмма определяется, не только знаком операции R, но и типом операндов. Например, одна подпрограмма соответствует операции сложения вещественных чисел, а другая – операции сложения целых. Иногда в пункте 3.2. приходится выполнять несколько подпрограмм. В частности, если один операнд целый, а другой вещественный, то в начале нужно привести операнды к одному типу, а затем выполнить подпрограмму формирования команды сложения. При несовместимости операндов или при несоответствии операндов знаку операции выдается информация об ошибке.
Блок-схема алгоритма перевода обратной польской записи в машинные команды приведена рисунке 4.
Заметим, что приведенный выше алгоритм пригоден для перевода в машинные команда не только арифметических и логических выражений, но и любых текстов, записанных в обратной польской записи с использованием произвольных операций, реализуемых машинными командами.
4.3.5. Общая схема работы интерпретатора
Рассмотрим, что же представляет собой программа, написанная на языке блок - схем с точки зрения интерпретатора. Это список структур следующего вида:
struct Blocks
{
int type; // тип блока