Новые технологии в организации PC
Как это все работает?
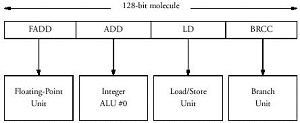
Для начала надо сказать пару слов о логической структуре процессора. Ядро Crusoe состоит из пяти модулей четырех различных типов: два блока для операций с целыми числами, один для операций числами с плавающей запятой, один - для операций с памятью, и один - модуль переходов. Соответственно, и каждая VLIW инструкция ("молекула", по терминологии Transmeta, длиной 64 или 128 бит) может состоять из четырех RISC-подобных операций этих типов ("атомов"). Все атомы выполняются параллельно, каждый соответствующим модулем, молекулы идут друг за другом, в строгом соответствии с очередью, в отличие от большинства сегодняшних суперскалярных x86 процессоров, где используется механизм внеочередного выполнения команд (out-of-order), это заметно упрощает внутреннюю структуру процессора, позволяя отказаться от некоторых громоздких функциональных модулей (например, декодера инструкций, коих в x86 наборе не так уж и мало). Для иллюстрации можно сравнить площадь мобильного 0.18 мкм Coppermine с суммарным объемом кэша 288 Кбайт с площадью TM5400 с суммарным кэшем 384 Кбайт - 106 квадратных милиметров против 73. Что, естественно, напрямую сказывается и на разнице в тепловыделении и энергопотреблении процессоров.
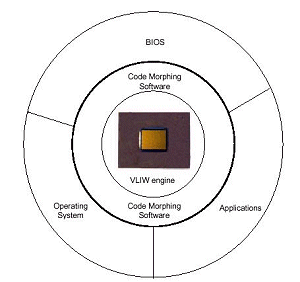
Но вернемся вновь к принципу работы процессора. На вышеописанный уровень "молекулы", по возможности максимально плотно упакованные "атомами", попадают с уровня Code Morphing, где в них превращаются исходные инструкции (на данный момент речь идет только о x86, но в перспективе ничто не мешает сделать версию транслятора и для другого набора команд). Вся окружающая среда с которой сталкивается процессор, начиная от BIOS и заканчивая операционной системой и программами, контактирует только с Code Morphing, не имея прямого доступа к самому ядру процессора. Очень удобно, учитывая, что даже уже у двух первых объявленных процессоров Transmeta это самое ядро - разное.
Одним из методов увеличения производительности такого нетрадиционного способа работы, является очень логичная система кэширования. Каждая x86 инструкция, будучи оттранслированной один раз, сохраняется в специальном кэше, располагающемся в системной памяти, и в следующий раз, при необходимости ее выполнения, этап трансляции можно пропустить, сразу достав из кэша необходимую цепочку молекул. Вдобавок, как обещает Transmeta, Code Morphing со временем еще и обучается: по мере выполнения программ, оптимизируя их для более быстрого выполнения, обращает внимание на наиболее часто выполняемые участки кода, анализирует переходы в теле программы, и т.д.
Первые процессоры Transmeta максимально ориентированы на рынок мобильных чипов (что, впрочем, не мешает компании уже поговаривать о серверном процессоре этой же архитектуры!), соответственно одним из наиболее важных параметров процессора здесь является его энергопотребление. И если с младшим из сегодняшних чипов Transmeta, TM3120, с его 92 Кбайт кэша, особых проблем нет, то в TM5400 компания встроила механизм LongRun, функционально подобный технологии SpeedStep от Intel - возможность изменения тактовой частоты и напряжения на ядре процессора на лету. Причем, куда более гибко, чем это возможно в случае с двумя фиксированными значениями у SpeedStep.
Если уж зашла речь о конкретных чипах, то давайте займемся этим вопросом более внимательно. Итак, на сегодняшний день объявлены два первых CPU, созданных по представленной Transmeta технологии. Первый, TM3120, нацелен на рынок HPC, второй, TM5400 куда больше подходит для рынка субноутбуков. Итак, по порядку:
TM3120. Младший процессор в семействе, с тактовой частотой 333, 366, и 400 МГц. Обладает всего лишь 96 Кбайт разделенного кэша L1 (64 Кбайт под инструкции, 32 Кбайт - под данные). Процессор рассчитан на напряжение 1.5 В.
Содержит стандартные для серии PC-on-a-chip элементы: 66-133 МГц SDRAM контроллер с 3.3 В интерфейсом, рассчитанный на применение со стандартными для мобильных приложений модулями SO-DIMM. Частота памяти получается путем применения определенного делителя (от 1/2 до 1/15) к тактовой частоте процессора. Контроллер шины PCI также обладает стандартным 33 МГц PCI 2.1 совместимым интерфейсом, обеспечивая полноценную работу со всеми сегодняшними продуктами, могущими его использовать. Из поддержки периферии надо упомянуть контроллер флэш-памяти - если уж продукт ориентирован на рынок самых маленьких компьютеров, то без этого там никуда.
Как любой нормальный процессор, предназначенный для работы с Windows (а в список проверенных ОС входят Microsoft Windows 95, Windows 98, Windows NT и Linux), TM3120 должен соответствовать системе управления энергопотреблением ACPI, что он успешно и делает, потребляя в системном состоянии Deep Sleep всего лишь 0.015 Вт. Разумеется, при выполнении мощных вычислений энергопотребление вырастает на несколько порядков. Например, при проигрывании DVD оно доходит до 2.9 Вт, что тоже, впрочем, чертовски хорошо, если сравнивать, скажем, с мобильными процессорами Intel и AMD.
Что касается старшего варианта, TM5400, то все вышесказанное в основном относится и к нему, но с рядом поправок. Во-первых, до 500-700 МГц выросла скорость. Во вторых, что не менее важно, значительно увеличился и объем кэша - наряду с 128 Кбайтами (64+64) L1, появился и L2 - причем сразу 256 Кбайт. Здесь, в зависимости от частоты, напряжение ядра плавает - от 1.2 до 1.6 В. Энергопотребление, впрочем, даже в случае проигрывания DVD доходит всего лишь до 1.8 Вт - в первую очередь сказывается LongRun.
Что касается PC-on-a-chip возможностей, то здесь всего одно пополнение, но такое, которое просто нельзя не заметить - к SDRAM контроллеру прибавился его DDR SDRAM собрат. Все что было сказано выше о скорости SDRAM, относится и к DDR.
Все это замечательно, но как Crusoe ведет себя в реальной жизни? Вполне неплохо для начала. Уже была продемонстрирована работа на компьютере на базе Crusoe заявленных операционных систем, без особых проблем работали реальные приложения - Power Point, Quake...
Что касается производительности, то Transmeta поступила весьма разумно, решив предложить для этого собственный тест - Mobile Platform Benchmark. Впрочем, надо признать, весьма логичный, во главу угла ставящий соотношение производительность/энергопотребление. (Ну а то, что здесь выигрывает Crusoe - это, разумеется, проблемы конкурентов). По тестам, произведенным на нем самой Transmeta, TM5400, с варьировавшейся в течение теста (LongRun был включен) от 266 до 533 МГц скоростью, на ряде задач шел вровень с мобильным Pentium III 500, на ряде отставал. Причем во всех задачах его энергопотребление было в несколько раз ниже. Здесь можно привести еще один показатель, правда, опять со слов самой компании - 667 Мгц TM5400 по производительности примерно равен 500 МГц Pentium III.
7. VIA Joshua
Всю свою историю, самой отличительной чертой процессоров Cyrix была их максимальная доступность. AMD всегда пыталась быть этаким средним классом, а Intel традиционно снимал сливки сверху. Этим стратегиям к концу 90-х годов полностью соответствовало и финансовое состояние компаний. Вдобавок, сильное влияние оказал и еще один момент: вспыхнувшая в последние годы тенденция к резкому снижению стоимости PC не сделала Cyrix королем, как это можно было бы подумать. Напротив, в результате на этот рынок обратили серьезнейшее внимание Intel и AMD, развернувшие в последние два года там кровопролитную ценовую войну, что очень напоминало борьбу двух слонов в посудной лавке.
Результат мы знаем. Летом, после достаточно продолжительной агонии своей линейки MII, National Semiconductor был вынужден оставить рынок x86 процессоров, шаг, который был вполне очевиден уже в конце 98 года. В течение второй половины прошедшего года ушли и другие компании, работавшие в той же нише: IDT и Rise. Но их уход отнюдь не означал, что спрос на процессоры, стоящие несколько два-три десятка долларов, внезапно испарился. Напротив, он остался, и даже, пожалуй, несколько вырос: все же последние несколько лет требования офисных пакетов застыли практически на одном и том же уровне, и этому уровню вполне соответствует производительность, обеспечиваемая подобными процессорами. Таким образом, спрос остался, а вот предложение фактически исчезло. Ситуация, которую надо было исправить.
И здесь на выручку пришла VIA Technology, амбиции которой к началу прошедшего года выросли до немыслимых высот. Компания, вполне успешно конкурирующая в последнее время с Intel в области чипсетов, причем во многом за счет умения продавать именно дешевые продукты, решила попробовать применить эту стратегию в области процессоров. Самым простым путем к реализации этого плана была покупка компании, уже работающей в этой области. Тем более, что ситуация сложилась так, что VIA крайне был необходим доступ к патентам, имеющим отношение к шине GTL+. Этим летом она получила его, за счет приобретения двух групп разработчиков процессоров - Cyrix у National Semiconductor и Centaur у IDT. Несмотря на то, что явным фаворитом VIA является Centaur, первым ее процессором все же станет процессор от Cyrix. О нем здесь речь и пойдет.
Первые сведения о нем появились еще осенью 1997 года, на MicroProcessor Forum, традиционном месте для объявлений такого рода. Вице-президент Cyrix, Роберт Махер, описал ядро Cayenne - модифицированное ядро 6x86 линейки, обладающее поддержкой MMXFP - набора SIMD инструкций, разработанного самим Cyrix, модуль операций с целыми числами оставался практически нетронутым, а вот модуль операций с числами с плавающей точкой должен был подвергнуться довольно значительным изменениям: появлялась конвейерная обработка и возможность обработки до двух операций с такими числами за такт. Новый сопроцессор должен был вывести процессор Cyrix почти на тот же уровень, что и Pentium II/Pentium III. То же самое можно сказать и работе Cayenne с MMX инструкциями.
Что касается технических параметров нового процессора, то подразумевалось, что Cayenne начнет производиться во второй половине 1998 года с использованием 0.25 мкм техпроцесса (площадь чипа из 6.8 миллионов транзисторов должна была составить около 70 кв. мм), в течение 98 года его скорость вырастет с 250 до 350 МГц (PR рейтинг - с 300 до 400 МГЦ). А уже в 99 году ему на смену должен был придти Jalapeno.
Тем не менее, прошел 98 год, прошла первая половина 99, Cyrix уже успел отказаться от собственного расширенного набора инструкций в пользу 3DNow!, а Cayenne все продолжал доводиться разработчиками, успев переименоваться сначала в Jedi, а потом, после появления претензий со стороны LucasFilm, и в Gobi. Что касается изменений, произошедших в дизайне процессора за это время, то известно только, что, как и предполагалось еще на MPR'97, у него появился кэш L2 на чипе, причем, достаточно внушительный - 256 Кбайт, как у сегодняшнего Coppermine. (А еще стоит вспомнить 64 Кбайт единого кэша L1 - вдвое больше, чем у того же Coppermine). В таком состоянии находились дела, когда Cyrix был приобретен VIA.
К этому моменту процессор находился уже на грани появления на свет: достаточно сказать только, что незадолго до приобретения Cyrix он уже демонстрировался на Computex'99. Таким образом, покупая Cyrix, VIA кроме получения столь необходимых ей патентов получала доведенный до кондиции в течение двух лет дешевый, но достаточно производительный процессор - именно то, что ей и было надо. Так что, разогнав половину Cyrix, VIA все же оставила полторы сотни человек с тем, чтобы они в течение нескольких месяцев довели процессор до стадии, когда было бы возможным его коммерческое производство.
К тому времени он уже начал принимать завершенные черты: четко определился интерфейс - Socket 370, частота системной шины (66/100/133 МГц), техпроцесс - 0.18 мкм и, самое главное, имя - Joshua. На самом деле, конечно, главное - это скорость, но вот с этим точной определенности не было. На момент написания этой статьи предполагается, что PR-рейтинг процессора будет составлять 433/466/500/533/566 МГц, причем, по видимому, на момент выхода будут доступны только два первых варианта из этой линейки.
Возможность разгона оставляет достаточно смутные впечатления. С одной стороны - незафиксированный коэффициент умножения: прямо-таки рай после процессоров Intel и AMD. С другой стороны, процессор, который изначально рассчитан на напряжение 2.2В (и это для не столь уж больших 300 МГц для PR-рейтинга 433!), заставляет крепко задуматься о перспективах его разгона: похоже, это сделали уже до нас. С другой стороны, 0.18 мкм техпроцесс TSMC все же оставляет некоторую надежду.
Что касается производительности, то, исходя из архитектуры процессора, стоит ожидать ее примерно на уровне Celeron, работающего тактовой частотой, соответствующей его PR-рейтингу - некоторые недостатки лишь слегка улучшенной архитектуры несколько летней давности должен во многом вытянуть 256 Кбайт кэш L2, работающий на тактовой частоте процессора. В основном, конечно, это касается офисных приложений, где лишние 128 Кбайт L2 совсем не помешают. Что касается игр, то здесь скажется значительно улучшенный со времен 6x86MX сопроцессор, и, разумеется, не стоит скидывать со счетов поддержку 3DNow! - сегодня под этот набор SIMD инструкций оптимизирована любая из выходящих мало-мальски серьезных игр и новые драйвера под любую видеокарту.
И все это за очень (наши источники в VIA категорически подчеркивают это слово) доступную цену. Учитывая, что по последним данным о планах Intel, прогресс линейки Celeron в этом году значительно замедлится, и его частота лишь слегка перешагнет за 600 МГц, то позиции VIA выглядят вполне надежными.
8. Merced
Введение
Merced - название 64-разрядного микропроцессора общего назначения, разрабатываемого в настоящее время фирмой Intel. Его выпуск начнется в середине 2000 года по 0.18-микронной технологии. Опытное производство - в 1999 году.
Процессор получил название от города Merced, расположенного недалеко от Сан-Хосе (США).
Merced станет первым процессором нового семейства IA-64. IA-64 - аббревиатура от Intel 64-bit Architecture - 64-разрядная Архитектура Intel. IA-64 воплощает концепцию EPIC (аббревиатура от Explicitly Parallel Instruction Computing - Вычисления с Явным Параллелизмом Команд). Концепция EPIC разработана совместно фирмами Intel и Hewlett-Packard, по их заявлениям, EPIC - концепция той же значимости, что CISC и RISC. В IA-64 используется новый 64-разрядный набор команд, разработанный также совместно фирмами Intel и HP (для него в официальных сообщениях Intel и HP вводится аббревиатура 64-bit ISA - 64-bit Instruction Set Architecture). Вдобавок, Merced будет полностью совместим с семейством x86 (В официальных сообщениях Intel семейство x86 обозначают аббревиатурой IA-32 - Intel 32-bit Architecture - 32-разрядная Архитектура Intel).
В настоящее время доподлино известно о работах над двумя процеcсорами семейства IA-64:
уже упомянутый Merced, разрабатываемый в основном силами Intel
McKinley, который разрабатывается в HP и появится в конце 2001 года
Недавно были добавлены еще два названия:
В 2002 должен появиться Madison, а за ним - Deerfield.
Хронология событий
Hewlett-Packard и Intel объявили о совместном исследовательском проекте в июне 1994 года. Цель проекта - создание более совершенных технологий в сфере "рабочих станций конца десятилетия, серверов и информационно-вычислительных продуктов масштаба предприятия". Проект включал разработку "архитектуры 64-разрядного набора команд" и оптимизирующих компиляторов.
В 1996 году фирма HP выпустила свой первый 64-разрядный процессор общего назначения - PA-8000, представитель нового семейства PA-RISC 2.0. Естественно предположить, что PA-RISC 2.0 - результат совместного проекта "архитектуры 64-разрядного набора команд", тем более, что в PA-8000 применены решения, которые в терминологии IA-64 называются "предикация" и "загрузка по предположению". Но нет официальных данных, подтверждающих это предположение.
9 октября 1997 года фирма Intel объявила, что
производство Merced, первого представителя нового семейства 64-разрядных микропроцессоров, начнется в 1999 году по 0.18-микронному технологическому процессу фирмы Intel, который также создается;
процессор предназначен для рабочих станций и серверов;
Merced сможет выполнять программы для 32-разрядных процессоров Intel;
Intel обладает средой разработки программного обеспечения, полностью совместимого с IA-64, и "ключевые" независимые продавцы программного обеспечения уже используют эту среду для разработки операционных систем и приложений уровня предприятия;
14 октября 1997 года, на Микропроцессорном Форуме в Сан-Хосе, Калифорния, фирмы Intel и HP впервые публично описали основы IA-64. Совместно выступили John Crawford, Intel Fellow and Director of Microprocessor Architecture и Jerry Huck, Hewllet-Packard`s Manager and Lead Architect. Запись их речей можно найти на Web-сервере Intel, а демонстрировавшиеся слайды - на Web-сервере HP. Фирма Intel дополнила это выступление заявлениями для прессы .
В тот же день на Микропроцессорном Форуме выступал Joel Birnbaum, Director of Hewlett-Packard Laboratories, Senior Vice President of Research and Development. Он вкратце рассказал о работах HP над процессорными архитектурами с 1980-х до альянса с Intel в 1994. По его словам, отправной точкой для альянса с Intel послужил проект, называемый сначала Wide-Word, а затем Super-Parallel Processor Architecture (SP-PA). Этот проект был выполнен в HP Labs под руководством Bill Worley, который одновременно возглавлял работы над PA-RISC. Согласно Joel Birnbaum, в проекте Wide-Word были проведены эксперименты со статическим параллелизмом и загрузкой по предположению, разработана "обобщенная предикация", механизмы, позволяющие масштабировать количество функциональных устройств и их "скорость". Также он объяснил, зачем фирме HP понадобилось заключать альянс с Intel, но это объяснение слишком обширно, чтобы приводить его здесь.
29 мая 1998 года фирма Intel сообщила о переносе на год выпуска процессора Merced. Было объявлено, что серийное производство начнется в середине 2000 года. А опытное - в 1999 году. В официальном сообщении нет никаких сведений ни об архитектуре Merced, ни о технологии его производства.
С 12 по 15 октября 1998 года проходил очередной Микропроцессорный Форум. От Intel выступал Stephen Smith с темой "IA-64 Processors: Features and Futures". Он сообщил несколько новых технических деталей, рассказал о перспективах семейства IA-64.
EPIC, IA-64, Merced
Концепция EPIC, согласно Intel и HP, обладает достоинствами VLIW, но не обладает ee недостатками.
John Crawford перечислил следующие особенности EPIC:
Большое количество регистров.
Масштабируемость архитектуры до большого количества функциональных устройств. Это свойство представители фирм Intel и HP называют "наследственно масштабируемый набор команд" (inherently scaleable instruction set)
Явный параллелизм в машинном коде. Поиск зависимостей между командами производит не процессор, а компилятор.
Предикация (Predication). Команды из разных ветвей услового ветвления снабжаются предикатными полями (полями условий) и запускаются параллельно.
Загрузка по предположению (Speculative loading). Данные из медленной основной памяти загружаются заранее.
Ниже эти особенности EPIC объяснены подробнее.
Представители Intel и HP назывют EPIC концепцией следующего поколения и противопоставляют ее CISC и RISC. По мнению Intel, традиционные архитектуры имеют фундаментальные свойства, ограничивающие производительность. Производители RISC процессоров не разделяют подобного пессимизма. Кстати, в 1980-х, когда возникла концепция RISC, прозвучало много заявлений, что концепция CISC устарела, имеет фундаментальные свойства, ограничивающие производительность. Но процессоры, причисляемые к CISC (например, семейство x86 фирмы Intel), широко используются до сих пор, их производительность растет.
Дело в том, что все эти аббревиатуры - CISC, RISC, VLIW обозначают только идеализированные концепции. Реальные микропроцессоры трудно классифицировать. Современные микропроцессоры, причисляемые к RISC, сильно отличаются от первых процессоров RISC архитектуры. То же относится и к CISC. Просто в наиболее совершенных процессорах заложено множество удачных идей вне зависимости от их принадлежности к какой-либо концепции.
Регистры IA-64:
128 64-разрядных регистров общего назначения (целочисленных)
128 80-разрядных регистров вещественной арифметики.
64 1-pазpядных пpедикатных pегистpов.
Напомним, что наличие большого числа регистров названо John Crawford в числе основных черт EPIC. Действительно, 128 - много по сравнению с 8 регистрами общего назначения семейства x86. Но, например, MIPS R10000 содержит 64 целых и 64 вещественных 64-разрядных регистров.
Формат команды IA-64:
идентификатор команды,
три 7-разрядных поля операндов - 1 приемник и 2 источника (операндами могут быть только регистры, а их - 128=2^7)
особые поля для вещественной и целой арифметики
6-разрядное предикатное поле (64=2^6)
Команды IA-64 упаковываются (группируются) компилятором в "связку" длиною в 128 pазpядов. Связка содеpжит 3 команды и шаблон, в котоpом будут указаны зависимости между командами (можно ли с командой к1 запустить параллельно к2, или же к2 должна выполниться только после к1) , а также между другими связками (можно ли с командой к3 из связки с1 запустить параллельно команду к4 из связки с2).
Перечислим все варианты составления связки из 3-х команд:
i1 || i2 || i3 - все команды исполняются паpаллельно
i1 & i2 || i3 - сначала i1, затем исполняются паpаллельно i2 и i3
i1 || i2 & i3 - паpаллельно исполняются i1 и i2, после них - i3
i1 & i2 & i3 - последовательно исполняются i1, i2, i3
Одна такая связка, состоящая из трех команд, соответствует набору из трех функциональных устройств процессора. Процессоры IA-64 могут содержать разное количество таких блоков, оставаясь при этом совместимыми по коду. Ведь благодаря тому, что в шаблоне указана зависимость и между связками, процессору с N одинаковыми блоками из трех функциональных устройства будет соответствовать командное слово из N*3 команд ( N связок ). Таким образом должна обеспечиваться масштабируемость IA-64. Несомненно, это красивая концепция. К сожалению, IA-64 присущи и некоторые недостатки.
Tom R. Halfhill в статье журнала BYTE предполагает что без перекомпиляции код с одного процессора семейства IA-64 не будет эффективно исполняться на другом.
Уже упомянутый Jerry Huck отметил, что в IA-64 можно произвольно (блоками по 3) увеличивать количество функциональных устройств, но при этом число регистров должно оставаться неизменным.
Также Jerry Huck предупредил, что размер кода для IA-64 будет больше, чем для RISC процессоров, потому что на 3 команды IA-64 приходится 128 bit, а длина RISC команды обычно равна 32 bit, то есть, в 128 битах содержатся 4 команды RISC.
Вдобавок произошла путаница. На прошедшем во второй половине февраля 1998 года Форуме Разработчиков Intel ведущий инженер Carole Dulong сказала, что в такой архитектуре, как Merced, пропорция целочисленых, вещественных, специализированных устройств и устройств чтения/записи будет определяться сочетанием соответствующих команд в предполагаемом машинном коде. Тогда как на Микропроцессорном Форуме представители фирм Intel и HP объясняли, что процессоры семейства IA-64 будут содержать N одинаковых блоков по три функциональных устройства. Причем, можно предположить, что такой блок должен состоять из целочисленного устройства, устройства вещественной арифметики и устройства чтения/записи. Данные высказывания противоречат друг другу.
Кстати, EPIC удивительно напоминает архитектру VelociTI семейства сигнальных процессоров TMS320C6x фирмы Texas Instruments. Примером может служить TMS320C6201. В этом процессоре довольно много регистров - 32 регистра общего назначения. 8 функциональных устройств - это много даже по меркам современных процессоров общего назначения. Команды TMS320C6201 упаковываются во VLIW-слова, состоящие из 8 команд и шаблона. В шаблоне указаны зависимости между командами - явный параллелизм. За такт может исполниться до 8 команд. Все команды снабжены полем условия - предикация.
Помимо семейства IA-64 идут разработки еще нескольких универсальных процессоров с VLIW-подобной архитектурой.
Например, в России группой Эльбрус с 1992 года разрабатывается микропроцессор E2k (Эльбрус-2000). Научный руководитель группы Эльбрус член-корреспондент РАН Б.А. Бабаян утверждает, что отечественный E2k будет в два раза производительнее, чем McKinley (последователь Merced). По оценкам полученным на логической модели, производительность E2k составит 135 SPECint95 и 350 SPECfp95.
Еще примеры:
В 1995 году была образована фирма Transmeta Ее руководителем является Dave Ditzel, который ранее, будучи сотрудником Sun, взаимодействовал с коллективом Эльбрус и имел доступ к информации по разрабатываемому E2k.
Исследования VLIW в исследовательском центре IBM имени T.J. Watson начались в 1986.
Кроме этого, сейчас появляется все больше сигнальных и "медийных" процессоров с архитектурой VLIW.
Предикация
Предикация - способ обработки условных ветвлений. Суть этого способа - компилятор указывает, что обе ветви выполняются на процессоре параллельно. Ведь EPIC процессоры должны иметь много функциональных устройств.
Опишем