Наращивание экономической и статистической информации в двухструктурных реляционных базах данных
Объекты БД в Delphi основаны на SQL и включают в себя полную мощь Borland Database Engine. В состав Delphi также включен Borland SQL Link, поэтому доступ к СУБД Oracle, Sybase, Informix и InterBase происходит с высокой эффективностью. Кроме того, Delphi включает в себя локальный сервер Interbase для того, чтобы можно было разработать расширяемые на любые внешние SQL-сервера приложения в офлайновом режиме. Разработчик в среде Delphi, проектирующий информационную систему для локальной машины (к примеру, небольшую систему учета медицинских карточек для одного компьютера), может использовать для хранения информации файлы формата .dbf (как в dBase или Clipper) или .db (Paradox). Если же он будет использовать локальный InterBase for Windows 4.0 (это локальный SQL-сервер, входящий в поставку), то его приложение безо всяких изменений будет работать и в составе большой системы с архитектурой клиент-сервер.
Масштабируемость на практике - одно и то же приложение можно использовать как для локального, так и для более серьезного клиент-серверного вариантов.[4, 22].
В состав пакета Delphi также входит множество утилит для работы и управления базами данных. Вот некоторые из них.
 Database
Desktop - это
утилита, во
многом похожая
на Paradox, которая
поставляется
вместе с Delphi для
интерактивной
работы с таблицами
различных
форматов локальных
баз данных -
Paradox и dBase, а также
SQL-серверных
баз данных
InterBase, Oracle, Informix, Sybase (с использованием
SQL Links). Она позволяет
создавать как
структуру
реляционных
таблиц,
так и всевозможные
ограничения
целостности
таблиц, индексы,
первичные ключи
и внешние ключи.
 WISQL
(Windows Interactive SQL)
- интерактивное
средство посылки
SQL-запросов к
InterBase (в том числе
и локальному
InterBase), входящее
в поставку
Delphi, позволяет
создавать
таблицы - через
посылку SQL-запросов.
 Database Desktop не
обладает всеми
возможностями
по управлению
SQL-серверными
базами данных.
Поэтому с помощью
Database Desktop удобно создавать
или локальные
базы данных
или только
простейшие
SQL-серверные
базы данных,
состоящие из
небольшого
числа таблиц,
не очень сильно
связанных друг
с другом. Если
же необходимо
создать базу
данных, состоящую
из большого
числа таблиц,
имеющих сложные
взаимосвязи,
можно воспользоваться
языком SQL. Можно
записать всю
последовательность
SQL-предложений
в один так называемый
скрипт
и послать его
на выполнение.
Конкретные
реализации
языка SQL незначительно
отличаются
в различных
SQL-серверах, однако
базовые предложения
остаются одинаковыми
для всех реализаций.
Практика показывает,
что если нет
необходимости
создавать
таблицы во
время выполнения
программы, то
лучше воспользоваться
WISQL.
InterBase - это система управления реляционными базами данных, поставляемая корпорацией BORLAND для построения приложений с архитектурой клиент-сервер произвольного масштаба: от сетевой среды небольшой рабочей группы с сервером под управлением Novell NetWare или Windows NT на базе IBM PC до информационных систем крупного предприятия на базе серверов IBM, Hewlett-Packard, SUN и т.п.
В пакет Delphi входит однопользовательская версия InterBase для Windows - Local InterBase. Используя Local InterBase можно создавать и отлаживать приложения, работающие с данными по схеме клиент-сервер, без подключения к настоящему серверу. В дальнейшем потребуется только перенастроить используемый псевдоним базы данных и программа будет работать с реальной базой без перекомпиляции. Кроме того, Local InterBase можно использовать в приложениях для работы с данными вместо таблиц Paradox.
Важной составной частью приложения является вывод данных на печать - получение отчета. В пакет Delphi входит средство для генерации и печати отчетов - ReportSmith. Вы можете объединить отчет с приложениями Delphi. Также, библиотека визуальных компонент Delphi включает специальный компонент TReport. В данном уроке показано, как использовать компоненту TRepor и рассмотрены основные принципы проектирования отчетов в ReportSmith.
Borland ReportSmith является инструментом для получения отчетов и интегрирован в среду Delphi. Отчет может быть добавлен к приложениям Delphi. Отчеты могут быть созданы для SQL БД или локальных БД и не требуют знания сложных команд БД. Интерфейс ReportSmith использует стандартные инструменты Windows типа tool bar, formatting ribbon, и “drag and drop”. Если пользователь уже знаком с интерфейсом стандартных Windows-программ, типа Word for Windows или Quattro Pro for Windows, ему будет “знаком” и интерфейс ReportSmith. ReportSmith предлагает 4 типа отчетов: Табличный, Кросс-таблица(CrossTab), Форма(Form) и Наклейка(Label).
ReportSmith использует концепцию “живых данных”, т.е. работа происходит с настоящими данными все время, а не только тогда, когда запускается просмотр (preview). Кроме этого, ReportSmith легко работает с чрезвычайно большими БД при помощи адаптивной технологии управления памятью. В ReportSmith можно управлять тем, где сохраняется результат выборки данных из БД: в локальный памяти клиентской PC, на жестком диске клиентской PC, или на сервере.
Настраиваемая среда разработчика
После запуска Delphi в верхнем окне горизонтально располагаются иконки палитры компонент. Если курсор задерживается на одной из иконок, под ней в желтом прямоугольнике появляется подсказка
Из этой палитры компонент можно выбирать компоненты, из которых можно строить приложения. Компоненты включают в себя как визуальные, так и логические компоненты. Такие вещи, как кнопки, поля редактирования - это визуальные компоненты; а таблицы, отчеты - это логические.
Поскольку в Delphi программа строится визуальным образом, все эти компоненты имеют свое графическое представление в поле форм для того, чтобы можно было бы ими соответствующим образом оперировать. Но для работающей программы видимыми остаются только визуальные компоненты. Компоненты сгруппированы на страницах палитры по своим функциям. К примеру, компоненты, представляющие Windows “common dialogs” все размещены на странице палитры с названием “Dialogs”.
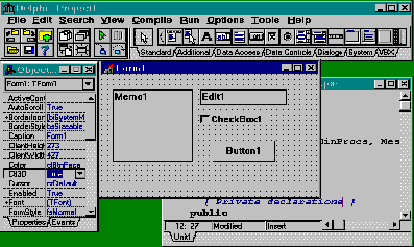 Delphi
позволяет
разработчикам
настроить среду
для максимального
удобства. Можно
легко изменить
палитру компонент,
инструментальную
линейку, а также
настраивать
выделение
синтаксиса
цветом.
В Delphi можно определить свою группу компонент и разместить ее на странице палитры, а если возникнет необходимость, перегруппировать компоненты или удалить неиспользуемые.
Интеллектуальный редактор. Редактирование программ можно осуществлять, используя запись и исполнение макросов, работу с текстовыми блоками, настраиваемые комбинации клавиш и цветовое выделение строк.
Графический отладчик. Delphi обладает мощнейшим, встроенным в редактор графическим отладчиком, позволяющим находить и устранять ошибки в коде. Можно установить точки останова, проверить и изменить переменные, при помощи пошагового выполнения в точности понять поведение программы. Если же требуются возможности более тонкой отладки, можно использовать отдельно доступный Turbo Debugger, проверив ассемблерные инструкции и регистры процессора.
Инспектор объектов. Этот инструмент представляет из себя отдельное окно, где вы можете в период проектирования программы устанавливать значения свойств и событий объектов (Properties & Events).
Менеджер проектов. Дает возможность разработчику просмотреть все модули в соответствующем проекте и снабжает удобным механизмом для управления проектами. Менеджер проектов показывает имена файлов, время/дату выбранных форм и пр. Можно немедленно попась в текст или форму, просто щелкнув мышкой на соответствующее имя.
Навигатор объектов. Показывает библиотеку доступных объектов и осуществляет навигацию по приложению. Можно посмотреть иерархию объектов, прекомпилированные модули в библиотеке, список глобальных имен вашего кода.
Дизайнер меню. Можно создавать меню, сохранить созданные в виде шаблонов и затем использовать в их в любом приложении.
Эксперты. Это набор инструментальных программ, облегчающих проектирование и настройку Ваших приложений. Есть возможность подключать самостоятельно разработанные эксперты. Потенциально это та возможность, при помощи которой третьи фирмы могут расширять Delphi CASE-инструментами, разработанными специально для Delphi. Включает в себя:
Эксперт форм, работающих с базами данных
Эксперт стилей и шаблонов приложений
Эксперт шаблонов форм
В состав RAD Pack входит эксперт для преобразования ресурсов, изготовленных в Borland Pascal 7.0, в формы Delphi. Уже появились эксперты, облегчающие построение DLL и даже написание собственных экспертов
Интерактивная обучающая система. Позволяет более полно освоить Delphi. Она являются не просто системой подсказок, а показывает возможности Delphi на самой среде разработчика.
Незначительные требования к аппаратным и программным средствам
Delphi это высокопроизводительный инструмент создания приложений. Для запуска Delphi требуется как минимум 386 компьютер с 4MB памяти. Более подходящей машиной будет 486DX 66MHz с 8MB ОЗУ.
Небольшие программы, созданные на Delphi будут работать на любом компьютере. Другими словами, они не требуют того ОЗУ или скорости процессора, что необходимо для среды Delphi. [4].
Проектирование базы данных
Проектирование БД связанно с разрешением проблем представления данных между конечными пользователями. Они продиктованы различными потребностями и задачами лиц, которые используют эти данные. Пользователи могут быть выделены в отдельные группы. Каждая из групп воздействует на результаты проектирования в разных направлениях. Необходимо собрать информацию о реальных и потенциальных приложениях, а также о пользователях базы данных, чтобы устранить все противоречия ещё на начальном этапе, так как многолетний мировой опыт использования информационных систем, построенных на основе баз данных, показывает, что недостатки проекта допущенные на этапе проектирования невозможно устранить любыми ухищрениями в программах приложений.
Проектирование обычно поручается человеку (группе лиц) – администратору базы данных (АБД). Им может быть как специально выделенный сотрудник, так и будущий пользователь базы данных, достаточно хорошо знакомый с машинной обработкой данных.
В основу проектирования БД должны быть положены представления конечных пользователей конкретной организации — концептуальные требования к системе. Именно конечный пользователь в своей работе принимает решения с учетом получаемой в результате доступа к базе данных информации. От оперативности и качества этой информации будет зависеть эффективность работы организации. Данные, помещаемые в базу данных, также предоставляет конечный пользователь. Кроме того, БД должна предоставлять доступ к данным пользователям, которые практически не имеют или не хотят иметь представления о физическом размещении в памяти данных и их описаний, о механизмах поиска запрашиваемых данных или о поддержании баз данных в актуальном состоянии.[15].
Прикладные программисты хотели бы иметь в одном месте (например, в одной таблице) все данные, необходимые им для реализации запроса из прикладной программы или с терминала.
АБД же заботятся об исключении возможных искажений хранимых данных при вводе в базу данных новой информации и обновлении или удалении существующей. Для этого они удаляют из базы данных дубликаты и нежелательные функциональные связи между таблицами, разбивая базу данных на множество маленьких таблиц.
Чтобы различать представления данных конечными пользователями, программистами и АБД создаются разные уровни моделей данных. Их общая структура представлена на рис. 14.
Основное различие между указанными выше тремя типами моделей данных (концептуальной, логической и физической) состоит в способах представления взаимосвязей между объектами. При проектировании БД требуется различать взаимосвязи между объектами, между свойствами одного объекта и между свойствами различных объектов. Рассмотрим каждую из них более подробно.
 Инфологическая
модель данных
Предметная область – часть реального мира отражённая в базу данных.
Объединяя частные представления о содержимом базы данных, полученные в результате опроса пользователей, и свои представления о данных, которые могут потребоваться в будущих приложениях, АБД сначала создает обобщенное неформальное описание создаваемой базы данных. Это описание, выполненное с использованием естественного языка, математических формул, таблиц, графиков и других средств, понятных всем людям, работающих над проектированием базы данных, называют инфологической моделью данных.
Цель инфологического моделирования – обеспечение наиболее естественных для человека способов сбора и представления той информации, которую предполагается хранить в создаваемой базе данных. Поэтому инфологическую модель данных пытаются строить по аналогии с естественным языком. Основными конструктивными элементами инфологических моделей являются сущности, связи между ними и их свойства (атрибуты).
Сущность – любой реальный или не реальный различимый объект (объект, который мы можем отличить от другого), информацию о котором необходимо хранить в базе данных. Сущностями могут быть люди, места, самолеты, рейсы, вкус, цвет и т.д. Необходимо различать такие понятия, как тип сущности и экземпляр сущности. Понятие тип сущности относится к набору однородных личностей, предметов, событий или идей, выступающих как целое. Экземпляр сущности относится к конкретной вещи в наборе. Например, типом сущности может быть ГОРОД, а экземпляром – Москва, Киев и т.д.
Атрибут – поименованная характеристика сущности. Атрибутом сущности является любая деталь, которая служит для уточнения, идентификации, классификации, числовой характеристики или выражения состояния сущности. Его наименование должно быть уникальным для конкретного типа сущности, но может быть одинаковым для различного типа сущностей (например, ЦВЕТ может быть определен для многих сущностей: СОБАКА, АВТОМОБИЛЬ, ДЫМ и т.д.). Атрибуты используются для определения того, какая информация должна быть собрана о сущности. Примерами атрибутов для сущности АВТОМОБИЛЬ являются ТИП, МАРКА, НОМЕРНОЙ ЗНАК, ЦВЕТ и т.д. Здесь также существует различие между типом и экземпляром. Тип атрибута ЦВЕТ имеет много экземпляров или значений: Красный, Синий, Банановый, Белая ночь и т.д., однако каждому экземпляру сущности присваивается только одно значение атрибута.
Абсолютное различие между типами сущностей и атрибутами отсутствует. Атрибут является таковым только в связи с типом сущности. В другом контексте атрибут может выступать как самостоятельная сущность. Например, для автомобильного завода цвет – это только атрибут продукта производства, а для лакокрасочной фабрики цвет – тип сущности.
Связь – ассоциирование двух или более сущностей. Эта ассоциация всегда является бинарной и может существовать между двумя разными сущностями или между сущностью и ей же самой (рекурсивная связь). В любой связи выделяются два конца (в соответствии с существующей парой связываемых сущностей), на каждом из которых указывается имя конца связи, степень конца связи (сколько экземпляров данной сущности связывается), обязательность связи (т.е. любой ли экземпляр данной сущности должен участвовать в данной связи).
Если бы назначением базы данных было только хранение отдельных, не связанных между собой данных, то ее структура могла бы быть очень простой. Однако одно из основных требований к организации базы данных – это обеспечение возможности отыскания одних сущностей по значениям других, для чего необходимо установить между ними определенные связи. А так как в реальных базах данных нередко содержатся сотни или даже тысячи сущностей, то теоретически между ними может быть установлено более миллиона связей. Наличие такого множества связей и определяет сложность инфологических моделей.
При определении инфологической модели необходимо принимать во внимание следующее:
База данных должна удовлетворять актуальным информационным потребностям организации. Получаемая информация должна по структуре и содержанию соответствовать решаемым задачам.
База данных должна обеспечивать получение требуемых данных за приемлемое время, то есть отвечать заданным требованиям производительности.
База данных должна удовлетворять выявленным и вновь возникающим требованиям всех пользователей.
База данных должна легко расширяться при реорганизации и расширении предметной области.
База данных должна легко изменяться при изменении программной и аппаратной среды.
Инфологическая модель данных "сущность-связь"
Инфологическая модель отображает реальный мир в некоторые понятные человеку концепции, полностью независимые от параметров среды хранения данных. Существует множество подходов к построению таких моделей: графовые модели, семантические сети, модель "сущность-связь" и т.д. Наиболее популярной из них оказалась модель "сущность-связь" или называемая ещё ER-моделью (от англ. Entity-Relationship, т.е. сущность-связь).
На использовании разновидностей ER-модели основано большинство современных подходов к проектированию баз данных (главным образом, реляционных). Модель была предложена Ченом (Chen) в 1976 г. Моделирование предметной области базируется на использовании графических диаграмм, включающих небольшое число разнородных компонентов. В связи с наглядностью представления концептуальных схем баз данных ER-модели получили широкое распространение в системах CASE, поддерживающих автоматизированное проектирование реляционных баз данных.
В них сущности изображаются помеченными прямоугольниками, ассоциации (связи)– помеченными ромбами или шестиугольниками, атрибуты – помеченными овалами, а связи между ними – ненаправленными ребрами, над которыми может проставляться степень связи (1 или буква, заменяющая слово "много") и необходимое пояснение.
Между двумя сущностям, например, А и В возможны четыре вида связей.
Первый тип – связь ОДИН-К-ОДНОМУ (1:1): в каждый момент времени каждому представителю (экземпляру) сущности А соответствует 1 или 0 представителей сущности В:
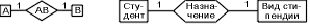
Студент может не "заработать" стипендию, получить обычную или одну из повышенных стипендий. Или, допустим, в определенный момент времени один клиент может сделать только один заказ. В этом случае между объектами КЛИЕНТ и ЗАКАЗ устанавливается взаимосвязь “один к одному”, обозначаемая одинарными стрелками.
Между данными, хранящимися в объектах КЛИЕНТ и ЗАКАЗ, будет существовать взаимосвязь, в которой каждая запись в одном объекте будет однозначно указывать на запись в другом объекте. Ни в одном, ни в другом объекте не может существовать записи, не связанной с какой-либо записью в другом объекте.
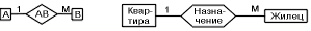 Второй
тип – связь
ОДИН-КО-МНОГИМ
(1:М): одному представителю
сущности А
соответствуют
0, 1 или несколько
представителей
сущности В.
Квартира может пустовать, в ней может жить один или несколько жильцов. Или, например, в определенный момент времени один клиент может стать обладателем нескольких моделей автомобилей, при этом несколько клиентов не могут являться обладателями одного автомобиля. Взаимосвязь “один ко многим” можно обозначить с помощью одинарной стрелки в направлении к “одному” и двойной стрелки в направлении ко “многим” .В этом случае одной записи данных первого объекта (его часто называют родительским или основным) будет соответствовать несколько записей второго объекта (дочернего или подчиненного). Взаимосвязь “один ко многим” очень распространена при разработке реляционных баз данных.
Третий тип – связь МНОГИЕ-К-ОДНОМУ (М:1): одному представителю сущности B соответствуют 0, 1 или несколько представителей сущности А.
В принципе нет никакой разницы между связью ОДИН-КО-МНОГИМ и МНОГИЕ-К-ОДНОМ, т.к. между двумя сущностями возможны связи в обоих направлениях и всё зависит от того с какими сущностями связаны данные.
Четвёртый тип – связь МНОГИЕ-КО-МНОГИМ (N:М): одному представителю сущности B соответствуют 0, 1 или несколько представителей сущности А и одновременно одному представителю сущности А соответствуют 0, 1 или несколько представителей сущности В.
Это также обусловлено тем, что между двумя сущностями возможны связи в обоих направлениях.
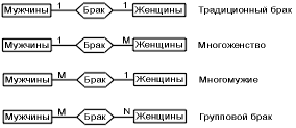 Если
связь между
сущностями
МУЖЧИНЫ и ЖЕНЩИНЫ
называется
БРАК, то существует
четыре возможных
представления
такой связи:
Или например каждый продавец может обслуживать нескольких клиентов. С другой стороны, приобретая автомобили в различное время, каждый клиент вполне может быть обслужен различными продавцами. Между объектами КЛИЕНТ и ПРОДАВЕЦ существует взаимосвязь “многие ко многим”. Такая взаимосвязь обозначается двойными стрелками.
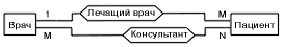 Характер
связей между
сущностями
не ограничивается
перечисленными.
Существуют
и более сложные
связи:
множество связей между одними и теми же сущностями
 (пациент,
имея одного
лечащего врача,
может иметь
также несколько
врачей-консультантов;
врач может быть
лечащим врачом
нескольких
пациентов и
может одновременно
консультировать
несколько
других пациентов);
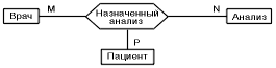
тренарные связи:
связи более высоких порядков, семантика (смысл) которых иногда очень сложна.
В приведенных примерах связей не показаны атрибуты сущностей и ассоциаций во всех ER-диаграммах. Так, ввод лишь нескольких основных атрибутов в описание брачных связей значительно усложнит ER-диаграмму (рис. 2.1,а). В связи с этим язык ER-диаграмм используется для построении небольших моделей и иллюстрации отдельных фрагментов больших. Чаще же применяется менее наглядный, но более содержательный язык инфологического моделирования (ЯИМ), в котором сущности и ассоциации представляются предложениями вида:
СУЩНОСТЬ (атрибут 1, атрибут 2 , ..., атрибут n)
АССОЦИАЦИЯ [СУЩНОСТЬ S1, СУЩНОСТЬ S2, ...]
(атрибут 1, атрибут 2, ..., атрибут n)
где S – степень связи, а атрибуты, входящие в ключ, должны быть отмечены с помощью подчеркивания.
Так, рассмотренный выше пример множества связей между сущностями, может быть описан на ЯИМ следующим образом:
Врач (Номер_врача, Фамилия, Имя, Отчество, Специальность)
Пациент (Регистрационный_номер, Номер койки, Фамилия,
Имя, Отчество, Адрес, Дата рождения, Пол)
Лечащий_врач [Врач 1, Пациент M]
(Номер_врача, Регистрационный_номер)
Консультант [Врач M,Пациент N]
(Номер_врача, Регистрационный_номер).
Для примера ER-диаграмма базы данных "Питание" показана на рис.16, а модель на языке ЯИМ имеет следующий вид:
Блюда (БЛ, Блюдо, Вид)
Продукты (ПР, Продукт, Калорийность)
Поставщики (ПОС, Город, Поставщик) [Город]
Состав [Блюда M, Продукты N] (БЛ, ПР, Вес (г))
Поставки [Поставщики M, Продукты N] (ПОС, ПР, Дата_П, Цена, Вес (кг))
Города (Город, Страна)
Рецепты (БЛ, Рецепт) {Блюда}
Расход (БЛ, Дата_Р, Порций) {Блюда}
 В
этих моделях
Блюдо, Продукт
и Поставщик
– наименования,
а БЛ, ПР и ПОС
– цифровые коды
блюд, продуктов
и организаций,
поставляющих
эти продукты.
Существует ещё наиболее распространенная модификация ER-диаграмм для представления инфологической модели баз данных - "Таблица-связь", пример использования которого приведен на рис. 16. В нем все сущности изображаются одностолбцовыми таблицами с заголовками, состоящими из имени и типа сущности. Строки таблицы – это перечень атрибутов сущности, а те из них, которые составляют первичный ключ, располагаются рядом и обводятся рамкой. Связи между сущностями указываются стрелками, направленными от первичных ключей или их составляющих. Именно этот тип диаграмм будет использоваться при построении инфологической модели базы данных, разрабатываемой в данной дипломной работе.
Даталогическая модель данных
Описание, создаваемое по инфологической модели данных, называют даталогической моделью данных. Даталогическая модель отражает логические связи между элементами данных вне зависимости от их содержания и среды хранения. Пользователям выделяются подмножества этой логической модели, называемые внешними моделями, отражающие их представления о предметной области. Внешняя модель соответствует представлениям, которые пользователи получают на основе логической модели, в то время как концептуальные требования отражают представления, которые пользователи первоначально желали иметь и которые легли в основу разработки инфологической модели. Даталогическая модель отображается в физическую память, такую, как диск, лента или какой-либо другой носитель информации. Даталогическая модель в основном используется прикладными программистами для реализации требований, которые выдвинули конечные пользователи, отражённых в инфологической концептуальной модели.
Типы даталогических моделей уже обсуждались нами ранее. Это есть не что иное, как Модели представления данных, т.о. даталогическая модель данных может быть реляционной, иерархической или сетевой.
При разработке даталогической модели, кроме требований предъявляемых для построения инфологической модели, предъявляются дополнительные требования:
Загруженные в базу данных корректные данные должны оставаться корректными.
Данные до включения в базу данных должны проверяться на достоверность.
Доступ к данным, размещаемым в базе данных, должны иметь только лица с соответствующими полномочиями.
Разрешение проблем, возникающих при одновременном запросе одних и тех же данных многими пользователями (прикладными программами);
Способы обеспечения защиты данных от некорректных обновлений и (или) несанкционированного доступа;
Если инфологическая модель данных предназначена для наглядного отражения представления пользователей, т.е. является человеко-ориентированной, то даталогическая модель уже является компьютеро-ориентированной. С её помощью СУБД дает возможность программам и пользователям осуществлять доступ к хранимым данным лишь по их именам, не заботясь о физическом расположении этих данных.
Переход от ER – модели к реляционной.
Переход от инфологической модели “сущность-связь”- это сравнительно простая задача, поскольку в терминологии и принципах ER-модели и реляционного подхода имеется взаимно однозначное соответствие. Существует ряд хорошо зарекомендовавших себя правил с пощью которых из ER-диаграмм отроются реляционные таблицы.
Каждая простая сущность превращается в таблицу. Простая сущность - сущность, не являющаяся подтипом и не имеющая подтипов. Имя сущности становится именем таблицы.
Каждый атрибут становится возможным столбцом с тем же именем; может выбираться более точный формат. Столбцы, соответствующие необязательным атрибутам, могут содержать неопределенные значения; столбцы, соответствующие обязательным атрибутам, - не могут.
Компоненты уникального идентификатора сущности превращаются в первичный ключ таблицы. Если имеется несколько возможных уникальных идентификатора, выбирается наиболее используемый. Если в состав уникального идентификатора входят связи, к числу столбцов первичного ключа добавляется копия уникального идентификатора сущности, находящейся на дальнем конце связи (этот процесс может продолжаться рекурсивно). Для именования этих столбцов используются имена концов связей и/или имена сущностей.
Связи многие-к-одному (и один-к-одному) становятся внешними ключами. Т.е. делается копия уникального идентификатора с конца связи "один", и соответствующие столбцы составляют внешний ключ. Необязательные связи соответствуют столбцам, допускающим неопределенные значения; обязательные связи - столбцам, не допускающим неопределенные значения.
Индексы создаются для первичного ключа (уникальный индекс), внешних ключей и тех атрибутов, на которых предполагается в основном базировать запросы.
Если в концептуальной схеме присутствовали подтипы, то возможны два способа: все подтипы в одной таблице (а) или для каждого подтипа - отдельная таблица (б). При применении способа (а) таблица создается для наиболее внешнего супертипа, а для подтипов могут создаваться представления. В таблицу добавляется, по крайней мере, один столбец, содержащий код ТИПА; он становится частью первичного ключа. При использовании метода (б) для каждого подтипа первого уровня (для более нижних - представления) супертип воссоздается с помощью представления UNION (из всех таблиц подтипов выбираются общие столбцы - столбцы супертипа).
Имеется два способа работы при наличии исключающих связей: общий столбец и явные внешние ключи (б). Если остающиеся внешние ключи все в одном домене, т.е. имеют общий формат (способ (а)), то создаются два столбца: идентификатор связи и идентификатор сущности. Столбец идентификатора связи используется для различения связей, покрываемых дугой исключения. Столбец идентификатора сущности используется для хранения значений уникального идентификатора сущности на дальнем конце соответствующей связи. Если результирующие внешние ключи не относятся к одному домену, то для каждой связи, покрываемой дугой исключения, создаются явные столбцы внешних ключей; все эти столбцы могут содержать неопределенные значения.
Физическая модель данных
Физическая модель данных – модель, определяющая размещение данных на внешних носителях, методы доступа и технику индексирования. Она так же называется внутренней моделью системы.
Внешние модели (даталогические модели) никак не связаны с типом физической памяти, в которой будут храниться данные, и с