Шини (Industrial Standard Architecture)
Шина, як відомо, представляє із себе, власне, набір проводів (ліній), що з'єднує різні компоненти комп'ютера для підведення до них живлення й обміну даними. У "мінімальній комплектації" шина має три типи ліній:
лінії керування;
лінії адресації;
лінії даних.
Пристрою, підключені до шини, поділяються на двох основних категорій - bus masters і bus slaves. Bus masters - це пристрою, здатні керувати роботою шини, т. ч. ініціювати запис/читання і т.д. Bus slaves - відповідно, пристрою, що можуть тільки відповідати на запити. Правда, є ще "інтелектуальні слуги" (intelligent slaves), але ми їх поки для ясності замнемо. Ну от, власне, і усе, що потрібно знати про шини для того, щоб зрозуміти, про що піде мова далі.
Компанія IBM у 1981 представила нову шину для використання в комп'ютерах серії PC/XT. Шина була вкрай проста по дизайні, містила 53 сигнальні лінії і 8 ліній харчування і являла собою синхронну 8-бітну шину з контролем парності і дворівневих переривань (trigger-edge interrupts), при використанні яких пристрою запитують переривання, змінюючи стан лінії відповідного IRQ з 0 на 1 або назад. Така організація запитів переривань дозволяє використовувати кожне переривання тільки одному пристроєві. Крім того, шина не підтримувала додаткових bus masters, і єдиними пристроями, що керують шиною, минулого процесор і контролер DMA на материнській платі.
62-контактний слот (див. таблицю 1) уключав 8 ліній даних, 20 ліній адреси (А0-А19), 6 ліній запиту переривань (IRQ2-IRQ7). Таким чином, обсяг пам'яті, що адресується, складав 1 Мбайт, і при частоті шини 4.77 Мгц пропускна здатність досягала 1.2 Мбайта/хв.
Забавно, що IBM не опублікувала повного опису шини з тимчасовими діаграмами сигналів на лініях даних і адреси, тому першим розроблювачам плат розширення довелося неабияк потрудитися.
Недоліки шини, що випливають із простоти конструкції, очевидні. Тому для використання в комп'ютерах IBM-AT ('Advanced Technology') у 1984 році була представлена нова версія шини, згодом названої ISA. Зберігаючи сумісність зі старими 8-бітними платами розширення, нова версія шини володіла поруч істотних переваг, як то:
додавання 8 ліній даних дозволило вести 16-бітний обмін даними;
додавання 4 ліній адреси дозволило збільшити максимальний розмір пам'яті, що адресується, до 16 МВ;
були додані 5 додаткових trigger-edged ліній IRQ;
була реалізована часткова підтримка додаткових bus masters;
частота шини була збільшена до 8 MHz;
пропускна здатність досягла 5.3 МВ/хв.
Реалізація bus mastering не була особливо вдалої, оскільки, наприклад, запит на звільнення шини ('Bus hang-off') до поточного bus master оброблявся кілька тактів, до того ж кожен master повинний був періодично звільняти шину, щоб дати можливість провести відновлення пам'яті (memory refresh), або сам проводити відновлення. Для забезпечення зворотної сумісності з 8-бітними платами більшість нових можливостей було реалізовано шляхом додавання нових ліній (див. таблицю 2). Тому що АТ був побудований на основі процесора Intel 80286, що був істотно швидше, ніж 8088, довелося додати генератор станів чекання (wait-state generator). Для обходу цього генератора використовується вільна лінія (контакт У8 NOWS-'No Wait State') вихідної 8-бітної шини. При установці цієї лінії в 0 такти чекання пропускаються. Використання в якості NOWS лінії вихідної шини дозволяло розроблювачам робити як 16-бітні, так і 8-бітні "швидкі" плати.
Таблиця 1. Призначення контактів рознімання 8-розрядної шини ISA
| Контакт | Назва сигналу | Контакт | Назва сигналу |
| B1 | Ground | A1 | I/O Channel Check |
| B2 | Reset Driver | A2 | Data7 |
| B3 | +5V | A3 | Data6 |
| B4 | IRQ2 | A4 | Data5 |
| B5 | -5V | A5 | Data4 |
| B6 | DMA Request 2 | A6 | Data3 |
| B7 | -12V | A7 | Data2 |
| B8 |
J8/NOWS1 |
A8 | Data1 |
| B9 | +12V | A9 | Data0 |
| B10 | Ground | A10 | I/O Channel Ready |
| B11 | Memory Write | A11 | Address Enable |
| B12 | Memory Read | A12 | Address19 |
| B13 | I/O Write | A13 | Address18 |
| B14 | I/O Read | A14 | Address17 |
| B15 | DMA Acknoledge3 | A15 | Address16 |
| B16 | DMA Request3 | A16 | Address15 |
| B17 | DMA Acknoledge1 | A17 | Address14 |
| B18 | DMA Request1 | A18 | Address13 |
| B19 | Refresh | A19 | Address12 |
| B20 | Clock | A20 | Address11 |
| B21 | IRQ7 | A21 | Address10 |
| B22 | IRQ6 | A22 | Address9 |
| B23 | IRQ5 | A23 | Address8 |
| B24 | IRQ4 | A24 | Address7 |
| B25 | IRQ3 | A25 | Address6 |
| B26 | DMA Acknoledge2 | A26 | Address5 |
| B27 | Terminal Count | A27 | Address4 |
| B28 | Address Latch Enable | A28 | Address3 |
| B29 | +5V | A29 | Address2 |
| B30 | Oscillator | A30 | Address1 |
| B31 | Ground | A31 | Address0 |
Новий слот містив 4 нових адресні лінії (LA20-LA23) і копії трьох молодших адресних ліній (LA17-LA19). Необхідність у такому дублюванні виникла через те, що адресні лінії ХТ були лініями з затримкою (latched lines), і ці затримки приводили до зниження швидкодії периферійних пристроїв. Використання дублюючого набору адресних ліній дозволяло 16-бітній карті на початку циклу визначити, що до неї звертаються, і послати сигнал про те, що вона може здійснювати 16-бітний обмін. Насправді, це ключовий момент у забезпеченні зворотної сумісності. Якщо процесор намагається здійснити 16-бітний доступ до плати, він зможе це зробити тільки в тому випадку, якщо одержить від неї відповідний відгук IO16. У противному випадку чипсет ініціює замість одного 16-бітного циклу два 8-бітних. І усі б було гарно, але адресних ліній без затримки лише 7, тому плати, що використовують діапазон адрес менший, чим 128Кбайт, не могли визначити, де знаходиться передана адреса в їхньому діапазоні адрес, і, відповідно, послати відгук IO16. Таким чином, багато плат, у тому числі плати EMS, не могли використовувати 16-бітний обмін
Таблиця 2. Призначення контактів рознімання 16-розрядної шини ISA
| Контакт | Назва сигналу | Контакт | Назва сигналу |
| B1 | Ground | A1 | I/O Channel Check |
| B2 | Reset Driver | A2 | Data7 |
| B3 | +5V | A3 | Data6 |
| B4 | IRQ2 | A4 | Data5 |
| B5 | -5V | A5 | Data4 |
| B6 | DMA Request 2 | A6 | Data3 |
| B7 | -12V | A7 | Data2 |
| B8 | No Wait States | A8 | Data1 |
| B9 | +12V | A9 | Data0 |
| B10 | Ground | A10 | I/O Channel Ready |
| B11 | Memory Write | A11 | Address Enable |
| B12 | Memory Read | A12 | Address19 |
| B13 | I/O Write | A13 | Address18 |
| B14 | I/O Read | A14 | Address17 |
| B15 | DMA Acknoledge3 | A15 | Address16 |
| B16 | DMA Request3 | A16 | Address15 |
| B17 | DMA Acknoledge1 | A17 | Address14 |
| B18 | DMA Request1 | A18 | Address13 |
| B19 | Refresh | A19 | Address12 |
| B20 | Clock | A20 | Address11 |
| B21 | IRQ7 | A21 | Address10 |
| B22 | IRQ6 | A22 | Address9 |
| B23 | IRQ5 | A23 | Address8 |
| B24 | IRQ4 | A24 | Address7 |
| B25 | IRQ3 | A25 | Address6 |
| B26 | DMA Acknoledge2 | A26 | Address5 |
| B27 | Terminal Count | A27 | Address4 |
| B28 | Address Latch Enable | A28 | Address3 |
| B29 | +5V | A29 | Address2 |
| B30 | Oscillator | A30 | Address1 |
| B31 | Ground | A31 | Address0 |
| Ключ | Ключ | ||
| D1 | Memory Access 16 bit | C1 | System Bus High |
| D2 | I/O 16 bit | C2 | Latch Address 23 |
| D3 | IRQ10 | C3 | Latch Address 22 |
| D4 | IRQ11 | C4 | Latch Address 21 |
| D5 | IRQ12 | C5 | Latch Address 20 |
| D6 | IRQ15 | C6 | Latch Address 19 |
| D7 | IRQ14 | C7 | Latch Address 18 |
| D8 | DMA Acknoledge0 | C8 | Latch Address 17 |
| D9 | DMA Request1 | C9 | Memory Read |
| D10 | DMA Acknoledge5 | C10 | Memory Write |
| D11 | DMA Request5 | C11 | Data8 |
| D12 | DMA Acknoledge6 | C12 | Data9 |
| D13 | DMA Request6 | C13 | Data10 |
| D14 | DMA Acknoledge7 | C14 | Data11 |
| D15 | DMA Request7 | C15 | Data12 |
| D16 | +5V | C16 | Data13 |
| D17 | Master 16 bit | C17 | Data14 |
| D18 | Ground | C18 | Data15 |
Незважаючи на відсутність офіційного стандарту і технічних "ізюминок" шина ISA перевершувала потреби середнього користувача зразка 1984 року, а "засилля" IBM AT на ринку масових комп'ютерів привело до того, що виробники плат розширення і клонів AT прийняли ISA за стандарт. Така популярність шини привела до того, що слоти ISA дотепер присутні на всіх системних платах, і плати ISA до цих виробляються. Правда, Microsoft у специфікації PC99 передбачає відмовлення від ISA, але, як говориться, до цього потрібно ще дожити.
Шина EISA (Extended Industry Standard Architecture)
Шина EISA з'явилася "асиметричною відповіддю" виробників клонів РС на спробу IBM поставити ринок під свій контроль. У вересні 1988 року Compaq, підтриманий "бандою дев'яти" - Wyse, AST Research, Tandy, власне Compaq, Hewlett-Packard, Zenith, Olivetti, NEC і Epson - представив 32-розрядне розширення шини ISA з повною зворотною сумісністю. Основні характеристики нової шини були наступними:
32-розрядна передача даних;
максимальна пропускна здатність - 33 МВ/хв;
32-розрядна адресація пам'яті дозволяла адресувати до 4 GB (як і в розширенні ISA, нові адресні лінії були без затримки);
підтримка multiply bus master;
можливість завдання рівня дворівневого (edge-triggered) переривання (що дозволяло декільком пристроям використовувати одне переривання, як і у випадку багаторівневого (level-triggered) переривання);
автонастрій плат розширення;
Як і у випадку 16-розрядного розширення, нові можливості забезпечувалися шляхом додавання нових ліній. Оскільки далі подовжувати рознімання ISA було нікуди, розроблювачі знайшли оригінальне рішення: нові контакти були розміщені між контактами шини ISA і не були доведені до краю рознімання. Спеціальна система виступів на розніманні і щілин у EISA-картах дозволяла їм глибше заходити в рознімання і приєднуватися до нових контактів. (Правда, затверджують, що при великому бажанні можна запхнути і ISA-карту так, щоб вона замкнула EISA-контакти. Не знаю, не пробував, тому що великого досвіду спілкування з EISA у мене немає: маленький був ще). Оскільки на даний момент шина EISA практично вимерла, приводити значення контактів рознімання не має змісту. Варто відзначити лише дві нових сигнальних лінії - EX32 і EX16, що визначали, що bus slave підтримує відповідно 32- і 16-розрядний цикл EISA. Якщо жоден з цих сигналів не був отриманий на початку циклу шини, виконувався цикл ISA.
Важливою особливістю шини була можливість для будь-якого bus master звертатися до будь-якого пристрою пам'яті або периферійному пристроєві, навіть якщо вони мали різні розряди шини. Говорячи про повну зворотну сумісність з ISA, слід зазначити, що ISA-карти, природно, не підтримували поділ переривань, навіть будучи вставленими в EISA-коннектор. Що стосується підтримки multiply bus master, те вона являла собою поліпшену і доповнену версію такої для ISA. Також були присутні чотири рівні пріоритету:
схеми відновлення пам'яті;
DMA;
процесор;
адаптери шини
і арбітр шини EISA - периферійний контролер (ISP - Integrated System Peripheral) - "стежив за порядком". Крім цього, було в наявності ще один пристрій - Intel's Bus Master Interface Chip (BMIC), що стежило за тим, щоб master "не засиджувався" на шині. Через визначену кількість тактів master "знімався" із шини і генерувалося немаскируемое переривання.
MCA проти EISA
Відразу ж після виходу шини EISA почалася "шинна війна", причому це була не стільки війна між архитектурами (вони обидві пішли в минуле), скільки війна за контроль IBM над ринком персональних комп'ютерів. І цю війну корпорація з тріском програла. Так, архітектура MCA по закладених технічних рішеннях і перспективам розвитку виглядала переважніше. Але, як не дивно, саме це виявилося другим фактором, що неї сгубил. Порівняльна характеристика шин EISA і MCA представлена у виді табл. 3.
Таблиця 3. Порівняльна характеристика шин EISA і MCA.
| MCA | EISA | |
| Пропускна здатність, МВ/хв | 20 | 33 |
| Спосіб передачі даних | асинхронний | Синхронний |
| Розмір карти (довжина х ширина), мм | 292.1 х 88.2 | 333.5 х 127.0 |
Площа поверхні карти EISA у 1.65 рази більше. А якщо ще врахувати, що адаптер EISA міг споживати більш ніж у 2 рази більше потужності, чим адаптер MCA, стає ясно, що робити периферію під EISA було і простіше і дешевше.
Крім того, у "шинній війні", як і скрізь, є присутнім "рука Intel". У прагненні звільнити ринок для нових процесорів 80386 і 80486, Intel випускав EISA-чипсети, що не підтримують 286 процесор (не чи правда, знайома ситуація), у той час, як шина MCA прекрасно працювала і на комп'ютерах з 286. Таким чином, перспективна розробка IBM так і залишилася перспективною розробкою, але і шина EISA не стала хітом: на той час, коли потреби комп'ютерів середнього рівня переросли можливості шини ISA, розроблювачі перейшли, минаючи EISA, до локальної шини.
Шина MCA (Micro Channel Architecture)
"До 1 квітня 1987 року життя у світі РС був украй простій: у байті було 8 біт, і при цьому існувала тільки одна шина, по якій ці біти можна було передавати. Звичайно, ця шина була "двох розмірів" - розрядністю 8 і 16 біт - але це була одна шина. Але наступного дня - 2 квітня - усі змінилося, і, здається, простота більше ніколи не повернеться."
Крис Лонг (Chris Long) PC User.
У 1987 році компанія IBM припинила випуск серії РС/АТ і початку виробництво лінії PS/2. Одним з головних відмінностей нового покоління персональних комп'ютерів була нова системна шина - Micro Channel Architecture (MCA). Ця шина не мала зворотну сумісність з ISA, але зате містила ряд передових для свого часу рішень:
8/16/32-розрядна передача даних;
20 МВ/хв пропускна здатність при частоті шини 10 MHz (у 4 рази більше,ніж у ISA!) при максимально можливій пропускній здатності шини 160 МВ/хв !!! (більше, ніж у PCI) (правда, не всі карти здатні працювати з такою швидкістю);
Підтримка декількох bus master. Будь-який пристрій, підключений до шини, може одержати право на її виняткове використання для передачі або прийому даних з іншого з'єднаного з нею пристрою. Такий пристрій, по суті, являє собою спеціалізований процесор, що може здійснювати обмін даними по шині незалежно від основного процесора. Роботу пристроїв координує пристрій, називаний арбітром шини (CACP - Central Arbitration Control Point). При розподілі функцій керування шиною арбітр виходить з рівня пріоритету, яким володіє той або інший пристрій або операція. Усього таких рівнів чотири (у порядку убування):
регенерація системної пам'яті;
прямий доступ до пам'яті (DMA);
плати адаптерів.
процесор.
Якщо пристроєві необхідний контроль над шиною, він сповіщає про це арбітрові. З першою нагодою (після обробки запитів з більш високими пріоритетами) арбітр передає йому керування шиною. Поза системою пріоритетів обслуговуються тільки немасковані переривання (NMI - non-maskable interrupts), при виникненні яких керування негайно передається процесорові;
11-рівневі переривання (11-level triggered interrupts) замість дворівневих (trigger-edged) у ISA дозволяли поділяти (share) переривання між пристроями, що дозволило вилікувати одну з хвороб перших PC - недостачу ліній IRQ;
24 або 32 адресні лінії дозволяли адресувати до 4 GB пам'яті;
автоматичне конфігурування пристроїв істотно спростило установку нових плат. У комп'ютерів із шиною MCA немає ніяких перемичок або перемикачів - ні на системній платі, ні на платах розширення. Замість використання адрес портів уведення-висновку, що зашиті у залізо, центральний процесор призначає них при старті системи, базуюся на інформації, ліченої з ROM карти;
асинхронний протокол передачі даних знижував імовірність виникнення конфліктів і перешкод між пристроями, підключеними до шини.
Не чи правда, непоганий набір для 1987 року? Можливо, весь розвиток персональних комп'ютерів пішло б по іншому шляху, якби не одне але - гроші. Справа в тім, що IBM, порахувавши своє лідируюче положення на ринку персональних комп'ютерів непорушним, запропонувало незалежним виробникам, що бажають використовувати шину МСА, зовсім кабальні умови, що включають вимогу заплатити за використання шини ISA в усіх раніше зроблених комп'ютерах!!! Як Ви самі розумієте, що бажають виявилося, м'яко скажемо, небагато. Із серйозних компаній тільки Apricot і Olivetti підтримали нову архітектуру (причому Olivetti брала активну участь у розробці конкуруючого стандарту - EISA). Більшість покупців систем PS/2 "купували IBM", а не МСА. У результаті величезна робота - було розроблено 6 типів слотів -
16-розрядні (основні слоти, що установлюється в усі комп'ютери із шиною МСА);
32-розрядні ( установлюються на комп'ютерах із шиною МСА і процесором 386DX і вище. Так само, як і в ISA, є тільки розширенням основного слоту, але, оскільки розроблялися одночасно із шиною, конструкція вийшла більш логічної);
16 і 32-розрядні з доповненнями для плат пам'яті (встановлюються в деяких комп'ютерах із шиною МСА, наприклад, PS/2 моделей 70 і 80, мають 8 додаткових контактів для роботи з платами розширення пам'яті, розташованих на самому початку рознімання, зверненому до задньої стінки комп'ютера, перед основними контактами);
16 і 32-розрядні з доповненнями для відеоадаптерів (призначені для збільшення швидкодії відеосистеми. Звичайно в комп'ютері із шиною МСА встановлений один такий слот. 10 додаткових контактів також розташовані на початку рознімання і дозволяють платі відеоадаптера одержати доступ до вбудованої у системну плату схемі VGA)
пропала фактично даром. На даний момент посилання на архітектуру МСА практично не зустрічаються навіть на сайті IBM (наскільки мені відомо, у даний час архітектура МСА використовується IBM тільки в RISC-системах, наприклад, сервер RS/6000 побудований на базі шини МСА з пропускною здатністю 160 МВ/хв), тому приводити таблиці значень контактів не буду.
Локальна шина (Local bus)
Всі описані раніше шини мають загальний недолік - порівняно низьку пропускну здатність. Це зв'язано з тим, що шини розроблялися в розрахунку на повільні процесори. Надалі швидкодія процесора зростала, а характеристики шин поліпшувалися в основному "екстенсивно", за рахунок додавання нових ліній. Перешкодою для підвищення частоти шини була величезна кількість випущених плат, що не могли працювати на великих швидкостях обміну (МСА це стосується в меншому ступені, але в силу вищевикладених причин ця архітектура не грала помітної ролі на ринку). У той же час на початку 90-х років у світі персональних комп'ютерів відбулися зміни, що зажадали різкого збільшення швидкості обміну з пристроями:
створення нового покоління процесорів типу Intel 80486, що працюють на частотах до 66 MHz;
збільшення ємності твердих дисків і створення більш швидких контролерів;
розробка й активне просування на ринок графічних інтерфейсів користувача (типу Windows або OS/2) привели до створення нових графічних адаптерів, що підтримують більш високий дозвіл і більша кількість квітів (VGA і SVGA).
Очевидним виходом з положення, що створилося, є наступний: здійснювати частина операцій обміну даними, що вимагають високих швидкостей, не через шину введення/висновку, а через шину процесора, приблизно так само, як підключається зовнішній кеш. Така конструкція одержала назву локальної шини (Local Bus). Малюнки 1 і 2наочно демонструють розходження між звичайною архітектурою й архітектурою з локальною шиною.
Локальна шина не заміняла собою колишні стандарти, а доповнювала них. Основними шинами в комп'ютері як і раніше залишалися ISA або EISA, але до них додавалися один або трохи слотів локальної шини. Спочатку ці слоти використовувалися майже винятково для установки відеоадаптерів, при цьому до 1992 року було розроблено трохи несумісних між собою варіантів локальних шин, виняткові права на які належали фірмам-виготовникам. Природно, така плутанина стримувала поширювання локальних шин, тому VESA (Video Electronic Standard Association) - асоціація, яка представляє більш 100 компаній – запропонувала в серпні 1992 року свою специфікацію локальної шини.
Локальна шина VESA (VL-bus)
Основні характеристики VL-bus такі.
Підтримка процесорів серій 80386 і 80486. Шина розроблена для використання в однопроцесорних системах, при цьому в специфікації передбачена можливість підтримки х86-несумісних процесорів за допомогою моста (bridge chip).
Максимальне число bus master - 3 (не включаючи контролер шини). При необхідності можлива установка декількох підсистем для підтримки більшого числа маstеrов.
Незважаючи на те, що споконвічно шина була розроблена для підтримки відеоконтролерів, можливі підтримка й інші пристрої (наприклад, контролерів твердого диска).
Стандарт допускає роботу шини на частоті до 66 MHz, однак електричні характеристики рознімання VL-bus обмежують неї до 50 MHz (це обмеження, природно, не відноситься до інтегрованого в материнську плату пристроям).
Двунаправлена (bi-directional) 32-розрядна шина даних підтримує і 16-розрядний обмін. У специфікацію закладена можливість 64-розрядного обміну.
Підтримка DMA забезпечується тільки для bus masters. Шина не підтримує спеціальних "ініціаторів" DMA.
Максимальна теоретична пропускна здатність шини - 160 МВ/хв (при частоті шини 50 MHz), стандартна - 107 МВ/хв при частоті 33 MHz.
Підтримується пакетний режим обміну (для материнських плат 80486, що підтримують цей режим). 5 ліній використовується для ідентифікації типу і швидкості процесора, сигнал Burst Last (BLAST#) використовується для активізації цього режиму. Для систем, що не підтримують цей режим, лінія встановлюється в 0.
Шина використовує 58-контактне рознімання МСА. Максимально підтримується 3 слоту (на деяких 50-мегагерцовых шинах можлива установка тільки 1 слоту).
Слот VL-bus встановлюється в лінію за слотами ISA/EISA/MCA, тому VL-платам доступні всі лінії цих шин.
Підтримується як інтегрований кеш процесора, так і кеш на материнській платі.
Напруга харчування - 5 В. Пристрою з рівнем вихідного сигналу 3.3 У підтримуються за умови, що вони можуть працювати з рівнем вхідного сигналу 5 В.
Шина VL-bus з'явилася величезним кроком вперед у порівнянні з ISA як по продуктивності, так і по дизайні. Одним з переваг шини було те, що вона дозволяла створювати карти, що працюють з існуючими чипсетами і не утримуючої великої кількості схем дорогої керуючої логіки. У результаті VL-карти виходили дешевше аналогічних EISA-карт. Однак і ця шина не була позбавлена недоліків, головними з яких були наступні.
Орієнтація на 486-ий процесор. VL-bus жорстко прив'язана до шини процесора 80486, що відрізняється від шин Pentium і Pentium Pro/Pentium II.
Обмежена швидкодія. Як уже було сказано, реальна частота VL-bus - не більше 50 MHz. Причому при використанні процесорів із множником частоти шина використовує основну частоту (так, для 486DX2-66 частота шини буде 33 MHz).
Схемотехнічні обмеження. До якості сигналів, переданих по шині процесора, пред'являються дуже тверді вимоги, дотриматися які можна тільки при визначених параметрах навантаження кожної лінії шини. На думку Intel, установка недостатньо акуратно розроблених VL-плат може привести не тільки до втрат даних і порушенням синхронізації, але і до ушкодження системи.
Обмеження кількості плат. Це обмеження випливає також з необхідності дотримання обмежень на навантаження кожної лінії.
Незважаючи на існуючі недоліки, VL-bus була безсумнівним лідером на ринку, тому що дозволяла усунути вузьке місце відразу в двох підсистемах - відеопідсистемі і підсистемі обміну з твердим диском. Однак лідерство було недовгим, оскільки корпорація Intel розробила свою новинку - шину PCI. На думку компанії, VL-bus базувалася на технологіях 11-літньої давнини і була усього лише "латочкою", компромісом між виробниками. Правда, VESA заявляла, що обидві шини можуть "уживатися" спільно в одній системі. Intel погоджувалася, що таке сусідство можливо, але задавала зустрічне убивче питання: "А навіщо?". Справедливості заради, треба сказати, що PCI дійсно була урятована від більшості недоліків, властивих VL-bus.
Шина PCI (Peripheral Component Interconnect bus)
Отже, переходимо до самого цікавого. Що ж знаходиться на сьогоднішній день усередині більшості наших комп'ютерів? Природно, шина PCI. Інше питання, чому саме ця шина. Спробуємо розібратися.
Отже, розробка шини PCI почалася навесні 1991 року як внутрішній проект корпорації Intel (Release 0.1). Фахівці компанії поставили перед собою ціль розробити недороге рішення, яке б дозволило цілком реалізувати можливості нового покоління процесорів 486/Pentium/P6 (от уже половина відповіді). Особливо підкреслювалося, що розробка проводилася "з нуля", а не була спробою установки нових "латок" на існуючі рішення. У результаті шина PCI з'явилася в червні 1992 року (R1.0). Розроблювачі Intel відмовилися від використання шини процесора і ввели ще одну "антресольну" (mezzanine) шину.
Завдяки такому рішенню шина вийшла, по-перше, процесоро-незалежною (на відміну від VLbus), а по-друге, могла працювати паралельно із шиною процесора, не звертаючи до неї за запитами. Наприклад, процесор працює собі з кешем або системною пам'яттю, а в цей час по мережі на вінчестер пишеться інформація. Просто здорово! Насправді ідилії, звичайно, не виходить, але завантаження шини процесора знижується здорово. Крім того, стандарт шини був оголошений відкритим і переданий PCI Special Interest Group, що продовжила роботу з удосконалювання шини (у даний час доступний R2.1), і в цьому, мабуть, друга половина відповіді на питання "чому PCI?"
Основні можливості шини наступні.
Синхронний 32-х або 64-х розрядний обмін даними (правда, наскільки мені відомо, 64-розрядна шина в даний час використовується тільки в Alpha-системах і серверах на базі процесорів Intel Xeon, але, у принципі, за нею майбутнє). При цьому для зменшення числа контактів (і вартості) використовується мультіплексірування, тобто адреса і дані передаються по тим самим лініях.
Підтримка 5V і 3.3V логіки. Рознімання для 5 і 3.3V плат розрізняються розташуванням ключів
Частота роботи шини 33MHz або 66MHz (у версії 2.1) дозволяє забезпечити широкий діапазон пропускних здібностей (з використанням пакетного режиму):
132 МВ/хв при 32-bit/33MHz;
264 MB/хв при 32-bit/66MHz;
264 MB/хв при 64-bit/33MHz;
528 МВ/хв при 64-bit/66MHz.
При цьому для роботи шини на частоті 66MHz необхідно, щоб усі периферійні пристрої працювали на цій частоті.
Повна підтримка multiply bus master (наприклад, кілька контролерів твердих дисків можуть одночасно працювати на шині).
Підтримка write-back і write-through кеша.
Автоматичне конфігуровання карт розширення при включенні харчування.
Специфікація шини дозволяє комбінувати до восьми функцій на одній карті (наприклад, відео + звук і т.д.).
Шина дозволяє встановлювати до 4 слотов розширення, однак можливе використання моста PCI-PCI для збільшення кількості карт розширення.
PCI-пристрої обладнані таймером, що використовується для визначення максимального проміжку часу, у плині якого пристрій може займати шину.
При розробці шини в її архітектуру були закладені передові технічні рішення, що дозволяють підвищити пропускну здатність.
Шина підтримує метод передачі даних, називаний "linear burst" (метод лінійних пакетів). Цей метод припускає, що пакет інформації зчитується (або записується) "одним шматком", тобто адреса автоматично збільшується для наступного байта. Природним образом при цьому збільшується швидкість передачі власне даних за рахунок зменшення числа переданих адрес.
Шина PCI є тією черепахою, на якій коштують слони, що підтримують "Землю" - архітектуру Microsoft/Intel Plug and Play (Pn) PC architecture. Специфікація шини PCI визначає три типи ресурсів: два звичайних (діапазони пам'яті і діапазон уведення/висновку, як них називає компанія Microsoft) і configuration space - "конфігураційний простір".
Конфігураційний простір складається з трьох регіонів:
заголовка, незалежного від пристрою (device-independent header region);
регіону, обумовленого типом пристрою (header-type region);
регіону, обумовленого користувачем (user-defined region).
У заголовку утримується інформація про виробника і тип пристрою - поле Class Code (мережний адаптер, контролер диска, мультімедіа і т.д.) і інша службова інформація.
Наступний регіон містить регістри діапазонів пам'яті і введення/висновку, що дозволяють динамічно виділяти пристроєві область системної пам'яті й адресного простору. У залежності від реалізації системи конфігурація пристроїв виробляється або BIOS (при виконанні POST - power-on self test), або програмно. Базовий регістр expansion ROM аналогічно дозволяє відображати ROM пристрою в системну пам'ять. Поле CIS (Card Information Structure) pointer використовується картами cardbus (PCMCIA R3.0). З Subsystem vendor/Subsystem ID усі зрозуміло, а останні 4 байти регіону використовуються для визначення переривання і часу запиту/володіння.
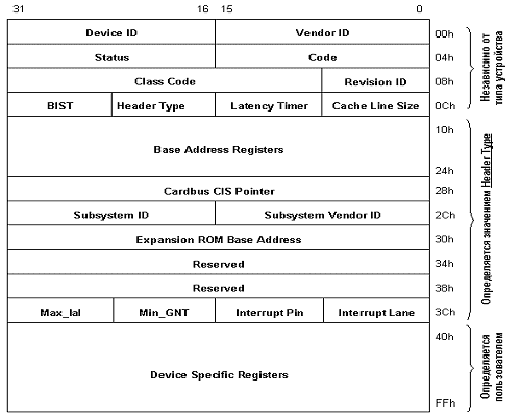
Малюнок 4. Конфігураційний простір.
Усе гарне коли-небудь кінчається. Кривдно - але істинно. Скільки писали про те, що шина PCI нарешті-те усунула