Информатика и программное обеспечение ПЭВМ
Когда говорят об автоматизированной работе с информацией посредством каких-либо технических устройств, обычно в первую очередь интересуются не содержанием сообщения, а количеством символов, которое содержит это сообщение.
1.4.2 Меры информации
Важным вопросом теории информации является установление меры количества и качества информации (рис. 1.1).
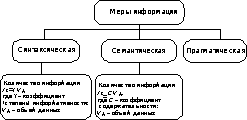
Рис. 1.1. Меры информации
Синтаксическая мера оперирует объемом данных и количеством информации Ia, выраженной через энтропию (понятие неопределенности состояния системы).
Семантическая мера оперирует количеством информации, выраженной через ее объем и степень содержательности.
Прагматическая мера определяется ее полезностью, выраженной через соответствующие экономические эффекты.
1.4.2.1 Синтаксическая мера информации
Эта мера количества информации оперирует с обезличенной информацией, не выражающей смыслового отношения к объекту.
На сегодняшний день наиболее известны следующие способы количественного измерения информации: объемный, энтропийный, алгоритмический.
Объемный является самым простым и грубым способом измерения информации. Соответствующую количественную оценку информации естественно назвать объемом информации.
Объем информации – это количество символов в сообщении. Поскольку одно и то же число может быть записано многими разными способами, т. е. с использованием разных алфавитов, например двадцать один – 21– XXI– 11001, то этот способ чувствителен к форме представления (записи) сообщения. В вычислительной технике вся обрабатываемая и хранимая информация вне зависимости от ее природы (число, текст, отображение) представлена в двоичной форме (с использованием алфавита, состоящего всего из двух символов "0" и "1").
В двоичной системе счисления единица измерения – бит (bit – binary digit – двоичный разряд).
В теории информации бит – количество информации, необходимое для различения двух равновероятных сообщений; а в вычислительной технике битом называют наименьшую "порцию" памяти, необходимую для хранения одного из двух знаков "0" и "1", используемых для внутримашинного представления данных и команд. Это слишком мелкая единица измерения, на практике чаще применяется более крупная единица – байт, – равная 8 бит, необходимых для того, чтобы закодировать любой из 256 символов алфавита клавиатуры компьютера (256 = 28).
Широко используются также еще более крупные производные единицы информации:
1 килобайт (кбайт) = 1024 байт = 210 байт;
1 Мегабайт (Мбайт) = 1024 кбайт = 220 байт;
1 Гигабайт (Гбайт) = 1024 Мбайт = 230 байт.
В последнее время в связи с увеличением объемов обрабатываемой информации входят в употребление следующие производные единицы:
1 Терабайт (Тбайт) = 1024 Гбайт = 240 байт;
1 Петабайт (Пбайт) = 1024 Тбайт = 250 байт.
В десятичной системе счисления единица измерения – дит (десятичный разряд).
Пример.
Сообщение в двоичной системе в виде восьмиразрядного двоичного кода 1011 1011 имеет объем данных VД = 8 бит.
Сообщение в десятичной системе в виде шестиразрядного числа 275 903 имеет объем данных VД = 6 бит.
В теории информации и кодирования принят энтропийный подход к измерению информации. Получение информации о какой-либо системе всегда связано с изменением степени неосведомлен-ности получателя о состоянии этой системы. Этот способ измерения исходит из следующей модели.
Пусть до получения информации потребитель имеет некоторые предварительные (априорные) сведения о системе α. После получения сообщения b получатель приобрел некоторую дополнительную информацию I(b), уменьшившую его неосведомленность. Эта информация в общем случае недостоверна и выражается вероятностями, с которыми он ожидает то или иное событие. Общая мера неопределенности (энтропия) характеризуется некоторой математической зависимостью от совокупности этих вероятностей. Количество информации в сообщении определяется тем, насколько уменьшится эта мера после получения сообщения.
Так, американский инженер Р. Хартли (1928 г.) процесс получения информации рассматривает как выбор одного сообщения из конечного наперед заданного множества из N равновероятных сообщений, а количество информации i, содержащееся в выбранном сообщении, определяет как двоичный логарифм N (формула Хартли):
 .
Допустим,
нужно угадать
одно число из
набора чисел
от единицы до
ста. По формуле
Хартли можно
вычислить,
какое количество
информации
для этого требуется:
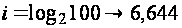 ,
т. е. сообщение
о верно угаданном
числе содержит
количество
информации,
приблизительно
равное 6,644 единицам
информации.
Другие примеры равновероятных сообщений:
при бросании монеты "выпала решка", "выпал орел";
на странице книги "количество букв четное", "количество букв нечетное".
Нельзя ответить однозначно на вопрос, являются ли равновероятными сообщения "первой выйдет из дверей здания женщина" и "первым выйдет из дверей здания мужчина". Все зависит от того, о каком именно здании идет речь. Если это, например, станция метро, то вероятность выйти из дверей первым одинакова для мужчины и женщины, а если это военная казарма, то для мужчины эта вероятность значительно выше, чем для женщины.
Для задач такого рода американский ученый Клод Шеннон предложил в 1948 г. другую формулу определения количества информации, учитывающую возможную неодинаковую вероятность сообщений в наборе (формула Шеннона):
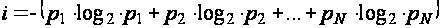 ,
где
 – вероятность
того, что именно
i-е сообщение
выделено в
наборе из N
сообщений.
Легко
заметить, что
если вероятности
 …
 равны, то каждая
из них равна
 и формула Шеннона
превращается
в формулу Хартли.
Помимо двух рассмотренных подходов к определению количества информации, существуют и другие. Важно помнить, что любые теоретические результаты применимы лишь к определенному кругу случаев, очерченному первоначальными допущениями.
В алгоритмической теории информации (раздел теории алгоритмов) предлагается алгоритмический метод оценки информации в сообщении. Любому сообщению можно приписать количественную характеристику, отражающую сложность (размер) программы, которая позволяет ее произвести.
Коэффициент (степень) информативности (лаконичности) сообщения определяется отношением количества информации к общему объему полученных данных:
 ,
причем 0 < Y < 1.
С увеличением Y уменьшаются объемы работ по преобразованию информации (данных) в системе. Поэтому необходимо стремиться к повышению информативности, для чего разрабатываются специальные методы оптимального кодирования информации.
1.4.2.2 Семантическая мера информации
Семантика – наука о смысле, содержании информации.
Для измерения смыслового содержания информации, т. е. ее количества на семантическом уровне, наибольшее признание получила тезаурусная мера, связывающая семантические свойства информации со способностью пользователя принимать поступившее сообщение. Одно и то же информационное сообщение (статья в газете, объявление, письмо, телеграмма, справка, рассказ, чертеж, радиопередача и т. п.) может содержать разное количество информации для разных людей в зависимости от их предшествующих знаний, уровня понимания этого сообщения и интереса к нему.
Для измерения количества семантической информации используется понятие "тезаурус пользователя", т. е. совокупность сведений, которыми располагает пользователь или система.
В зависимости от соотношений между смысловым содержанием информации S и тезаурусом пользователя Sp изменяется количество семантической информации Ic, воспринимаемой пользователем и включаемой им в дальнейшем в свой тезаурус. Характер такой зависимости показан на рисунке 1. 2.
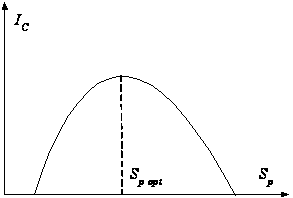
Рис. 1. 2. Зависимость количества семантической информации, воспринимаемой потребителем, от его тезауруса IC = f(Sp)
Рассмотрим два предельных случая, когда количество семантической информации IC равно 0:
при
 пользователь
не воспринимает,
не понимает
поступающую
информацию;
при
 пользователь
все знает и
поступающая
информация
ему не нужна.
Максимальное
количество
семантической
информации
 потребитель
приобретает
при согласовании
ее смыслового
содержания S
со своим тезаурусом
 (
 ),
когда поступающая
информация
понятна пользователю
и несет ему
ранее неизвестные
(отсутствующие
в его тезаурусе)
сведения.
Следовательно, количество семантической информации и новых знаний в сообщении, получаемое пользователем, является величиной относительной.
Относительной мерой количества семантической информации может служить коэффициент содержательности С, определяемый как отношение количества семантической информации к ее объему:
 .
1.4.2.3 Прагматическая мера информации
Эта мера определяет полезность информации (ценность) для достижения пользователем поставленной цели. Это величина относительная, обусловленная особенностями использования информации в той или иной системе. Ценность информации целесообразно измерять в тех же самых единицах (или близких к ним), в которых измеряется целевая функция.
Введенные меры информации представлены в таблице 1.3.
Таблица 1.3 Единицы измерения информации и примеры
| Мера информации | Единицы измерения | Примеры (для компьютерной области) |
|
Синтаксическая: шенноновский подход компьютерный подход |
Степень уменьшения неопределенности Единицы представления информации |
Вероятность события Бит, байт, кбайт и т. д. |
| Семантическая |
Тезаурус Экономические показатели |
Пакет прикладных программ, персональный компьютер, компьютерные сети и т. д. Рентабельность, производительность, коэффициент амортизации и т. д. |
| Прагматическая | Ценность использования |
Емкость памяти, производительность компьютера, скорость передачи данных и т. д.; денежное выражение; время обработки информации и принятия решений |
1.4.3 Качество информации
Получая какую-либо информацию, человек пытается ее осмыслить и оценить: Что в ней нового? Насколько она ему важна? Правдива ли она? Может возникнуть множество вопросов относительно полученной информации. Как же правильно ее оценить? Оказывается, любая информация должна обладать рядом свойств. Только определив, насколько ваша информация отвечает присущим ей свойствам, можно оценить ее качество. Качество информации – обобщенная положительная характеристика информации, отражающая степень ее полезности для пользователя.
Важнейшие свойства информации: достоверность, полнота, доступность, актуальность, защищенность, ценность, содержательность, своевременность, защищенность.
Одно из свойств информации – достоверность, означающая истинное, объективное отражение действительности. Как известно, каждый человек воспринимает окружающую действительность субъективно, имея свои собственные, отличные от других взгляд и мнение, поэтому передаваемая или получаемая человеком информация не может быть абсолютно объективна. Она лишь может быть максимально приближена к объективной, например прогноз погоды. Существуют различные источники получения информации о предстоящей погоде: собственные наблюдения, сводки погоды, составленные метеослужбами различных ведомств, городов, а также гидрометеорологическими службами целых регионов. Каждая из этих служб имеет свои средства наблюдения и составления прогнозов, учитывает какие-то показатели больше, какие-то меньше. У всех различная точность предсказания погоды.
Точность информации определяется степенью близости получаемой информации к реальному состоянию объекта, процесса, явления и т. п. Для информации, отображаемой цифровым кодом, известны четыре классификационных понятия точности:
формальная, измеряется значением единицы младшего разряда числа;
реальная, определяется значением единицы последнего разряда числа, верность которого гарантируется;
максимальная, ее можно получить в конкретных условиях функционирования системы;
необходимая, определяется функциональным назначением показателя.
Рассмотрим на примере прогноза погоды свойства информации. Получая сводку погоды, в одних случаях нас интересует температура и влажность воздуха, в других – осадки и направление ветра, в третьих, возможно, нам потребуется полная картина предстоящей погоды. Полнота информации означает, что она содержит минимальный, но достаточный для принятия правильного решения состав (набор) показателей. Как неполная, т. е. недостаточная для принятия правильного решения, так и избыточная информации снижают эффективность принимаемых пользователем решений.
Также важно, чтобы получаемая информация соответствовала данной ситуации. Например, можно получить полную сводку погоды из достоверного источника, но она окажется ненужной, если будет содержать сведения недельной давности. Иными словами, информация должна быть актуальной, что определяется степенью сохранения ценности информации для управления в момент ее использования и зависит от динамики изменения ее характеристик и интервала времени, прошедшего с момента возникновения данной информации.
Однако достоверная, полная и актуальная информация о погоде на предстоящую неделю может быть записана (или произнесена) в терминах и обозначениях синоптиков, непонятных большинству людей. В этом случае она окажется бесполезной. Значит информация должна быть выражена в таком виде, который был бы понятен получателю данной информации. В этом заключается следующее свойство информации – доступность, которая обеспечивается выполнением соответствующих процедур ее получения и преобразования.
Получая новую информацию, человек решает, нужна ли она для решения какой-то данной проблемы. Одна и та же информация может быть очень важной для одного и быть абсолютно бесполезной для другого. От того, какие задачи можно решить с помощью данной информации, зависит ее ценность. В зависимости от того, какой объем поступивших данных был переработан, определяется содержательность информации, которая отражает семантическую емкость.
С увеличением содержательности информации растет семантическая пропускная способность информационной системы, так как для получения одних и тех же сведений требуется преобразовать меньший объем данных. Одинаково нежелательны как преждевременная подача информации (когда она еще не может быть усвоена), так и ее задержка. Только своевременно полученная информация может принести ожидаемую пользу. Своевременность информации означает ее поступление в соответствии со временем решения поставленной задачи.
Защищенность – свойство, характеризующее невозможность несанкционированного использования или изменения.
1.5 Кодирование сигналов
1.5.1 Основные виды и способы обработки
и кодирования данных
Этап подготовки информации связан с процессом формирования структуры информационного потока. Такая структура должна обеспечивать возможность передачи информации от объекта к субъекту (от источника к потребителю) по каналам коммуникаций посредством определенных сигналов или знаков, а также возможность однозначного понимания этих сигналов и обеспечения их записи на соответствующие носители информации. Для этого осуществляется кодирование сигналов.
Кодирование информации – одна из базовых тем курса теоретических основ информатики, отражающая фундаментальную необходимость представления информации в какой-либо форме. При этом слово "кодирование" понимается не в узком смысле – как способ сделать сообщение непонятным для всех, кто не владеет ключом кода, а в широком – как представление информации в виде сообщения на любом языке. В канале связи сообщение, составленное из символов (букв) одного алфавита, может преобразоваться в сообщение из символов (букв) другого алфавита.
Код – правило (алгоритм), сопоставляющее каждое конкретное сообщение (информацию) со строго определенной комбинацией различных символов (или соответствующих им сигналов).
Кодирование – процесс преобразования сообщения (информации) в комбинацию различных символов или соответствующих им сигналов, осуществляющийся в момент поступления сообщения от источника в канал связи.
Кодовое слово – последовательность символов, которая в процессе кодирования присваивается каждому из множеств передаваемых сообщений.
Декодирование – процесс восстановления содержания сообщения по данному коду.
Необходимым условием декодирования является взаимно однозначное соответствие кодовых слов во вторичном алфавите кодируемым символам первичного алфавита.
Устройство, обеспечивающее кодирование, называют кодировщиком.
Система кодирования – совокупность правил кодового обозначения объектов – применяется для замены названия объекта на условное обозначение (код) в целях обеспечения удобной и более эффективной обработки информации, т. е. кодирование – это отображение информации с помощью некоторого языка. Любой язык состоит из алфавита, включающего в себя буквы, цифры и другие символы, и правил составления слов и фраз (синтаксических правил).
Первичный алфавит – символы, при помощи которых записано передаваемое сообщении; вторичный – символы, при помощи которых сообщение трансформируется в код.
Код характеризуется длиной (числом позиций в коде) и структурой (порядком расположения символов, используемых для обозначения классификационного признака).
Неравномерные (некомплектные) коды – это коды, с помощью которых сообщения кодируются комбинациями с неравномерным количеством символов; равномерные (комплектные) – коды, с помощью которых сообщения представлены комбинациями с равным количеством символов.
Для хранения в ЭВМ информация кодируется. При выборе языка создатели руководствовались следующими соображениями:
буквы алфавита должны надежно распознаваться (нельзя допустить, чтобы одна буква была принята за другую);
алфавит должен быть как можно проще, т. е. содержать поменьше букв;
синтаксис языка (правила построения слов и фраз) должен быть строгим, однозначным, не допускающим неопределенности.
Таким свойством обладают математические теории, в них все строго определено.
1.5.2 Кодирование текста
Не возникает никаких проблем при кодировании информации, представимой с помощью ограниченного набора символов – алфавита. Достаточно пронумеровать все знаки этого алфавита и затем записывать в память компьютера и обрабатывать соответствующие номера. Самым простым алфавитом является тот, в котором всего две буквы, два символа.
При кодировании текста для каждого его символа отводится обычно 1 байт. Именно по этой причине ячейка памяти в компьютере сделана так, что может хранить сразу восемь бит (1 байт), т. е. целый символ. Это позволяет использовать 28 = 256 различных символов, так как в ЭВМ надо кодировать все буквы: английские – 52 буквы (прописные и строчные), русские – 66 букв, 10 цифр, знаки препинания, арифметических операций и т. п.:
| Разрядность | Пример | Количество |
| 1 | 0 | 2 = 21 |
| 2 | 00 | 4 = 22 |
| 3 | 000 | 8 = 23 |
| 4 | 0000 | 16 = 24 |
Хорошо видно, что если у числа разрядность равна n, то количество n-разрядных чисел равно 2n:
| Разрядность | Количество чисел |
| 5 | 25 = 32 |
| 6 | 26 = 62 |
| 7 | 27 = 128 |
| 8 | 28 = 256 |
| 9 | 29 = 512 |
| 10 | 210 = 1024 |
и так далее.
Чтобы закодировать порядка 256 букв и символов, требуется использовать 8-разрядные числа.
Соответствие между символом и его кодом может быть выбрано совершенно произвольно. Однако на практике необходимо иметь возможность прочесть на одном компьютере текст, созданный на другом, поэтому таблицы кодировок стараются стандартизовать. Практически все использующиеся сейчас таблицы основаны на "американском стандартном коде обмена информацией" ASCII. Он определяет значения для нижней половины кодовой таблицы – первых 127 кодов (32 управляющих кода, основные знаки препинания и арифметические символы, цифры и латинские буквы). В результате, эти символы отображаются верно, какая бы кодировка не использовалась на конкретном компьютере. Хуже обстоит дело с национальными символами и типографскими знаками препинания. А особенно не повезло языкам, использующим кириллицу (русскому, украинскому, белорусскому, болгарскому и т. д.).
Например, для русского языка сейчас широко используются пять таблиц кодировок:
CP866 (альтернативная DOS) – на PC-совместимых компьютерах при работе с операционными системами DOS и OS/2, а также в любительской международной сети Фидо (Fidonet);
CP1251 (Windows-кодировка) – на PC-совместимых компью-терах при работе под Windows 3.1 и Windows 95;
KOI-8r – самая старая из использующихся до сих пор кодировок. Применяется на компьютерах, работающих под UNIX, является фактическим стандартом для русских текстов в сети Internet;
Macintosh Cyrillic – предназначена для работы со всеми кириллическими языками на Макинтошах.
ISO-8859. Эта кодировка задумывалась как международный стандарт для кириллицы, однако на территории России практически не применяется.
Сейчас, когда объем памяти компьютеров чрезвычайно вырос, уже нет необходимости очень сильно "экономить" при кодировании текста. Можно позволить себе роскошь "тратить" для хранения текста вдвое больше памяти (выделяя для каждого символа не 1, а 2 байт). При этом появляется возможность разместить в кодовой таблице – каждый на своем месте – не только буквы европейских алфавитов (латинского, кириллицы, греческого), но и буквы арабского, грузинского и многих других языков и даже большую часть японских и китайских иероглифов, поскольку два байта могут хранить число от 0 до 65 535. Двухбайтная международная кодировка Unicode, разработанная несколько лет назад, теперь начинает внедряться на практике. В компьютере все составные части соединяются между собой с помощью шины (магистрали), т. е. пучка проводов.
Теперь нам должно стать понятно, почему шина содержит 8, 16 или 32 провода. Если в шине 8 проводов, то по ней можно передать одновременно 8 бит, т. е. 1 байт (1 символ) информации. Такой компьютер называется восьмиразрядным, (первые персональные компьютеры IBM).
Если в шине 16 проводов, то по ней можно передать одновременно 2 байт информации; если 32 провода – 4 байт, если 64 провода – 8 байт.
1.5.3. Два способа кодирования изображения
Изображение на экране компьютера (или при печати с по-мощью принтера) составляется из маленьких точек – пикселов. Их так много, и они настолько малы, что человеческий глаз воспринимает картинку как непрерывную. Следовательно, качество изображения будет тем выше, чем плотнее расположены пиксели (т. е. чем больше разрешение устройства вывода) и точнее закодирован цвет каждого из них.
В простейшем случае каждый пиксел может быть или черным, или белым. Значит, для его кодирования достаточно одного бита. Однако при этом полутона приходится имитировать, чередуя черные и белые пиксели (заметим, что примерно так формируют полутоновое изображение на принтерах и при типографской печати). Чтобы получить реальные полутона, для хранения каждого пикселя нужно отводить большее количество разрядов. В этом случае черный цвет по-прежнему будет представлен нулем, а белый – максимально возможным числом. Например, при восьмибитном кодировании получится 256 разных значений яркости – 256 полутонов.
Сложнее обстоит дело с цветными изображениями, так как здесь нужно закодировать не только яркость, но и оттенок пикселя. Изображение на мониторе формируется путем сложения в различных пропорциях трех основных цветов: красного, зеленого и синего. Значит просто нам нужно хранить информацию о яркости каждой из этих составляющих.
Для получения наивысшей точности цветопередачи достаточно иметь по 256 значений для каждого из основных цветов (вместе это дает 2563 – более 16 млн. оттенков). Во многих случаях можно обойтись несколько меньшей точностью цветопередачи. Если использовать для представления каждой составляющей по 5 бит (тогда для хранения данных пикселя будет нужно не 3, а 2 байт), удастся закодировать 32 768 оттенков.
На практике встречаются (и нередко) ситуации, когда гораздо важнее не идеальная точность, а минимальный размер файла: бывают изображения, где изначально используется небольшое количество цветов. В этих случаях поступают так: собирают все нужные оттенки в таблицу и нумеруют, после чего хранят уже не полный код цвета каждого пикселя, а номера (индексы) цветов в таблице. Чаще всего используют 256-цветные таблицы. В разных компьютерах могут быть приняты разные стандартные таблицы цветов, поэтому не исключено, что открыв полученный от кого-нибудь графический файл, можно увидеть совершенно немыслимую картинку.
При печати на бумаге используется несколько иная цветовая модель: если монитор испускает свет, то оттенок получается в результате сложения цветов, а краски поглощают свет – цвета вычитаются. Поэтому в качестве основных используют голубую, сиреневую и желтую краски. Кроме того, из-за неидеальности красителей к ним обычно добавляют четвертую краску – черную. Для хранения информации о каждой краске чаще всего используют 1 байт.
Растровые изображения очень хорошо передают реальные образы. Они замечательно подходят для фотографий, картин и в случаях, когда требуется максимальная "естественность". Такие изображения легко выводить на монитор или принтер, поскольку эти устройства тоже основаны на растровом принципе. Однако есть у них и ряд недостатков. Растровое изображение высокого качества (с высоким разрешением и большой глубиной цвета) может занимать десятки, и даже сотни мегабайт памяти. Для их обработки нужны мощные компьютеры, но и они нередко "задумываются" на десятки минут. Любое изменение размеров неизбежно приводит к ухудшению качества: при увеличении пикселы не могут появиться "из ничего", при уменьшении – часть пикселов будет просто выброшена.
Есть другой способ представления изображений – объектная (векторная) графика. В этом случае в памяти хранится не сам рисунок, а правила его построения, т. е., например, не все пикселы круга, а команда "построить круг радиусом 30 с центром в точке с координатами (50, 135) и закрасить его красным цветом". Быстродействия современных компьютеров вполне достаточно, чтобы перерисовка происходила почти мгновенно.
На первый взгляд, все становится гораздо более сложным. Зачем же это нужно? Во-первых, и это самое главное, векторное изображение можно как угодно масштабировать, выводить на устройства, имеющие любое разрешение, – и всегда будет получаться результат с наивысшим для данного устройства качеством, ведь картинка каждый раз "рисуется" заново, используя столько пикселов, сколько возможно.
Во-вторых, в векторном изображении все части (так называемые "примитивы") могут быть изменены независимо друг от друга: любой из них можно увеличить, повернуть, деформировать, перекрасить, даже стереть, но остальных объектов это никоим образом не коснется.
В-третьих, даже очень сложные векторные рисунки, содержащие тысячи объектов, редко занимают более нескольких сотен килобайт, т. е. в десятки, сотни, а то и тысячи раз меньше аналогичного растрового.
Но почему, если все так хорошо, векторная графика не вытеснила растровую? Сам принцип ее формирования предполагает использование объектов с исключительно ровными четкими границами, а это сразу выдает их искусственность, поэтому область применения векторной графики довольно ограничена – это чертежи, схемы, стилизованные рисунки, эмблемы и другие подобные изображения.
1.5 Кодирование звука
Если преобразовать звук в электрический сигнал, например с помощью микрофона, можно увидеть плавно изменяющееся с течением времени напряжение. Для компьютерной обработки такой аналоговый сигнал нужно каким-то образом преобразовать в последовательность двоичных чисел. Если измерять напряжение через равные промежутки времени и записывать полученные значения в память компьютера, то этот процесс называется дискретизацией (оцифровкой), а устройство, выполняющее его, – аналого-цифровым преобразователем (АЦП).
Чтобы воспроизвести закодированный таким образом звук, нужно выполнить обратное преобразование, для чего служит цифро-аналоговый преобразователь (ЦАП), а затем сгладить получившийся ступенчатый сигнал.
Чем выше частота дискретизации (количество отсчетов за секунду) и больше разрядов отводится для каждого отсчета, тем точнее будет представлен звук. Размер звукового файла увеличивается, поэтому в зависимости от характера звука, требований, предъявляемых к его качеству и объему занимаемой памяти, выбирают некоторые компромиссные значения. Например, при записи на компакт-диски используются 16-битные отсчеты при частоте дискретизации 44 032 Гц. При работе только с речевыми сигналами достаточно 8-битных отсчетов при частоте 8 кГц.
Описанный способ кодирования звуковой информации универсален, он позволяет представить любой звук, преобразовывать его самыми разными способами. Бывают случаи, когда выгодней действовать по-иному. Человек издавна использует довольно компактный способ представления музыки – нотную запись. Чтобы перевести символьную информацию в понятную компьютеру форму, достаточно иметь таблицу соответствий символов этого языка их двоичным кодам.
В 1983 г. ведущие производители компьютеров и музыкальных синтезаторов разработали стандарт, определивший такую систему кодов, – MIDI.
Конечно, такая система кодирования позволяет записать далеко не всякий звук, она годится только для инструментальной музыки. Но есть у нее и неоспоримые преимущества: чрезвычайно компактная запись, естественность для музыканта (практически любой MIDI–редактор позволяет работать с музыкой в виде обычных нот), легкость замены инструментов, изменения темпа и тональности мелодии. Коме того, качество звучания зависит от возможностей синтезатора или звуковой платы компьютера, с помощью которых производится запись.
Заметим, что существуют и другие компьютерные форматы записи музыки, основанные на подобном же принципе.
1.5.5 Цифровое кодирование
При цифровом кодировании дискретной информации применяют потенциальные и импульсные коды.
В потенциальных кодах для представления логических единиц и нулей используется только значение потенциала, а его перепады, формирующие законченные импульсы, во внимание не принимаются. Импульсные коды позволяют представить двоичные данные либо импульсами определенной полярности, либо частью импульса – перепадом потенциала определенного направления.
При использовании прямоугольных импульсов для передачи дискретной информации необходимо выбрать такой способ кодирования, который одновременно достигал бы нескольких целей:
имел при одной и той же битовой скорости наименьшую ширину спектра результирующего сигнала;
обеспечивал синхронизацию между передатчиком и приемником;
обладал способностью распознавать ошибки;
обладал низкой стоимостью реализации.
Более узкий спектр сигналов позволяет на одной и той же линии добиваться более высокой скорости передачи данных. Кроме того, часто к спектру сигнала предъявляется требование отсутствия постоянной составляющей, т. е. наличия постоянного тока между передатчиком и приемником.
Синхронизация передатчика и приемника нужна для того, чтобы приемник точно знал, в какой момент времени необходимо считывать новую информацию с линии связи, поэтому в сетях применяются самосинхронизирующиеся коды, сигналы которых несут для передатчика указание о том, в какой момент времени нужно осуществлять распознавание очередного бита или нескольких бит, если