Лекции по теории проектирования баз данных (БД)
Лекция 1
Технология проектирования баз данных
Вопросы:
Проектирование базы данных как элемент информационной технологии;
Теоретические основы проектирования БД;
Синтез БД.
Проектирование базы данных как элемент информационной технологии
Как видно из материалов предыдущих лекций основу большинства информационных технологий составляют большие массивы накопленной информации. Основной формой организации хранения данных в информационных системах являются базы данных. В курсе “Автоматизированные системы обработки учетной информации” мы рассмотрели основные понятия, связанные с моделями данных, теоретические основы разработки простейших баз данных и жизненный цикл баз данных. Теперь, рассматривая БД как часть информационной технологии, необходимо по новому взглянуть на проблему проектирования базы.
Проблемы проектирования связаны с функциями БД в программно - технологической среде, поддерживающей информационные технологии. В общем случае место БД можно отразить следующей схемой:
П


 риложения
поддержки
информационных
технологий
Прочие
приложения
Поскольку база данных является связующим звеном между пользовательскими приложениями и аппаратными средствами, ее проектирование можно разделить на два направления: проектирование структуры и пользовательских приложений и распределение данных по аппаратным средствам (в случае баз данных на сетях). В данном разделе мы рассмотрим вопросы проектирования структуры базы данных. В дисциплине АСОЭИ, рассматривая основы реляционной алгебры и разработки реляционных моделей, мы коснулись вопросов проектирования реляционных баз данных. Одной из распространенных технологий разработки БД является следующая:
сбор данных о предметной области;
анализ представлений пользователей;
интеграция представлений пользователей;
разработка сетевой модели;
преобразование сетевой модели в первую нормальную форму реляционной модели;
нормализация отношений путем преобразования их к третьей нормальной форме.
В результате получается модель реляционной базы данных, которая представляет собой совокупность взаимосвязанных отношений.
Построение сетевой модели связано скорее с потребностью разработчика графически представить взаимосвязь данных, полученных в результате интеграции представлений пользователей. Преобразование сетевой модели в реляционную дает первую нормальную форму последней. Напомним, что отношение R находится в первой нормальной форме, если значения в dom(A) являются атомарными для каждого атрибута А в R . Вторая и третья нормальные формы позволяют избежать аномалий при обновлении данных и избавится от информационной избыточности в отношениях. Напомним, что отношение R нормальной форме, если оно находится в первой нормальной форме и каждый атрибут не являющийся ключом полностью зависит от любого ключа в R. И отношение R находится в третьей нормальной форме, если оно находится во 2НФ и каждый атрибут, не являющийся первичным ключом не транзитивно зависит от любого возможного ключа.
Недостатком такого подхода является то, что в моделях, имеющих десятки и сотни атрибутов очень трудно имперически построить модель, все отношения которой заданы в третьей нормальной форме и связаны между собой таким образом, что составляют единое целое.
Пример.
А В С
D F G H
G V M N






B M T X



Другим подходом является возможность формального синтеза модели на основании априорно установленных зависимостей между атрибутами. Зависимости между атрибутами устанавливаются на основании смысловой связи.
Пример.
НОМЕР_ЗАЧЕТКИ - ИМЯ_СТУДЕНТА
НОМЕР_РЕЙСА - ДАТА_ВЫЛЕТА
Безусловно такой подход к разработке модели базы данных предпочтительнее, так как позволяет автоматизировать процесс моделирования. Для реализации этого подхода необходимо расширение теоретической базы, полученной в курсе АСОЭИ.
Теоретические основы проектирования БД.
Основные понятия.
Поскольку рассматриваемый подход к разработке реляционной модели базируется на формальной логике, то в его основе должны лежать некоторые фундаментальные формализации. В теории реляционных баз данных к ним относятся понятия атрибута, отношения, ключа и функциональной зависимости.
Атрибутом
будем называть
поименованное
свойство объекта
и обозначать
Аi , где
 .
Домен атрибута
Аi обозначим
dom(Аi). Тогда
отношением
R называется
конечное множество
атрибутов
 .
Ключ отношения
R является
подмножеством
К =
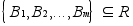 со следующим
свойством. Для
любых двух
различных
кортежей t1 и
t2 в R существует
такое
 ,
что t1(B)
 t2(B).
Другими словами
, не существует
двух кортежей,
имеющих одно
и то же значение
на всех атрибутах
из К . Таким образом,
достаточно
знать К - значение
кортежа, чтобы
идентифицировать
кортеж однозначно.
Пример.
СТУДЕНТ[НОМЕР_ЗАЧЕТКИ,ИМЯ,КУРС,ГРУППА]
Ключи, явно указанные в модели называются выделенными. Могут быть ключи отличные от выделенных и называемые неявными ключами. Например ИМЯ в предыдущем прмере.
Под функциональной зависимостью атрибутов или F-зависимостью понимают такую связь между атрибутами, когда значения кортежа на одном множестве атрибутов единственным образом определяют эти значения на другом множестве атрибутов. Так в отношении:
ГРАФИК[ПИЛОТ,РЕЙС,ДАТА,ВРЕМЯ]
ПИЛОТ функционально зависит от {РЕЙС,ДАТА}
F-зависимости принято обозначать {РЕЙС,ДАТА}-> ПИЛОТ и говорят, что РЕЙС и ДАТА функционально определяют ПИЛОТ.
В терминах теории множеств и реляционной алгебры F-зависимость определяется так. Пусть R отношение и X, Y подмножества атрибутов в R. Отношение R удовлетворяет функциональной зависимости X -> Y, если Y(X-x®) имеет не более чем один кортеж для каждого Х - значения х. В F-зависимости X->Y подмножество X называется левой частью, а Y - правой частью.
Лекция 2
Такая интерпретация функциональной зависимости является основой алгоритма SATISFIES, приводимого ниже.
SATISFIES
Вход: Отншение R и F-зависимость X->Y.
Выход: истина, если R удовлетворяет X->Y, ложь - в противном случае.
SATISFIES(R,X->Y)
Отсортировать отношение R по Х-столбцам так, чтобы собрать кортежи с равными Х-значениями вмести.
Если каждая совокупность кортежей с равными Х-значениями имеет также равные Y-значения, то на выходе получаем истину, а в противном случае - ложь.
Этот алгоритм проверяет, удовлетворяет ли отношение R F-зависимости X -> Y.
Пример.
В результате выполнения алгоритма SATISFIES выясним удовлетворяет ли F-зависимость РЕЙС -> ВРЕМЯ_ВЫЛЕТА следующему отношению
ГРАФИК
| ПИЛОТ | РЕЙС | ДАТА | ВРЕМЯ_ВЫЛЕТА |
| А... | 83 | 9 авг | 10:15 |
| П... | 83 | 11 авг | 10:15 |
| А... | 116 | 10 авг | 13:25 |
| Р... | 116 | 12 авг | 13:25 |
| П... | 281 | 8 авг | 5:50 |
| С... | 281 | 9 авг | 5:50 |
| П... | 301 | 12 авг | 18:35 |
| С... | 412 | 15 авг | 13:25 |
Однако F-зависимость ВРЕМЯ_ВЫЛЕТА -> РЕЙС согласно этому алгоритму не выполняется для этого отношения
ГРАФИК
| ПИЛОТ | РЕЙС | ДАТА | ВРЕМЯ_ВЫЛЕТА |
| П... | 281 | 8 авг | 5:50 |
| С... | 281 | 9 авг | 5:50 |
| А... | 83 | 9 авг | 10:15 |
| П... | 83 | 11 авг | 10:15 |
| А... | 116 | 10 авг | 13:25 |
| Р... | 116 | 12 авг | 13:25 |
| С... | 412 | 15 авг | 13:25 |
| П... | 301 | 12 авг | 18:35 |
Д ля
разработки
модели базы
данных необходимо
знать полное
множество
F-зависимостей.
Чтобы найти
их, необходимы
семантические
знания об исходном
отношении R.
Поэтому можно
считать семейство
F-завсимостей
заданным. Обозначим
его F. Однако
при таком подходе
нельзя быть
уверенным, что
найдены все
F-зависимости
отношения R.
Для того, чтобы
найти все
F-зависимости,
если известны
некоторые из
них, можно
воспользоваться
аксиомами
вывода. Возможность
получения новых
F-зависимостей
с помощью аксиом
вывода базируется
на следующем
правиле. Мнжество
F-зависимостей
F влечет за собой
F-зависимость
X -> Y (обозначение:
F =
 X
-> Y ), если каждое
отношение
удовлетворяющее
всем зависимостям
в F, удовлетворяет
также зависимости
X -> Y. Аксиома вывода
- это правило,
устанавливающее,
что если отношение
удовлетворяет
определенным
F-зависимостям,
то оно должно
удовлетворять
и некоторым
другим F-зависимостям.
Существует
шесть аксиом
вывода:
Рефлексивность: X -> X.
Пополнение: X -> Y влечет за собой XZ -> y.
Аддитивность: X -> Y и X -> Z влечет за собой X -> YZ.
Проективность: X -> YZ влечет за собой X -> Z.
Транзитивность: X -> Y и Y -> Z влечет за собой X -> Z.
Псевдотранзитивность: X -> Y и YZ -> W влечет за собой XZ -> W.
Пример.
Пусть дано отношение R , а X , Y и Z подмножества R . Предположим, что отношению удовлетворяет XY -> Z и X -> Y . Согласно аксиоме псевдотранзитивности получим XX -> Z или X -> Z.
Если даны аксиомы рефлексивности, пополнения и псевдотранзитивности, то из них можно вывести все остальные. Иногда их называют аксиомами Армстронга.
Пусть F-множество F-зависимостей для отношения R . Замыкание F , обозначаемое F+ , - это наименьшее содержащее F множество, такое что при применении к нему аксиом Армстронга нельзя получить ни одной F - зависимости, не принадлежащей F.
Пример.
Пусть F = {AB -> C, C -> B } - множество F-зависимостей на R(ABC). F+ = {A -> A, AB -> A, AC -> A, ABC -> A, B -> B, AB -> B, BC -> B, ABC -> B, C -> C, AC -> C, BC -> C, ABC -> C, AB -> AB, ABC -> AB, AC -> AC, ABC -> AC, BC -> BC, ABC -> BC, ABC -> ABC, AB -> C, AB -> AC, AB -> BC, AB -> ABC, C -> B, C -> BC, AC -> B, AC -> AB}
Т аким
образом, если
известно множество
F-зависимостей
удовлетворяющих
отношению R,
можно найти
все F- зависимости,
удовлетворяющие
этому отношению.
Говорят, что
F = X -> Y ,если X -> Y
 F+ .
Лекция 3
П олучение
замыкания F+
не обязательно
для установления
F = X -> Y.
Для этого достаточно воспользоваться алгоритмом MEMBER .
Алгоритм MEMBER.
Вход: Множество F-зависимостей F и F-зависимость X -> Y.
Выход:
истина, если
F = F = X -> Y, ложь в противном
случае.
MEMBER(F, X -> Y)
begin
if Y
CLOSURE(X,F) then return (истина)
else return(ложь)
end
Здесь CLOSURE алгоритм, позволяющий выявить список атрибутов входящих в множество F, который имеет вид.
Алгоритм CLOSURE.
Вход: Множество атрибутов Х и множество F-зависимостей F.
Выход: Замыкание Х над F.
CLOSURE(X,F)
begin
OLDDEP = 0; NEWDEP = X
while
NEWDEP
OLDDEP do begin
OLDDEP = NEWDEP
for каждая F- зависимость W -> Z в F do
if
NEWDEP
 W then
NEWDEP
= NEWDEP
 Z
end
return(NEWDEP)
end
Пример работы алгоритма MEMBER
Пусть F = {НОМЕР_РЕЙСА ДАТА_ВЫЛЕТА -> КОЛИЧЕСТВО_МЕСТ,
НОМЕР_РЕЙСА -> ПУНКТ_ОТПРАВЛЕНИЯ, НОМЕР_РЕЙСА ДАТА_ВЫЛЕТА -> ПИЛОТ} и необходимо установить F |= НОМЕР_РЕЙСА -> ПИЛОТ
Используем для этого алгоритм MEMBER
Покрытия функциональных зависимостей
Для формирования БД, как системы взаимосвязанных отношений на основании известных (из семантических соображений) F-зависимостей необходимо иметь способ минимизации первоначального множества F-зависимостей. Это необходимо для минимизации дублирования данных, обеспечения их согласованности и целостности. Теоретической основой для построения такого способа является теория покрытий функциональных зависимостей.
Определение.
Два
множества
F-зависимостей
F и G над отношением
R эквивалентны,
 , если F+ = G+ . Если
,
то F есть покрытие
для G. Предполагается,
что имеет смысл
рассматривать
в качестве
покрытий такие
множества F,
которые не
превосходят
множество G по
числу F-зависимостей.
Из этого определения следует, что для установления факта, что множество функциональных зависимостей F является покрытием G , необходимо определить эквивалентность F и G. Практически это достигается путем использования следующего алгоритма:
Алгоритм EQUIV
Вход: два множества F- зависимостей F и G.
Выход: истина,
если
;
ложь в противном
случае.
EQUIV(F,G)
begin
v=DERIVES(F,G) and DERIVES(G,F);
return(v)
end
Здесь DERIVES алгоритм проверяет условие F |= G и имеет вид:
Алгоритм DERIVES
Вход: два множества F- зависимостей F и G.
Выход: истина, если F |= G; ложь в противном случае.
DERIVES(F,G)
begin
v= истина
for каждая F-зависимость X -> Y из G do
v = v and MEMBER(F, X -> Y)
end
return(v)
end
Множество
F-зависимостей
F не избыточно,
если у него нет
такого собственного
подмножества
F’ , что F’ F
. Если такое
множество F’
существует,
то F избыточно.
F является не
избыточным
покрытием G,
если F есть покрытие
G и F не избыточно.
Пример. Пусть G = { AB -> C, A -> B, B -> C, A -> C}. Множество F= {AB -> C, A -> B, B -> C} эквивалентно G, но избыточно, потому что F’ = {A -> B, B -> C} также является покрытием G. Множество F’ представляет собой не избыточное покрытие G.
Действительно,
согласно алгоритму
EQUIV
, так как DERIVES(F,G) дает
истину и DERIVES(G,F) так
же истина. То
же самое можно
сказать относительно
F’ и G.
(Подробнее)
Множество F не избыточно, если в нем не существует F-зависимости X -> Y, такой, что F - { X -> Y} |= X -> Y . Назовем F-зависимость из F избыточной в F , если F - { X -> Y} |= X -> Y.
Для любого множества F-зависимостей G существует некоторое подмножество F, такое, что F является не избыточным покрытием G. Если G не избыточно, то F=G. Для определения не избыточного покрытия множества F- зависимостей G существует алгоритм NONREDUN, который имеет вид:
Вход: множество F-зависимостей G.
Выход: не избыточное покрытие G.
NONREDUN(G)
begin
F=G
for каждая зависимость X -> Y из G do
if MEMBER(F-{X->Y],X->Y) then F=F-{X->Y}
end
return(F)
end
Пример: Пусть G= {A -> B, B -> A, B -> C, A -> C}.
Результатом работы алгоритма является множество:
{A -> B, B -> A, A -> C}.
Если бы G было представлено в порядке {A -> B, A -> C, B -> A , B -> C} , то результатом работы алгоритма было бы
{A -> B, B -> A, B -> C}.
Из примера видно, что множество F-зависимостей G может иметь более одного неизбыточного покрытия. Могут так же существовать неизбыточные покрытия G, не содержащиеся в G. В приведенном примере таким неизбыточным покрытием будет множество
F = {A -> B, B -> A, AB -> C}.
Если F-неизбыточное множество F-зависимостей, то в нем нет “лишних” зависимостей в том смысле, что нельзя уменьшить F , удалив некоторые из них. Удаление любой F-зависимости из F приведет к множеству, не эквивалентному F. Однако размер можно уменьшить, удалив некоторые атрибуты F-зависимостей F.
Определение. Пусть F-множество F-зависимостей над R и X -> Y есть F-зависимость из F. Атрибут А из R называется посторонним в X -> Y относительно F, если
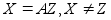 и (F - {X -> Y})
{Z -> Y}F
или
Y = AW, Y
W
и (F - {X -> Y})
{X -> W}F.
Иными словами, А - посторонний атрибут, если он может быть удален из правой или левой части X -> Y без изменения замыкания F.
Пример. Пусть G = {A -> BC,B -> C,AB -> D}. Атрибут С является посторонним в правой части A -> BC, а атрибут B - в левой части AB -> D.
Определение.
Пусть F - множество
F-зависимостей
над R и X -> Y принадлежит
F. F-зависимость
X -> Y называется
редуцированной
слева, если Х
не содержит
постороннего
атрибута А и
редуцированной
справа, если
Y не содержит
атрибута А ,
постороннего
для X -> y. Зависимость
X -> Y называется
редуцированной,
если она редуцирована
слева и справа
и Y
 .
Редуцированная
слева F-зависимость
называется
также полной
F-зависимостью.
Определение. Множество F-зависимостей F называется редуцированным (слева, справа), если каждая F-зависимость из F редуцирована (соответственно слева, справа).
Пример. Множество G = {A -> BC, B -> C, AB -> D} не является редуцированным ни справа, ни слева. Множество G1 = {A -> BC, B -> C, A -> D} редуцировано слева, но не справа, а G2 = {A -> B, B -> C, AB -> D} редуцировано справа, но не слева. Множество G3 = {A -> B, B -> C, A -> D} редуцировано слева и справа, следовательно, поскольку правые части не пусты, редуцировано.
Для нахождения редуцированных покрытий используется алгоритм:
REDUCE
Вход: множество F-зависимостей G.
Выход: редуцированное покрытие G.
REDUCE(G)
begin
F = RIGHTRED(LEFTRED(G))
удалить из F
все F-зависимости
вида X ->

return(F)
end
здесь RIGHTRED и LEFTRED алгоритмы редуцирования соответственно справа и слева, которые имеют вид:
RIGHTRED
Вход: множество F-зависимостей G.
Выход: редуцированное справа покрытие G.
RIGHTRED(G)
begin
F = G
for каждая зависимость X -> Y из G do
for каждый атрибут А из Y do
if
MEMBER(F - {X -> Y}
{X ->(Y - A)}, X -> A) then
удалить
А из Y в X -> Y из F
end
end
return(F)
end
Алгоритм LEFTRED
Вход: множество F-зависимостей G.
Выход: редуцированное слева покрытие G.
Begin
F = G
for каждая зависимость X -> Y из G do
for каждый атрибут А из Х do
if MEMBER(F,{X - A) -> Y) then
удалить А из
X в X -> Y из F
end
end
return(F)
end
Пример. Пусть G’= {A -> C, AB