Глобальні інформаційні мережі
Новий движок містить можливість локалізованого пошуку (Near Me) - система здатна автоматично визначати місцезнаходження користувача за IP-адресою його комп'ютера.
ОПИС РОСІЙСЬКИХ ПОШУКОВИХ СИСТЕМ
В Рунеті основними є пошукові системи Яndex, Rambler та Mail На діаграмі представлена питома вага різних пошукових машин Рунету.
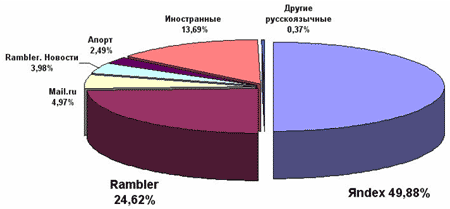
Yandex виконує пошук по словяномовній частині Інтернету з урахуванням морфології словянських мов. Маючи могутній механізм підбору сайтів під запити, ця пошукова машина допомагає знайти найбільш відповідні веб-сторінки. Яндекс щодня переглядає сотні тисяч веб-сторінок у пошуках змін або нових посилань, і їх база постійно зростає.
Слово "Яndex" означає "Мовний index", або, якщо по-англійськи, "Yandex" - "Yet Another indexer". За 10 роки публічного існування Яndex виникали і інші тлумачення. Наприклад, якщо в слові "Index" перекласти з англійського першу букву ("I" - "Я"), вийде "Яndex".
Офіційно пошукова машина Yandex.Ru була анонсована 23 вересня 1997 року на виставці Softool. Вже тоді пошуковик мав певні переваги - можливість перевірки документів на унікальність, облік морфології словянських мов, можливість пошуку з врахуванням відстані (наприклад, при пошуку точного словосполучення). Основною відмінною рисою Yandex є ретельно розроблений алгоритм оцінки відповідності відповіді запиту (релевантності), який враховує не лише кількість слів запиту, знайдених у тексті, але і "контрастність" слова (його відносну частоту для даного документа), відстань між словами, і положення слова в документі.
Згідно даних глобальної статистики Рунету, сьогодні більше 50% пошукового трафіку генерується саме цим пошуковиком (для порівняння, на долю Rambler'a доводиться близько 20%, і ще менше - на долю Google'a).
Реєстрація відбувається за адресою yandex/addurl.html. В Яндекса достатньо швидкий пошуковий робот. Завдяки ньому реєстрована сторінка з'явиться в пошукових результатах протягом 2-4 годин. Але це лише первинна індексація. Після повної індексації, вона може зникнути з пошукових результатів, якщо пошуковий робот визнає її за спам. Тому положення web-сторінки в результатах пошуку потрібно відстежувати до тих пір, поки не пройде повна індексація. Перелік результатів може мінятися залежно від завантаженості серверів, оскільки база даних Яндекса має кластерну структуру і рознесена на декілька серверів.
Яндекс любить документи середніх розмірів, насичені текстом (статті і т.п.). Слід помірно повторювати ключові слова. Ключові слова можна писати в описі, але вага слів у цьому тегу є нижчою. Добре індексуються сторінки, що створено за допомогою скриптів .cgi, .php. Це стосується гостьових книг, форумів і т.п. Для індексації решти (окрім головної) сторінок сайту потрібно приблизно 2 тижні.
Хороших позицій допомагають досягати ключові слова в мета-тегах, де варто зазначати слова, які зустрічаються в тексті сторінки. Мета-теги, використовуються також і для видачі опису сторінки в результатах пошуку. Це потрібно враховувати при його складанні, оскільки, користувач по цьому опису приймає рішення відвідати вас, чи ні. Важливо розміщувати ключові слова і в тегу "title", заголовках (h1-h6), змісті сторінки, "ALT"-тегах.
Для визначення релевантности Яндекс використовує Зважений Індекс Цитування, який впливає на рейтинг в результатах пошуку. Звичайний Індекс Цитування використовується тільки при сортуванні сайтів в каталозі Яндекса.
RAMBLER.RU (Спрощено - r0)
Цей пошуковик займає сьогодні друге місце серед пошуковиків Ренета. Він був першою пошуковою програмою, що створено спеціально для російського Інтернету програмістом компанії Stack Ltd Дмитром Крюком у 1996 році. Слово "Rambler" перекладається як «гуляща людина», «бродяга» по Інтернету.
Rambler постійно вдосконалює свій пошуковий алгоритм. Проводяться роботи по оптимізації роботи системи для точності та актуальності пошуку. Як і більшість російських пошукових машин, Rambler враховує морфологію російської мови. При видачі результатів вплив має положення сайту в рейтингу Rambler's Top100. Rambler індексує сайти в зонах ru .su, , , .kz, .kg, .uz, .ge, а також славяномовні сайти в доменах , або .
На сьогодні Rambler є в величезним інтернет-холдингом, до складу якого входять портал Рамблер, новинна інтернет-газета Лента.ру, медичний сайт Doctor, онлайновий клуб батьків Mama, картографічний сервіс NaKarte, телекомунікаційний підрозділ "Рамблер Телеком".
На Рамблері реалізовано розумну систему, яка виводить в результатах пошуку слова, які є синонімами запиту. Ще однією функцією системи є видача контекстної реклами не лише за конкретними ключовими словами, але і за фразами, що тісно пов'язані з ними.
Реєстрація знаходиться за адресою rambler/doc/add_site_form.shtml. Не реєструються сайти в доменах , , або . Якщо ж зміст сайту з цих зон має відношення до російськомовного Інтернету, то користувач має відправити лист на search.support@rambler-co з проханням проіндексувати сайт.
Рамблер (на відміну від інших пошукачів) вміє витягувати гіперпосилання з об'єктів Macromedia Flash. Якщо сайт має заставку або навігаційні панелі, що виконані з використанням цієї технології, Рамблер обробляє їх, знаходить адреси всіх сторінок сайту і індексує весь сайт. Тексти flash-об'єктів не індексуються. Для сайтів, які цілком складаються з flash-об'єктів, рекомендується створити HTML-копію і зареєструвати її в пошуковій машині. Роботи Рамблера також справляються з конструкціями фреймів.
Роботи Рамблера ігнорують більшість мета-тегів. Коментарі в документі роботи Рамблера теж не сканують, але більшої уваги звертають на заголовки і виділення в документі. Базові поняття і ключові для даного сайту слова доцільно включати в наступні HTML-теги (у порядку значущості): "title", "h1"..."h4", "b", "strong", "u".
Максимальний розмір документа для роботів складає 200 кілобайт. Документи більшого розміру усікаються до вказаної величини.
APORT.RU
Пошукову систему "Апорт!" було розроблено компанією "Агама" за підтримки Intel і вперше продемонстровано в лютому 1996 року на прес-конференції "Агамы" з приводу відкриття "Російського клубу". Тоді вона шукала лише по сайту russia.agama.
Найважливішими особливостями першої версії "Апорту" були переклад запиту і результатів пошуку англійською мовою і зворотно, а також відновлення всіх проіндексованих сторінок з власної бази (що надає можливість переглядання сторінок, вже неіснуючих в оригіналі).
До кінця 1999 року було представлено нову версію Апорт - "Апорт 2000", який став першим російським пошуковиком, що побудований на основі видачі результатів по окремо взятих сайтах. "Апорт 2000" практично реалізував дві базові технології американської пошукової машини Google: облік "рангу сайту" (Page Rank), і обробка запиту, орієнтуючись на HTML-код сторінки. Серед недокументованих особливостей - більший пріоритет сайтам, які мають вищу та елітну лігу у каталозі AtRus.
Aport є повнотекстовою пошуковою системою, тобто вона індексує всі слова, які б побачила на екрані людина, що переглядатиме конкретну сторінку. В результаті будь-яке слово з тексту документів може бути критерієм для подальшого пошуку. Апорт також індексує тексти гіперпосилань на документ з інших сторінок, що знаходяться, як всередині сайту, так і за його межами, а також складені (або перевірені) редакторами описи сайтів з каталогу.
Результати пошуку впорядковуються за частотою використання шуканих термінів. Разом з посиланням відображається фрагмент тексту, де зустрічається термін, вказується індекс відповідності до запиту і дата останньої модифікації файлу. "Апорт!" у виданому фрагменті тексту виділяє червоним кольором запитані слова.
Реєстрація сайту в Апорті проводиться із сторінки aport/addurl.asp. Ця сторінка доступна з будь-якої сторінки Апорту, наприклад, з головної сторінки Апорту. Додавати в пошукову систему Апорт слід російськомовні сайти, а також сайти, що мають безпосереднє відношення до російського Інтернету. У разі відмови в автоматичному додаванні сайту можна звернутися з проханням про додавання сайту за addurl-nr@aport.
З моменту додавання сайту в Апорт до моменту його появи в пошуковій базі проходить від двох-трьох днів до двох тижнів.
При перегляданні вмісту сервера для індексування Апорт обов'язково перевіряє файл ROBOTS.TXT. Отже можна його використати, щоб обмежити 'діяльність' Апорту на своєму сервері. Апорт за умовчанням не індексує динамічні документи, в адресах яких зустрічається символ '?'.
Для документів HTML, окрім основного тексту документа індексуються також: заголовок документа "TITLE", ключові слова "KEYWORDS", описи сторінок "DESCRIPTION" і підписи до картинок "ALT". Апорт пропонує декілька варіантів направленої реклами aport/adv, проте немає можливості купити вищі місця для свого сайту в результатах пошуку.
Ключові слова не мають визначального значення при визначенні релевантности документа. Але розумне використання цього тега рекомендується.
На відміну від багатьох інших пошукових систем, Апорт не застосовує спеціальних санкцій до сайтів, що намагаються обдурити пошукову систему за допомогою спаму, але досягнути подібним чином бажаного результату не вийде. Тому не варто писати невидимі тексти, набирати сотні ключових слів, що не мають жодного відношення до змісту документа і т.д.
Ось перелік основних критеріїв, які Апорт враховує при сортуванні сайтів: густина ключових слів, відстань між ключовими словами в тексті документа, місце, де зустрічаються пошукові слова (заголовок, опис, мета-тег і т.п.), зовнішній вигляд шрифту, яким набрані ключові слова (розмір, грубість, колір), кількість посилань з Інтернету на даний документ, використання ключового слова в тексті посилань з Інтернету на даний документ. Остаточний відсоток відповідності документа до запиту будується як певна функція від всіх цих показників.
З ЧОГО ПОТРІБНО ПОЧИНАТИ ПОШУК?
По-перше, визначитися з метою пошуку. При цьому потрібно концентруватися не лише на самій меті, але і на тому, що може її супроводжувати.
У ідеалі процес пошуку повинен виглядати приблизно так. Спочатку робиться загальний запит, отримується відповідь з результатами пошуку, в якому потрібно виділити описи більш-менш відповідних посилань. Потім необхідно додати до запиту загальні ключові слова, які є в описі потрібних посилань і повторити процес. Якщо все робити правильно, то кожен запит повинен наближати до потрібної інформації. Користувач має бути своєрідним зворотним зв'язком, з кожним кроком зменшуючи невідповідність між потрібною інформацією і тим, що видає пошукова система.
Розглянемо невеликий приклад - необхідно знайти розклад потягів що проходять через Київ. Як загальний запит можна так і спробувати "запитати" пошукову систему: розклад всіх потягів що проходять через київ. Проте, по такому запиту, наприклад, Яндекс, знаходить лише розклади потягів, що проходять через Львів, Тернопіль, але Києва серед результатів пошуку не видно. Це у жодному випадку не означає, що цієї інформації в базі пошукової системи немає, просто запит був сформульований не дуже вдало.
Річ у тому, що будь-яка пошукова система прагне знайти сторінки, на яких знаходиться максимальна кількість слів з запиту, більш того, якщо ці слова слідують один за одним, то такі сторінки будуть виведені першими. Тобто, наприклад, якщо в тексті сторінки зустрічається фраза розклад всіх потягів, що проходять через Львів, то за відсутності такої ж фрази розклад всіх потягів, що проходять через Київ система визначить, що вони мають 5 загальних слів, тобто з великою ймовірністю сторінка, що містить цю фразу підійде, хоча це і не так. Тому потрібно такий запит скоректувати, прибравши всі слова-паразити і залишивши лише слова, які точно характеризують вашу потребу. Словами-паразитами є слова всіх, що проходять, через, які можуть зустрічатися на яких завгодно сторінках. Задавши скорегований запит розклад потягів київ, результат буде кращим.
Саме так зараз врешті-решт поступають переважна більшість користувачів, проте, для того, щоб навчитися швидко і ефективно знаходити потрібну інформацію, просто скоректувати запит в більшості випадків недостатньо. Необхідно ще ознайомитися з декількома дуже корисними, а іноді просто незамінними операторами мови запитів пошукової системи. Ці оператори не тільки істотно полегшать роботу, але і допоможуть знаходити таку інформацію, яку за допомогою простих запитів знайти абсолютно неможливо.
Що таке оператори пошукової системи і для чого вони потрібні? Оператори дозволяють не тільки точніше сформулювати запит, але і вибирати, на яких сторінках здійснювати пошук і навіть в яких їх елементах, наприклад, заголовках, ключових словах або посиланнях. Розглянемо оператори, що є загальними для всіх пошукових систем.
Перший оператор - оператор строгої відповідності, як правило, в сучасних пошукових системах це лапки "". Поєднання слів, які вказані в лапках, будуть враховані системою як єдине ціле, а також задається порядок проходження слів один за одним. Наприклад, за запитом комп'ютерні журнали можна отримати в результатах пошуку сторінки із словами, що згадуються відособлено, тобто на одній сторінці може бути слово комп'ютерні, на іншій - журнали і т.д. Конструкція "комп'ютерні журнали" в лапках примушує пошукову систему відкинути всі зайві сторінки і показувати лише ті, на яких ці два слова йдуть один за одним.
Наступні важливі оператори - оператор обов'язкової наявності слова "+" і оператор обов'язкової відсутності слова "-". Наприклад, якщо потрібно знайти сайт журналу ЧІП, достатньо до запиту "комп'ютерні журнали" додати +чіп: "комп'ютерні журнали" +чіп. Якщо ж потрібно вивести всі журнали, окрім Чіпа, потрібно ввести "комп'ютерні журнали" -чіп.
Використовуючи ці три прості оператори, вже можна істотно скоротити витрати на час пошуку інформації.
Часто є потреба, щоб шукані ключові слова були присутні в межах одного документа. Для цього необхідно використовувати оператор логічного І AND. Проте, у всіх пошукових системах це можна зробити, якщо поставити звичайний пропуск. Наприклад, запити комп'ютерні журнали і комп'ютерні AND журнали, як правило, нададуть однаковий результат. Оператор логічного АБО OR дозволяє знайти хоча б одне слово із запиту. Наприклад, за допомогою запиту комп'ютерні OR журнали можна знайти документи, в яких зустрічається або слово комп'ютерні, або слово журнали.
З мовами запитів конкретної пошукової системи можна ознайомитися в її розділі допомоги. Багато з них мають власні додаткові оператори.
ПРЕДСТАВЛЕННЯ ШУКАНОГО ДОКУМЕНТА ЯК ОБРАЗУ
Пошук можна істотно спростити, уявивши собі образ сторінки, що містить потрібну інформацію. Існують загальноприйняті правила, яких притримуються практично всі сторінки Інтернет. Основне і головне правило: заголовок кожної сторінки стисло і точно характеризує її вміст. Відшукати, наприклад, певну книгу в електронному вигляді дуже просто. Звичайно, можна спробувати її знайти, якщо задати в пошуковій системі прізвище автора і назву і зрештою знайти її, але тоді витрачається багато часу на переглядання абсолютно даремних сторінок із згадкою даної книги або автора, але без її електронної копії.
На допомогу тут знов приходять розширені можливості пошуку, використовуючи які, можна відшукувати потрібну інформацію прямо в заголовках сторінок.
Простій приклад - потрібно знайти, припустимо, книгу Паоло Коельо "Алхімік". Спершу складаємо образ потрібної сторінки - швидше за все, в її заголовку можуть знаходитися і прізвище автора, і назва твору. Далі потрібно з'ясувати, як включити розширені можливості пошуку по заголовку в пошуковій системі. Наприклад, в Яндекс для пошуку по заголовках потрібно використовувати конструкцію $title(), таким чином, запит може виглядати як: $title(коельо "алхімік"). Результат перевершує всі очікування - перші 7 посилань, які вивів Яндекс в результатах пошуку, містять потрібні дані.
Шукати так само можна не лише книги, а все, що завгодно. Ще один реальний приклад – потрібно знайти, скажімо, результат фіналу футбольного матчу кубка Іспанії між Реалом і Депортіво. Для того, щоб переконатися в правильності вищевикладених принципів, цього разу використаємо іншу пошукову систему, популярну Google. Для пошуку по заголовках в неї використовується інша конструкція - allintitle. Створюємо образ потрібної сторінки - вірогідно, в заголовку новини повинна бути присутньою фраза "кубок іспанії" і назви команд, що беруть участь, наприклад, мадридський реал в кубку іспанії. В даному випадку запит може виглядати приблизно так: allintitle: реал "кубок испанії". Якщо задати щось подібне до allintitle: реал депортіво "кубок іспанії" і пошукова система показала, що сторінок, які б задовольняли цьому запиту, немає, оператор allintitle можна не застосовувати і пошукати у всьому тексті: реал депортіво "кубок іспанії". Результат в обох випадках вражає - знайдена одна і та ж потрібна сторінка.
Але не лише заголовки корисні при пошуку потрібної інформації. Велику допомогу надає і текст посилань. Будь-який сайт містить певні посилання, які ведуть на його сторінки або сторінки інших сайтів. Кожне таке посилання має власний опис, по значенню сумірне, а часто і більш інформативне, ніж заголовок самої сторінки, на яку вона веде. Адже і в текстах посилань теж можна шукати, та ще як!
Отже, що ж надає текст в посиланнях? Наприклад, потрібно знайти в Інтернеті певний файл, наприклад, викачати останню версію універсального музичного програвача winamp. Створимо образ сторінки. Оскільки програма ця відома, то, ймовірно, існує багато сайтів, на яких є посилання на сторінку, де можна викачати останню версію winamp. Якщо спробувати пошукати в тексті цих посилань, швидше за все одною з перших в результатах пошуку з'явиться потрібна нам сторінка, оскільки решта всіх посилань веде саме до неї. Для пошуку в описах посилань в Google використовується оператор allinanchor, отже, запит можна сформулювати приблизно так: allinanchor: winamp download. Для того, щоб упевнитися у вірності приведеного, можна замість winamp поставити іншу програму - якщо в Мережі на неї є хоч одне посилання, система виведе її першою.
ПОРЯДОК РОБОТИ
Відкрити пошукові сайти і ознайомитися з їх структурою, налаштуваннями та довідковою системою.
Провести пошук за ключовими словами та фразами.
Застосувати для пошуку оператори мови пошуку.
Ознайомитись з результатами пошуку.
Порівняти можливості пошукових систем.
ЗМІСТ ЗВІТУ
Назва та мета виконання лабораторної роботи.
Організація пошукового сервісу.
Основні пошукові сайти Інтернет.
Аналіз результатів пошуку.
Висновки.
ЗАСОБИ СТВОРЕННЯ WEB-СТОРІНОК
Web-сторінки є базовими документами World Wide Web і створються у HTML (HyperText Markup Language).
Сторінки можуть бути як частиною Web-сайту, так і самостійними документами.
HTML-сторінка містить HTML-теги, що надають інформацію про структуру сторінки, її вигляд та вміст. Web-браузери використовують цю інформацію для визначення способу відображення сторінки.
РІВНІ СТВОРЕННЯ WEB-СТОРІНОК
До створення Web-сторінок існує три загальних підходи:
Високий рівень - створення документу звичайними засобами з наступною його конвертацією в HTML,
Середній рівень - створення Web-сторінки в спеціалізованому HTML-редакторі,
Низький рівень - створення Web-сторінки безпосередньо в HTML-кодах.
Перший підхід не вимагає жодних знань мови HTML. Документ створюється в довільному текстовому редакторі у форматі, в якому він буде відображатись у Web-браузері. Після створення документ конвертується у HTML-код. Наприклад, Microsoft Word дозволяє зберегти відкритий документ у форматі HTML. Але цей підхід має суттєві недоліки: по-перше, код, що отримано в результаті конвертації є досить громіздким і незручним для подальшого редагування, а по-друге, можливості Web-сторінки, що отримана таким шляхом, досить обмежені, оскільки від початку створюється не HTML-документ, а, наприклад, Word-документ.
Другий підхід є найзручнішим з точки зору співвідношення часу, що витрачається на створення Web-сторінки, та можливостей цієї сторінки, отриманих за допомогою спеціалізованого HTML-редактора. Такі HTML-редактори, як правило, дозволяють створювати Web-сторінки подібно, як створюються документи у текстових процесорах, із форматуванням тексту, графіки, таблиць та інших елементів сторінки за принципом WYSIWYG (What You See Is What You Get - "що бачиш, те і отримаєш"), при цьому сам документ зберігається відразу у HTML-коді. Крім того, такі HTML-редактори дозволяють безпосередньо редагувати HTML-код. Ефективність отриманого коду при цьому підході залежить від ефективності та можливостей вибраного редактора.
Третій підхід вимагає глибокого знання мови HTML. Редагування Web-сторінок відбувається у форматі, дещо незручному для сприйняття початківцем. Однак при такому підході можна створити дуже ефективний HTML-код, що забезпечить максимальну інформативність сторінки при її мінімальному об'ємі. Крім того, в такому випадку Web-дизайнеру доступні всі можливості мови HTML, які можуть не бути реалізовані у спеціалізованих HTML-редакторах.
ОГЛЯД РЕДАКТОРІВ ДЛЯ ВЕРСТКИ ВЕБ-СТОРІНОК
Існує багато інструментів для верстання веб-сторінок, варто випробувати різні редактори, і лише тоді вже вирішувати, з яким краще працювати.
Редактори для верстання веб-сторінок є двох типів: візуальні і текстові.
Візуальні редактори не вимагають знань html, css та інших технологій для розмітки сторінок. У візуальному редакторі різні елементи сайту розташовуються, неначе на листі паперу, а редактор пише код самостійно. Саме тому візуальні редактори ще називають WYSIWYG-редакторами.
Проте, жоден візуальний редактор не є досконалим і всі вони так чи інакше є обмеженими за своїми можливостями, тому від професійних кодерів потрібне уміння писати код руками, саме тому професійним кодерам потрібні текстові редактори. У цих редакторах пишуть код своїми руками. У текстових редакторах, як правило, бувають різні функції що полегшують кодеру написання коду, такі, як підсвічування коду (так легше бачити, де в коді вставлені стилі, або скрипти, а де просто текст), різні гарячі кнопки і клавіші, які вставляють вже готові конструкції (фрагменти коду, спецсимволи) в код, і т.п.
Якого ж типу обрати редактор? Якщо за мету ставиться вивчення html, css або інших технологій для розмітки сторінок, якщо потрібно навчитися створювати якісні сторінки і бути професійним кодером, то безумовно потрібний текстовий редактор. Якщо ж таких завдань не ставиться, то звісно кращим вибором буде візуальний редактор, бо він економить час і сили. А краще всього мати у себе на комп'ютері і візуальний, і текстовий редактори для різних потреб.
ВІЗУАЛЬНІ РЕДАКТОРИ
MACROMEDIA DREAMWEAVER MX
Професійний інструмент для створення web-сайтів і додатків. Мабуть, це сама краща програма з візуальних редакторів на даний момент, принаймні вона є у пошані у багатьох користувачів.
Розробники стверджують, що Macromedia Dreamweaver MX призначена для проектування, розробки і адміністрування професійних web-сайтів і додатків. Окрім того Dreamweaver легко інтегрується з іншими програмами від Macromedia, наприклад, такими, як Flash. Dreamweaver є значно більшим, ніж просто візуальний редактор, це достатньо могутній і складний інструмент, а всякий складний інструмент вимагає, щоб на його освоєння було витрачено якийсь час, перш, ніж користувач зможе працювати в нім.
Офіційна сторінка та опис програми Dreamweaver
Завантажити Dreamweaver (48,2 Мб)
Підручник Dreamweaver 4
Підручник DreamWeaver MX
Підручник Macromedia Flash & Dreamweaver
ADOBE GOLIVE І LIVEMOTION
Можливо, Adobe GoLive сподобається тим, хто любить програми від Adobe, і багато з ними працюває: знайоме середовище, в якому легко розібратися. Всі програми від Adobe є сумісними між собою і доповнюють один одного. GoLive є лише візуальним редактором для верстання веб-сторінок і підтримує технологій Html, Dhtml, CSS, XML та декілька готових Javascript’ів. Вбудований редактор коду (текстовий) в цій програмі є добрим. GoLive це є оптимальне поєднання візуального і текстового редактора (два в одному).
Варто використовувати з GoLive таку програму, як Adobe LiveMotion (в попередніх версіях вона називалося Image Styler). Хоча, LiveMotion є графічним редактором, в якому можна створювати нескладну, але якісну графіку для своїх веб-сайтів, він також вміє верстати веб-сторінки, на основі того, що намальовано. LiveMotion сам розподіляє готовий макет на багато картинок, які потім можна використати при верстанні сайту в GoLive.
Офіційна сторінка та опис програми Golive
Завантажити Golive (106 Мб)
Огляд-підручник GoLive
Підручник: інтеграція шаблонів Golive
Офіційна сторінка та опис програми LiveMotion
Завантажити LiveMotion (65,5 Мб)
Завантажити Image Styler (попередня версія LiveMotion) (15 Мб)
Навчання роботі з Image Styler
MICROSOFT FRONTPAGE
Програма FrontPage дозволяє створювати веб-сторінки у форматах Html, Css, Dhtml, Javascript. Надає широкі можливості по управлінню зображеннями і flash-роликами. FrontPage сумісний з технологіями ASP, XML, VBScript, XSL. В останній версії FrontPage створює більш чистий код (раніше FrontPage вставляв в код багато непотрібних коментарів та іншої зайвої інформації).
Офіційна сторінка та опис програми FrontPage
FrontPage 98 - Підручник
Основи роботи з FrontPage 2000
HOTDOG
Програма має простій і зрозумілий користувачеві інтерфейс. Hotdog є дружнім до користувача, сумісним з Flash, SQL, PHP, ASP, може працювати з GIF-зображеннями (оптимізація, анімація), містить Html-компресор, може створювати файли довідки (CHM).
Офіційна сторінка та опис програми Hotdog
Завантажити Hotdog (11,3 Мб)
ТЕКСТОВІ РЕДАКТОРИ
HOMESITE
Цей редактор, мабуть, найпопулярніший і могутніший серед текстових редакторів. В ньому легко працювати не лише з Html-кодом. Користувачеві надається широка допомога: перелік різних атрибутів до всіх тегів, перевірка коду (правильність перевіряється за вимогами W3C), підтримка XHTML, CSS-редактор, тощо.
Офіційна сторінка та опис програми Homesite
Завантажити Homesite (11,3 Мб)
Все про html-редактор Homesite 4.5
HTML PAD
HTMLPad підтримує JavaScript, VBScript, SSI, ASP і Perl, вміє створювати макроси (на подобі Word’a і Excel'а), містить довідкові матеріали по CSS і Html, і багато іншого.
Офіційна сторінка та опис програми HTML Pad
Завантажити HTML Pad (3 Мб)
Як працювати з HtmlPad
NOTEPAD
Notepad він же Блокнот. У цій програмі немає жодних функцій, які полегшують роботу: ні підсвічування коду, ні вставляння готових конструкцій коду, нічого, проте ця програма є в Стандартних на комп'ютері у кожного користувача. З неї можна почати свої перші кроки в написанні коду, а потім вже змінити на більш досконалий редактор.
ПОРЯДОК РОБОТИ
Запустити програму DreamWeaver (Start -> Programs -> Macromedia -> Macromedia Dreamweaver MX.
Відкрити підручник з DreamWeaver.
Вивчити методику створення Web-сайту за допомогою MacroMedia DreamWeaver.
Створити фрагмент у візуальному режимі, перейти у текстовий режим і проаналізувати створене.
Зробити виправлення у текстовому режимі, перейти у візуальний режим і проаналізувати результат
Дослідити можливості у створенні таблиць
Додати до створеної сторінки стилі
ЗМІСТ ЗВІТУ
Назва та мета виконання лабораторної роботи.
Порівняльний аналіз популярних редакторів.
Характеристика та основні можливості по створенню Web-сторінок за допомогою DreamWeaver.
Додати скрін створеного фрагменту та його код.
Висновки.
СТВОРЕННЯ ВЕБ САЙТУ
Створення сайту завжди починається з ідеї. Але до її реалізації існують усталені етапи для того, щоб створити працездатний якісний сайт.
Ідея
Розробка структури сайту
Розробка оформлення сайту
Кодинг, програмування
Тестування і доопрацювання
Просування, реклама
Подальша підтримка і оновлення
Перші п'ять етапів відносяться безпосередньо до створення сайту, останні потрібні для подальшого існування сайту.
ІДЕЯ
Перш, ніж приступити до роботи над сайтом, потрібно чітко уявляти, що в результаті має бути, а також перспективи розвитку сайту.
Отже, потрібно вирішити:
Навіщо створювати сайт (чи потрібно це взагалі)
Про що буде сайт (тематика)
Що це буде (домашня сторінка, портал, або щось ще)
Відмінність від сайтів з такою ж тематикою (якщо це не домашня сторінка)
Яка буде аудиторія сайту (стать, вік, інтереси і т.д.)
Якого роду сервіси будуть присутні на сайті (форум, каталог, пошта і т.д.)
Плани на найближче майбутнє
Плани подальшого розвитку (перспективи)
та багато інших подібних питань які слід вирішити перш, ніж братися за реалізацію. Продумування: що, як навіщо і чому - найважливіший етап в створенні сайту. Головним тут є хороша ідея, а інше додається під час роботи.
Тільки після того, як в думці, а краще і на папері, оформиться чіткий образ того, яким повинен бути сайт, можна приступати до інших етапів. Певні етапи розробки сайту можуть проводитися паралельно (особливо, якщо працює над створенням сайту не одна людина, а команда в декілька чоловік).
РОЗРОБКА СТРУКТУРИ
Щоб створити сайт потрібний план. Чітко розписаний, що, де буде розташовано. План цей малюється на папері, і називається це розробка структури сайту.
Структуру сайту можна умовно розділити на зовнішню і внутрішню.
ВНУТРІШНЯ СТРУКТУРА САЙТУ
Залежить від того, яка інформація буде розміщена, які є матеріали. Слід вирішити, які будуть на сайті розділи, підрозділи, тобто скласти дерево сайту.
Розглянемо розробку внутрішньої структури на прикладі домашньої сторінки. Яку інформацію можна на ній розмістити? Розповідь про себе (на головній сторінці), свої фотографії, контактну інформацію - це як мінімум. Отже, внутрішня структура домашньої сторіночки буде