Основы распараллеливания программ, их динамический анализ
DependenceStore – класс, предназначенный для хранения всех зависимостей одного типа.
Информация о массивах, используемых в программе, представляется классами CArrays и CArrayData. Класс CArrayData содержит информацию об одном массиве:
имя массива, номер строки, в котором он был определен,
Sage-номер или внутренний идентификатор массива для динамических массивов,
число измерений массива и размеры каждого измерения,
размер одного элемента массива.
При сохранении в файл данные записываются в формате XML. Удобство данного формата состоит в том, что он имеет древовидную структуру и, кроме того, является текстовым форматом, а потому может быть непосредственно прочитан человеком. Следует также отметить, что существуют простые и удобные библиотеки для работы с XML.
Конкретное представление дерева контекстов в виде XML несущественно. Предполагается, что все модули, требующие для работы результаты анализа, будут использовать предназначенную для этого библиотеку.
4.3 Внутреннее устройство анализатора
Внутренняя структура анализатора показана на Рисунке 2.
Ядро является основной частью динамического анализатора. Фактически, ядро – это реализация алгоритмов, описанных в разделе Error: Reference source not found, использующая блок внешнего интерфейса для получения информации о ходе выполнения программы, а остальные блоки как структуры данных для хранения информации.
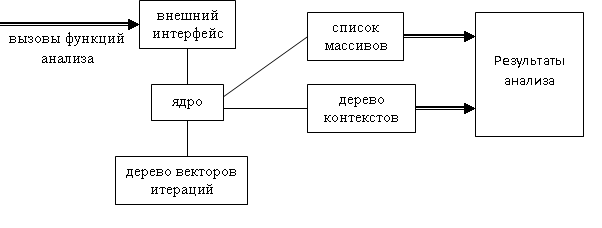
Рисунок 2 Внутренняя структура анализатора
Ядро анализатора использует внутренний интерфейс, основные операции которого соответствуют операциям интерфейса анализатора, описанным в разделе . Имеются, тем не менее, незначительные отличия, обусловленные соображениями удобства и простоты. Блок внешнего интерфейса необходим для преобразования вызовов функций анализа в вызовы интерфейса ядра. Исторически такое преобразование было необходимо в связи с тем, что первая версия анализатора была реализована на основе интерфейса отладчика системы DVM [Error: Reference source not found]. Этот отладчик предназначен для проверки корректности DVM-программы посредством моделирования ее параллельного выполнения, а также посредством накопления и сравнения трасс при ее последовательном и параллельном выполнении. В его интерфейс входят базовые функции, необходимые динамическому анализатору: чтение и запись значений переменных, начало и завершение циклов, начало итераций циклов. Поэтому до появления специального инструментатора было возможно использовать инструментатор, предназначенный для отладчика DVM. В данный момент наличие блока внешнего интерфейса позволяет при необходимости изменять интерфейс анализатора, не затрагивая основную часть библиотеки.
Дерево контекстов и список массивов – это части библиотеки работы с результатами анализа. Анализатор использует их для хранения информации во время выполнения программы и сохранения результатов по окончании анализа. Другие модули системы автоматизации распараллеливания смогут воспользоваться той же библиотекой для чтения сохраненных результатов. Дополнительно анализатор создает дерево векторов итераций – структуру данных, представляющую цепочки векторов итераций для операторов программы. Все цепочки, возникающие при анализе, организуются в дерево по следующему принципу: каждый элемент цепочки соответствует переходу на один уровень вниз по дереву, при этом одинаковым началам цепочек соответствуют одинаковые пути от корня по дереву. Тогда одинаковые цепочки векторов итераций представляются одним узлом в дереве. Виртуальная точка доступа при этом представляется просто как пара ссылок на соответствующие узлы в дереве контекстов и дереве векторов итераций. Дерево векторов итераций не сохраняется, поскольку после вычисления расстояний зависимостей векторы итераций уже не нужны.
В начале и при завершении работы анализатор производит специальные действия. При выполнении команды инициализации ядро ищет результаты предыдущего запуска анализатора и в случае успеха загружает ранее полученные дерево контекстов и список массивов. В этом случае результаты нового запуска добавляются к уже имеющимся результатам, что необходимо при наличии нескольких тестов. Когда анализатор получает команду завершения, содержимое дерева контекстов и списка массивов сохраняется в файл.
4.4 Результаты тестирования
Тестирование анализатора проводилось на программах, реализующих решение уравнения Пуассона в трехмерном пространстве классическими итерационными методами: методом Якоби, методом последовательной верхней релаксации (SOR), методом красно-черного упорядочения (RedBlack), а также на программе, реализующей решение системы линейный алгебраических уравнений методом Гаусса.
Основные показатели производительности показаны на Таблице 1. В методах Якоби, SOR и RedBlack использовалась матрица размера 16x16x8. В методе Гаусса решалась система размера 100x100.
Таблица 1 – Показатели производительности
| Метод | Время выполнения, сек | Используемая память, Kb | ||
| без анализатора | с анализатором | без анализатора | с анализатором | |
| Якоби | 0,05 | 4,73 | 924 | 58136 |
| SOR | 0,05 | 2,23 | 908 | 25096 |
| RedBlack | 0,05 | 5,52 | 908 | 65752 |
| Гаусс | 0,04 | 6,45 | 980 | 51756 |
Из приведенных результатов следует, что текущая реализация динамического анализатора замедляет работу программы в 100 и более раз, используя при этом в десятки раз больший объем памяти. Это ограничивает возможности применения анализатора, поскольку для того, чтобы время анализа оставалось в разумных пределах, необходимо сильно уменьшать размерность решаемой задачи.
Следует отметить, что на данный момент не было сделано попыток оптимизации анализатора. Поэтому полученные результаты нельзя считать окончательными, и следует считать указанием на необходимость дальнейшей работы по улучшению метода динамического анализа.
5. Заключение
Подведем некоторые итоги данной работы. Динамический анализ зависимостей по данным обладает рядом преимуществ по сравнению с традиционными статическими методами анализа. Поскольку анализ производится во время выполнения программы, доступна вся информация о производимых доступах в память. Это позволяет получить абсолютно точную информацию о зависимостях по данным независимо от сложности индексных выражений массивов, наличия косвенной индексации или указателей.
Основным недостатком данного метода является отсутствие гарантии того, что все возможные зависимости по данным обнаружены. Это означает, что для проведения анализа необходимо наличие набора тестов, достаточно полно покрывающего различные варианты поведения программы. Кроме того, существенные затраты ресурсов анализатором при каждом запуске программы на выполнение заставляют уменьшать размерность задач для анализа, что, быть может, не всегда возможно.
В рамках данной работы один из методов динамического анализа был реализован в виде библиотеки на языке С++ (около 2500 строк исходного кода). Проведено тестирование анализатора на наборе программ на языке Си, представляющих собой реализации классических итерационных методов (Якоби, SOR, RedBlack) и метода Гаусса. Тем самым показана возможность применения динамического анализа для поиска зависимостей в программах, требующих распараллеливания.
6. Литература
ParaWise. The Computer Aided Parallelization Toolkit [HTML, PDF] (parallelsp).
Проект V-Ray [HTML] (parallel/v-ray).
Jacobson T., Stubbendieck G. Dependency Analysis of FOR-Loop Structures for Automatic Parallelization of C Code [PDF] (css.edu/depts/cis/mics_2003/MICS2003_Papers/Jacobson.PDF).
Karkowski I., Corporaal H. Overcoming the Limitations of the Traditional Loop Parallelization // Journal of Future Generation Computer Systems. 1998. № 13. P. 407-416.
Petersen P.M. Evaluation of Programs and Parallelizing Compilers Using Dynamic Analysis Techniques. Champaign, IL, USA: University of Illinois at Urbana-Champaign, 1993. 164 p.
DVM-система [HTML] (keldysh/dvm).