Компьютерное моделирование технологических процессов
Матрица содержит полный набор всех возможных комбинаций уровней варьирования факторов. Отсюда полный факторный эксперимент получил свое название.
Как следует из рис. 22, результаты опытов, приведенные в табл. 13, соответствуют на факторной плоскости вершинам квадрата с центром в начале координат.
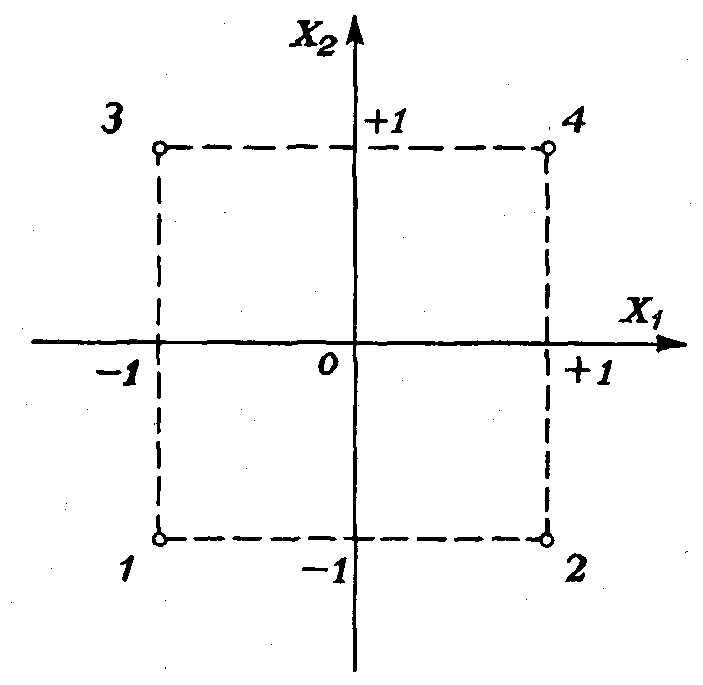
Рис. 22. Полной двухфакторной эксперимент на плоскости
В табл. 14 приведены условия опытов полного трехфакторного эксперимента. Эти опыты соответствуют в факторном пространстве вершинам куба с центром в начале координат.
Основные принципы построения матриц планирования полного факторного эксперимента: 1) уровни варьирования первого фактора чередуются от опыта к опыту; 2) частота смены уровней варьирования каждого последующего фактора вдвое меньше, чем у предыдущего.
Таблица 13 Условия полного трехфакторного эксперимента
| Номер опыта | Факторы | Функция отклика | ||
| X1 | X2 | X3 | ||
|
|
- 1 | - 1 | -1 | y1 |
|
|
+ 1 | - 1 | - 1 | y2 |
|
|
- 1 | + 1 | - 1 | y3 |
|
|
+ 1 | + 1 | - 1 | y4 |
|
|
- 1 | - 1 | + 1 | y5 |
|
|
+ 1 | -1 | + 1 | y6 |
|
|
- 1 | + 1 | + 1 | y7 |
|
|
+ 1 | + 1 | + 1 | y8 |
Общее число опытов полного факторного эксперимента:
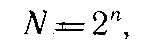
где n — число факторов.
На основании результатов полного факторного эксперимента вычисляют коэффициенты регрессии, пользуясь следующими формулами:
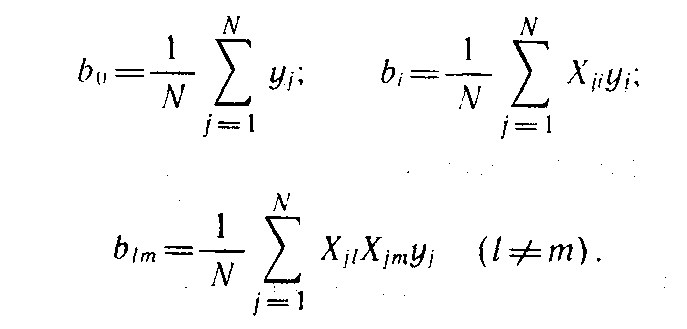
Некоторые из коэффициентов регрессии могут оказаться пренебрежимо малыми - незначимыми. Чтобы установить, значим коэффициент или нет, необходимо прежде всего вычислить оценку дисперсии, с которой он определяется:
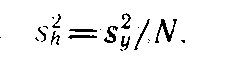
Следует отметить, что по результатам полного факторного эксперимента все коэффициенты определяются с одинаковой погрешностью.
Принято считать, что коэффициент регрессии значим, если выполнено условие
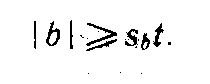
где —
значение критерия
Стьюдента,
взятое
из табл. 15.
Для
пользования
табл. 15 необходимо
знать число
степеней
свободы связанное
с оценкой дисперсии

Таблица 15 Значения критерия Стьюдента
| f | t |
| 1 | 12,71 |
| 2 | 4,30 |
| 3 | 3,18 |
| 4 | 2,78 |
| 5 | 2,57 |
| 6 | 2.45 |
| 7 | 2,36 |
| 8 | 2,31 |
| 9 | 2,26 |
| 10 | 2,23 |
Если проверка показала, что коэффициент регрессии незначим, то соответствующий член можно исключить из уравнения.
Получив уравнение регрессии, следует проверить его адекватность, то есть способность достаточно хорошо описывать поверхность отклика и прогнозировать результаты опытов. Для проверки адекватности вычисляют оценку дисперсии адекватности по формуле
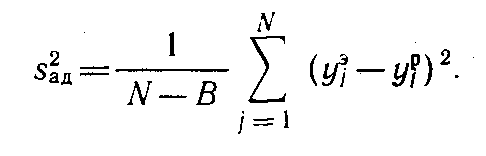
Здесь — число значимых
коэффициентов
регрессии;
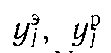 —
экспериментальное
и расчетное
значение функции
отклика в
 опыте;
 — число опытов
полного факторного
эксперимента.
С оценкой дисперсии адекватности связано число степеней свободы
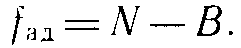
Затем находят расчетное значение критерия Фишера:
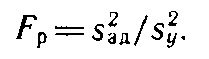
Уравнение регрессии считается адекватным, если выполняется условие
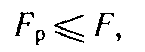
где — критическое
значение критерия
Фишера табл.
16.
Для
пользования
табл. 19 необходимо
знать числа
степеней свободы,
связанных с
числителем
и знаменателем
отношения
Методом дробного факторного эксперимента
С увеличением числа учитываемых факторов резко возрастает число опытов полного факторного эксперимента.
Для нахождения коэффициентов регрессии не всегда требуется много опытов. В таких случаях можно уменьшить объем экспериментальных работ, воспользовавшись методом дробного факторного эксперимента, который известен также под названием метода дробных реплик.
Этот
метод заключается
в том, что для
нахождения
уравнения
регрессии
используется
определенная
часть полного
факторного
эксперимента: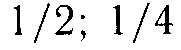 и
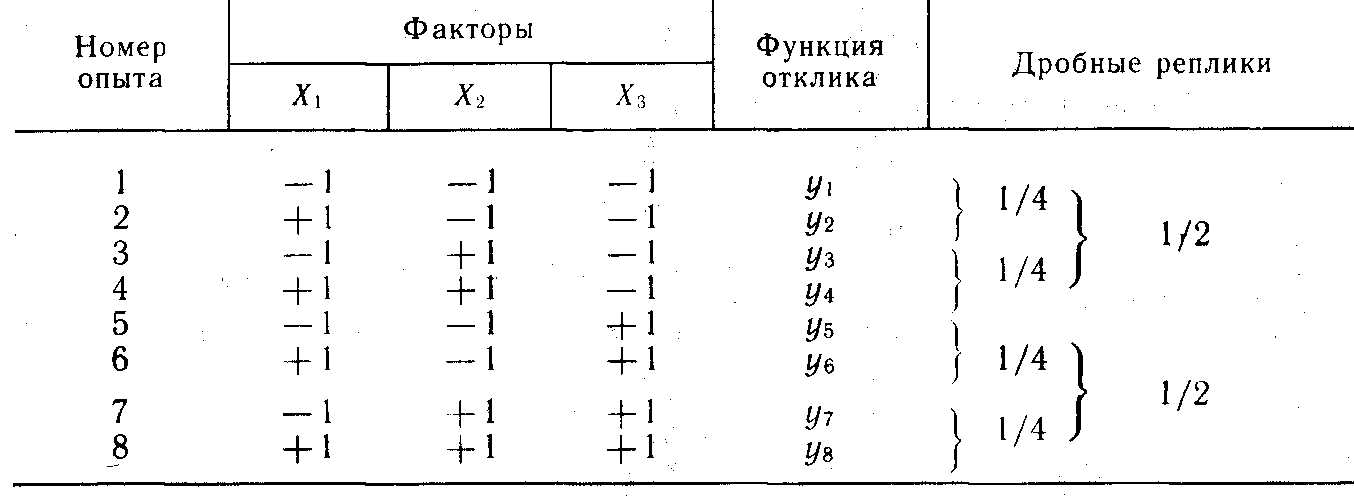
т. д. Такие системы
опытов называются
дробными
репликами табл.
19.
Таблица 19
Полный трехфакторный эксперимент и его дробные реплики
Расчет коэффициентов регрессии, проверка значимости коэффициентов и адекватности математического описания в данном случае осуществляются так же, как и при полном факторном эксперименте.
Пусть требуется найти коэффициенты уравнения регрессии
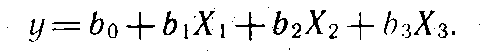
Если
для этой цели
воспользоваться
полным трехфакторным
экспериментом,
то необходимо
провести 8 опытов.
Однако эту
задачу можно
решить и с помощью
меньшего числа
опытов. Например,
возьмем матрицу
полного двухфакторного
эксперимента
табл. 20 и приравняем
произведение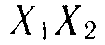 к фактору

Рассчитаем коэффициенты регрессии:
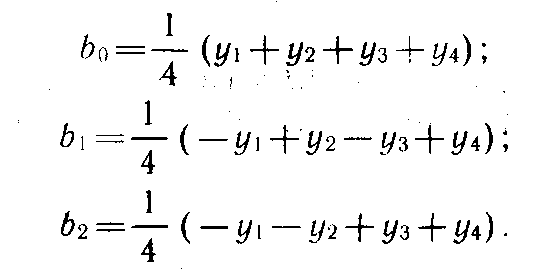
Обратим
внимание на
то, что в табл.
20 столбцы для
произведенияи
фактора полностью
совпадают.
Поэтому коэффициенты
регрессии
 и
 не
могут быть
определены
раздельно.
Таблица 20 Дробный факторный эксперимент типа 23-1
| Номер опыта | X1 | X2 | X1X2 | X3 | Функция отклика |
| 1 | - 1 | - 1 | + 1 | + 1 | y1 |
| 2 | + 1 | - 1 | - 1 | - 1 | y2 |
| 3 | - 1 | + 1 | -1 | - 1 | y3 |
| 4 | + 1 | + 1 | + 1 | + 1 | y4 |
Может быть найдена только их сумма:
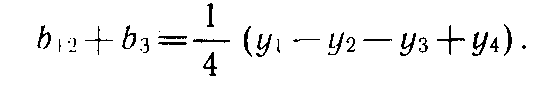
Этот недостаток рассматриваемого плана является своеобразной «платой» за уменьшение общего числа опытов с восьми до четырех.
Такое
планирование
эксперимента,
когда некоторые
из факторов
приравнивают
к произведениям
нескольких
факторов, называется
планированием
со смешиванием.
Его
обозначают
символом
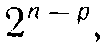 где
 —
общее число
факторов, а
 —
число факторов,
приравненных
к произведениям.
С этой точки
зрения в табл.
20 приведена
матрица планирования
типа
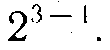
Существует правило, позволяющее определить, какие коэффициенты регрессии определяются совместно при планировании со смешиванием. Рассмотрим это правило на примере.
Методом дробных реплик будем искать математическое описание процесса в виде уравнения регрессии
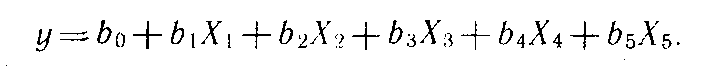
Воспользуемся
планированием
типа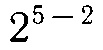 и
примем
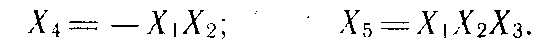
Такие равенства в методе дробных реплик называются генерирующими соотношениями.
Следует отметить, что выбор генерирующих соотношений в общем случае произволен. Однако он существенно влияет на характер совместных оценок коэффициентов регрессии.
Правило определения совместных оценок коэффициентов заключается в следующем:
Примем во внимание, что
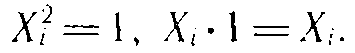
Умножив
обе части
генерирующих
соотношений
соответственно
на и
 получим:

Эти равенства называются определяющими контрастами. Перемножив их почленно, получим новые определяющие контрасты.
В данном случае _
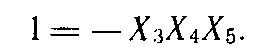
3. Составим алгебраическую сумму из единицы и правых частей всех полученных определяющих контрастов:
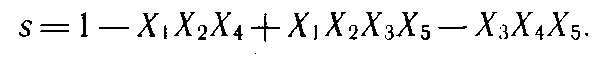
4. Умножив каждый из факторов на s и заменив факторы соответствующими коэффициентами регрессии р получим искомые совместные оценки:
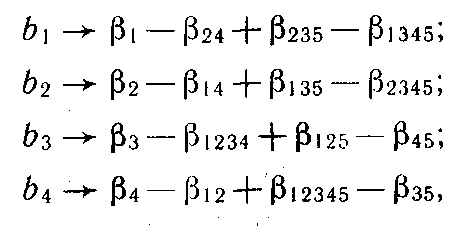
где —
истинные
коэффициенты
регрессии.
В
рассмотренном
примере удалось
значительно
сократить общее
количество
опытов. Так,
полный пятифакторный
эксперимент
состоит из 32
опытов. План
типа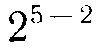 содержит
8 опытов, т. е. в
четыре раза
меньше.
Отметим еще одну интересную особенность дробного факторного эксперимента. Планирование со смешиванием иногда применяют в тех случаях, когда необходимо уменьшить влияние неуправляемых временных изменений некоторых влияющих факторов, т. е. влияние так называемого временного дрейфа. Примером временного дрейфа может служить уменьшение со временем активности катализатора вследствие отравления его каталитическими ядами.
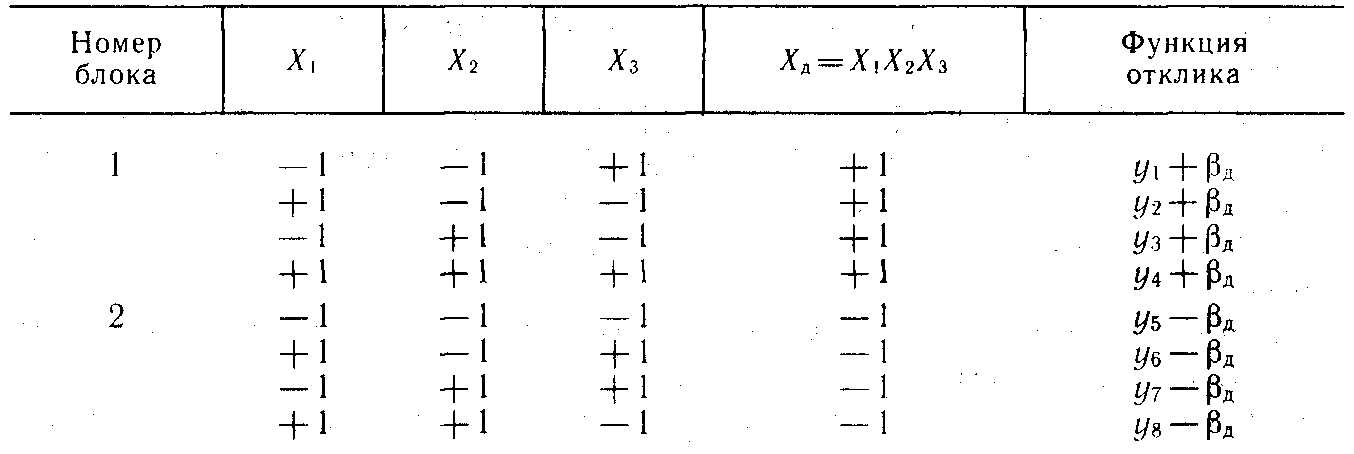
При постановке большой серии опытов, требующих длительного времени, всегда приходится опасаться нежелательных изменений исходных свойств реагентов, некоторых характеристик технологического оборудования и т. п. Влияние этого временного дрейфа на параметры математического описания процесса можно практически устранить, разбивая всю серию опытов на отдельные блоки так, чтобы эффект от временного дрейфа оказался смешанным с произведениями факторов, для которых коэффициенты регрессии достаточно малы.
Допустим, что необходимо устранить влияние временного дрейфа на параметры уравнения регрессии, получаемого в результате полного трехфакторного эксперимента. С этой целью разобъем эксперимент на два блока и введем новую независимую переменную ХЛ, характеризующую дрейф. Положим
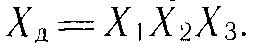
Исходя
из матрицы
планирования,
представленной
в табл. 21, будем
считать, что
в первом блоке
все результаты
опытов вследствие
временного
дрейфа завышены
на а
во втором —
занижены на
ту же величину.
Таблица 21 Планирование в условиях временного дрейфа
Если уравнение регрессии отыскивается в виде
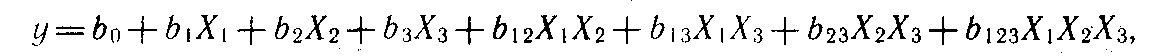
то коэффициенты регрессии будут являться следующими оценками:
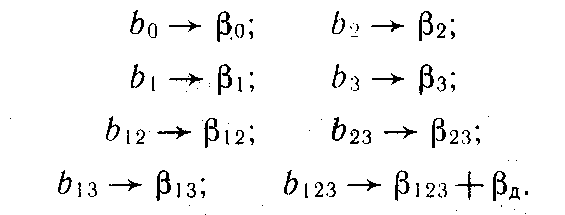
Рассчитаем,
например,
коэффициенты и
 :
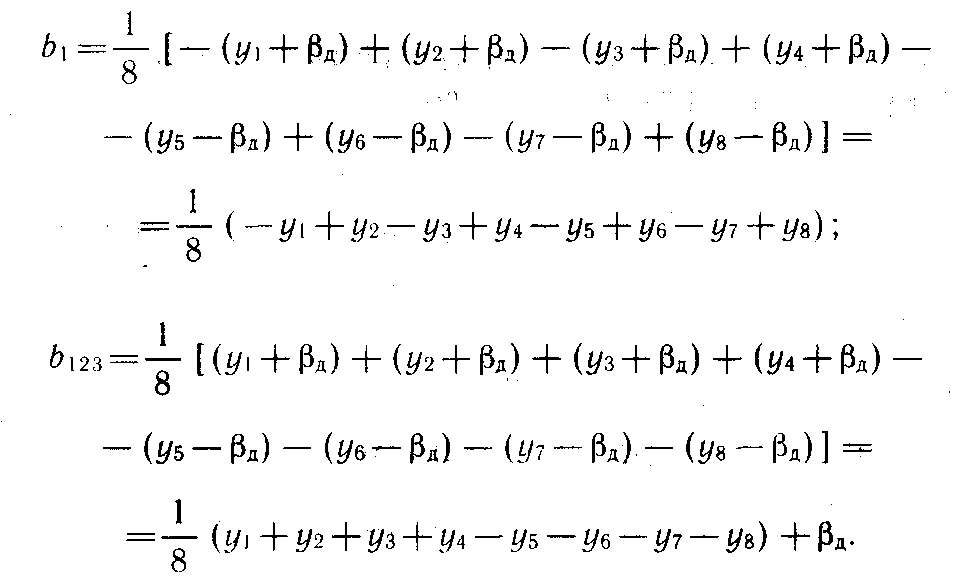
Следовательно,
все коэффициенты
регрессии,
кроме не содержат
погрешностей,
обусловленных
временным
дрейфом.
Крутое восхождение
Полученное с помощью полного или дробного факторного эксперимента уравнение регрессии служит не только математической моделью химико-технологического процесса, но используется и для его оптимизации. Оптимизацией процесса называют целенаправленный поиск наилучших в определенном смысле условий его проведения. Задачи оптимизации приходится решать при разработке новых технологий и реконструкции действующих производств.
Величина, характеризующая уровень оптимизации процесса, называется критерием оптимальности или целевой функцией. Например, критерием оптимальности может быть выход целевого продукта химической реакции в расчете на израсходованное сырье.
Качество процесса химической технологии обычно выражается не одним, а несколькими показателями. Безусловно, хочется, чтобы все показатели достигали одновременно своих наилучших значений. К сожалению, это невозможно. Например, максимальная производительность оборудования и минимальная себестоимость продукции обычно имеют место при различных технологических режимах.
Чтобы осуществлять оптимизацию, необходимо располагать определенными ресурсами. Например, для увеличения выхода целевого продукта химической реакции, мы должны иметь возможность варьировать в определенных пределах значениями таких величин, как температура реакционной-смеси, исходные концентрации реагентов и т. д.
Оптимизацию проводят, как правило, в условиях ограничений на ресурсы оптимизации и некоторые выходные параметры процесса.
Задачу оптимизации можно сформулировать следующим образом. Задан критерий оптимальности
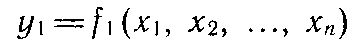
и ограничения на остальные выходные параметры процесса:
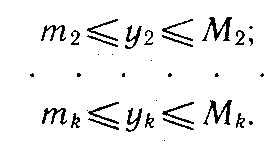
Заданы ограничения на ресурсы оптимизации:
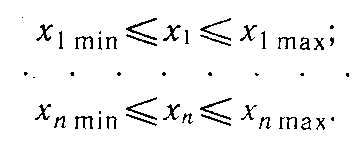
Требуется
найти такие
значения ресурсов
оптимизации
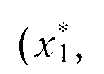
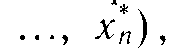 при которых
критерий
оптимальности
достигает
своего экстремального
(т.
е. наибольшего
или наименьшего)
значения.
Д. Бокс и К. Уилсон предложили использовать для оптимизации результаты полного или дробного факторного эксперимента. Сущность этого метода состоит в следующем.
Среди
всех имеющихся
функций отклика,
описывающих
объект оптимизации,
выбирают одну
наиболее важную
и принимают
ее в качестве
критерия
оптимальности Затем
указывают
ограничения,
накладываемые
на остальные
функции отклика
и на влияющие
факторы.
Один
из наиболее
сильно влияющих
факторов принимают
за базовый и
для него вычисляют
произведение
соответствующего
коэффициента
регрессии на
шаг варьирования.
Например, для
первого фактора
это произведение
имеет вид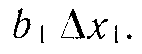 Затем
для базового
фактора выбирают
шаг
 с
которым будет
осуществляться
оптимизация.
С целью более
точного нахождения
координат
оптимума обычно
принимают
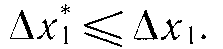
После этого вычисляют отношение
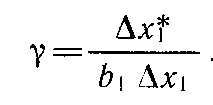
Для всех остальных факторов шаги движения к оптимуму рассчитывают по формуле
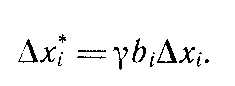
Движение
к оптимуму
начинают из
центра
плана,
который был
использован
для получения
уравнения
регрессии.
Значения факторов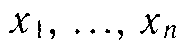 на
каждом новом
шаге оптимизации
находят путем
прибавления
 к
соответствующим
предыдущим
значениям. Так
осуществляется
оптимизация
по методу Бокса
и Уилсона,
получившему
название метода
крутого восхождения.
Отметим
некоторые
особенности
этого метода.
Движение из
центра плана
начинается
в сторону наиболее
быстрого увеличения
критерия
оптимальности.
Это происходит
благодаря тому,
что шаги
 пропорциональны
коэффициентам
регрессии

Если
ищется минимум
критерия то
новые значения
факторов
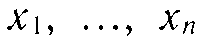 находят из
предыдущих
путем вычитания
 Такой
способ оптимизации
назван методом
наискорейшего
спуска.
Движение
к экстремуму
прекращают
при выполнении
следующих
условий: 1) значения
факторов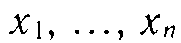 (одного
или нескольких)
или функций
отклика
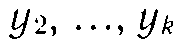 (одной
или нескольких)
вышли на допустимые
границы; 2) достигнут
экстремум
критерия
оптимальности.
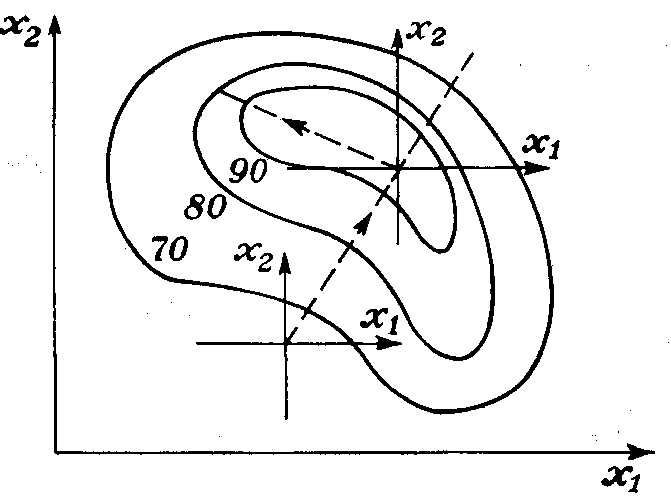
Рис. 23. Оптимизация по методу крутого восхождения
Как
следует из рис.
23, в ходе крутого
восхождения
по поверхности
отклика сначала
может быть
достигнут
локальный
экстремум на
направлении
движения. В
таком случае
необходимо
в окрестности
этого экстремума
поставить новый
полный факторный
эксперимент
и реализовать
новое крутое
восхождение.
Отметим, что в реальных условиях оптимум обычно находится на границах области допустимых значений
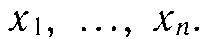
1.4 Среда для моделирования технологических процессов Visual Studio.NET
Из чего состоит .NET Framework, NET Framework состоит прежде всего из огромной библиотеки программ, к которой можно обращаться из различных языков программирования (например из С#) с помощью различных технологий объектно-ориентированного программирования (ООП, object-oriented programming). Эта библиотека разбита на несколько различных модулей таким образом, что имеется возможность использовать ту или иную ее часть в зависимости от требуемых результатов. Так, например, в одном из модулей содержатся "кирпичики", из которых можно построить Windows-приложения, в другом — "кирпичики", необходимые для организации работы в сети, в третьем — все необходимое для развития Всемирной паутины (Web). Некоторые из этих модулей подразделяются на более специфические подмодули: к примеру, в состав модуля для развития Паутины входит подмодуль, предназначенный для создания web-служб.
Основная идея в данном случае заключается в том, что различные операционные системы могут поддерживать некоторые или все из этих модулей (что зависит от характеристик этих операционных систем). Так, PDA потенциально мог бы поддерживать все основные функциональные возможности .NET, однако маловероятно, чтобы ему потребовались какие-либо более хитрые модули.
Часть библиотеки .NET Framework посвящена описанию некоторых базисных типов. Тип — это способ представления данных; определение наиболее фундаментальных из них (например 32-разрядного целого со знаком) облегчает совместное использование языков программирования с помощью .NET Framework. Все вместе это называется Common Type System (CTS — единая система типов)
Кроме вындописанной библиотеки, в состав системы входит также NET Common Language Runtime (CLR — единая система выполнения программ), которая ответственна за поддержку выполнения всех приложении, разработанных с использованием библиотеки .NET,
Как можно создавать приложения с помощью .NET Framework
Создание приложений с помощью .NET Framework означает написание программы (на любом из языков программирования, поддерживаемых системой) посредством использования библиотеки программ. В этой книге для наших разработок мы будем использовать VS, который представляет собой мощную интегрированную среду разработки, поддерживающую С# (а также управляемый и не управляемый
С+ + , Visual Basic.NET и некоторые другие языки программирования). Преимуществом данной среды является та простота, с которой возможности .NET могут быть интегрированы в наши программы. Код, который мы будем создавать, будет целиком написан на С#, однако в нем повсеместно будут использоваться возможности .NET Framework, а там, где возникнет необходимость, мы будем применять в VS дополнительные инструменты.
Для того чтобы написанная на С# программа могла быть выполнена, ее необходимо преобразовать в язык, понятный операционной системе, на которой эта программа будет выполняться; такой язык известен под названием родного кода. Подобное преобразование называется компиляцией программы н выполняется компилятором. Однако в .NET этот процесс состоит нз двух этапов.
MSIL и ЛТ
При компиляции кода, в котором используется библиотека .NET Framework, мы не получаем сразу родной код для конкретной операционной системы. Напротив, наша программа будет откомпилирована в программу на языке Microsoft Intermediate Language (MSIL — промежуточный язык компании Microsoft). Этот код не является специфическим ни для какой операционной системы и так же точно не является специфическим для С#. Компиляция с других языков программирования .NET — например с Visual Basic.NET — на первом этапе тоже происходит на этот язык. Данный этап компиляции выполняется VS в тех случаях, когда мы используем его для разработки приложений на С#,
Очевидно, что для запуска приложения потребуется сделать некоторую дополнительную работу. Эта работа возлагается на ЛТ-компилятор (Just-In-Time, своевременный), который осуществляет компиляцию MSIL-кода на код, специфический для ОС и архитектуры используемого компьютера. Только после этого операционная система может выполнить приложение.
В прошлом часто возникала необходимость транслировать написанную программу в несколько различных приложении, каждое нз которых предназначалось для конкретной операционной системы и архитектуры центрального процессора, Нередко это был один нз способов оптимизации (направленной на то, чтобы программа, к примеру, быстрее выполнялась на AMD-чнпах), но иногда это оказывалось критичным (например, когда приходилось использовать некоторые приложения одновременно и в среде Win9x, и в среде WinNt/2000). Теперь такая необходимость исчезла, поскольку ЛТ-компнляторы (как и предполагает их название) используют код на языке MSIL, который совершенно независим от компьютера, операционной системы н центрального процессора. Существует несколько различных JIT-компиляторов, каждый нз которых предназначается для некоторой конкретной архитектуры, поэтому для создания родного кода, необходимого в том или ином случае, будет использоваться соответствующий ЛТ-компилятор.
Удобство такого подхода заключается в том, что теперь приходится выполнять существенно меньший объем работы: фактически мы получаем возможность просто забыть о системно-зависимых особенностях и сконцентрироваться на более интересных функциональных возможностях создаваемой программы.
Модули
Когда выполняется компилирование приложения, создаваемый MSIL-код сохраняется в некотором модуле (assembly). В состав таких модулей входят как выполняемые файлы приложений, которые могут быть запущены из Windows напрямую и которым для работы не требуется никаких других программ (такие файлы имеют расширение .ехе), так и библиотеки, предназначенные для использования другими приложениями (они имеют расширение .dil).
Кроме данных на языке MSIL, в модулях хранятся метаннформацня (т. е. информация об информации, хранящейся в данном модуле, иначе известная под названием метаданных) и дополнительные ресурсы (дополнительные данные, используемые MSIL, например звуковые и графические файлы). Метаинформация делает модули полностью самоописательными. Для использования модуля не требуется никакой дополнительной информации; другими словами, исключается ситуация, когда не удается добавить необходимые данные в системный регистр, и все подобные ей, что составляло серьезную проблему прн разработке приложений на других платформах.
Отсюда следует, что установка приложений зачастую сводится к простому копированию файлов в директорию удаленного компьютера. Поскольку системам, под управлением которых будет выполняться приложение, не требуется никакой дополнительной информации, мы получаем возможность просто запускать выполняемый файл из этой директории (при условии, что на данном компьютере инсталлирована CLR.NET) без каких-либо дополнительных действий,
Естественно, размещать все необходимое для выполнения приложения в одном месте не обязательно. Существует возможность создавать код, выполняющий задачи, которые могут потребоваться нескольким приложениям. В подобных ситуациях полезно располагать такой многократно используемый код в месте, доступном всем приложениям. В .NET Framework таким местом является Global Assembly Cache (GAC — кэш глобальных модулей). Разместить код в таком кэше очень просто: для этого необходимо просто поместить модуль, содержащий соответствующую программу, в директорию, содержащую этот кэш.
Управляемый код
Использование CLR не ограничивается тем моментом, когда мы откомпилировали программу на MSIL, а некоторый ЛТ-компнлятор откомпилировал MSIL в родной код. Код, написанный с помощью .NET Framework, является управляемым на этапе выполнения (данный этап зачастую называется временем выполнения (runtime)). Это означает, что CLR отслеживает выполнение приложений, управляя памятью, межъязыковой отладкой, обеспечением безопасности и т. п.
Напротив, приложения, которые выполняются не под контролем CLR, называются неуправляемыми, и в них можно использовать определенные языки программирования, такие как С + + , для получения, например доступа к функциям нижнего уровня операционной системы. Однако на С# можно писать только код, который выполняется в управляемой среде. Мы будем использовать возможности CLR по управлению кодом и возложим осуществление любых взаимодействий с операционной системой на .NET.
Сборка мусора
Одной нз наиболее важных особенностей управляемого кода является понятие "сборка мусора". Это способ, применяемый в .NET и гарантирующий полное освобождение памяти, использовавшейся приложением, по завершении работы этого приложения. До появления .NET эта задача возлагалась на программистов, и наличие в программе пары простых ошибок могло привести к ситуации, когда огромные блоки памяти таинственным образом исчезали. Обычно это приводило к постепенному замедлению работы компьютера с последующим крахом системы,
Сборка мусора в .NET работает путем как можно более частого инспектирования памяти компьютера и удаления из нее всего, что уже не требуется. Здесь не существует никаких заранее определенных временных рамок; этот процесс может запускаться с частотой несколько тысяч раз в секунду или один раз в несколько секунд, но вы можете быть уверены, что рано нлн поздно это случиться.
В связи с этим программисты должны учитывать несколько важных аспектов. Поскольку подобные действия выполняются в заранее не известные моменты, приложения нужно разрабатывать с учетом этой особенности. Код, который использует большое количество памяти, должен сам очищать память, а не полагаться на автоматическую сборку мусора, тем более что реализовать это не так уж сложно.
Связывание
Существует еще одни момент, который необходимо учитывать в вышеприведенном процессе. Код на С#, который компилируется иа MSIL на шаге 2, совсем не обязательно должен находиться в одном файле. Имеется возможность разнести код приложения по нескольким исходным файлам, которые затем будут скомпилированы в единый модуль. Этот процесс известен под названием "связывание" н является чрезвычайно полезным. Причина такого положения дел заключается в том, что работать с несколькими не очень большими файлами намного легче, чем с одним огромным. Можно выделить логически связанный код в отдельный файл, работа иад которым будет вестись совершенно независимо и о котором можно забыть после того, как произойдет компиляция. Такой подход существенно упрощает выявление конкретных сегментов кода, когда они оказываются нужными, а заодно позволяет командам разработчиков разделить бремя программирования на отдельные куски, которые затем можно выверять без риска повредить правильно работающие сегменты и те части кода, иад которыми трудятся другие программисты.
Что такое С#
Как отмечалось выше, С# — один нз языков программирования, который может использоваться для создания приложений, выполняемых в среде .NET CLR. Этот язык — результат эволюции языков С и