Проектирование адаптивной сети нейро-нечеткого вывода для контроля критической зависимости параметров гемодинамики по модели измерений предрейсовых осмотров
где
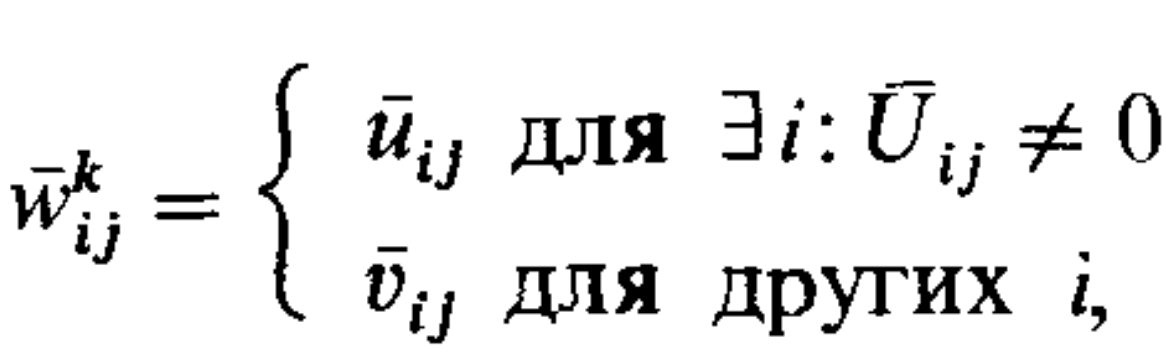 (2.17)
Где
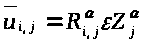 ,
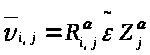
(обозначения
 ,
 объяснены в
дополнении).
Кроме того, решение для выражения (2.9) можно получить, найдя вектор
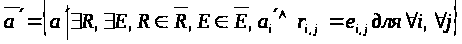 ,
(2.18)
Это решение имеет следующий вид:
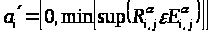 ,
 .
(2.19)
Следовательно,
решение, удовлетворяющее
формулам (2.15),
(2.19), для любых
 имеет вид
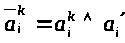 ,
,
(2.20)
где
 определяется
следующим
образом:
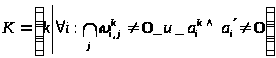 . (2.21)
Если
 ,
решения не
существует.
В этом случае
можно рекомендовать
следующие
способы решения:
1) уменьшить значение параметра а (а-сечение), отражающего точность выводов, и делать повторные выводы, приближая этот параметр к нулю;
2) повторно
расспросить
больного о
симптоме ,
исправить
данные на уточненные
и вновь сделать
выводы.
Первый способ позволяет легко получить результаты с достаточно высокой степенью нечеткости в целом, но он не слишком эффективен. Поэтому целесообразно применить второй способ.
2.2.4 Усовершенствованный метод диагностики
Выше мы рассмотрели случай, когда существует решение обратной задачи при некотором заданном значении а. Однако, например, если а = 0,6, решение существует, но при а > 0,8 уже не существует, т. е. прийти к решению не всегда возможно. Обычно в подобных случаях недостаточно информации о симптомах, и лучше повторить диагностику после получения более полной информации. Следовательно, необходимо рассмотреть какие-либо методы выбора нужных симптомов. Например, в случае ошибочных исходных данных можно использовать усовершенствованную диагностику, которая позволяет прийти к правильному диагнозу. Такая диагностика состоит в следующем.
Прежде всего
рассмотрим
следующий
вектор
 ,
элементами
которого являются
ЛЗИ элементов
нечеткого
множества
болезней по
отношению к
симптомам:
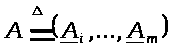 .
(2.22)
i-й базовый вектор А определим следующим образом:
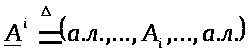 ,
,
(2.23)
где а. л. означает «абсолютная ложь».
 -вектор,
в котором только
i-й
элемент есть
,
а все остальные
элементы - а.л.
Другими словами,
учитывается
только возможность
появления
болезни i,
а уровень ЛЗИ
для всех остальных
болезней есть
а.л. Кроме того,
предложим
следующие
варианты ЛЗИ,
относящиеся
к
 :
L = {ложь, неизвестно, истина, абсолютная истина}. Если применить к формулам (2.6), (2.7) правила нечеткий «модус поненс» и нечеткий «модус олленс» соответственно, то для i, j получим следующие формулы:
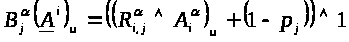 ,
(2.24)
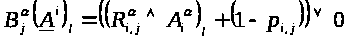 .
(2.25)
Приближение
(среднее арифметическое
ожидаемое
значение)
 полученное
с помощью ЧЗИ
для симптома,
предсказанного
в случае
 ,
есть вектор,
элементы которого
имеют следующий
вид:
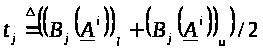 ,
 .
(2.26)
Аналогично
определим
среднее арифметическое
значение b
для реально
наблюдаемых
симптомов.
Элементы
 зададим следующим
образом:
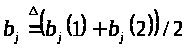 ,
.
(2.27)
Направление
новых наблюдений
можно определить
с учетом геометрической
формы
 и
 ,
т.е. чтобы определить
группу симптомов,
которые следует
проверить,
вычислим разность
 и
.
Алгоритм вычислений
заключается
в следующем.
Сначала рассмотрим
обычное расстояние
 :
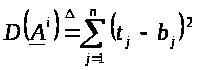 .
(2.28)
есть разность
ожидаемых
значений истинности
симптомов при
 .
Это один из
способов определения
расстояния,
кроме него
можно рассматривать
другие расстояния.
Кратчайшее
расстояние
 определим
следующим
образом:
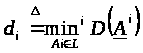 ,
,
(2.29)
а именно
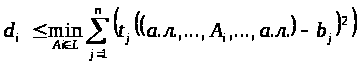 .
(2.30)
Запомним
 ,
удовлетворяющую
следующему
условию:
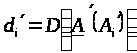 ,
.
(2.31)
 представляет
собой значение,
при котором
 является минимальным
для
 при любой болезни
i.
При этом пусть
 -это
,
задающее
.
Затем вычислим
 такое,
что
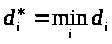 .
(2.32)
определяет
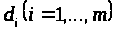 для болезней,
среди которых
есть номер
болезни с самым
маленьким
.
Учитывая значения
истинности
симптомов,
определим
базовый вектор
 для болезни,
разность ожидаемых
и наблюдаемых
значений для
которой наименьшая:
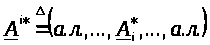 .
(2.33)
Этот вектор
позволяет
создать относительный
критерий истинности
значений для
симптомов.
Кроме того,
получим
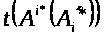 ,
т.е.
 ,
который можно
сравнить с
для каждого
элемента.
Итак, можно
указать группу
симптомов,
соответствующую
номеру с наибольшим
значением
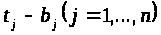 .
Если прогнозируется
появление
одновременно
двух и более
болезней, данный
алгоритм
предполагается
усовершенствовать,
например путем
изучения комбинации
базовых векторов
 .
2.2.5 Выводы и база знаний
В качестве методов нечетких выводов с использованием нечеткой информации известны продукционные правила, выводы с помощью нечетких отношений и другие методы. В данной системе из-за того, что знания имеют иерархическую структуру (что позволяет делать окончательную оценку с использованием промежуточных гипотез об оценке результатов обследования, рекомендаций по образу жизни и других гипотез) и есть необходимость запуска механизма выводов не в режиме диалога, а по факту ввода данных, использованы выводы с помощью продукционных правил с прямым построением цепочки рассуждений. По мере прослеживания правил метод построения цепочки увеличивает нечеткость, поэтому в системе результаты выдаются на втором или третьем уровне иерархии.
При вводе данных клинических анализов, информации, полученной при расспросе пациента, и при выводе тяжести болезни или других сведений используются непосредственные значения или лингвистические значения
ности. Механизм выводов является независимой подсистемой (рисунок 2.4). На входы поступают данные из базы фактов и базы знаний, а на выход передаются результаты выводов, их достоверность и объяснение процесса выводов.
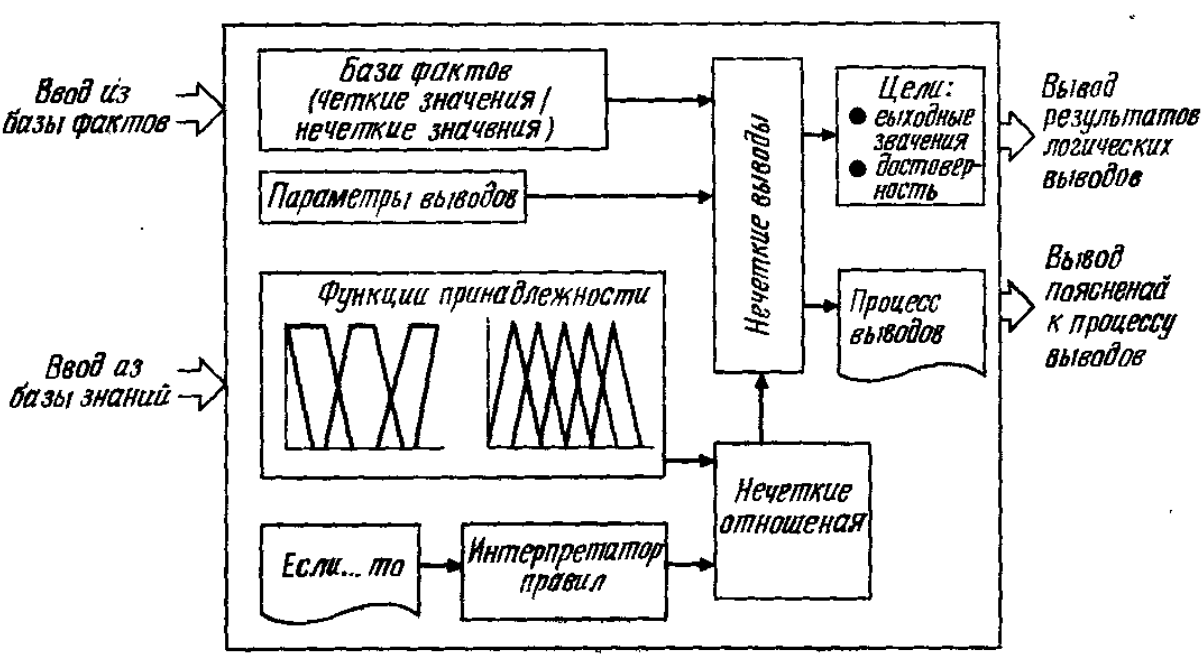
Рисунок - 2.4 Схема механизма выводов.
Для выводов использован нечеткий «модус поненс», представляющий собой расширение правила «модус поненс» - дедуктивного вывода в классической логике. Это правило можно представить следующим образом:
Если
 и
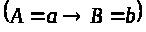 ,
тогда
 ,
(2.34)
где
 -нечеткие множества
в полных пространствах
 ,
соответственно
их элементы
обозначим через
 .
Знак
 обозначает
импликацию.
Если можно
получить информацию
