Ссылочные типы. Динамические переменные
Последний элемент списка содержит указатель, связывающий его с первым элементом. Для полного обхода такого списка достаточно иметь указатель только на текущий элемент.
В двунаправленном циклическом списке система указателей аналогична системе указателей двунаправленного линейного списка (см. рис 4).
Двунаправленный циклический список позволяет достаточно просто осуществлять вставки и удаления элементов слева и справа от текущего элемента. В отличие от линейного списка, элементы являются равноправными и для выделения первого элемента необходимо иметь указатель на заголовок. Однако во многих случаях нет необходимости выделять первый элемент списка и достаточно иметь указатель на текущий элемент.
Разберем решение типичной задачи, связанной с обработкой списков.
Текст задания
С использованием списков, заданный во входном файле текст (за которым следует точка) распечатать в обратном порядке.
Решение
program reverse;
type List= ^Elem;
Elem= record
Info: Char;
Next: List
end;
var
L, p: List;
c: char;
begin
{ввод литер текста и запись их в обратном порядке в список L (без заглавного звена)}
L:= nil; {ссылка на построенную часть списка}
read( c );
while c <> '.' do begin
{добавить с в начало списка}
new( p );
p^.Info:= c;
p^.Next:= L;
L:= p;
read( c )
end;
{печать литер из L}
while L <> nil do begin
write( L^.Info );
L:= L^.Next
end;
writeln
end.
3. Очереди и стеки
Очередь и стек представляют собой структуры данных с фиксированными механизмами занесения и выбора элементов. Возможны реализации очереди и стека на базе регулярных или списковых структур данных. Соответственно представлению изменяется реализация механизмов обработки структур. Однако определяющими являются следующие принципы: очередь предполагает занесение нового элемента в конец, а выбор с начала списка (FIFO √ First In First Out); в стек элемент заносится в начало и выбирается также сначала (LIFO √ Last In First Out).
3.1 Очередь на базе списка
Из механизма FIFO следует, что в очереди доступны два элемента √ первый и последний простая очередь (см. рис. 5).
Структура данных, представляющая очередь, могла бы выглядеть следующим образом:
type
TypeOfElem= {};
Assoc= ^ElementOfQueue;
ElementOfQueue= record
Elem: TypeOfElem;
NextElem: Pointer
end;
Queue= Assoc;
3.2 Создание (очистка) очереди
Для создания новой пустой или очистки существующей очереди достаточно присвоить указателям на первый и последний элементы значение nil.
procedure CreateQueue ( var FirstElem, LastElem: Queue);
begin
FirstElem:= nil;
LastElem:= nil
end;
3.3 Проверка очереди на пустоту
Условием пустоты очереди является значения указателей на первый и последний элементы, равные nil.
function QueueIsClear( var FirstElem, LastElem: Queue ): Boolean;
begin
QueueIsClear:= ( FirstElem= nil ) and ( LastElem= nil )
end;
3.4 Включение элемента в очередь
Для включения элемента в очередь, необходимо создать новый элемент типа очередь, затем инициализировать его информационное поле. В заключение изменить его указатель и указатель на последний элемент очереди так, чтобы последним стал новый элемент.
procedure IncludeInQueue( var FirstElem, LastElem: Queue; NewElem: TypeOfElem);
var
ServiceVar: Queue;
begin
{создание нового элемента}
new( ServiceVar );
ServiceVar^.Elem:= NewElem;
ServiceVar^.NextElem:= nil;
if ( FirstElem= nil ) and ( LastElem= nil ) then begin
{создать очередь из одного элемента}
FirstElem:= ServiceVar;
LastElem:= ServiceVar
end
else begin
{созданный элемент поместить в конец очереди}
LastElem^.NextElem:= ServiceVar;
LastElem:= ServiceVar
end
end;
3.5 Выбор элемента из очереди
При выборе элемента из очереди информационное поле первого ее элемента должно быть присвоено результирующей переменной, а сам элемент должен быть исключен из очереди и удален. Здесь необходима также проверка на то, являлся ли этот элемент в очереди единственным, и если да, то необходимо соответствующим образом изменить указатель на последний элемент.
procedure SelectFromQueue( var FirstElem, LastElem: Queue; var Result: TypeOfElem);
var
ServiceVar: Queue;
begin
if not ( ( FirstElem= nil ) and ( LastElem= nil ) ) then begin
Result:= FirstElem^.Elem;
ServiceVar:= FirstElem;
{убираем 1-ый элемент из очереди}
FirstElem:= FirstElem^.NextElem;
{был ли это последний элемент}
if FirstElem= nil then
LastElem:= nil;
dispose( ServiceVar )
end
end;
3.6 Стек на базе списка
Из механизма LIFO следует, что в стеке доступен только последний занесенный его элемент √ так называемая вершина стека. Главный элемент, представляющий весь список как единый объект, в случае стека оказывается лишним, его роль выполняет вершина стека. Элемент, занесенный в стек раньше других имеет ссылку nil (см. рис. 6).
Структура данных, представляющая стек, могла бы выглядеть следующим образом:
type
TypeOfElem= {};
Assoc= ^ElementOfStack;
ElementOfStack= record
Elem: TypeOfElem;
NextElem: Pointer
end;
Stack= Assoc;
Рассмотрим реализацию основных операций над стеком.
3.7 Создание (очистка) стека
Для создания нового пустого или очистки существующего стека достаточно присвоить указателю на первый его элемент (вершину) значение nil.
procedure CreateStack ( var StackHead: Stack);
begin
StackHead:= nil
end;
3.8 Проверка стека на пустоту
Условием пустоты стека является значение его вершины, равное nil.
function StackIsClear( var StackHead: Stack ): Boolean;
begin
StackIsClear:= ( StackHead= nil )
end;
3.9 Занесение элемента в стек
Для включения элемента в стек, необходимо создать новый элемент типа стек, затем инициализировать его информационное поле. В заключение изменить его указатель и указатель на первый элемент стека так, чтобы первым стал новый элемент.
procedure IncludeInStack( var StackHead: Stack; NewElem: TypeOfElem );
var
ServiceVar: Stack;
begin
{создание нового элемента}
new( ServiceVar );
ServiceVar^.Elem:= NewElem;
{созданный элемент сделать вершиной стека}
ServiceVar^.NextElem:= StackHead;
StackHead:= ServiceVar
end;
3.10 Выбор элемента из стека
При выполнении этой операции информационное поле элемента, находящегося в вершине стека, должно быть присвоено в качестве значения некоторой переменой, а сам элемент должен быть исключен из стека и уничтожен.
procedure SelectFromStack( var StackHead: Stack; var Result: TypeOfElem);
var
ServiceVar: Assoc;
begin
if StackHead <> nil then begin
{выбор элемента из вершины}
Result:= StackHead^.Elem;
{запоминание ссылки на старую вершину}
ServiceVar:= StackHead;
{исключение из стека и уничтожение элемента}
StackHead:= StackHead^.NextElem;
dispose( ServiceVar )
end
end;
Необходимо обратить внимание на введение вспомогательной переменной ссылочного типа ServiceVar для осуществления удаления элемента. Типична ошибка, связанная с попыткой решить эту задачу через dispose( StackHead ).
Разберем решение типичной задачи, связанной с обработкой стека.
Текст задания
Используя стек (считать уже описанными тип Stack с информационным элементом типа Char, функцию StackIsClear (проверка пустоты стека) и процедуры CreateStack (очистка стека), IncludeInStack (вставка элемента в стек), SelectFromStack (выборка элемента из стека)) решить следующую задачу: в текстовом файле f записана без ошибок формула следующего вида:
<формула>::= <цифра>|M(<формула>,<формула>)|m(<формула>,<формула>)
цифра::= 0|1|2|3|4|5|6|7|8|9
где M обозначает функцию max, а m √ min. Вычислить (как целое число) значение данной формулы (например, M( 5, m( 6, 8)): 6).
Решение
program StackSample;
type
FileType= File of Char;
var
Source: FileType;
function formula( var t: FileType ): integer;
type
TypeOfElem= Char;
Assoc= ^ElementOfStack;
ElementOfStack= record
Elem: TypeOfElem;
NextElem: Pointer
end;
Stack= Assoc;
var
S: Stack;
c, op, x, y: char;
procedure CreateStack ( var StackHead: Stack);
begin
StackHead:= nil
end;
function StackIsClear( var StackHead: Stack ): Boolean;
begin
StackIsClear:= ( StackHead= nil )
end;
procedure IncludeInStack( var StackHead: Stack; NewElem: TypeOfElem );
var
ServiceVar: Stack;
begin
{создание нового элемента}
new( ServiceVar );
ServiceVar^.Elem:= NewElem;
{созданный элемент сделать вершиной стека}
ServiceVar^.NextElem:= StackHead;
StackHead:= ServiceVar
end;
procedure SelectFromStack( var StackHead: Stack; var Result: TypeOfElem );
var
ServiceVar: Assoc;
begin
if StackHead <> nil then begin
{выбор элемента из вершины}
Result:= StackHead^.Elem;
{запоминание ссылки на старую вершину}
ServiceVar:= StackHead;
{исключение из стека и уничтожение элемента}
StackHead:= StackHead^.NextElem;
dispose( ServiceVar )
end
end;
begin
reset( t );
CreateStack( S );
while not eof( t ) do begin
read(t, c);
{обработка очередной литеры текста (литеры ╚(╩ и ╚,╩ игнорируются)}
if c in ['0'..'9','M','m'] then IncludeInStack( S, c)
else
if c= ')' then begin {конец формулы вида p(x, y)}
{в конце стека находится тройка op x y, она удаляется
из стека, выполняется операция op и результат
записывается в стек}
SelectFromStack( S, y );
SelectFromStack( S, x );
SelectFromStack( S, op );
case op of
'M'{max}: if x > y then c:= x else c:= y;
'm'{min}: if x < y then c:= x else c:= y
end;
IncludeInStack( S, c )
end
end; {of while}
{в стеке осталась одна цифра √ значение всей формулы; цифра переводится в целое число}
SelectFromStack( S, c );
formula:= ord( c ) - ord( '0' )
end;
begin
assign( Source, 'c:tempsource.txt' );
writeln( Formula( Source ) );
end.
4. Двоичные деревья
Элементы двоичного дерева помимо информативной части имеют две ссылки √ на нижний левый и на нижний правый элементы. Принцип построения двоичного дерева заключается в том, что очередной элемент в зависимости от значения информативной части должен попасть в правое (если информационная часть включаемого элемента больше информационной части корня) или левое (в противном случае) поддерево. При этом в рамках выбранного поддерева определение местоположения нового элемента производится аналогично (см. рис. 7).
Данную структуру целесообразно описать следующим образом:
type
TypeOfElem= {};
Assoc= ^ElemOfTree;
ElemOfTree= record
Elem: TypeOfElem;
Left, Right: Pointer
end;
4.1 Поиск элемента в дереве
function FoundInTree( Elem: TypeOfElem; var Tree, Result: Pointer ): Boolean;
var
ServiceVar: Assoc;
b: Boolean;
begin
b:= False;
ServiceVar:= Tree;
if Tree <> nil then
repeat
if ServiceVar^.Elem= Elem then b:= True
else
if Elem < ServiceVar^.Elem then ServiceVar:= ServiceVar^.Left
else ServiceVar:= ServiceVar^.Right
until b or ( ServiceVar= nil );
FoundInTree:= b;
Result:= ServiceVar
end;
4.2 Включение элемента в дерево
Включение элемента в дерево реализуется путем во-первых, поиска вершины √ предка нового элемента, во-вторых, непосредственным включением элемента в дерево по найденной позиции. Опишем процедуру поиска предка для нового элемента.
function SearchNode( Elem: TypeOfElem; var Tree, Result: Assoc): Boolean;
var
ServiceVar1, ServiceVar2: Assoc;
b: Boolean;
begin
b:= False;
ServiceVar1:= Tree;
if Tree <> nil then
repeat
ServiceVar2:= ServiceVar1;
if ServiceVar1^.Elem= Elem then {элемент найден} b:= True
else begin
{запоминание обрабатываемой вершины}
ServiceVar2:= ServiceVar1;
if Elem < ServiceVar1^.Elem then ServiceVar1:=
ServiceVar1^.Left
else ServiceVar1:= ServiceVar1^.Right
end
until b or ( ServiceVar1= nil );
SearchNode:= b;
Result:= ServiceVar2
end;
Как видно из описания, эта функция подобна ранее рассмотренной функции поиска элемента дерева (FoundInTree), но в качестве побочного эффекта фиксируется ссылка на вершину, в которой был найден заданный элемент (в случае успешного поиска), или ссылка на вершину, после обработки которой поиск прекращен (в случае неуспешного поиска). Сама процедура включения элемента в дерево будет иметь следующее описание.
procedure IncludeInTree( Elem: TypeOfElem; var Tree: Assoc );
var
Result, Node: Assoc;
begin
if not SearchNode( Elem, Tree, Result ) then begin
{формирование новой вершины в дереве}
new( Node );
Node^.Elem:= Elem;
Node^.Left:= nil;
Node^.Right:= nil;
if Tree= nil then
{если дерево пусто, то созданный элемент сделать вершиной дерева}
Tree:= Node
else
{подсоединить новую вершину к дереву}
if Elem < Result^.Elem then Result^.Left:= Node
else Result^.Right:= Node
end
end;
Двоичное дерево можно рассматривать как рекурсивную структуру данных, состоящую из корневой записи, указывающей на левое и правое поддерево. Оба поддерева имеют такую же структуру: корень поддерева и правое и левое поддеревья. При этом, для представления дерева рекурсивной динамической структурой целесообразно модифицировать описание типа дерева, данное выше. А именно, удобнее изменить тип ссылок на левое и правое поддеревья с нетипизированного (Pointer) на типизированный:
type
TypeOfElem1= {};
Assoc1= ^ElemOfTree1;
ElemOfTree1= record
Elem: TypeOfElem1;
Left, Right: Assoc1
end;
Опишем процедуру вставки элемента рекурсивно.
procedure IncludeInTree2( NewElem: Assoc1; var SubTree: Assoc1 );
begin
if SubTree= nil then begin
SubTree:= NewElem;
NewElem^.Left:= nil;
NewElem^.Right:= nil;
end
else
if NewElem^.Elem < SubTree^.Elem then
IncludeInTree2( NewElem, SubTree^.Left )
else
IncludeInTree2( NewElem, SubTree^.Right )
end;
4.3 Удаление элемента дерева
Проблема реализации данной операции состоит в том, что в общем случае, в удаляемую вершину входит одна связь, а выходят две. Поэтому, необходимо найти подходящий элемент дерева, который можно было бы вставить на место удаляемого. Этот элемент является либо самым правым элементом левого поддерева (для достижения этого элемента необходимо перейти в следующую вершину по левой ветви, а затем, переходить в очередные вершины по правым ветвям до тех пор, пока очередная такая ссылка не будет равна nil), либо самый левый элемент правого поддерева (для достижения этого элемента необходимо перейти в следующую вершину по правой ветви, а затем, переходить в очередные вершины по левым ветвям до тех пор, пока очередная такая ссылка не будет равна nil). Процедура исключения элемента из двоичного дерева должна различать тои случая:
1. элемента с заданной информативной частью в дереве нет; 2. элемент с заданной информативной частью имеет не более одной ветви; 3. элемент с заданной информативной частью имеет две ветви.
procedure DeleteElemOfTree( var Tree: Assoc1; Elem: TypeOfElem1 );
var
ServiceVar1: Assoc1;
procedure Del( var ServiceVar2: Assoc1 );
begin
if ServiceVar2^.Right= nil then begin
ServiceVar1^.Elem:= ServiceVar2^.Elem;
ServiceVar1:= ServiceVar2;
ServiceVar2:=ServiceVar2^.Left
end
else Del( ServiceVar2^.Right )
end;
begin
{удаление элемента с информативным полем равным Elem из дерева Tree}
if Tree= nil then
{первый случай процедуры удаления}
writeln( 'Элемент не найден' )
else
{поиск элемента с заданным ключом}
if Elem < Tree^.Elem then DeleteElemOfTree( Tree^.Left, Elem )
else
if Elem > Tree^.Elem then
DeleteElemOfTree( Tree^.Right, Elem )
else begin
{элемент найден, необходимо его удалить}
ServiceVar1:= Tree;
{второй случай процедуры удаления}
if ServiceVar1^.Right= nil then
Tree:= ServiceVar1^.Left
else
if ServiceVar1^.Left= nil then
Tree:= ServiceVar1^.Right
else
{третий случай процедуры удаления}
Del( ServiceVar1^.Left )
end
end;
Вспомогательная рекурсивная процедура Del вызывается лишь в третьем случае процедуры удаления. Она переходит к самому правому элементу левого поддерева удаляемого элемента, а затем заменяет информационное поле удаляемого на значение поля найденного элемента.
4.4 Вывод элементов дерева
Данная задача также может быть решена с помощью механизма рекурсии.
procedure PrintTree( Tree: Pointer);
var
ServiceVar: Assoc1;
begin
ServiceVar:= Tree;
writeln( ServiceVar^.Elem );
if ServiceVar^.Right <> nil then PrintTree(ServiceVar^.Right);
if ServiceVar^.Left <> nil then PrintTree(ServiceVar^.Left);
end;
Разберем решение типичной задачи, связанной с обработкой двоичных деревьев.
Текст задания
Описать процедуру copy( T, T1) которая строит T1 √ копию дерева T.
Решение
procedure CopyTree( T: Tree; var T1: Tree );
begin
if T= nil then T1:= nil
else
begin
new( T1 );
T1^.Elem:= T^.Elem;
CopyTree( T^.Left, T1^.Left );
CopyTree( T^.Right, T1^.Right )
end
end;
Глава II. Практическая часть
1-Задача 1. Программа «Калькулятор»
Постановка задачи. Составить программу калькулятор.
Листинг программы
program Kalkulator;
var
M:array[1..50] of string;
j,i,n:integer;
s,s1,s2,s3:string;
x,y:real;
begin
writeln('BBeDi OPeRAciy');
readln(s);
n:=length(s);
for i:=0 to n-1 do
begin
M[i]:=copy(s,i,1);
if (m[i]='+')or(m[i]='-')or(m[i]='*')or(m[i]='/') then j:=i;
end;
s1:=copy(s,0,j-1);
s2:=copy(s,j,1);
s3:=copy(s,j+1,n);
val(s1,x,n);
val(s3,y,n);
if s2='+' then writeln(x+y:4:1);
if s2='-' then writeln(x-y:4:1);
if s2='*' then writeln(x*y:4:1);
if s2='/' then writeln(x/y:4:1);
readln;
end.
Блок-схема
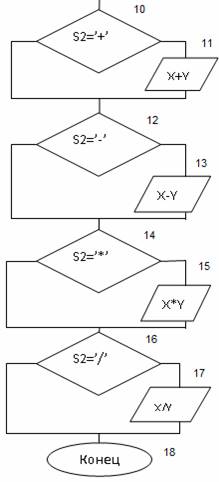
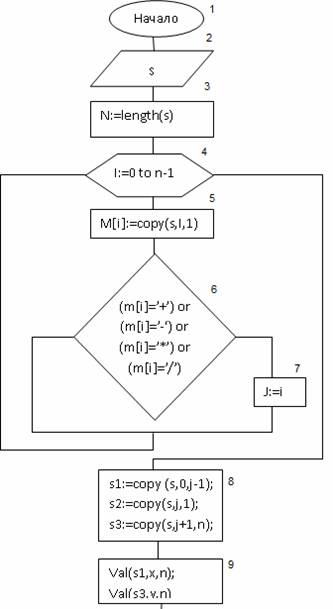
Пояснение к блок-схеме
| № блока | Назначение |
| 1 | Начало программы |
| 2 | Ввод/вывод данных |
| 3 | Выполнение операции N:=length(s) |
| 4 |