Принципы проектирования и использования многомерных баз данных
Выбор в качестве уровня агрегации Номер Контракта/Счета позволит перейти на качественно новый уровень анализа. На этом уровне можно будет учитывать взаимосвязи между конкретным Автомобилем, Менеджером и Покупателем. А поскольку при покупке автомобиля заполняется множество документов, то доступна достаточно детальная информация о каждом конкретном Покупателе (Возраст, Пол, Место жительства, Вид оплаты и т.д.). Теперь вы сможете проанализировать не только рынок, но и заглянуть внутрь своей фирмы и всесторонне проанализировать эффективность работы каждого Менеджера и Подразделения. Но наиболее ценное, что вы получаете, - это информация о Регионах и Покупателях. Например, вы не только сможете оценить, какие Модели автомобилей пользуются наибольшим спросом в конкретном регионе сегодня, но на основе анализа истории и структуры автомобильного рынка в более развитых, с точки зрения автомобилизации, регионах попытаться оценить динамику спроса и перспективы различных Моделей в остальных регионах.
Однако переход на каждый следующий уровень детализации и добавление новых источников данных могут привести к увеличению, иногда более чем на порядок, размера целевой МБД и соответствующему удорожанию и усложнению аппаратного решения.
Рассмотрим в качестве примера Показатель Объем продаж. Анализ предметной области показывает, что он однозначно определяется комбинацией четырех Измерений:
1. {Год | Полугодие | Квартал | Месяц | Неделя | День | Счет}
2. {Страна | Регион | Филиал | Менеджер}
3. {Фирма-Производитель | Завод-Производитель | Модель Автомобиля}
4. {Тип скидки}
Выбрав уровень детализации:
1. День (365 * 10 = 3650 различных значений),
2. Менеджер (300 различных значений),
3. Модель Автомобиля (100 различных значений),
4. Тип Скидки (4 различных значения),
получим куб, состоящий из 438000000 ячеек. Но в основе используемого в МСУБД способа хранения данных лежит предположение о том, что внутри, в данном случае четырехмерного гиперкуба, нет пустот. Данные в МСУБД представлены в виде разреженных матриц с заранее фиксированной размерностью. При этом значения Показателей хранятся в виде множества логически упорядоченных блоков (массивов), имеющих фиксированную длину, причем именно блок является минимальной индексируемой единицей.
Таким образом, в нашей БД будет сразу же зарезервировано место для всех 438 млн. значений Показателя Объем Продаж. Причем цифры "300 менеджеров" и "100 моделей автомобилей" вовсе не означают того, что сегодняшняя номенклатура фирмы - 100 различных моделей, которые продают 300 человек. Цифра 300 говорит о том, что в фирме за 10 лет ее существования работало 300 различных менеджеров. Сегодня же их может быть, например, всего 30.
Попробуем оценить, какой процент ячеек в нашем случае будет содержать реальные значения. Предположим, что в среднем в фирме постоянно работает около 30 менеджеров, менеджер продает в день 10 различных моделей и при продаже каждого автомобиля может быть использован только один вариант скидки. Тогда 3650 * 30 * 10 * 1 = 1095000. То есть только 0,25% ячеек куба будет содержать реальные значения данных. И хотя в МСУБД обычно предполагается, что блоки, полностью заполненные неопределенными значениями, не хранятся, как правило, это не обеспечивает полного решения проблемы.
Загрузка данных
Как уже было сказано выше, основное назначение МСУБД - работа с достаточно стабильными во времени данными, и данные в таких системах достаточно редко вводятся в интерактивном режиме. Обычно загрузка выполняется из внешних источников: оперативных БД, электронных таблиц или из заранее подготовленных плоских файлов.
В OLAP системах загрузка данных может производиться практически из различных внешних источников данных, включая:
различные РСУБД;
плоские файлы с фиксированной структурой записей;
электронных таблиц (Lotus 1-2-3, Ecxell и т.д.);
в интерактивном режиме через специально написанные пользовательские приложения.
Следует заметить, что в данные могут храниться как на постоянной основе, так и загружаться динамически, в тот момент, когда к ним обратится пользователя. Таким образом, имеется возможность постоянно хранить в МБД только ту информацию, которая наиболее часто запрашивается пользователями. Для всех остальных данных хранятся только описания их структуры и программы их выгрузки из центральной (обычно реляционной) БД. И хотя при первичном обращении к таким виртуальным данным, время отклика может оказаться достаточно продолжительным, такое решение обеспечивает высокую гибкость и требует более дешевых аппаратных средств. А если впоследствии оказывается, что интенсивность обращения к данным, имеющим статус временных, высока, их статус может быть легко изменен.
Заключение
В заключение необходимо сказать, что было бы не совсем правильно противопоставлять или говорить о какой-либо серьезной взаимной конкуренции реляционного и многомерного подходов. Правильнее сказать, что эти два подхода взаимно дополняют друг друга. Как отметил Э. Кодд [1], реляционный подход никогда не предназначался для решения на его основе задач, требующих синтеза, анализа и консолидации данных. И изначально предполагалось, что такого рода функции должны реализовываться с помощью внешних по отношению к РСУБД, инструментальных средств.
Но именно на решение таких задач и ориентированы МСУБД. Область, где они наиболее эффективны, это хранение и обработка высоко агрегированных и стабильных во времени данных. И их применение оправдано только при выполнении двух требований.
Уровень агрегации данных в БД достаточно высок, и, соответственно, объем БД не очень велик (не более нескольких гигабайт).
В качестве граней гиперкуба выбраны достаточно стабильные во времени Измерения (с точки зрения неизменности их взаимосвязей), и, соответственно, число несуществующих значений в ячейках гипрекуба относительно невелико.
Поэтому уже сегодня МСУБД все чаще используются не только как самостоятельный программный продукт, но и как аналитические средства переднего плана, к системам Хранилищ Данных или традиционным оперативным системам, реализуемым средствами РСУБД.
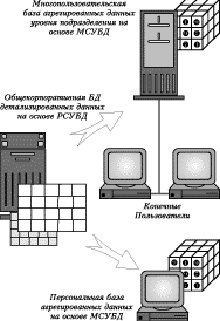
Рисунок 1.(Многоуровневая архитектура).
Причем такое решение позволяет наиболее полно реализовать и использовать достоинства каждого из подходов: компактное хранение детализированных данных и поддержка очень больших БД, обеспечиваемые РСУБД и простота настройки и хорошие времена отклика, при работе с агрегированными данными, обеспечиваемые МСУБД.
Литература
Codd, S.B. Codd, C.T. Salley. Providing OLAP (On-Line Analytical Processing) to User-Analysts: An IT Mandate. - E.F.Codd & Associates, 1993.
Guide to OLAP Terminology. - Kenan Systems Corporation, 1995