Разработка операционных систем
Взаимодействие очередей осуществляется по следующим правилам: ни один процесс с более низким приоритетом не может быть запущен, пока не выполнятся процессы во всех очередях с более высоким приоритетом.
приоритет
Работа процесса из очереди с более низким приоритетом может быть приостановлена, если в одной из очередей с более высоким приоритетом появился процесс.
2.2.6. Программирование с использованием многоуровневой очереди с обратными связями (multilevel feedback queue sheduling).
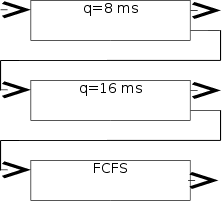
Обычная многоуровневая очередь не допускает перемещения процессов между очередями. Многоуровневая очередь с обратными связями предполагает, что процессы при определенных условиях могут перемещаться между очередями.
0
1
2
Процессы первоначально попадают в очередь 0, где каждому из них предоставляется квант времени, равный 8 мс. Те процессы, которые не успели выполниться в течение этого времени, перемещаются в очередь 1. Процессы из очереди 1 начинают обрабатываться только тогда, когда очередь 0 становиться пустой. Те процессы, которые не выполнились в очереди 1 (q=16 мс) перемещаются в очередь 2. Процессы из очереди 2 будут обрабатываться только в том случае, если становятся пустыми очереди 0 и 1.
Рассмотренная стратегия является наиболее универсальной и сочетает в себе свойства всех рассмотренных раньше стратегий.
FCFS
SJF
приоритетная
Round Robin
многоуровневая очередь
3. Управление невиртуальной памятью.
3.1. Своппинг. (swapping).
Своппингом называется метод управления памятью, основанный на том, что все процессы, участвующие в мультипрограммной обработке, хранятся во внешней памяти.
Процесс, которому выделен CPU, временно перемещается в основную память (swap in/roll in).
В случае прерывания работы процесса он перемещается обратно во внешнюю память (swap out/roll out).
Замечание: при своппинге из основной памяти во внешнюю (и обратно) перемещается вся программа, а не её отдельная часть.
Своппинг иногда используют при приоритетном планировании CPU. В этом случае с целью освобождения памяти для высокоприоритетных процессов, низкоприоритетные процессы перемещаются во внешнюю память.
Основное применение своппинг находит в системах разделения времени, где он используется одновременно с Round Robin стратегией планирования CPU.
В начале каждого временного кванта блок управления памятью выгружает из основной памяти процесс, работа которого была только что прервана, и загружает очередной выполненный процесс.
Метод своппинга влияет на величину временного кванта Round Robin стратегии.
Пример.
пусть очередной загружаемый в память процесс имеет размер 100Кб.
диск позволяет читать данные со скоростью 1 Мб в секунду
следовательно, 100 Кб могут быть загружены за 100 мс.
будем считать, что для первоначального подвода головки чтения - записи потребуется 8 мс
таким образом, операция своппинг займет 108 мс, а общее время своппинга - 216 мс.
Для эффективной загруженности процессора время своппинга должно быть существенно меньше времени счета. Следовательно, для рассмотренного примера квант времени должен быть существенно больше, чем 216 мс. Ясно, что это число значительно увеличится, если перемещаемый процесс имеет размер, например, 1 Мб.
Недостаток “чистого” своппинга в больших потерях времени на загрузку или выгрузку процессов. Поэтому в современных операционных системах используется модифицированные варианты своппинга.
Так, например, во многих версиях операционной системы UNIX своппинг включается только в том случае, когда количество процессов в памяти становится слишком большим.
3.2. Смежное размещение процессов.
Методы размещения процессов в основной памяти по отношению к расположению участков памяти, выделенных для одной и той же программы делят на два класса. Первый — метод смежного размещения, а второй — метод несмежного размещения.
Смежное размещение является простейшим и предполагает, что в памяти, начиная с некоторого начального адреса выделяется один непрерывный участок адресного пространства.
при несмежном размещении программа разбивается на множество частей, которые располагаются в различных, необязательно смежных участках адресного пространства.
3.2.1. Однопрограммный режим.
0
а
б
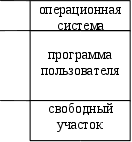
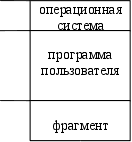
Рисунок иллюстрирует смежное размещение (contiguous allocation) одной программы в основной памяти.



операционная система
корневой сегмент
б
а
0

оверлейная область
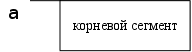
При смежном размещении размер загружаемой программы ограничивается размером накопителя. Для того чтобы при смежном размещении загружать программы, размеры которых превышают размеры накопителя, используют метод оверлейных сегментов (overlay segments).
В программе, имеющей древовидную структуру, модули второго уровня работают сугубо последовательно, поэтому в памяти может находиться только один из них.
Оверлейную структуру программы и последовательность загрузки оверлейных сегментов планирует сам программист.
В процессе выполнения программы все её адреса не должны быть меньше числа а. В противном случае возможна запись какого-либо результата работы программы (поверх операционной системы) и уничтожение некоторых её частей. Защиту операционной системы в случае смежного размещения при однопрограммном режиме можно осуществить с помощью регистра границы.
0
а
б
CPU
Регистр
границы a

Во время работы прикладной программы все адреса, генерируемые CPU, сравниваются с содержимым регистра границы. Если генерируется адрес меньше числа а, работа программы прерывается.
3.2.2 Мультипрограммный режим с ФИКСИРОВАННЫМИ границами.
Мультипрограммирование с фиксированными разделами (Multiprogramming with a fixed number of tasks) предполагает разделение адресного пространства на ряд разделов фиксированного раздела. В каждом разделе размещается один процесс.
операционная система
раздел № 1
0
а
раздел № 2
б
раздел № 3
в
Наиболее простой и наименее эффективный режим MFT соответствует случаю, когда трансляция программ осуществляется в абсолютных адресах для соответствующего раздела.
В этом случае, если соответствующий раздел занят, то процесс остается в очереди во внешней памяти даже в том случае, когда другие разделы свободны.
Уменьшить фрагментацию при мультипрограммировании с фиксированными разделами можно, если загрузочные модули получать в перемещаемых адресах. Такой модуль может быть загружен в любой свободный раздел после соответствующей настройки.
При мультипрограммировании с трансляцией в перемещаемых адресах имеются две причины фрагментации. Первая — размер загруженного процесса меньше размера, занимаемого разделом (внутренняя фрагментация), вторая — размер процесса в очереди больше размера свободного раздела, и этот раздел остается свободным (внешняя фрагментация).
Для защиты памяти при мультипрограммировании с фиксированным разделами необходимы два регистра. Первый — регистр верхней границы (наименьший адрес), второй — регистр нижней границы (наибольший адрес).
0
а
б
CPU
Регистр
границы a
Регистр
границы б

операционная система
раздел № 1
0
а
раздел № 2
б
в
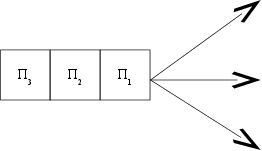
Очередь процессов в перемещаемых адресах
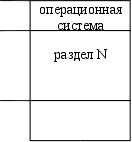
Прежде чем программа в разделе N начнет выполняться, ее граничные адреса загружаются в соответствующие регистры. В процессе работы программы все формируемые ею адреса контролируются на удовлетворение неравенства
а < Адр. < б
При выходе любого адреса программы за отведенные ей границы, работа программы прерывается.
3.2.3. Мультипрограммирование с переменными разделами. (multiprogramming with a variable number of tasks (MVT).
Метод Multiprogramming with a Variable number of Tasks предполагает разделение памяти на разделы и использование загрузочных модулей в перемещаемых адресах, однако, границы разделов не фиксируются.
| 0 | ОС | |||||
|
|
а | Раздел 1 | ||||
|
|
П4 |
П3 |
П2 |
П1 |
Раздел 2 | |
|
|
Раздел 3 | |||||
| Раздел 4 | ||||||
| 80 Кб |
 90
Кб
 П5
| 0 | ОС | |||
| 90 Кб | а | Раздел 1 | ||
|
|
П6 |
П5 |
100 Кб | |
| Раздел 4 | ||||
 П7
Таким образом, на фазе повторного размещения действуют те же причины фрагментации, что и для метода MFT.
3.2.4. Мультипрограммирование с переменными разделами и уплотнением памяти.
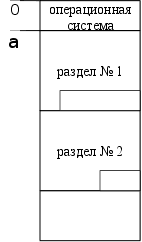
Ясно, что метод Multiprogramming with a Variable number of Tasks порождает в памяти множество малых фрагментов, каждый из которых может быть недостаточен для размещения очередного процесса, однако суммарный размер фрагментов превышает размер этого процесса.
Уплотнением памяти называется перемещение всех занятых разделов по адресному пространству памяти. Таким образом, чтобы свободный фрагмент занимал одну связную область.
операционная система
раздел № 1
0
а
раздел № 2
 На
практике реализация
уплотнения
памяти сопряжена
с усложнением
операционной
системы и обладает
следующими
недостатками:
в тех случаях, когда мультипрограммная смесь неоднородна по отношению к размерам программ, возникает необходимость в частом уплотнении, что расходует ресурс процессорное время и компенсирует экономию ресурса памяти.
во время уплотнения все прикладные программы переводятся в состояние “ожидание”, что приводит к невозможности выполнения программ в реальном масштабе времени.
3.2.5. Основные стратегии заполнения свободного раздела.
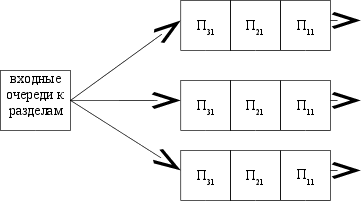
Рассмотренные методы мультипрограммирования предполагают наличие входной очереди/очередей к разделам основной памяти.
В том случае, когда освобождается очередной раздел, операционная система должна выбрать один из процессов для размещения его в памяти. Алгоритм выбора может использовать одну из следующих трех стратегий:
стратегия наиболее подходящего (best fit strategy) выбирает процесс, которому в освободившемся разделе наиболее тесно (выигрыш в памяти).
стратегия первого подходящего (first fit strategy) выбирает первый процесс, который может разместить в освободившемся разделе.
стратегия наименее подходящего (last fit strategy) выбирает процесс, которому в освободившемся разделе наиболее свободно (в этом случае остающийся фрагмент часто достаточен для размещения еще одного процесса).
3.3. Страничная организация памяти.
Страничная организация памяти (paging) относится к методам несмежного размещения процессов в основной памяти.
Основное достоинство страничной организации памяти заключается в том, что она позволяет свести к минимуму общую фрагментацию за счет полного устранения внешней фрагментации и минимизации внутренней фрагментации.
3.3.1. Базовый метод.
Основная память
f
CPU
П
Д
Логический адрес

Таблица страниц


f
f

Д







Страничная рамка
Адресное пространство основной и внешней памяти разбивают на блоки фиксированного размера, называемые страничные рамки (frames). Логическое адресное пространство программы также разбивается на блоки фиксированного размера, называемых страницами (pages). Размеры страничных рамок и страниц совпадают. Процесс загружается в память постранично, причем каждая страница помещается в любую свободную страничную рамку основной памяти.
Каждый адрес, генерируемый процессором, состоит из двух частей: П - номер страницы (page number) и Д - смещение в пределах страницы (off set). Номер страницы может использоваться как индекс для таблицы страниц (page table).
 Таблица
страниц содержит
начальные
адреса f всех
страничных
рамок, в
которых размещена
программа.
Физический
адрес определяется
путем сложения
начального
адреса страничной
рамки f и смещения
Д.
| Вторичная память |
Таблица страниц |
Основная память | ||||||
| программы А |
|
|||||||
| стр. 0 |
|
1 |
|
стр. 0 | ||||
| программа | стр. 1 |
|
3 |
|
||||
| А | стр. 2 |
|
4 |
|
стр. 1 | |||
| стр. 3 |
|
7 |
|
стр. 2 | ||||
|
|
|
|||||||
|
f П |
|
|||||||
|
|
стр. 3 | |||||||


Для ускорения вычисления физического адреса операцию суммирования заменяют операцией конкатенации.
| старшие разряды | младшие разряды | |||||
|
2n+1 |
2n |
f | ||||
|
2n-1 |
2n |
Д | ||||
Например, при n=9 базовые адреса страничных рамок — это следующий ряд: 512, 1024, 1536. Следовательно, размер страничной рамки равен 512 байт.
В современных операционных системах типичный размер страницы составляет 2 Кб или 4 Кб.
Каждая операционная система поддерживает свой собственный метод работы с таблице страниц. Обычно за каждым процессом, находящимся в основной памяти, закреплена отдельная таблица страниц. В этом случае указатель на таблицу страниц хранится в PCB соответствующего процесса.
3.3.2. Аппаратная поддержка страничной организации памяти.
Преобразование логического адреса в физические осуществляется для каждого адреса, генерируемого процессором, поэтому часто для ускорения этого процесса применяются аппаратные методы. На рисунке приведена схема, иллюстрирующая метод, использующий ассоциативные регистры (associative registers).
Каждый ассоциативный регистр кроме операций чтения - записи может обрабатывать операцию сравнения кода, поступающего на его вход с частью кода, хранимого в регистре. Матрица ассоциативных регистров хранит часть таблицы страниц. Номер страницы П подается одновременно на входы всех ассоциативных регистров, которые параллельно выполняют операцию сравнения. На выходе матрицы ассоциативных регистров образуется начальный адрес страничной рамки f того регистра, в котором про-
изошло совпадение кода.


Логический адрес
Д
П
CPU
Основная память
f


f

Д
Таблица страниц


|
П |
f |
матрица ассоциативных регистров
Страничная рамка
Д
f
В том случае, если требуемый номер страницы находится в таблице страниц, то есть ни в одном из ассоциативных регистров не произошло совпадение, происходит обращение к таблице страниц, находится искомый
номер страничной рамки, а найденная строка таблицы страниц переписывается в один из ассоциативных регистров.
Защита страничной памяти основана на контроле уровня доступа к каждой странице, возможны следующие уровни доступа:
только чтение
и чтение и запись
только выполнение
В этом случае каждая страница снабжается трехбитным кодом уровня доступа. При трансформации логического адреса в физический сравнивается значение кода разрешенного уровня доступа с фактически требуемым. При их несовпадении работа программы прерывается.
3.4. Сегментная организация памяти.
Страничная организация памяти предполагает, что разделение программы на страницы осуществляет операционная система и это невидимо для прикладного программиста. Большинство технологий программирования также предполагает разделение программы на множество логических частей — подпрограммы, процедуры, модули и так далее.
Сегментная организация памяти представляет собой метод несмежного размещения, при котором программа разбивается на части (сегменты) на этапе программирования. Отдельный сегмент хранит отдельную логическую часть программы: программный модуль или структуру данных (массив), стек, таблица и так далее.
3.4.1. Базовый метод сегментной организации памяти.
Обычно сегменты формируются компилятором, а на этапе загрузки им присваиваются идентифицирующие номера. Таким образом, логический адрес при сегментной организации памяти состоит из двух частей: S и d, где S — номер сегмента, а d — смещение в пределах сегмента.
Трансформация логического адреса в физический осуществляется с помощью таблицы сегментов (segment table).
да
CPU
S
d
сегмент
d
base

таблица сегментов

limit
base