Основы дискретной математики
Многие задачи, встречающиеся на практике, сводятся к одной или нескольким подзадачам, которые можно абстрактно сформулировать как последовательность основных команд, выполняемых на некоторой базе данных (универсальном множестве элементов). Например, выполнение последовательности команд, состоящих из операций поиск, вставка, удаление и минимум, составляет существенную часть задач поиска. Об этих и других подобных командах и пойдет речь ниже [12].
Рассмотрим несколько основных операций над множествами, типичных для задач информационного поиска.
• Поиск (а; S) определяет, принадлежит ли элемент а множеству S;
если
а
 S,
результат
операции –
ответ «да»; в
противном
случае –
ответ «нет».
• Вставка (а, S) добавляет элемент а в множество S, то есть заменяет S на S U {а}.
• Алгоритм правильного обхода(S) печатает элементы множества S с
соблюдением порядка.
• Удаление (a, S) удаляет элемент а из множества S, то есть заменяет S на S {а}.
• Объединение (S1, S2, S3) объединяет множества S1 и S2, т. е. строит
множество S3 = S1 U S2.
• Минимум (S) выдает наименьший элемент множества S.
Следующая операция – операция минимум(S). Для нахождения наименьшего элемента в двоичном дереве поиска Т строится путь v0, vi, …, vp, где v0-корень дерева Т, vi – левый сын вершины vi-1 (i= 1,2,…, р), а у вершины vp левый сын отсутствует. Ключ вершины vp, и является наименьшим элементом в дереве Т. В некоторых задачах полезно иметь указатель на вершину vy, чтобы обеспечить доступ к наименьшему элементу за постоянное время.
Алгоритм выполнения операции минимум(S) использует рекурсивную процедуру левый сын(v), определяющую левого сына вершины v. Алгоритм и процедура выглядят следующим образом.
Input
двоичное дерево поиска Т для множества S
begin
if T = 0 then output «дерево пусто»;
else
вызвать процедуру левый сын(r)
(здесь r – корень дерева Т);
минимум:=1 (v), где v – возврат процедуры левый сын;
end
Output ответ «дерево пусто», если Т не содержит вершин;
минимум – наименьший элемент дерева Т в противном случае.
Procedure левый сын (v).
begin
if v имеет левого сына w then return левый сын (w)
else return v
end
Пример 2.1 Проследите работу алгоритма минимум на дереве поиска, изображенном на рисунке 2.7.
Решение. Дерево Т не пусто, следовательно, вызывается процедура левый сын (1).
Вершина 1 имеет левого сына – вершину 2, значит, вызывается процедура левый сын (2).
Вершина 2 имеет левого сына вершину 4, значит, вызывается процедура левый сын (4).
Вершина 4 не имеет левого сына, поэтому вершина 4 и будет возвратом процедуры левый сын.
Ключом вершины 4 является слово begin, следовательно, наименьшим элементом дерева Т является значение минимум= begin.
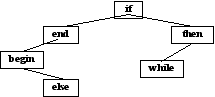
Рисунок 2.7 – Дерево поиска минимума S
Реализовать операцию удаление (a, S) на основе бинарных поисковых деревьев тоже просто. Допустим, что элемент а, подлежащий удалению, расположен в вершине v. Возможны три случая:
• вершина v является листом; в этом случае v просто удаляется
из дерева;
• у вершины v в точности один сын; в этом случае объявляем отца вершины v отцом сына вершины v, удаляя тем самым v из дерева (если v – корень, то его сына делаем новым корнем);
• у вершины v два сына; в этом случае находим в левом поддереве вершины v наибольший элемент b, рекурсивно удаляем из этого поддерева вершину, содержащую b, и присваиваем вершине v ключ b. (Заметим, что среди элементов, меньших а, элемент b будет наибольшим элементом дерева. Кроме того, вершина, содержащая b, может быть или листом, являющимся чьим-то правым сыном, или иметь только левое поддерево.)
Ясно, что до выполнения операции удаление (а, S) необходимо проверить, не является ли дерево пустым и содержится ли элемент а в множестве S. Для этого придется выполнить операцию поиск (а, S), причем, и в случае положительного ответа необходимо выдать кроме ответа «да» и номер вершины, ключ которой совпадает с a (далее ключ вершины v будем обозначать через l(v)). Кроме этого, для реализации операции удаление (a, S) требуется знать и номер вершины w, являющейся отцом вершины v. Саму же рекурсивную процедуру удаление (а, S) можно реализовать так, как показано ниже.
Procedure удаление (а, S)
begin
if v – лист then удалить v из Т
else
(2) if v имеет только левого или только
правого сына u then
(3) if v имеет отца w then
назначить и сыном w
else
сделать u корнем дерева,
присвоив ему номер v
else
найти в левом поддереве v наибольший элемент b, содержащийся в вершине у;
(6) return удаление (b, S);
(7) l(v):=b;
end
Пример 2.2 Проследите за работой алгоритма удаление (а, S) для двоичного дерева поиска S, изображенного на рисунке 2.7, если a – это слово «if».
Решение. Слово «if» расположено в корне с номером 1, у которого два сына (вершины 2 и 3), поэтому выполняем строку (5) алгоритма. Наибольшее слово, меньшее «if» (лексикографически), расположенное в левом поддереве корня и находящееся в вершине 2, – это end. Вызываем процедуру удаление (end, S).
Условие строки (2) алгоритма выполняется, так как вершина 2 с ключом end имеет только левого сына. Условие строки (3) не выполняется, так как удаляемая вершина является корнем. Поэтому переходим к строке (4): делаем вершину 2 корнем, сыновьями которого становятся вершины 4 (левым) и 3 (правым). Работа процедуры удаление (end, S) закончена.
Продолжаем выполнение алгоритма (выполняем строку (7)): полагаем ключ вершины 1 равным «end» (l (I):=end).
Полученное в результате дерево изображено на рисунке 2.8.
Заметим, что при работе рассмотренных алгоритмов необходимо находить сыновей, отца и ключ заданной вершины двоичного дерева поиска. Это можно сделать довольно просто, если дерево в памяти компьютера хранится в виде трех массивов: LEFTSON, RIGHTSON и KEY. Эти массивы устроены следующим образом:
| LEFTSON (i) = |
*, если у вершины i левого сына нет |
| RIGHTSONM (i) = |
*, если у вершины i правого сына нет |
 v,
если v
– левый сын
вершины i
key(i) = l(i) – ключ вершины i.
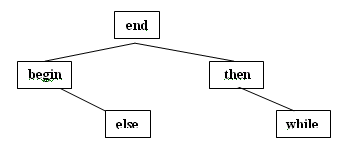
Рисунок 2.8 – Результат работы алгоритма удаление (а, S) для двоичного дерева поиска S
Например, бинарное поисковое дерево, изображенное на рисунке 2.7, может быть представлено в виде таблицы 2.1.
Таблица 2.1 – Представление бинарного поискового дерева в виде таблицы
| I | LEFTSON | RIGHTSON | KEY |
| 1 | 2 | 3 | if |
| 2 | 4 | * | end |
| 3 | * | 6 | then |
| 4 | * | 5 | begin |
| 5 | * | * | else |
| 6 | * | * | while |
Правила поиска сыновей и ключа заданной вершины следуют из определения массивов. Определение отца заданной вершины состоит в нахождении строки массивов LEFTSON или RIGHTSON, в которой находится номер заданной вершины. Например, отцом вершины 4 является вершина 2, так как число 4 находится во второй строке массива LEFTSON.
Объединение множеств
Обратимся теперь к объединению множеств, то есть к операции объединение (S1, S2, S3).
Если множества S1 и S2 линейно упорядочены, то естественно требовать такого порядка и от их объединения. Один из возможных способов объединения состоит в последовательном выполнении описанной выше операции вставка для добавления каждого элемента одного множества в другое. При этом, очевидно, операцию вставка предпочтительнее выполнять над элементами меньшего множества с целью сокращения времени на объединение. Отметим, что такой способ работы подходит как для непересекающихся, так и для пересекающихся множеств.
Во многих задачах объединяются непересекающиеся множества. Это упрощает процесс, так как исчезает необходимость каждый раз проверять, содержится ли добавляемый элемент в множестве, либо удалять повторяющиеся экземпляры одного и того же элемента из S3.
Процедура объединения непересекающихся множеств применяется, например, при построении минимального остовного дерева в данном нагруженном графе.
Рассмотрим алгоритм объединения непересекающихся множеств на основе списков. Будем считать, что элементы объединяемых множеств пронумерованы натуральными числами 1,2,…. n. Кроме того, предположим, что имена множеств – также натуральные числа. Это не ограничивает общности, поскольку имена множеств можно просто пронумеровать натуральными числами.
Представим рассматриваемые множества в виде совокупности линейных связанных списков. Такую структуру данных можно организовать следующим образом.
Сформируем два массива R и next размерности n, в которых R(i) – имя множества, содержащего элемент i, a next(i) указывает номер следующего элемента массива R, принадлежащего тому же множеству, что и элемент i. Если i – последний элемент какого-то множества, то положим next(i) = 0. Для указателей на первые элементы каждого множества будем использовать массив list, число элементов которого равно числу рассматриваемых в задаче множеств, и элемент которого list(j) содержит номер первого элемента множества с именем j в массиве R.
Кроме того, сформируем массив size, каждый элемент которого size(j) содержит количество элементов множества с именем j.
Будем различать внутренние имена множеств, содержащиеся в массиве к, и внешние имена, получаемые множествами в результате выполнения операции объединение. Соответствие между внутренними и внешними именами множеств можно установить с помощью массивов Ехт-NAME и INT-NAME. Элемент массива EXT-NAME(j) содержит внешнее имя множества, внутреннее имя которого есть j, а INT-NAME(k) – внутреннее имя множества, внешнее имя которого есть к.
Пример 2.3 Используя только что определенные массивы, опишите множества {1,3,5,7}, {2,4.8}, {6} с внешними именами 1, 2, 3 и внутренними именами 2, 3, 1 соответственно.
Решение. Прежде всего, отметим, что общее количество элементов всех множеств равно восьми. Поэтому размерность массивов R и next будет n = 8. Кроме того, напомним, что номера элементов массивов list, SIZE, Ехт-NAME и значения элементов массива R – это внутренние имена множеств, а массива INT-NAME внешние.
Алгоритм выполнения операции объединение (S1, S2, S3) состоит в добавлении к списку элементов большего из множеств S1 и S2 элементов меньшего множества и присвоение полученному множеству внешнего имени S3. При этом вычисляется также размер построенного множества S3.
Объединение (i, j, к)
Input
i, j – внешние имена объединяемых множеств
(пусть размер i меньше размера j);
массивы R, NEXT, LIST, SIZE, ЕХТ-NAME, INT-NAME;
begin
A:=INT-NAME(i);
B:=INT-NAME(j);
element:=LIST(A);
while element <> 0 do
begin
R(element):=B;
last:=element;
element:=NEXT(element)
end
NEXT(last):=LIST(B);
LIST(B):=LIST(A);
SIZE(B):=SIZE(B) + SIZE(A);
INT-NAME(K):=B;
EXT-NAME(B):=k
End
Объединение множеств i, j с внешним именем k.
В процессе работы алгоритм совершает следующие действия:
1) определяет внутренние имена множеств i и j;
2) определяет начало списка элементов меньшего множества;
3) просматривает список элементов меньшего множества и изменяет соответствующие элементы массива R на внутреннее имя большего множества;
4) объединяет множества путем подстановки меньшего множества перед большим;
5) присваивает новому множеству внешнее имя k.
Заметим, что время выполнения операции объединения двух множеств с помощью рассмотренного алгоритма пропорционально мощности меньшего множества.
2.1.3 Алгоритмы генерации множеств
Реализация операций над подмножествами заданного универсума U
Пусть универсум U – конечный, и число элементов в нем не превосходит разрядности ЭВМ: мощность |U| < n. Элементы универсума нумеруются: U = {u1,…, un}. Подмножество А универсума U представляется кодом (машинным словом или битовой шкалой) С, в котором:
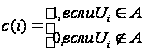
где С(i) – это i й разряд кода С.
Код пересечения множеств А и В есть поразрядное логическое произведение кода множества А и кода множества В. Код объединения множеств А и В есть поразрядная логическая сумма кода множества А и кода множества В. Код дополнения множества А есть инверсия кода множества А. В большинстве ЭВМ для этих операций есть соответствующие машинные команды. Таким образом, операции над небольшими множествами выполняются весьма эффективно.
Если мощность универсума превосходит размер машинного слова, но не очень велика, то для представления множеств используются массивы битовых шкал. В этом случае операции над множествами реализуются с помощью циклов по элементам массива [23].
Генерация всех подмножеств универсума
Во многих переборных алгоритмах требуется последовательно рассмотреть все подмножества заданного множества. В большинстве компьютеров целые числа представляются кодами в двоичной системе счисления, причем число 2k – 1 представляется кодом, содержащим k единиц. Таким образом, число 0 является представлением пустого множества 0, число 1 является представлением подмножества, состоящего из первого элемента, и т. д. Следующий тривиальный алгоритм перечисляет все подмножества n элементного множества (представлен в паскале-подобном коде, описание в [23]).
Алгоритм 1.1: Алгоритм генерации всех подмножеств n элементного множества
Вход: n
 0
– мощность
множества
Выход: последовательность кодов подмножеств i
for i from 0 to 2n – 1 do
yield i
end for
Обоснование: Алгоритм выдает 2n различных целых чисел, следовательно, 2n различных кодов.
С увеличением числа n увеличивается количество двоичных разрядов, необходимых для его представления. Самое большое (из генерируемых) число 2n 1 требует для своего представления ровно n разрядов. Таким образом, все подмножества генерируются, причем ровно по одному разу.
Во многих переборных задачах требуется рассмотреть все подмножества некоторого множества и найти среди них то, которое удовлетворяет заданному условию. При этом проверка условия часто может быть весьма трудоемкой и зависеть от состава элементов очередного рассматриваемого подмножества. В частности, если очередное рассматриваемое подмножество незначительно отличается по набору элементов от предыдущего, то иногда можно воспользоваться результатами оценки элементов, которые рассматривались на предыдущем шаге перебора. В таком случае, если перебирать множества в определенном порядке, можно значительно ускорить работу переборного алгоритма. [5]
Алгоритм построения бинарного кода Грея
Данный алгоритм генерирует последовательность всех подмножеств n элементного множества, причем каждое следующее подмножество получается из предыдущего удалением или добавлением одного элемента.
Алгоритм
1.2: Алгоритм
построения
бинарного кода
Грея Вход: n
0 – мощность
множества
Выход: последовательность кодов подмножеств В
В: array [l..n] of 0..1 {битовая шкала для представления подмножеств}
for i from 1 to n do
B[i]: = 0 {инициализация} end for
yield В {пустое множество}
for i from I to 2n – 1 do
p: = Q(i) {определение элемента, подлежащего добавлению или удалению}
B[р]: = 1 – В[р] {добавление или удаление элемента}
yield В {очередное подмножество} end for
proc Q(i) {количество 2 в разложении i на множители + 1} q: = l; j: = i while j четно do
j:=j/2; q: = q + l end while return q end proc
Обоснование
Для n = 1
искомая последовательность
кодов суть 0,1.
Пусть есть
искомая последовательность
кодов В1,…,
 для n = к. Тогда
последовательность
кодов B10,…,
0,
1,
…. B11 будет
искомой последовательностью
для n = к + 1. Действительно,
в последовательности
B10,…,
0,
1,…,
В11 имеется
2k+1 кодов, они
все различны
и соседние
различаются
ровно в одном
разряде по
строению. Именно
такое построение
и осуществляет
данный алгоритм.
На нулевом шаге
алгоритм выдает
правильное
подмножество
В (пустое). Пусть
за первые 2k
– 1 шагов алгоритм
выдал последовательность
значений В.
При этом В [k
+ 1] = В [k + 2] = •
• • = В[n] =
0. На 2 k ом
шаге разряд
В [k + 1] изменяет
свое значение
с 0 на 1. После этого
будет повторена
последовательность
изменений
значений В
[1. k] в обратном
порядке, поскольку
Q (2k + m) = Q (2k
– m) для

Пример 2.4
Таблица 2.5 – Протокол выполнения алгоритма 1.2 для п = 3
| i | Р | В | ||
| 0 | 0 | 0 | ||
| 1 | 1 | 0 | 0 | 1 |
| 2 | 2 | 0 | 1 | 1 |
| 3 | 1 | 0 | 1 | 0 |
| 4 | 3 | 1 | 1 | 0 |
| 5 | 1 | 1 | 1 | 1 |
| 6 | 2 | 1 | 0 | 1 |
| 7 | 1 | 1 | 0 | 0 |
Представление множеств упорядоченными списками
Если универсум очень велик (или бесконечен), а рассматриваемые подмножества универсума не очень велики, то представление с помощью битовых шкал не является эффективным с точки зрения экономии памяти. В этом случае множества обычно представляются списками элементов. Элемент списка при этом представляется записью с двумя полями: информационным и указателем на следующий элемент. Весь список представляется указателем на первый элемент.
elem = record
i: info; {информационное поле}
n: elem {указатель на следующий элемент} end record
При таком
представлении
трудоемкость
операции
составит O(n),
а трудоемкость
операций
 составит
О(nm), где n и m
– мощности
участвующих
в операции
множеств.
Если элементы в списках упорядочить, например, по возрастанию значения поля i, то трудоемкость всех операций составит О(n). Эффективная реализация операций над множествами, представленными в виде упорядоченных списков, основана на весьма общем алгоритме, известном как алгоритм типа слияния.
1
1 1
1 2 1
13 3 1
14 6 4 1
Рисунок 2.9 – Иллюстрация к алгоритму слияния
В этом равнобедренном треугольнике каждое число (кроме единиц на боковых сторонах) является суммой двух чисел, стоящих над ним. Число сочетаний С (m, n) находится в (m + 1) – м ряду на (n + 1) – м месте.
Генерация подмножеств
Элементы множества {1,…, m} упорядочены. Поэтому каждое n элементное подмножество также можно рассматривать как упорядоченную последовательность. На множестве таких последовательностей естественным образом определяется лексикографический порядок. Следующий простой алгоритм генерирует все n элементные подмножества m элементного множества в лексикографическом порядке.
Алгоритм 1.3. Генерация n элементных подмножеств m элементного множества
Вход: n
– мощность
подмножества,
m – мощность
множества, m
n > 0.
Выход: последовательность всех n элементных подмножеств m элементного множества в лексикографическом порядке.
for i from 1 to m do
A[i]: = i {инициализация исходного множества} end for
if m = n then
yield A [1..n] {единственное подмножество} exit end if
p: = n {p – номер
первого изменяемого
элемента} while p
1 do
yield A [1..n] {очередное подмножество в первых n элементах массива А} if А[i] = m then
р: = р – 1 {нельзя увеличить последний элемент} else
р:=n
{можно увеличить
последний
элемент} end if if p
1 then
for i from n downto p do
А[i]: = А[р]+i р+1 {увеличение элементов} end for end if end while
Заметим, что в искомой последовательности n элементиых подмножеств (каждое из которых является возрастающей последовательностью n чисел из диапазона l..m) вслед за последовательностью (ai,…, an) следует последовательность
(b1,…,
bn) = (а1…,
ap-1, ар
+ 1, ар + 2,…,
ар + n-р
+1), где р – максимальный
индекс, для
которого bn
= ар + n
- р + 1 m. Другими словами,
следующая
последовательность
получается
из предыдущей
заменой некоторого
количества
элементов в
хвосте последовательности
на идущие подряд
целые числа,
но так, чтобы
последний
элемент не
превосходил
n, а первый
изменяемый
элемент был
на 1 больше, чем
соответствующий
элемент в предыдущей
последовательности.
Таким образом,
индекс р, начиная
с которого
следует изменить
«хвост последовательности»,
определяется
по значению
элемента А[n].
Если А[n] < m,
то следует
изменять только
А[n], и при этом
р: = n. Если же
уже А(n) = m, то
нужно уменьшать
индекс р: =р
– 1, увеличивая
длину изменяемого
хвоста.
2.1.4 Представление множеств в приложениях на Delphi
Тип множество задает неупорядоченную совокупность неповторяющихся объектов. Переменная типа множество – это совокупность объектов из исходного заданного множества – может иметь значение «пусто» (пустое множество). Число элементов исходного множества ограничено – оно не может быть более 256. Для задания элементов множества может использоваться любой порядковый тип, однако порядковые номера элементов множества, т. е. значения функции ord, должны находиться в пределах от 0 до 255. Для задания типа множества используется следующее объявление [22]:
Type <Имя> = set of <тип элементов>;
При задании типа элементов необходимо соблюдать ограничения, указанные выше.
Type A = set of Char; A1 = set of ‘A’.’Z’;
Oper = set of (Plus, Minus, Mult, Divide);
Number = set of Byte; D = set of 1..20;
Для переменных типа множество можно задавать типизированные константы. При этом значения задаются в виде конструктора множества.
Const K:D = [5,9,11,17]; R:D = [1.. 9,13,20];
Для задания значений переменным типа множество также можно использовать конструкторы. Пусть объявлено
Var AA:A;, тогда возможна запись (тип A объявлен выше)
AA:=[Char(13), Char(7), ‘0’, ‘Q’];
Если требуется присвоить этой переменной значение «пусто», то используется такой конструктор: AA:= [];
Операции над множествами
Как и для других типов, имеется ряд встроенных операций для типа множество. Пусть заданы следующие типы и переменные: Type Mn = set of 1..50; Var A, B, C: Mn;
Пусть переменным присвоены значения:
A:= [3,5,9,10]; B:= [1,7,9,10];
Объединение множеств
C:=A+B; {1,3,5,7,9,10}
Разность (A-B <> B-A)
C:=A-B; {3,5}
C:=B-A; {1,7}
Пересечение (умножение)
C:=A*B; {9,10}
Проверка эквивалентности, например в операторе IF
(A = B) {False}
Проверка неэквивалентности
(A <> B) {True}
Проверка, является ли одно множество подмножеством другого
(A>=B) {False}
(A<=B) {False}
Проверка, входит ли заданный элемент в заданное множество
(3 in A) {True}
(3 in B) {False}
Стандартные подпрограммы для выполнения некоторых действий над множествами
Exclude (A, 3); удалить из множества A элемент 3}
Include (A, 3); {вставить элемент 3 в множество A}.
2.1.5 Характеристический вектор множества
Характеристическим вектором Vx множества X, заданного на универсальном множестве I, является вектор, содержащий 0 и 1. Количество элементов в векторе Vx равно количеству элементов в универсальном множестве, причём, 1 записывается в случае, если элемент присутствует и в универсальном множестве I, и в множестве X, в противном случае записывается 0. Некоторые задачи с множествами, особенно на компьютере, удобно решать, используя характеристические векторы [1].
Действия над векторами похожи на логические операции.
Над характеристическими векторами выполняются поразрядно логические операции:
при пересечении – логическое умножение;
при объединении – логическое сложение;
при нахождении дополнения – значения в исходном векторе изменяются на противоположные.
При объединении
множеств
 элементы
характеристического
вектора считают
по правилу:

2) При
пересечении
множеств
 элементы
характеристического
вектора считают
по правилу:

3) При
нахождении
дополнения
 нули меняют
на единицы,
единицы – на
нули;
4) При
нахождении
симметричной
разности
 ,
используют
формулу:

Пример 2.5 Пусть I = {1, 2, 3, 4, 5, 6}, А={1, 2, 4, 5} и В={3, 5} Характеристическим вектором множества А является вектор а = (1, 1, 0, 1, 1, 0). Характеристический вектор множества В равен b = (0, 0, 1, 0, 1, 0).
Вычислим
характеристический
вектор множества
A U
 .
Он равен
а или (не b) = (1, 1, 0, 1, 1, 0) или (1, 1, 0 1, 0, 1) = (1,1,0,1,1,1).
Следовательно,
A U
=
{1, 2, 4, 5, 6}.
Характеристический вектор множества А Δ В равен
(а и (не b)) или (b и (не а)) = ((1, 1, 0, 1, 1, 0) и (1, 1, 0, 1, 0, 1)) или
или ((0, 0, 1, 0, 1, 0) и (0, 0, 1,