Реализация АВЛ–деревьев через классы объектно–ориентированного программирования
Малое правое вращение.
В случае, когда показатель сбалансированности вершины, в которой произошло нарушение баланса, равен 2, а показатель сбалансированности корня правого поддерева равен 1, восстановить сбалансированность в вершине можно с помощью преобразования, называемого малым правым вращением. Это вращение симметрично малому левому и схематично изображено на рисунке 10:
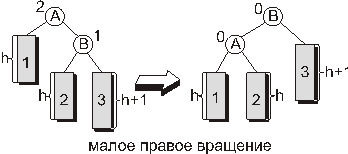
Рис. 10.
Большое левое вращение.
Несколько сложнее случай, когда показатель сбалансированности в вершине, в которой произошло нарушение баланса равен -2, а показатель сбалансированности в корне левого поддерева равен 1 или 0. В этом случае применяется преобразование, называемое большим левым вращением. Как видно из рисунка 11 здесь во вращении участвуют три вершины, а не две как в случае малых вращений.
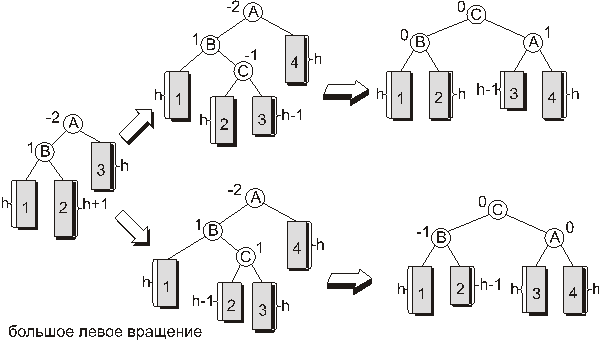
Рис. 11.
Большое правое вращение.
Большое правое вращение применяется, когда показатель сбалансированности вершины, в которой произошло нарушение баланса, равен 2, а показатель сбалансированности корня правого поддерева равен -1 или 0. Большое правое вращение симметрично большому левому и схематично изображено на рисунке 12:
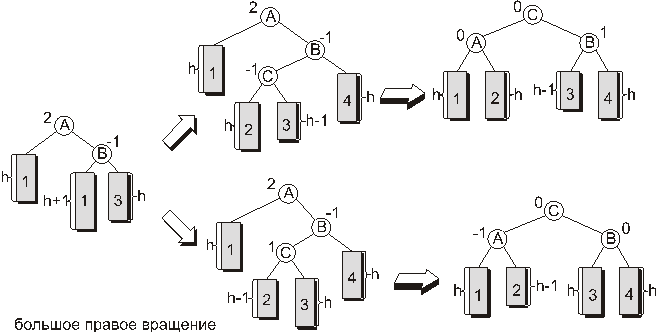
Рис. 12.
Повороты необходимы, когда родительский узел P становится разбалансированным. Одинарный поворот вправо (single right rotation) происходит тогда, когда родительский узел P и его левый сын LC начинают перевешивать влево после вставки узла в позицию X. В результате такого поворота LC замещает своего родителя, который становится правым сыном. Бывшее правое поддерево узла LC (ST) присоединяется к P в качестве левого поддерева. Это сохраняет упорядоченность, так как узлы в ST больше или равны узлу LC, но меньше узла P. Поворот уравновешивает как родителя, так и его левого сына (рис. 13).
// выполнить поворот по часовой стрелке вокруг узла p
// сделать lc новой точкой вращения
template <class T>
void AVLTree<T>::SingleRotateRight (AVLTreeNode<T>* &p)
{
// левое, перевешивающее поддерево узла p
AVLTreeNode<T> *lc;
// назначить lc левым поддеревом
lc = p->Left();
// скорректировать показатель сбалансированности для родительского узла и его левого сына
p->balanceFactor = balanced;
lc->balanceFactor = balanced;
// правое поддерево узла lc в любом случае должно оставаться справа от lc, выполнить это условие, сделав st левым поддеревом узла p
p->Left() = lc->Right();
// переместить p в правое поддерево узла lc
// сделать lc новой точкой вращения
lc->Right() = p;
p = lc;
}
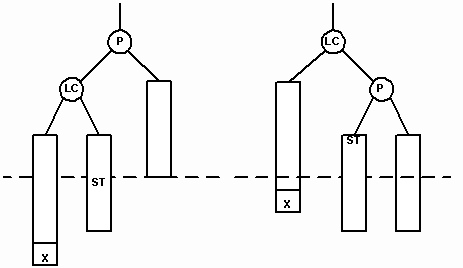
Рис. 13
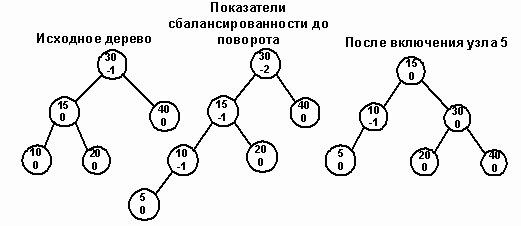
Рис. 14.
Попытка вставить узел 5 в изображенное на рисунке 14 АВЛ - дерево нарушает АВЛ - условие для узла 30. Одновременно левое поддерево узла 15 (LC) становится перегруженным.
Для переупорядочения узлов вызывается процедура SingleRotateRight. В результате родительский узел (30) становится сбалансированным, а узел 10 перевешивающим влево. Двойной поворот вправо (double right rotation) нужен тогда, когда родительский узел (P) становится перевешивающим влево, а его левый сын (LC) перевешивающим вправо. NP – корень правого перевешивающего поддерева узла LC. Тогда в результате поворота узел NP замещает родительский узел. На рисунках 15 и 16 показаны случаи вставки нового узла в качестве сына узла NP. В обоих случаях NP становится родительским узлом, а бывший родитель P становится правым сыном NP.
На рисунке 15 мы видим сдвиг узла X1, после того как он был вставлен в левое поддерево узла NP. На рисунке 16 изображено перемещение узла X2 после его вставки в правое поддерево NP.
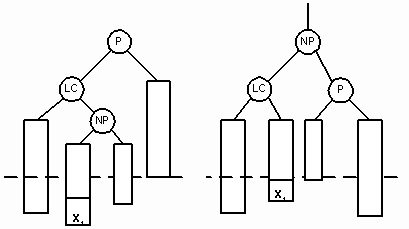
Рис. 15.
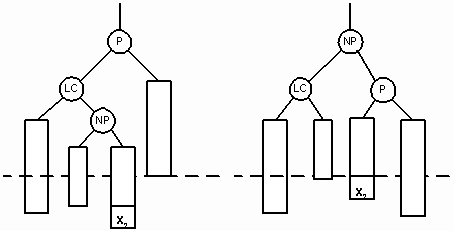
Рис. 16
// двойной поворот вправо вокруг узла p
template <class T>
void AVLTree<T>::DoubleRotateRight (AVLTreeNode<T>* &p)
{
// два поддерева, подлежащих повороту
AVLTreeNode<T> *lc, *np;
// узел lc <= узел np < узел p
lc = p->Left(); // левый сын узла p
np = lc->Right(); // правый сын узла lc
// обновить показатели сбалансированности в узлах p, lc и np
if (np->balanceFactor == rightheavy)
{
p->balanceFactor = balanced;
lc->balanceFactor = rightheavy;
}
else
{
p->balanceFactor = rightheavy;
lc->balanceFactor = balanced;
}
np->balanceFactor = balanced;
// перед тем как заменить родительский узел p, следует отсоединить его от старых детей и присоединить к новым
lc->Right() = np->Left();
np->Left() = lc;
p->Left() = np->Right();
np->Right() = p;
p = np;
}
Двойной поворот иллюстрируется на дереве, изображенном на рисунке 17. Попытка вставить узел 25 разбалансирует корневой узел 50. В этом случае узел 20 (LC) приобретает слишком высокое правое поддерево и требуется двойной поворот.
Новым родительским узлом (NP) становится узел 40. Старый родительский узел становится его правым сыном и присоединяет к себе узел 45, который также переходит с левой стороны дерева.
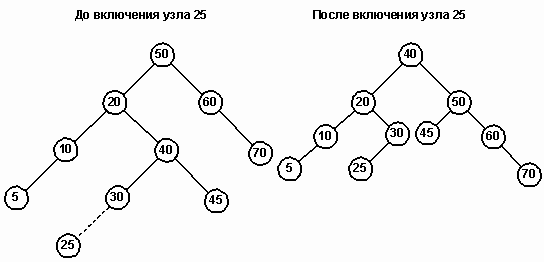
Рис. 17.
Оценка сбалансированных АВЛ - деревьев.
Обоснованность применения АВЛ - деревьев неоднозначна, поскольку они требуют дополнительных затрат на поддержание сбалансированности при вставке или удалении узлов. Если в дереве постоянно происходят вставки и удаления элементов, эти операции могут значительно снизить быстродействие.
С другой стороны, если ваши данные превращают бинарное дерево поиска в вырожденное, вы теряете поисковую эффективность и вынуждены использовать АВЛ - дерево. В большинстве случаев в программах используются алгоритмы, когда сначала заполняется список, а потом производится поиск по этому списку с небольшим количеством изменений. Поэтому на практике использование АВЛ - деревьев предпочтительно.
Для АВЛ - дерева не существует наихудшего случая, так как оно является почти полным бинарным деревом. Сложность операции поиска составляет O(log2n). Опыт показывает, что повороты требуются примерно в половине случаев вставок и удалений. Сложность балансировки обусловливает применение АВЛ - деревьев только там, где поиск является доминирующей операцией.
Оценка производительности АВЛ – деревьев.
Эта программа сравнивает сбалансированное и обычное бинарные деревья поиска, каждое из которых содержит N случайных чисел. Исходные данные для этих деревьев берутся из единого массива. Для каждого элемента массива осуществляется его поиск в обоих деревьях. Длины поисковых путей суммируются, а затем подсчитывается средняя длина поиска по каждому дереву. Программа прогоняется на 1000- и на 10000-элементном массивах.
Обратите внимание, что на случайных данных поисковые характеристики АВЛ - дерева несколько лучше. В самом худшем случае вырожденное дерево поиска, содержащее 1000 элементов, имеет среднюю глубину 500, в то время как средняя глубина АВЛ - дерева всегда равна 9.
#include <iostream.h>
#include "bstree.h"
#include "avltree.h"
#include "random.h"
// загрузить из массива числа в бинарное поисковое дерево и АВЛ – дерево
void SetupLists(BinSTree<int> &Tree1, AVLTree<int> &Tree2, int A[], int n)
{
int i;
RandomNumber rnd;
// запомнить случайное число в массиве А, а также вставить его в бинарное дерево поиска и в АВЛ - дерево
for (i=0; i<n; i++)
{
A[i] = rnd.Random(1000);
Tree1.Insert(A[i]);
Tree2.Insert(A[i]);
}
// поиск элемента item в дереве t
// при этом накапливается суммарная длина поиска
template <class T>
void PathLength(TreeNode<T> *t, long &totallength, int item)
{
// возврат, если элемент найден или отсутствует в списке
if (t == NULL || t->data == item)
return;
else
{
// перейти на следующий уровень, увеличить суммарную длину пути поиска
totallength++;
if (item < t->data)
PathLength(t->Left(), totallength, item);
else
PathLength(t->Right(), totallength, item);
}
void main(void);
{
// переменные для деревьев и массива
BinSTree<int> binTree;
AVLTree<int> avlTree;
int *A;
// суммарные длины поисковых путей элементов массива в бинарном дереве поиска и в АВЛ - дереве
long totalLengthBintree = 0, totalLengthAVLTree = 0;
int n, i;
cout << "Сколько узлов на дереве? ";
cin >> n;
// загрузить случайными числами массив и оба дерева
SetupLists(binTree, avlTree, A, n);
for (i=0; i<n; i++)
{
PathLength(binTree.GetRoot(), totalLengthBintree, A[i]);
PathLength((TreeNode<int> *)avlTree.getRoot(),
totalLengthAVLTree, A[i]);
}
cout << "Средняя длина поиска для бинарного дерева = "
<< float(totalLengthBintree)/n << endl;
cout << "Средняя длина поиска для сбалансированного дерева = "
<< float(totalLengthAVLTree)/n << endl;
}
Прогон 1:Сколько узлов на дереве? 1000
Средняя длина поиска для бинарного дерева = 10.256.
Средняя длина поиска для сбалансированного дерева = 7.901.
Прогон 2:Сколько узлов на дереве? 10000
Средняя длина поиска для бинарного дерева = 12.2822.
Средняя длина поиска для сбалансированного дерева = 8.5632.
Итераторы АВЛ - деревьев.
Сканирование узлов дерева более сложно, чем сканирование массивов и последовательных списков, так как дерево является нелинейной структурой и существует несколько способов прохождения дерева. Проблема каждого из них состоит в том, что до завершения рекурсивного процесса из него невозможно выйти. Нельзя остановить сканирование, проверить содержимое узла, выполнить какие-нибудь операции с данными, а затем вновь продолжить сканирование со следующего узла дерева.
Используя же итератор, клиент получает средство сканирования узлов дерева, как если бы они представляли собой линейный список, без обременительных деталей алгоритмов прохождения, лежащих в основе процесса. Наш класс использует класс Stack и наследуется от базового класса итератора. Поэтому сначала опишем класс Stack и базовый класс итератора.
Спецификация класса Stack.
Объявление:
#include <iostreani.h>
#include <stdlib.h>
const int MaxStackSize = 50;
class Stack
{
private:
DataType stacklist[MaxStackSize];
int top;
public:
// конструктор; инициализирует вершину
Stack(void);
// операции модификации стека
void Push(const DataType& item);
DataType Pop(void);
void ClearStack(void);
// доступ к стеку
DataType Peek(void) const;
// методы проверки состояния стека
int StackEmpty(void) const;
int StackFull(void) const; // для реализации, основанной на массиве
};
Описание:
Данные в стеке имеют тип DataType, который должен определяться с использованием оператора typedef. Пользователь должен проверять, полный ли стек, перед попыткой поместить в него элемент и проверять, не пустой ли стек, перед извлечением данных из него. Если предусловия для операции push или pop не удовлетворяются, печатается сообщение об ошибке и программа завершается. StackEmpty возвращает TRUE, если стек пустой, и FALSE - в противном случае. Используйте StackEmpty, чтобы определить, может ли выполняться операция Pop.
StackFull возвращает TRUE, если стек полный, и FALSE - в противном случае. Используйте StackFull, чтобы определить, может ли выполняться операция Push. ClearStack делает стек пустым, устанавливая top = -1. Этот метод позволяет использовать стек для других целей.
Реализация класса Stack.
Конструктор Stack присваивает индексу top значение -1, что эквивалентно условию пустого стека.
//инициализация вершины стека
Stack::Stack (void) : top(-l)
{ }
Операции стека.
Две основные операции стека вставляют (Push) и удаляют (Pop) элемент из стека. Класс содержит функцию Peek, позволяющую получать данные элемента, находящегося в вершине стека, не удаляя в действительности этот элемент. При помещении элемента в стек, top увеличивается на 1, и новый элемент вставляется в конец массива stacklist. Попытка добавить элемент в полный стек приведет к сообщению об ошибке и завершению программы.
// поместить элемент в стек
void Stack::Push (const DataTypes item)
{
// если стек полный, завершить выполнение программы
if (top == MaxStackSize-1)
{
cerr << "Переполнение стека!" << endl;
exit(l);
}
// увеличить индекс top и копировать item в массив stacklist
top++;
stacklist[top] = item;
}
Операция Pop извлекает элемент из стека, копируя сначала значение из вершины стека в локальную переменную temp и затем увеличивая top на 1. Переменная temp становится возвращаемым значением. Попытка извлечь элемент из пустого стека приводит к сообщению об ошибке и завершению программы.
// взять элемент из стека
DataType Stack::Pop (void)
DataType temp;
// стек пуст, завершить программу
if (top == -1)
{
cerr << "Попытка обращения к пустому стеку! " << end.1;
exit(1);
}
// считать элемент в вершине стека
temp = stacklist[top];
// уменьшить top и возвратить значение из вершины стека
top--;
return temp;
}
Операция Peek в основном дублирует определение Pop с единственным важным исключением. Индекс top не уменьшается, оставляя стек нетронутым.
// возвратить данные в вершине стека
DataType Stack::Peek (void) const
{
// если стек пуст, завершить программу
if (top == -1)
{
cerr << "Попытка считать данные из пустого стека!" << end.1;
exit(l);
}
return stacklist[top];
}
Условия тестирования стека.
Во время своего выполнения операции стека завершают программу при попытках клиента обращаться к стеку неправильно; например, когда мы пытаемся выполнить операцию Peek над пустым стеком. Для защиты целостности стека класс предусматривает операции тестирования состояния стека. Функция StackEmpty проверяет, является ли top равным -1. Если - да, стек пуст и возвращаемое значение - TRUE; иначе возвращаемое значение - FALSE.
// тестирование стека на наличие в нем данных
int Stack::StackEmpty(void) const
{
return top == -1;
}
Функция StackFull проверяет, равен ли top значению MaxStackSize - 1. Если так, то стек заполнен и возвращаемым значением будет TRUE; иначе, возвращаемое значение - FALSE.
// проверка, не переполнен ли стек
int Stack::StackFuli(void) const
{
return top == MaxStackSize-1;
}
Метод ClearStack переустанавливает вершину стека на -1. Это восстанавливает начальное условие, определенное конструктором.
// удалить все элементы из стека
void Stack::ClearStack(void)
{
top = -1;
}
Стековые операции Push и Pop используют прямой доступ к вершине стека и не зависят от количества элементов в списке.
Абстрактный базовый класс Iterator.
Класс Iterator позволяет абстрагироваться от тонкостей реализации алгоритма перебора, что дает независимость от деталей реализации базового класса. Мы определяем абстрактный класс Iterator как шаблон для итераторов списков общего вида.
Спецификация класса Iterator.
Объявление:
template <class T>
class Iterator
{
protected:
// Флаг, показывающий, достиг ли итератор конца списка должен поддерживаться производными классами
int iterationComplete;
public:
// конструктор
Iterator(void);
// обязательные методы итератора
virtual void Next(void) = 0;
virtual void Reset(void) = 0;
// методы для выборки/модификации данных
virtual T& Data(void) = 0;
// проверка конца списка
virtual int EndOfList(void) const;
};
Обсуждение:
Итератор является средством прохождения списка. Его основные методы: Reset (установка на первый элемент списка), Next (переход на следующий элемент), EndOfList (определение конца списка). Функция Data осуществляет доступ к данным текущего элемента списка.
Итератор симметричного метода прохождения.
Симметричное прохождение бинарного дерева поиска, в процессе которого узлы посещаются в порядке возрастания их значений, является полезным инструментом.
Объявление:
// итератор симметричного прохождения бинарного дерева использует базовый класс Iterator
template <class T>
class InorderIterator: public Iterator<T>
{
private:
// поддерживать стек адресов узлов
Stack< TreeNode <T> * > S;
// корень дерева и текущий узел
TreeNode<T> *root, *current;
// сканирование левого поддерева используется функцией Next
TreeNode<T> *GoFarLeft(TreeNode<T> *t);
public:
// конструктор
InorderIterator(TreeNode<T> *tree);
// реализации базовых операций прохождения
virtual void Next(void);
virtual void Reset(void);
virtual T& Data(void);
// назначение итератору нового дерева
void SetTree(TreeNode<T> *tree);
};
Описание:
Класс InorderIterator построен по общему для всех итераторов образцу. Метод EndOfList определен в базовом классе Iterator. Конструктор инициализирует базовый класс и с помощью GoFarLeft находит начальный узел сканирования.
Пример:
TreeNode<int> *root; // бинарное дерево
InorderIterator treeiter(root); // присоединить итератор
// распечатать начальный узел сканирования для смешанного прохождения это самый левый узел дерева
cout << treeiter.Data();
// сканирование узлов и печать их значений
for (treeiter.Reset(); !treeiter.EndOfList(); treeiter.Next())
cout << treeiter.Data() << " ";
Реализация класса InorderIterator.
Итерационный симметричный метод прохождения эмулирует рекурсивное сканирование с помощью стека адресов узлов. Начиная с корня, осуществляется спуск вдоль левых поддеревьев. По пути указатель каждого пройденного узла запоминается в стеке. Процесс останавливается на узле с нулевым левым указателем, который становится первым посещаемым узлом в симметричном сканировании. Спуск от узла t и запоминание адресов узлов в стеке выполняет метод GoFarLeft. Вызовом этого метода с t=root ищется первый посещаемый узел (рис. 18).
// вернуть адрес крайнего узла на левой ветви узла t
// запомнить в стеке адреса всех пройденных узлов
template <class T>
TreeNode<T> *InorderIterator<T>::GoFArLeft(TreeNode<T> *t)
{
// если t=NULL, вернуть NULL
if (t == NULL)
return NULL;
// пока не встретится узел с нулевым левым указателем, спускаться по левым ветвям, запоминая в стеке S адреса пройденных узлов. Возвратить указатель на этот узел
while (t->Left() != NULL)
{
S.Push(t);
t = t->Left();
}
return t;
}
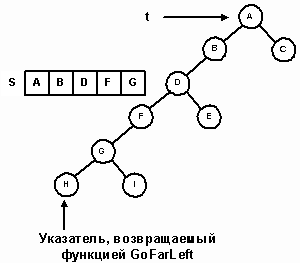
Рис. 18.
После инициализации базового класса конструктор присваивает элементу данных root адрес корня бинарного дерева поиска. Узел для начала симметричного сканирования получается в результате вызова функции GoFarLeft с root в качестве параметра. Это значение запоминается в переменной сurrent.
// инициализировать флаг iterationComplete. Базовый класс сбрасывает его, но
// дерево может быть пустым. начальный узлел сканирования - крайний слева узел.
template <class T>
InorderIterator<T>::InorderIterator(TreeNode<T> *tree):
Iterator<T>(), root(tree)
{
iterationComplete = (root == NULL);
current = GoFarLeft(root);
}
Метод Reset по существу является таким же, как и конструктор, за исключением того, что он очищает стек. Перед первым обращением к Next указатель current уже указывает на первый узел симметричного сканирования. Метод Next работает по следующему алгоритму. Если правая ветвь узла не пуста, перейти к его правому сыну и осуществить спуск по левым ветвям до узла с нулевым левым указателем, попутно запоминая в стеке адреса пройденных узлов.
Если правая ветвь узла пуста, то сканирование его левой ветви, самого узла и его правой ветви завершено. Адрес следующего узла, подлежащего обработке, находится в стеке. Если стек не пуст, удалить следующий узел. Если же стек пуст, то все узлы обработаны и сканирование завершено. Итерационное прохождение дерева, состоящего из пяти узлов, изображено на рисунке 19.
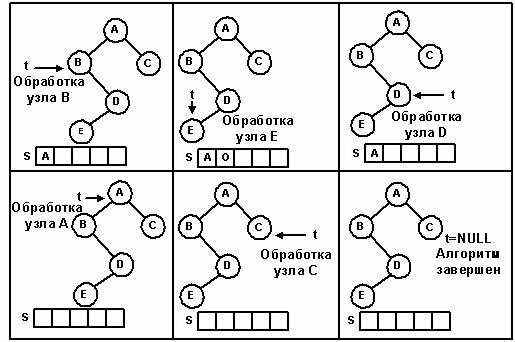
Рис. 19.
template <class T>
void InorderIterator<T>::Next(void)
{
// ошибка, если все узлы уже посещались
if (iterationComplete)
{
cerr << "Next: итератор прошел конец списка!" << endl;
exit(1);
}
// current - текущий обрабатываемый узел
// если есть правое поддерево, спуститься до конца по его левой ветви, попутно запоминая в стеке адреса пройденных узлов
if (current->Right() != NULL)
current = GoFarLeft(current->Right());
// правого поддерева нет, но в стеке есть другие узлы, подлежащие обработке.
// Вытолкнуть из стека новый текущий адрес, продвинуться вверх по дереву
else if (!S.StackEmpty())
current = S.Pop();
// нет ни правого поддерева, ни узлов в стеке. Сканирование завершено
else
iterationComplete = 1;
}
Алгоритм TreeSort.
Когда объект типа InorderIterator осуществляет прохождение дерева поиска, узлы проходятся в сортированном порядке и, следовательно, можно построить еще один алгоритм сортировки, называемый TreeSort. Этот алгоритм предполагает, что элементы изначально хранятся в массиве. Поисковое дерево служит фильтром, куда элементы массива копируются в соответствии с алгоритмом вставки в бинарное дерево поиска. Осуществляя симметричное прохождение этого дерева и записывая элементы снова в массив, мы получаем в результате отсортированный список. На рисунке 20 показана сортировка 8 - элементного массива.
#include "bstree.h"
#include "treeiter.h"
// использование бинарного дерева поиска для сортировки массива
template <class T>
void TreeSort(T arr[], int n)
{
// бинарное дерево поиска, в которое копируется массив
BinSTree<T> sortTree;
int i;
// вставить каждый элемент массива в поисковое дерево
for (i=0; i<n; i++)
sortTree.Insert(arr[i]);
// объявить итератор симметричного прохождения для sortTree
InorderIterator<T> treeSortIter(sortTree.GetRoot());
// выполнить симметричное прохождение дерева
// скопировать каждый элемент снова в массив
i = 0;
while (!treeSortIter.EndOfList())
{
arr[i++] = treeSortIter.Data();
treeSortIter.Next();
}
}
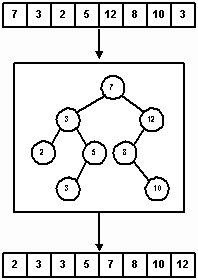
Рис. 20.
3. Алгоритм реализации АВЛ – деревьев через классы объектно – ориентированного программирования.
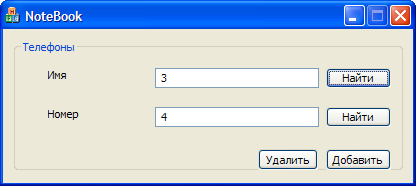
Программа создана на объектно – ориентированном языке программирования C++ в среде быстрой разработки (RAD) Bolrand C++ Builder 6.0, имеет графический интерфейс.
Текст программы.
#pragma once
template <typename KEY,typename VALUE> class AvlTree
{
public:
KEY key;
VALUE value;
int balance;
AvlTree<KEY, VALUE>* left;
AvlTree<KEY, VALUE>* right;
bool empty;//заполнены ключ и значение или нет
AvlTree()
{
empty=true;
left = NULL;
right = NULL;
balance = 0;
}
AvlTree(KEY Key,VALUE Value)
{
empty=false;
key = Key;
value = Value;
left = NULL;
right = NULL;
balance = 0;
}
int add(KEY Key, VALUE Value)//добавление узла, возвращает изменился баланс(1) или нет (0)
{ //при добавлении в правую ветку баланс узла увеличиваю на результат добавления
if (empty) //в левую уменьшаю
{ //после каждого вызова add(...) вызываю TurnAround();
key = Key; //дерево перестраивается пока потомок текущего узла в нужном направлении не будет NULL
value = Value; //потом в этого потомка записываем новые значения
empty=false;
return 0;
}
if (Key == key)
throw CString(L"Уже есть");
int a = balance;
if (Key > key)
{
if (right != NULL)
{
balance += right->add(Key, Value);
TurnAround();
}
else
{
right = new AvlTree<KEY, VALUE>(Key, Value);
balance++;
}
}
else
{
if (left != NULL)
{
balance -= left->add(Key, Value);
TurnAround();
}
else
{
left = new AvlTree<KEY, VALUE>(Key, Value);
balance--;
}
}
if (balance != a)
{
return 1;
}
else
{
return 0;
}
}
void TurnAround() //нормализация дерева, если баланс не равномерный смещаю(поворачиваю) узел так,
{ //чтобы количество потомков справа и слева не отличалось больше , чем на 1
if (balance == 2)
{
if (right->balance >= 0)
{
KEY tKey = key;
VALUE tValue = value;
key = right->key;
value = right->value;
right->key = tKey;
right->value = tValue;
AvlTree<KEY, VALUE>*tNode=right->right;
right->right = right->left;
right->left = left;
left = right;
right = tNode;
balance = left->balance - 1;
left->balance = 1 - left->balance;
}
else
{
KEY tKey = key;
VALUE tValue = value;
key = right->left->key;
value = right->left->value;
right->left->key = tKey;
right->left->value = tValue;
AvlTree<KEY, VALUE>* tNode = right->left->right;
right->left->right = right->left->left;
right->left->left = left;
left = right->left;
right->left = tNode;
balance = 0;
right->balance = (left->balance == -1) ? (1) : (0);
left->balance = (left->balance == 1) ? (-1) : (0);
}
}
else
{
if (balance == -2)
{
if (left->balance <= 0)
{
KEY tKey = key;
VALUE tValue = value;
key = left->key;
value = left->value;
left->key = tKey;
left->value = tValue;
AvlTree<KEY, VALUE>* tNode = left->left;
left->left = left->right;
left->right = right;
right = left;
left = tNode;
balance = 1 + right->balance;
right->balance = -1 - right->balance;
}
else
{
KEY tKey = key;
VALUE tValue = value;
key = left->right->key;
value