Работа и устройство процессоров
Свойства процессора
По мере появления новых процессоров их архитектура дополняется все новыми и новыми возможностями, которые позволяют не только улучшить эффективность выполнения тех или иных приложений, но и повысить надежность центрального процессора в целом. В следующих разделах представлено краткое описание различных технологий, включая режим управления системой, суперскалярное выполнение, технологии MMX и SSE.
SMM
Задавшись целью создания все более быстрых и мощных процессоров для портативных компьютеров, Intel разработала схему управления питанием. Эта схема позволяет процессорам экономно использовать энергию батареи и таким образом продлить срок ее службы. Такая возможность впервые была реализована компанией Intel в процессоре 486SL, который является усовершенствованной версией процессора 486DX. Впоследствии, когда возможности управления питанием стали более универсальными, их начали встраивать в Pentium и во все процессоры более поздних поколений. Система управления питанием процессоров называется SMM (System Management Mode — режим управления системой).SMM физически интегрирована в процессор, но функционирует независимо. Благодаря этому она может управлять потреблением мощности, в зависимости от уровня активности процессора. Это позволяет пользователю определять интервалы времени, по истечении которых процессор будет частично или полностью выключен. Данная схема также поддерживает возможность приостановки/возобновления, которая позволяет мгновенно включать и отключать мощность, что обычно используется в портативных компьютерах. Соответствующие параметры устанавливаются в BIOS.
Суперскалярное выполнение
В процессорах Pentium пятого и последующих поколений встроен ряд внутренних конвейеров, которые могут выполнять несколько команд одновременно. Процессор 486 и все предшествующие в течение определенного отрезка времени могли выполнять только одну команду. Технология одновременного выполнения нескольких команд называется суперскалярной. Благодаря использованию данной технологии и обеспечивается дополнительная эффективность по сравнению с процессором 486.Суперскалярная архитектура обычно ассоциируется с микросхемами RISC (Reduced Instruction Set Computer — компьютер с упрощенной системой команд). Процессор Pentium — одна из первых микросхем CISC (Complex Instruction Set Computer — компьютер со сложной системой команд), в которой применяется суперскалярная технология, реализованная во всех процессорах пятого и последующих поколений. Рассмотрим на примере установки электрической лампочки инструкции CISC.
1. Возьмите электрическую лампочку.
2. Вставьте ее в патрон.
3. Вращайте до отказа.
И аналогичный пример в виде инструкций RISC.
1. Поднесите руку к лампочке.
2. Возьмите лампочку.
3. Поднимите руку к патрону.
4. Вставьте лампочку в патрон.
5. Поверните ее.
6. Лампочка поворачивается в патроне? Если да, то перейти к п. 5.
7. Конец.
Многие инструкции RISC довольно просты, поэтому для выполнения какой-либо операции потребуется больше таких инструкций. Их основное преимущество состоит в том, что процессор выполняет меньшее количество операций, что, как правило, сокращает время выполнения отдельных команд и соответственно всей задачи (программы). Можно долго спорить о том, что же в действительности лучше — RISC или CISC, хотя, если говорить честно, такого понятия, как "чистая" микросхема RISC или CISC, не существует. Подобная классификация не более чем вопрос терминологии. Процессоры Intel и совместимые с ними процессоры можно определить как микросхемы CISC. Несмотря на это, процессоры пятого и шестого поколения обладают различными атрибутами RISC и разбивают во время работы команды CISC на более простые инструкции RISC.
Технология MMX
В зависимости от контекста, MMX может означать multi-media extensions (мультимедийные расширения) или matrix math extensions (матричные математические расширения). Технология MMX использовалась в старших моделях процессоров Pentium пятого поколения в качестве расширения, благодаря которому ускоряется компрессия/декомпрессия видеоданных, манипулирование изображением, шифрование и выполнение операций ввода-вывода — почти все операции, используемые во многих современных программах. В архитектуре процессоров MMX есть два основных усовершенствования. Первое, фундаментальное, состоит в том, что все микросхемы MMX имеют больший внутренний встроенный кэш, чем их собратья, не использующие эту технологию. Это повышает эффективность выполнения каждой программы и всего программного обеспечения независимо от того, использует ли оно фактически команды MMX. Другое усовершенствование MMX состоит в расширении набора команд процессора 57 новыми командами, а также во введении новой возможности выполнения команд, называемой одиночный поток команд — множественный поток данных (Single Instruction — Multiple Data, SIMD). В современных мультимедийных и сетевых приложениях часто используются циклы; хотя они занимают около 10% (или даже меньше) объема полного кода приложения, на их выполнение может уйти до 90% общего времени выполнения. SIMD позволяет одной команде осуществлять одну и ту же операцию над несколькими данными, подобно тому, как преподаватель, читая лекцию, обращается ко всей аудитории, а не к каждому студенту в отдельности. Технология SIMD позволяет ускорить выполнение циклов при обработке графических, анимационных, видео- и аудиофайлов; в противном случае эти циклы отнимали бы время у процессора. Intel также добавила 57 новых команд, специально разработанных для более эффективной обработки звуковых, графических и видеоданных. Эти команды предназначены для выполнения с высокой степенью параллелизма последовательностей, которые часто встречаются при работе мультимедийных программ. Высокая степень параллелизма в данном случае означает, что одни и те же алгоритмы применяются ко многим данным, например к данным в различных точках при изменении графического изображения. Такие компании, как AMD и Cyrix, лицензировали у Intel технологию MMX и реализовали ее в собственных процессорах.
Инструкции SSE и SSE2
В феврале 1999 года Intel представила общественности процессор Pentium III, содержащий обновление технологии MMX, получившей название SSE (Streaming SIMD Extensions — потоковые расширения SIMD). До этого момента инструкции SSE носили имя Katmai New Instructions (KNI), так как первоначально они были включены в процессор Pentium III с кодовым именем Katmai. Процессоры Celeron 533A и выше, созданные на основе ядра Pentium III, тоже поддерживают инструкции SSE. Более ранние версии процессора Pentium II, а также Celeron 533 и ниже (созданные на основе ядра Pentium II) SSE не поддерживают. Инструкции SSE содержат 70 новых команд для работы с графикой и звуком в дополнение к существующим командам MMX. Фактически этот набор инструкций кроме названия KNI имел еще и второе название — MMX-2. Инструкции SSE позволяют выполнять операции с плавающей запятой, реализуемые в отдельном модуле процессора. В технологиях MMX для этого использовалось стандартное устройство с плавающей запятой. Инструкции SSE2, содержащие в себе 144 дополнительные команды SIMD, были представлены в ноябре 2000 года вместе с процессором Pentium 4. В SSE2 были включены все инструкции предыдущих наборов MMX и SSE. Потоковые расширения SIMD (SSE) содержат целый ряд новых команд для выполнения операций с плавающей запятой и целыми числами, а также команды управления кэш-памятью. Новые технологии SSE позволяют более эффективно работать с трехмерной графикой, потоками аудио- и видеоданных (DVD-воспроизведение), а также приложениями распознавания речи. В целом SSE обеспечивает следующие преимущества: более высокое разрешение/качество при просмотре и обработке графических изображений; улучшенное качество воспроизведения звуковых и видеофайлов в формате MPEG2, а также одновременное кодирование и декодирование формата MPEG2 в мультимедийных приложениях; уменьшение загрузки процессора и повышение точности/скорости реагирования при выполнении программного обеспечения для распознавания речи. Инструкции SSE и SSE2 особенно эффективны при декодировании файлов формата MPEG2, который является стандартом сжатия звуковых и видеоданных, используемым в DVD-дисках. Следовательно, SSE-оснащенные процессоры позволяют достичь максимальной скорости декодирования MPEG2 без использования дополнительных аппаратных средств (например, платы декодера MPEG2). Кроме того, процессоры, содержащие набор инструкций SSE, значительно превосходят предыдущие версии процессоров при распознавании речи. Одним из основных преимуществ SSE по отношению к MMX является поддержка операций SIMD с плавающей запятой, что очень важно при обработке трехмерных графических изображений. Технология SIMD, как и MMX, позволяет выполнять сразу несколько операций при получении процессором одной команды. В частности, SSE поддерживает выполнение до четырех операций с плавающей запятой за цикл; одна инструкция может одновременно обрабатывать четыре блока данных. Для выполнения операций с плавающей запятой инструкции SSE могут использоваться вместе с командами MMX без заметного снижения быстродействия. SSE также поддерживает упреждающую выборку данных (prefetching), которая представляет собой механизм предварительного считывания данных из кэш-памяти. Обратите внимание, что наилучший результат использования новых инструкций процессора обеспечивается только при их поддержке на уровне используемых приложений. Сегодня большинство компаний, занимающихся разработкой программного обеспечения, модифицировали приложения, связанные с обработкой графики и звука, что позволило в более полной мере использовать возможности SSE. Например, графическое приложение Adobe Photoshop поддерживает инструкции SSE, что значительно повышает эффективность использования SSE-оснащенных процессоров. Поддержка инструкций SSE встроена в DirectX 6.1 и в самые последние видео- и аудиодрайверы, поставляемые с операционными системами Windows 98 Second Edition, Windows Me, Windows NT 4.0 (с пакетом обновления 5 или более поздним) и Windows 2000.Инструкции SSE являются расширением технологий MMX, а SSE2 — расширением инструкций SSE. Таким образом, процессоры, поддерживающие SSE2, поддерживают также инструкции SSE, а процессоры, поддерживающие инструкции SSE, в свою очередь, поддерживают оригинальные команды MMX. Это означает, что стандартные MMX-приложения могут выполняться практически на любых системах.
3DNow и Enhanced 3DNow
Технология 3DNow разработана компанией AMD в ответ на реализацию поддержки инструкций SSE в процессорах Intel. Впервые (май 1998 года) 3DNow реализована в процессорах AMD K6, а дальнейшее развитие — Enhanced 3DNow — эта технология получила в процессорах Athlon и Duron. Аналогично SSE, технологии 3DNow и Enhanced 3DNow предназначены для ускорения обработки трехмерной графики, мультимедиа и других интенсивных вычислений.3DNow представляет собой набор из 21 инструкции SIMD, которые оперируют массивом данных в виде единичного элемента. В Enhanced 3DNow к существующим добавлены еще 24 новых инструкции. Технологии обработки данных 3DNow и Enhanced 3DNow хотя и подобны SSE, но несовместимы на уровне инструкций, поэтому производителям программного обеспечения необходимо отдельно реализовать поддержку этих технологий. Технология 3DNow, как и SSE, поддерживает операции SIMD с плавающей запятой, а также позволяет выполнять до четырех операций с плавающей запятой за один цикл. Инструкции 3DNow для операций с плавающей запятой могут использоваться вместе с командами MMX без заметного снижения быстродействия. Поддерживается и упреждающая выборка данных — механизм предварительного считывания данных из кэшпамяти. Все технологии ускорения обработки данных компаний Intel и AMD реализованы на уровне операционных систем Windows 9x и Windows NT/2000. Кроме этого, все программные интерфейсы DirectX (с версии 6) компании Microsoft и Open GL компании SGI оптимизированы для технологии 3DNow, а практически все современные видеодрайверы 3Dfx, ATI, Matrox и nVidia поддерживают 3DNow и Enhanced 3DNow. Несмотря на то что технология 3DNow поддерживается многими компьютерными играми и драйверами видеоадаптеров, существует ряд профессиональных графических приложений, к числу которых относится и Adobe Photoshop, не поддерживающих 3DNow.
Supplemental Streaming SIMD Extension 3 (SSSE3) — это обозначение, данное Intel’ом 4-му расширению системы команд. Предыдущее имело обозначение SSE3 и Intel добавил ещё один символ 'S' вместо того, чтобы увеличить номер расширения, возможно потому, что они посчитали SSSE3 простым дополнением к SSE3. Часто, до того как стало использоваться официальное обозначение SSSE3, эти новые команды назывались SSE4. Также их называли кодовыми именами Tejas New Instructions (TNI) и Merom New Instructions (MNI) по названию процессоров, где впервые Intel намеревалась поддержать эти новые команды. Появившись в Intel Core Microarchitecture, SSSE3 доступно в сериях процессоров Xeon 5100 (Server и Workstation версии), а также в процессорах Intel Core 2 (Notebook и Desktop версии).
EM64T (англ. Extended Memory 64 Technology) — реализация 64-битных расширений AMD64 процессорной архитектуры IA-32 (архитектуры x86-совместимых процессоров) фирмы Intel. Основное улучшение, обеспечиваемое EM64T — 64-битная адресация оперативной памяти, что позволяет снять присущее 32-битным процессорам ограничение в 4 гигабайта адресуемой напрямую памяти
Динамическое выполнение
Этот метод впервые использован в микросхемах P6 (процессорах шестого поколения) и позволяет процессору параллельно обрабатывать сразу несколько команд, что приводит к уменьшению времени, необходимого для выполнения той или иной задачи. Это технологическое новшество включает в себя следующие элементы.
-Предсказание множественного перехода (ветвления). Предсказание потока выполнения программы через несколько ветвлений.
-Анализ потока команд. Назначение выполнения команд по мере готовности, независимо от их порядка в оригинальной программе.
-Упреждающее выполнение. Увеличение скорости выполнения за счет опережающего просмотра счетчика команд и выполнения тех команд, к которым, вероятно, потребуется обратиться позже.
Предсказание перехода
Функция предсказания перехода, ранее применявшаяся только в универсальных процессорах старших моделей, позволяет процессору при высокоскоростном выполнении команд сохранять конвейер заполненным. Специальный модуль выборки/декодирования, включенный в процессор, использует высоко оптимизированный алгоритм предсказания перехода, позволяющий предсказывать направление и результат команд, выполняемых через несколько уровней ветвлений, обращений и возвратов. Этот модуль напоминает шахматиста, разрабатывающего несколько различных стратегий перед началом шахматной партии, предсказывая ответные действия противника на несколько ходов вперед. Благодаря предсказанию результатов выполнения команды инструкции могут выполняться практически без задержек.
Анализ потока данных
Функция анализа потока команд используется для исследования потока данных, проходящих через процессор, и выявления любых возможностей выполнения команды с изменением заданной ранее последовательности. Специальный процессорный модуль отправки/выполнения контролирует команды и позволяет выполнять их в таком порядке, который оптимизирует использование модулей множественного суперскалярного выполнения. Возможность изменять последовательность выполнения команд позволяет сохранить занятость модулей выполнения даже в случае промаха кэш-памяти или обработки каких-либо информационно-зависимых команд.
Упреждающее выполнение
Способность процессора выполнять команды с помощью опережающего просмотра существующего счетчика команд называется упреждающим выполнением. Модуль отправки/выполнения, включенный в процессор, анализирует поток данных для выполнения всех команд, существующих в буфере (накопителе) команд, и сохранения результатов их выполнения в буферных регистрах. После этого модуль изъятия анализирует содержимое пула команд на предмет наличия завершенных команд, не зависящих от данных, получаемых при выполнении других команд, или команд, имеющих неразрешенные предсказания перехода. Результаты выполнения обнаруженных завершенных команд передаются в память модулем изъятия или соответствующей стандартной архитектурой Intel в том порядке, в котором они были получены. Затем команды удаляются из буфера.В сущности, динамическое выполнение устраняет зависимость от линейной последовательности команд. Выполнение команд с изменением их последовательности позволяет максимально загрузить модуль выполнения и уменьшить время ожидания, необходимое для получения данных из памяти. Несмотря на то что порядок предсказания и выполнения команд может быть изменен, их результаты передаются в исходном порядке, для того чтобы не прерывать и не изменять течение программы. Это позволяет процессорам P6 выполнять существующее программное обеспечение архитектуры Intel точно так же, как это делали P5 (Pentium) или процессоры более ранних версий, но на целый порядок быстрее!
Архитектура двойной независимой шины
Эта архитектура (Dual Independent Bus — DIB) впервые была реализована в процессоре шестого поколения и предназначалась для увеличения пропускной способности шины процессора и повышения производительности. При наличии двух независимых шин данных для ввода-вывода процессор получает доступ к данным с любой из них одновременно и параллельно, а не последовательно, как в системе с одной шиной. Вторая, или фоновая (backside) входная шина процессора с DIB применяется кэш-памятью второго уровня, поэтому она может работать значительно быстрее, чем в том случае, если бы ей пришлось использовать (совместно с процессором) основную шину. В архитектуре DIB предусмотрено две шины: шина кэш-памяти второго уровня и шина, соединяющая процессор и основную память, или системная шина. Процессоры Pentium Pro, Celeron, Pentium II/III, Athlon и Duron могут использовать обе шины одновременно, благодаря чему снижается критичность такого параметра, как пропускная способность шины. Благодаря архитектуре двойной шины кэш-память второго уровня более современных процессоров может работать на полной скорости в ядре процессора на независимой шине, используя при этом основную шину центрального процессора (FSB) для обработки текущих данных, поступающих на микросхему и отправляемых ею. Шины работают с разной тактовой частотой. Шина FSB, или главная шина центрального процессора, соединена с системной платой, а шина кэш-памяти второго уровня — непосредственно с ядром процессора. При увеличении рабочей частоты процессора увеличивается тактовая частота кэш-памяти второго уровня. Для реализации архитектуры DIB кэш-память второго уровня перемещена с системной платы в один корпус с процессором, что позволило приблизить быстродействие кэш-памяти второго уровня к быстродействию встроенной кэш-памяти, которое значительно превосходит быстродействие памяти, помещаемой на системную плату. Чтобы поместить кэш в корпус процессора, понадобилось модифицировать гнездо процессора. DIB также позволяет системой шине выполнять одновременно несколько транзакций (а не одну последовательность транзакций), благодаря чему ускоряется поток информации внутри системы и повышается эффективность. Все средства архитектуры DIB повышают пропускную способность почти в три раза по сравнению с процессором, имеющим архитектуру одиночной шины
Производство процессоров
Основным химическим элементом, используемым при производстве процессоров, является кремний, самый распространенный элемент на земле после кислорода. Это базовый компонент, из которого состоит прибрежный песок (кремниевый диоксид); однако в таком виде он не подходит для производства микросхем. Чтобы использовать кремний в качестве материала для изготовления микросхемы, необходим длительный технологический процесс, который начинается с получения кристаллов чистого кремния по методу Жокральски (Czochralski). По этой технологии сырье, в качестве которого используется в основном кварцевая порода, преобразуется в электродуговых печах в металлургический кремний. Затем для удаления примесей полученный кремний плавится, дистиллируется и кристаллизуется в виде полупроводниковых слитков с очень высокой степенью чистоты (99,999999%). После механической нарезки слитков полученные заготовки загружаются в кварцевые тигли и помещаются в электрические сушильные печи для вытяжки кристаллов, где плавятся при температуре более 2500° по Фаренгейту. Для того чтобы предотвратить образование примесей, сушильные печи обычно устанавливаются на толстом бетонном основании. Бетонное основание, в свою очередь, устанавливается на амортизаторах, что позволяет значительно уменьшить вибрацию, которая может негативно сказаться на формировании кристалла. Как только заготовка начинает плавиться, в расплавленный кремний помещается небольшой, медленно вращающийся затравочный кристалл. По мере удаления затравочного кристалла от поверхности расплава вслед за ним вытягиваются кремниевые нити, которые, затвердевая, образуют кристаллическую структуру. Изменяя скорость перемещения затравочного кристалла (10-40 мм в час) и температуру (примерно 2500° по Фаренгейту), получаем кристалл кремния малого начального диаметра, который затем наращивается до нужной величины. В зависимости от размеров изготавливаемых микросхем, выращенный кристалл достигает 8-12 дюймов (20-30 мм) в диаметре и 5 футов (около 1,5 м) в длину.
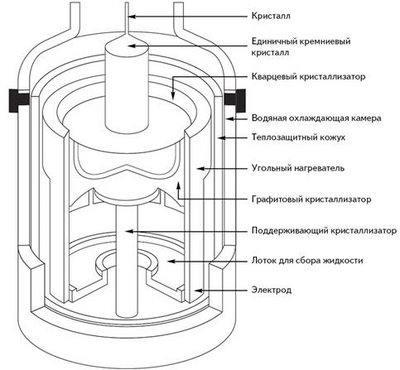
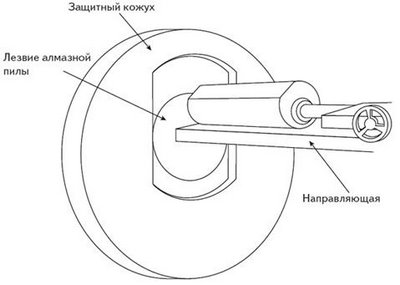
Вес выращенного кристалла достигает нескольких сотен фунтов. Заготовка вставляется в цилиндр диаметром 200 мм (текущий стандарт), часто с плоской вырезкой на одной стороне для точности позиционирования и обработки. Затем каждая заготовка разрезается алмазной пилой более чем на тысячу круговых подложек толщиной менее миллиметра (рис2). После этого подложка полируется до тех пор, пока ее поверхность не станет зеркально гладкой. В производстве микросхем используется процесс, называемый фотолитографией. Технология этого процесса такова: на полупроводник, служащий основой чипа, один за другим наносятся слои разных материалов; таким образом, создаются транзисторы, электронные схемы и проводники (дорожки), по которым распространяются сигналы. В точках пересечения специфических схем можно создать транзистор или переключатель (вентиль). Фотолитографический процесс начинается с покрытия подложки слоем полупроводника со специальными добавками, затем этот слой покрывается фоторезистивным химическим составом, а после этого изображение микросхемы проектируется на ставшую теперь светочувствительной поверхность. В результате добавления к кремнию (который, естественно, является диэлектриком) донорных примесей получается полупроводник. Проектор использует специальный фотошаблон (маску), который является, по сути, картой данного конкретного слоя микросхемы. (Микросхема процессора Pentium III содержит пять слоев; другие современные процессоры могут иметь шесть или больше слоев. При разработке нового процессора потребуется спроектировать фотошаблон для каждого слоя микросхемы.) Проходя через первый фотошаблон, свет фокусируется на поверхности подложки, оставляя отпечаток изображения этого слоя. Затем специальное устройство несколько перемещает подложку, а тот же фотошаблон (маска) используется для печати следующей микросхемы. После того как микросхемы будут отпечатаны на всей подложке, едкая щелочь смоет те области, где свет воздействовал на фоторезистивное вещество, оставляя отпечатки фотошаблона (маски) конкретного слоя микросхемы и межслойные соединения (соединения между слоями), а также пути прохождения сигналов. После этого на подложку наносится другой слой полупроводника и вновь немного фоторезистивного вещества поверх него, затем используется следующий фотошаблон (маска) для создания очередного слоя микросхемы. Таким способом слои наносятся один поверх другого до тех пор, пока не будет полностью изготовлена микросхема.
Финальная маска добавляет так называемый слой металлизации, используемый для соединения всех транзисторов и других компонентов. В большинстве микросхем для этого слоя используют алюминий, но в последнее время стали использовать медь. Например, при производстве процессоров компании AMD на фабрике в Дрездене используется медь. Это объясняется лучшей проводимостью меди по сравнению с алюминием. Однако для повсеместного использования меди необходимо решить проблему ее коррозии.
Когда обработка круговой подложки завершится, на ней будет фотоспособом отпечатано максимально возможное количество микросхем. Микросхема обычно имеет форму квадрата или прямоугольника, по краям подложки остаются некоторые "свободные" участки, хотя производители стараются использовать каждый квадратный миллиметр поверхности. Промышленность переживает очередной переходный период в производстве микросхем. В последнее время наблюдается тенденция к увеличению диаметра подложки и уменьшению общих размеров кристалла, что выражается в уменьшении габаритов отдельных схем и транзисторов и расстояния между ними. В конце 2001 и начале 2002 года произошел переход с 0,18- на 0,13-микронную технологию, вместо алюминиевых межкристальных соединений начали использовать медные, при этом диаметр подложки увеличился с 200 мм (8 дюймов) до 300 мм (12 дюймов). Увеличение диаметра подложки до 300 мм позволяет удвоить количество изготавливаемых микросхем. Использование 0,13-микронной технологии позволяет разместить на кристалле большее количество транзисторов при сохранении его приемлемых размеров и удовлетворительного процента выхода годных изделий. Это означает сохранение тенденции увеличения объемов кэш-памяти, встраиваемой в кристалл процессора. В качестве примера того, как это может повлиять на параметры определенной микросхемы, рассмотрим процессор Pentium 4.
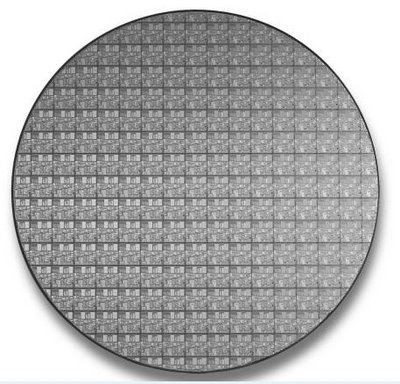
Диаметр стандартной подложки, используемой в полупроводниковой промышленности в течение уже многих лет, равен 200 мм или приблизительно 8 дюймов(рис). Таким образом, площадь подложки достигает 31 416 мм2. Первая версия процессора Pentium 4, изготовленного на 200-миллиметровой подложке, содержала в себе ядро Willamette, созданное на основе 0,18-микронной технологии с алюминиевыми контактными соединениями, расположенными на кристалле площадью около 217 мм2. Процессор содержал в себе 42 млн. транзисторов. На 200-миллиметровой (8-дюймовой) подложке могло разместиться до 145 подобных микросхем. Процессоры Pentium 4 с ядром Northwood, созданные по 0,13-микронной технологии, содержат в себе медную монтажную схему, расположенную на кристалле площадью 131 мм2. Этот процессор содержит уже 55 млн. транзисторов. По сравнению с версией Willamette ядро Northwood имеет удвоенный объем встроенной кэш-памяти второго уровня (512 Кбайт), что объясняет более высокое количество содержащихся транзисторов. Использование 0,13-микронной технологии позволяет уменьшить размеры кристалла примерно на 60%, что дает возможность разместить на той же 200-миллиметровой (8-дюймовой) подложке до 240 микросхем. Как вы помните, на этой подложке могло разместиться только 145 кристаллов Willamette. В начале 2002 года Intel приступила к производству кристаллов Northwood на большей, 300-миллиметровой подложке площадью 70 686 мм2. Площадь этой подложки в 2,25 раза превышает площадь 200-миллиметровой подложки, что позволяет практически удвоить количество микросхем, размещаемых на ней. Если говорить о процессоре Pentium 4 Northwood, то на 300-миллиметровой подложке можно разместить до 540 микросхем. Использование современной 0,13-микронной технологии в сочетании с подложкой большего диаметра позволило более чем в 3,7 раза увеличить выпуск процессоров Pentium 4. Во многом благодаря этому современные микросхемы зачастую имеют более низкую стоимость, чем микросхемы предыдущих версий. В 2003 году полупроводниковая промышленность перешла на 0,09-микронную технологию. При вводе новой поточной линии не все микросхемы на подложке будут годными. Но по мере совершенствования технологии производства данной микросхемы возрастет и процент годных (работающих) микросхем, который называется выходом годных. В начале выпуска новой продукции выход годных может быть ниже 50%, однако ко времени, когда выпуск продукта данного типа прекращается, он составляет уже 90%. Большинство изготовителей микросхем скрывают реальные цифры выхода годных, поскольку знание фактического отношения годных к бракованным может быть на руку их конкурентам. Если какая-либо компания будет иметь конкретные данные о том, как быстро увеличивается выход годных у конкурентов, она может скорректировать цены на микросхемы или спланировать производство так, чтобы увеличить свою долю рынка в критический момент. Например, в течение 1997 и 1998 годов у AMD был низкий выход годных, и компания утратила значительную долю рынка. Несмотря на то что AMD предпринимала усилия для решения этой проблемы, ей все же пришлось подписать соглашение, в соответствии с которым IBM Microelectronics должна была произвести и поставить AMD некоторые ею же разработанные микропроцессоры. По завершении обработки подложки специальное устройство проверяет каждую микросхему на ней и отмечает некачественные, которые позже будут отбракованы. Затем микросхемы вырезаются из подложки с помощью высокопроизводительного лазера или алмазной