Приховані марківські процеси
Міністерство освіти та науки України
Національний університет «Львівська політехніка»
Курсова робота
з дисципліни
Інформаційні інтелектуальні системи
на тему
«Приховані марківські процеси»
Львів – 2009
Зміст
1. Постановка проблеми, якій присвячується тема курсової роботи
2. Огляд літератури за тематикою курсової роботи
3. Постановка завдання яке буде виконане у курсовій роботі
4. Існуючі шляхи вирішення задачі
5. Основні результати, які отримані в результаті вирішення задачі
6. Місце і спосіб застосування отриманих результатів
7. Програмна реалізація завдання, виконаного у курсовій роботі
7.1 Алгоритм ELVIRS для окремо вимовлених слів
7.2 Алгоритм ELVIRCOS для розпізнавання злитого мовлення
8. Експериментальні результати
9. Список використаної літератури
1. Постановка проблеми, якій присвячується тема курсової роботи
Приховані марківські процеси (ПМП), специфікація яких була опублікована ще в кінці 60-х років, останнім часом стали дуже популярні. По-перше, математична структура ПМП дуже багата і дозволяє вирішувати математичні проблеми різних галузей науки. По-друге, грамотно спроектована модель дає на практиці гарні результати роботи.
Явища, що відбуваються, можна описувати як сигнали. Сигнали можуть бути дискретними, як письмова мова, або безперервними, як фонограма або кардіограма. Сигнали з постійними статистичними властивостями, називаються стабільними (стаціонарними), а з мінливими - нестабільними (нестаціонарними). Сигнал, може бути чистим, а може й не чистим, з телефонів або зі сторонніми сигналами.
Для опису сигналів часто потрібні математичні моделі. У моделі сигналу на основі його характеристик може бути передбачений певний механізм обробки, що дозволяє одержати бажаний вихід при аналізі сигналу. Наприклад, якщо треба облагородити сигнал, спотворений і зашумлений при передачі, ми можемо змоделювати його, і розглянути цю модель не звертаючи увагу на спотворення шумів в сигналі. Моделі дозволяють також генерувати і досліджувати сигнал без його джерела. У цьому випадку, маючи під рукою гарну модель, ми можемо імітувати сигнал і вивчити його з цієї імітації.
Моделі дуже успішно застосовуються на практиці, що дозволяє створювати ефективні робочі системи: системи прогнозу, розпізнавання, ідентифікації. Грубо всі моделі можна розділити на детерміністичні та статистичні. Детерміністичні використовуються, якщо відомі фундаментальні характеристики сигналу: сигнал - це синусоїдальна хвиля або, наприклад, сума експонент. У такому випадку досить просто описати подібну модель сигналу - для цього потрібно всього лише підібрати (обчислити) параметри цієї моделі: для синусоїдальної хвилі - це амплітуда, частота, фаза. Другий клас - це статистичні моделі, які, у відповідності зі своєю назвою, використовують в якості основи статистичні характеристики сигналу. Ці моделі описують гауссови, пуассоновскі, Марківські процеси, а також подібні до них процесиВ загальному, статистичні моделі описують сигнал як певний випадковий процес, параметри якого можуть бути якісно визначені. [2]
В області розпізнавання мовлення використовуються обидва типи моделей, але ми розглянемо тільки одну, статистичну модель, а саме - приховану Марківську модель (ПММ).[3]
Теорія прихованих Марківських моделей не нова. Її основи опублікував Баум і його колеги в кінці 60-х, початку 70-х років. Тоді ж, на початку 70-х Бейкер і Джелінек з колегами застосували ПММ в розпізнаванні мови.
2. Огляд літератури за тематикою курсової роботи
Виконуючи підготовку до курсової роботи я використовувала такі матеріали
Із матеріалів Вікіпедії (uk.)- визначення марківського процесу.
Марківський процес — це випадковий процес, конкретні значення якого для будь-якого заданого часового параметру t+1 залежать від значення у момент часу t, але не залежать від його значень у моменти часу t-1, t-2 і т. д.[6]
На сайті www.nbuv.gov-сутність поняття марківського процесу. Прикладом марківського процесу може бути відома дитяча гра, у якій фішки учасників повинні переміститися з початкового пункту А0 ("старт") у кінцевий Ak ("фініш"). Потрапивши в той або інший проміжний пункт AJ, фішка може або наблизитися до фінішу (за рахунок "пільги", передбаченої умовами гри), або видалитися від нього (за рахунок "штрафу").
Статтю Т.В. Грищука «Отримання характеристичної обсервації прихованої марківської моделі». В статті розглядається процес отримання на основі натренованої прихованої моделі характеристичної обсервації голосової команди. Ця інформація може використовуватися для підвищення ефективності процесу розпізнання мови. Введено поняття оціночної функції, знаходження максимуму якої дає характеристичну обсервацію.
Вісник НАН України. — 2003. — N 1. Стаття І. Сергієнко, А. Гупал. Стаття в якій описується ланцюг Маркова — проста та економна модель дослідження поведінки об'єктів із залежними ознаками.
Стаття «Алгоритм Витерби для моделей скрытых марковских процессов с неизвестным моментом появления скачка». В цій статті показані результати математичного моделювання для алгоритма Вітербі, за допомогою прихованих марківських процесів.[3]
teormin.ifmo/education/machine-learning/notes-06-hmm.pdf Стаття «Приховані марківські моделі». В ній є поняття прихованих марківських процесів, конкретні приклади та пояснюються елементи прихованих марківських моделей. Також пояснюється зміст та вирішення задач прихованих марківських моделей.[5]
lib-ru/diss/cont/9307.html Стаття «Скрытые марковские модели», в якій описується марківські ланцюги та процеси, а також розв`язок задач прихованих марківських моделей.[2]
genetics.wustl.edu/eddy В цій статті наведений приклад застосування Прихованих марківських моделей як програмного забезпечення для аналізу послідовності білка. HMMER є програмною реалізацією. HMMER1 широко використовується для аналізу ДНК, на додаток до аналізу білків.[1]
3. Постановка завдання яке буде виконане у курсовій роботі
Розглянемо систему, яку можна в будь-який момент часу можна описати одним з N станів, S1, S2,...SN, (мал. 1), де для простоти N = 5. Через певний проміжок часу система може змінити свій стан або залишитися в колишньому стані відповідно до ймовірностям, зазначеним для цих станів. Моменти часу, коли ми реєструємо стан системи ми позначимо як t=1,2,... , а стан в момент часу t - ми позначимо q t. Повний опис розглянутої вище системи, повинно містити поточний стан (в момент часу t) і послідовність всіх попередніх станів, через які пройшла система. В окремих випадках опис системи зводиться до вказівкою поточного та попереднього стану.
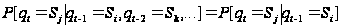 (1)
Крім того, ми також вважаємо що процеси, що протікають у системі, не залежать від часу, про що нам говорить права частина формули (1). Таким чином, систему можна описати безліччю ймовірностей a i j у вигляді
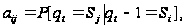
 (2)
де a i j - це ймовірність переходу з стану S i в стан S j в даний момент часу. Оскільки ці ймовірності характеризують випадковий процес, вони мають звичайні властивості, т. е.
 (3.1)
 (3.2)
Описаний вище випадковий процес можна назвати відкритою марківською моделю, оскільки вихідний сигнал моделі - це послідовність станів реєструються в часі. Кожен стан відповідає певному (що спостерігається) події. Для того, щоб краще зрозуміти все вищесказане, розглянемо просту марківську модель погоди, у якій буде всього три стану. Передбачається, що ми один раз на день (наприклад, в опівдні), дивимося у вікно і реєструємо в журналі поточний стан погоди. Ми домовилися, що лише один із трьох нижче названих станів в день t ми записуємо в журнал:
Стан № 1: дощ (або сніг)
Стан № 2: хмарно, можливий дощ
Стан № 3: ясно
Матриця ймовірностей зміни погоди A має вигляд
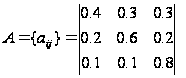
Виходячи
з того, що погода
в перший день
(t = 1) ясна (стан
3), ми можемо задати
собі питання:
яка вірогідність
(згідно з нашою
моделі), що наступні
7 днів буде саме
«зрозуміло
- ясно - дощ - дощ
- ясно - Хмарно,
можливий дощ
- ясно »? Точніше
сказати, для
цієї послідовності
станів O, де
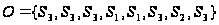 відповідає,
t=1,2,...,8, Ми хочемо
на основі даної
моделі визначити
ймовірність
спостереження
послідовності
O. Ця ймовірність
може бути виражена
(і обчислено)
наступним чином
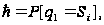
 (4)
це ймовірність того, що початковий стан системи буде Si.
Є й інший цікаве питання, відповідь на яке нам дасть ця модель: яка вірогідність того, що модель збереже свій стан протягом рівно d днів? Ця ймовірність може бути обчислено як ймовірність спостереження такій послідовності
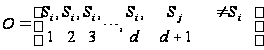
дає модель, в якій
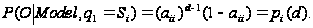 (5)
Величина pi (d) - це ймовірність того, що система буде перебувати в стані i рівно d раз поспіль. Відповідно є функція розподілу ймовірності для тривалості перебування системи в одному стані, яка є характеристикою збереження стану для марківських ланцюга. Знаючи величини pi (d) ми можемо обчислити середній час, протягом якого система збереже свій стан (використовуємо формулу математичного очікування):
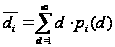 (6.1)
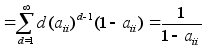 (6.2)
Очікується, що сонячна погода швидше за все простоїть 5 днів, похмура - 2,5 дні, а от дощова погода, згідно з нашою моделі, імовірніше за все протримається 1,67 дня.
4. Існуючі шляхи вирішення задачі
У описаної марківській моделі кожній фізичній явищу відповідало певний стан моделі. Ця модель, на жаль, занадто обмежена, і їй не під силу рішення багатьох актуальних проблем. У цьому розділі ми розглянемо марківські моделі, у яких спостерігаються послідовність - це результат переходів у відповідності з позначеними ймовірностей. У даному випадку модель (прихована марківська модель) - це результат двох випадкових процесів. Перший - прихований процес - його ніяк не можна зареєструвати, але його можна охарактеризувати за допомогою іншого випадкового процесу, який надає нам набір сигналів - спостерігається послідовність. Проілюструємо цей опис на прикладі підкидання монети.
Приклад монети, яку підкидають. Ви знаходитесь в кімнаті, а за перегородкою - в іншій кімнаті - знаходиться людина, яка підкидає монету. Він не говорить, як саме він підкидає монету, а може він її взагалі лінується підкидали. Він лише говорить вам результат кожного падіння монети: орел чи решка. У цьому й полягає суть прихованого процесу (ви не знаєте, що відбувається з монетою), коли про процесі ви можете судити лише за що спостерігається послідовності
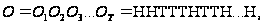 ,
де Н - це орел, а Т - це решка.
Як же побудувати приховану марківську модель, що відповідає цій ситуації? Перше питання: скільки станів буде у моделі і що означає кожне стан такої моделі? Припустимо, що ми підкидаємо одну єдину монету, а інших у нас немає. Тоді вибір ми зупинимо на моделі з двома станами, де одне стан означає випадання орла, інше - решка. [1]
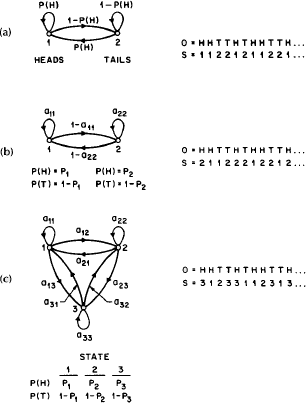
мал. 2.
Три марківські моделі, які можуть описати експеримент з монетою, що підкидається. (а) 1 монета бере участь у підкиданні, (2) 2 - монети, (3) - три монети.
Ця модель зображена на малюнку 2 (а). У цьому випадку марківських модель є відкритою і єдине, що ми можемо зробити з цією моделлю - це оптимізувати ймовірність зміни стану. Слід зауважити, що прихована марківських модель, що є аналогом моделі, зображеної на рис. 2 (а), буде представляти собою модель одного стану. В цій моделі єдине стан означає, що підкидана всього лише одна монета.
На наступному малюнку 2 (б) зображена ПММ двох станів. У цьому випадку кожне стан відповідає різним монетам, які підкидають в ході експерименту (наприклад, 1 копійка і 5 рублів). Кожному станом відповідає розподіл ймовірностей між випаданням орла і решка, а також матрицею ймовірностей переходів (матрицею переходів), що вказує ймовірність переходу з одного стану в інше. Перехід зі стану в стан згідно з заданим ймовірностям з матриці переходів може здійснюється на основі того ж підкидання монети або на основі будь-якої іншої випадкової події.
На третьому малюнку 2 (в) представлена модель, що враховує той факт, що підкидають три різні монети, причому вибір між ними здійснюється знову ж таки на основі якого-небудь випадкового події.
Тут, як і кожен раз при проектуванні ми задаємося питанням: яка з трьох моделей найкращим чином підходить для опису, що спостерігається послідовності? Добре видно, що перша модель (мал. 2 (а)) має всього лише 1 невідомий параметрМодель для двох монет (мал. 2 (б)) має 4 невідомих параметра І нарешті, модель для трьох монет (мал. 3 (в)) має 9 невідомих параметрів. Таким чином, ПММ з великою кількістю ступенів свободи по суті більш дієздатна, ніж її менші аналоги. Також теоретично доведено (і це ми побачимо далі), що в сучасних умовах існують обмеження на розмір моделей. Більш того, може виявитися, що у випадку, коли людина за стіною підкидає одну єдину монету, ми виберемо модель трьох станів. У такому випадку з'ясовується, що стану системи не відповідають реальним станів за стіною, і, отже, ми використовуємо надлишкову модель.
Приклад кульок у вазах. Зараз ми доповнимо ПММ новими структурними елементами, для того, щоб вона могла вирішувати ряд більш складних завдань. Допоможе нам в цьому приклад з кульками у вазах (мал. 3).
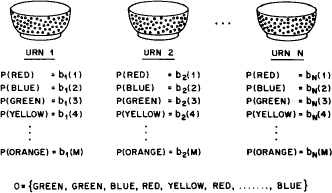
мал. 3. Модель з N станами (вазами) та кульками, кольори яких позначають елементи що спостерігається послідовності.
Припустимо, у нас є N скляних прозорих ваз. У кожній вазі - велике число кульок різного кольоруВважаємо, що у нас в кошику лежать кульки M різних кольорів. Фізично це можна представити наступним чином. Людина знаходиться в кімнаті з вазами. Яким-небудь випадковим чином він вибирає будь-яку вазу, простягає руку глибше, і витягує м'яч. Колір кулі записується в журнал показань - спостерігається послідовність, і людина кладе шар назад в цю вазу. Потім наша людина вибирає нову вазу, і йде до неї, і витягує звідти новий шар, і так далі. В результаті ми отримуємо послідовність кольорів - результат роботи ПММ - спостерігається послідовність.
Очевидно, що приклад кульок у вазах відповідає прихованої марківській моделі, де кожне стан моделі - це обрана ваза, причому в різних ваз різну ймовірність витягти кульку червоного (або іншого) кольору, що відповідає різного розподілу ймовірностей для кожного стану. Те, яка ваза буде обрана наступної, залежить від матриці переходів ПММ, т. е. залежить і від того, у якої вази ми зараз знаходимося.[1]
Елементи прихованої марківської моделі
Наведені вище приклади дають непогане уявлення про ПММ, і про можливі сферах їх застосування. Зараз ми дамо формальне визначення елементів ПММ і зрозумілий, як модель генерує спостережувану послідовність. ПММ визначається наступними елементами:
1. N
- загальна
кількість
станів
в моделі. Незважаючи
на те, що стану
в ПММ є прихованими,
у багатьох
випадках є
відповідність
між станом
моделі і реальним
станом процесу.
У прикладі з
підкиданням
монети кожне
стан відповідно
до обраної
монеті, а в прикладі
з кульками у
вазах стан
моделі відповідно
до обраної
вазі. В загальному,
перехід у будь-який
обраний стан
можливий з
будь-якого
стану всієї
системи (в тому
числі й сама
в себе); з іншого
боку, і це ми
побачимо згодом,
лише певні
шляхи переходів
представляють
інтерес у кожної
конкретної
моделі. Ми позначимо
сукупність
станів моделі
безліччю
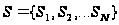 ,
, a поточний
стан в момент
часу
t як q.
2. M,
кількість
можливих символів
у що
спостерігається
послідовності,
розмір алфавіту
послідовності.
У випадку з
підкиданням
монети - це 2
символу: орел
і решка; у випадку
з кульками - це
кількість
кольорів цих
самих кульок.
Алфавіт
що спостерігається
в послідовності
ми позначимо
як
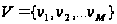 .
3. Матриця
ймовірностей
переходів (або
матриця переходів)
 ,
де
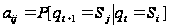 ,
 (7)
ттобто це ймовірність того, що система, що перебуває в стані Si, перейде в стан Sj. Якщо для будь-яких двох станів в моделі можливий перехід з одного стану в інше, то a i j> 0 для будь-яких i, j. В інших ПММ для деяких i, j у нас ймовірність переходу a i j = 0.
4. Розподіл
ймовірностей
появи символів
у j-тому стані,
 ,
где ,
де
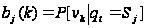

 (8)
b j (k) - імовірність того, що в момент часу t, система, яка знаходиться в j-му стані (стан Sj), видасть k-тий символ (символ k) в спостережувану послідовність.
5. Розподіл
ймовірностей
початкового
стану
 ,
где ,
де
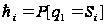 ,
,
(9)
тобто ймовірність того, Si - це початковий стан моделі.
Сукупність значень N, M, A, B і π - це прихована марківська модель, яка може згенерувати послідовність
 (10)
(де O t — один з символів алфавіту V , а T — це кількість елементів в послідовності.
ПММ будує спостережувану послідовність по наступному алгоритмі
Вибираємо початковий стан q 1 = S i відповідно до розподілу π
Встановлюємо t = 1 .
Вибираємо O t = v k відповідно до розподілу b j ( k ) у стані ( S i ).
Переводимо модель у новий стан q t + 1 = S j відповідно до матриці переходів a i j з урахуванням поточного стану S i .
Встановлюємо час t = t + 1 ; вертаємося до кроку 3, якщо t < T ; інакше — закінчуємо виконання.
Підбиваючи підсумок, можливо помітити, що повний опис ПММ складається із двох параметрів моделі ( N і M ), опису символів спостережуваної послідовності й трьох масивів ймовірностей — A , B , і π . Для зручності ми використаємо наступний запис
 (11)
для позначення достатнього опису параметрів моделі.
5. Основні результати, які отримані в результаті вирішення задачі
Відповідно до опису схованої марківської моделі, викладеному в попередньому розділі, існує три основних задачі, які повинні бути вирішені для того, щоб модель могла успішно вирішувати поставлені перед нею задачі.
Задача 1
Дано: спостережувана послідовність і модель λ = ( A , B ,π) . Необхідно обчислити ймовірність P ( O | λ) — імовірність того, що дана спостережувана послідовність побудована саме для даної моделі.
Задача 2
Дано: спостережувана послідовність і модель λ = ( A , B ,π) . Необхідно підібрати послідовність станів системи , що найкраще відповідає спостережуваній послідовності, тобто «пояснює» спостережувану послідовність.
Задача 3
Підібрати параметри моделі λ = ( A , B ,π) таким чином, щоб максимізувати P ( O | λ) .
Задача 1 - це задача оцінки моделі, що полягає в обчисленні ймовірності того, що модель відповідає заданій спостережуваній послідовності. До суті цієї задачі можна підійти й з іншої сторони: наскільки обрана ПММ відповідає заданій спостережуваній послідовності. Такий підхід має більшу практичну цінність. Наприклад, якщо в нас коштує питання вибору найкращої моделі з набору вже існуючих, то рішення першої задачі дає нам відповідь на це питання.
Задача 2 - це задача, у якій ми намагаємося зрозуміти, що ж відбувається в прихованій частині моделі, тобто знайти «правильну» послідовність, що проходить модель. Зовсім ясно, що абсолютно точно не можна визначити цю послідовність. Тут можна говорити лише про припущення з відповідним ступенем вірогідності. Проте для наближеного рішення цієї проблеми ми звичайно будемо користуватися деякими оптимальними показниками, критеріями. Далі ми побачимо, що, на жаль, не існує єдиного критерію оцінки для визначення послідовності станів. При рішенні другої задачі необхідно кожний раз ухвалювати рішення щодо того, які показники використати. Дані, отримані при рішенні цієї задачі використаються для вивчення поводження побудованої моделі, знаходження оптимальної послідовності її станів, для статистики й т.п. [6]
Рішення задачі 3 складається в оптимізації моделі таким чином, щоб вона якнайкраще описувала реальну спостережувану послідовність. Спостережувана послідовність, по якій оптимізується ПММ, прийнято називати навчальною послідовністю, оскільки за допомогою її ми «навчаємо» модель. Задача навчання ПММ - це найважливіша задача для більшості проектованих ПММ, оскільки вона полягає в оптимізації параметрів ПММ на основі навчальної спостережуваної послідовності, тобто створюється модель, що щонайкраще описує реальні процеси.
Для кращого розуміння розглянемо все вищесказане на прикладі системи, призначеної для розпізнавання мови. Для кожного слова зі словника W ми спроектуємо ПММ із N станами. Кожне слово зокрема ми представимо як послідовність спектральних векторів. Навчання ми будемо вважати завершеним, коли модель із високою точністю буде відтворювати ту саму послідовність спектральних векторів, що використалася для навчання моделі. У такий спосіб кожна окрема ПММ буде навчатися відтворювати яке-небудь одне слово, але навчати цю модель треба на декількох варіантах проголошення цього слова; тобто наприклад три чоловіки (кожний по-своєму) проговорюють слово «собака», а потім кожне сказане слово конвертується в упорядкований за часом набір спектральних векторів, і модель навчається на основі цих трьох наборів. Для кожного окремого слова проектуються відповідні моделі. Спершу вирішується 3-я задача ПММ: кожна модель настроюється на «проголошення» певного слова зі словника W , відповідно до заданої точності. Для того щоб інтерпретувати кожний стан спроектованих моделей ми вирішуємо 2-ую задачу, а потім виділяємо ті властивості спектральних векторів, які мають найбільша вага для певного стану. Це момент тонкого настроювання моделі. А вже після того, як набір моделей буде спроектований, оптимізований і навчений, варто оцінити модель на предмет її здатності розпізнавати слова в реальному житті. Тут ми вже вирішуємо 1-ую задачу ПММ. Нам дається тестове слово, представлене, зрозуміло, у вигляді спостережуваної послідовності спектральних векторів. Далі ми обчислюємо функцію відповідності цього тестового слова для кожної моделі. Модель, для якої ця функція буде мати найбільше значення, буде вважатися моделлю названого слова.
6. Місце і спосіб застосування отриманих результатів
Для розпізнавання мовлення із великих словників для ізольовано (або дискретно) вимовлених слів на початку 90-х років було розроблено декілька систем з достатньо гарними показниками. Потім увага дослідників перенеслася на розпізнавання злитого мовлення, де використовувалися статистичні залежності в порядку слів, що дозволяло передбачити поточне розпізнаване слово на основі кількох попередніх слів. Розроблені статистичні методи прогнозу дозволили значно зменшити кількість альтернатив при розпізнаванні, що у свою чергу дозволило розробляти системи розпізнавання з сумарним обсягом у десятки тисяч слів, хоча на кожному кроці розпізнавання розглядалося декілька сотень альтернатив.
Проте, існує необхідність побудови систем розпізнавання мови з великою кількістю альтернатив і за умови, що немає яких-небудь обмежень на порядок розпізнаваних слів.
Наприклад, при керуванні комп'ютера голосом неможливо передбачити наступне слово на основі декількох попередніх, оскільки це визначається логікою