Java: Русские буквы и не только…
Введение
Некоторые проблемы настолько сложны, что нужно быть очень умным и очень хорошо информированным, чтобы не быть уверенным в их решении.
Лоренс Дж. Питер
Peter's Almanac
Кодировки
Когда я только начинал программировать на языке C, первой моей программой (не считая HelloWorld) была программа перекодировки текстовых файлов из основной кодировки ГОСТ-а (помните такую? :-) в альтернативную. Было это в далёком 1991-ом году. С тех пор многое изменилось, но за прошедшие 10 лет подобные программки свою актуальность, к сожалению, не потеряли. Слишком много уже накоплено данных в разнообразных кодировках и слишком много используется программ, которые умеют работать только с одной. Для русского языка существует не менее десятка различных кодировок, что делает проблему ещё более запутанной.
Откуда же взялись все эти кодировки и для чего они нужны? Компьютеры по своей природе могут работать только с числами. Для того чтобы хранить буквы в памяти компьютера надо поставить в соответствие каждой букве некое число (примерно такой же принцип использовался и до появления компьютеров - вспомните про ту же азбуку Морзе). Причём число желательно поменьше - чем меньше двоичных разрядов будет задействовано, тем эффективнее можно будет использовать память. Вот это соответствие набора символов и чисел собственно и есть кодировка. Желание любой ценой сэкономить память, а так же разобщённость разных групп компьютерщиков и привела к нынешнему положению дел. Самым распространённым способом кодирования сейчас является использование для одного символа одного байта (8 бит), что определяет общее кол-во символов в 256. Набор первых 128 символов стандартизован (набор ASCII) и является одинаковыми во всех распространённых кодировках (те кодировки, где это не так уже практически вышли из употребления). Англицкие буковки и символы пунктуации находятся в этом диапазоне, что и определяет их поразительную живучесть в компьютерных системах :-). Другие языки находятся не в столь счастливом положении - им всем приходится ютиться в оставшихся 128 числах.
Unicode
В конце 80-х многие осознали необходимость создания единого стандарта на кодирование символов, что и привело к появлению Unicode. Unicode - это попытка раз и навсегда зафиксировать конкретное число за конкретным символом. Понятно, что в 256 символов тут не уложишься при всём желании. Довольно долгое время казалось, что уж 2-х то байт (65536 символов) должно хватить. Ан нет - последняя версия стандарта Unicode (3.1) определяет уже 94140 символов. Для такого кол-ва символов, наверное, уже придётся использовать 4 байта (4294967296 символов). Может быть и хватит на некоторое время... :-)
В набор символов Unicode входят всевозможные буквы со всякими чёрточками и припендюльками, греческие, математические, иероглифы, символы псевдографики и пр. и пр. В том числе и так любимые нами символы кириллицы (диапазон значений 0x0400-0x04ff). Так что с этой стороны никакой дискриминации нет.
Если Вам интересны конкретные кода символов, для их просмотра удобно использовать программу "Таблица символов" из WinNT. Вот, например, диапазон кириллицы:
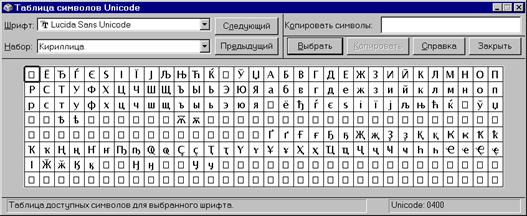
Если у Вас другая OS или Вас интересует официальное толкование, то полную раскладку символов (charts) можно найти на официальном сайте Unicode (unicode/charts/web.html).
Типы char и byte
В Java для символов выделен отдельный тип данных char размером в 2 байта. Это часто порождает путаницу в умах начинающих (особенно если они раньше программировали на других языках, например на C/C++). Дело в том, что в большинстве других языков для обработки символов используются типы данных размером в 1 байт. Например, в C/C++ тип char в большинстве случаев используется как для обработки символов, так и для обработки байтов - там нет разделения. В Java для байтов имеется свой тип - тип byte. Таким образом C-ишному char соответствует Java-вский byte, а Java-вскому char из мира C ближе всего тип wchar_t. Надо чётко разделять понятия символов и байтов - иначе непонимание и проблемы гарантированны.
Java практически с самого своего рождения использует для кодирования символов стандарт Unicode. Библиотечные функции Java ожидают увидеть в переменных типа char символы, представленные кодами Unicode. В принципе, Вы, конечно, можете запихнуть туда что угодно - цифры есть цифры, процессор всё стерпит, но при любой обработке библиотечные функции будут действовать исходя из предположения что им передали кодировку Unicode. Так что можно спокойно полагать, что у типа char кодировка зафиксирована. Но это внутри JVM. Когда данные читаются извне или передаются наружу, то они могут быть представлены только одним типом - типом byte. Все прочие типы конструируются из байтов в зависимости от используемого формата данных. Вот тут то на сцену и выходят кодировки - в Java это просто формат данных для передачи символов, который используется для формирования данных типа char. Для каждой кодовой страницы в библиотеке имеется по 2 класса перекодировки (ByteToChar и CharToByte). Классы эти лежат в пакете sun.io. Если, при перекодировке из char в byte не было найдено соответствующего символа, он заменяется на символ ?.
Кстати, эти файлы кодовых страниц в некоторых ранних версиях JDK 1.1 содержат ошибки, вызывающие ошибки перекодировок, а то и вообще исключения при выполнении. Например, это касается кодировки KOI8_R. Лучшее, что можно при этом сделать - сменить версию на более позднюю. Судя по Sun-овскому описанию, большинство этих проблем было решено в версии JDK 1.1.6.
До появления версии JDK 1.4 набор доступных кодировок определялся только производителем JDK. Начиная с 1.4 появилось новое API (пакет java.nio.charset), при помощи которого Вы уже можете создать свою собственную кодировку (например поддержать редко используемую, но жутко необходимую именно Вам).
Класс String
В большинстве случаев для представления строк в Java используется объект типа java.lang.String. Это обычный класс, который внутри себя хранит массив символов (char[]), и который содержит много полезных методов для манипуляции символами. Самые интересные - это конструкторы, имеющие первым параметром массив байтов (byte[]) и методы getBytes(). При помощи этих методов Вы можете выполнять преобразования из массива байтов в строки и обратно. Для того, чтобы указать какую кодировку при этом использовать у этих методов есть строковый параметр, который задаёт её имя. Вот, например, как можно выполнить перекодировку байтов из КОИ-8 в Windows-1251:
// Данные в кодировке КОИ-8
byte[] koi8Data = ...;
// Преобразуем из КОИ-8 в Unicode
String string = new String(koi8Data,"KOI8_R");
// Преобразуем из Unicode в Windows-1251
byte[] winData = string.getBytes("Cp1251");
Список 8-ми битовых кодировок, доступных в современных JDK и поддерживающих русские буквы Вы можете найти ниже, в разделе "8-ми битовые кодировки русских букв".
Так как кодировка - это формат данных для символов, кроме знакомых 8-ми битовых кодировок в Java также на равных присутствуют и многобайтовые кодировки. К таким относятся UTF-8, UTF-16, Unicode и пр. Например вот так можно получить байты в формате UnicodeLittleUnmarked (16-ти битовое кодирование Unicode, младший байт первый, без признака порядка байтов):
// Строка Unicode
String string = "...";
// Преобразуем из Unicode в UnicodeLittleUnmarked
byte[] data = string.getBytes("UnicodeLittleUnmarked");
При подобных преобразованиях легко ошибиться - если кодировка байтовых данных не соответствуют указанному параметру при преобразовании из byte в char, то перекодирование будет выполнено неправильно. Иногда после этого можно вытащить правильные символы, но чаще всего часть данных будет безвозвратно потеряна.
В реальной программе явно указывать кодовую страницу не всегда удобно (хотя более надёжно). Для этого была введена кодировка по умолчанию. По умолчанию она зависит от системы и её настроек (для русских виндов принята кодировка Cp1251), и в старых JDK её можно изменить установкой системного свойства file.encoding. В JDK 1.3 изменение этой настройки иногда срабатывает, иногда - нет. Вызвано это следующим: первоначально file.encoding ставится по региональным настройкам компьютера. Ссылка на кодировку по умолчанию запоминается в нутрях при первом преобразовании. При этом используется file.encoding, но это преобразование происходит ещё до использования аргументов запуска JVM (собсно, при их разборе). Вообще-то, как утверждают в Sun, это свойство отражает системную кодировку, и она не должна изменяться в командной строке (см., например, комментарии к BugID 4163515) Тем не менее в JDK 1.4 Beta 2 смена этой настройки опять начала оказывать эффект. Что это, сознательное изменение или побочный эффект, который может опять исчезнуть - Sun-овцы ясного ответа пока не дали.
Эта кодировка используется тогда, когда явно не указанно название страницы. Об этом надо всегда помнить - Java не будет пытаться предсказать кодировку байтов, которые Вы передаёте для создания строки String (так же она не сможет прочитать Ваши мысли по этому поводу :-). Она просто использует текущую кодировку по умолчанию. Т.к. эта настройка одна на все преобразования, иногда можно наткнуться на неприятности.
Для преобразования из байтов в символы и обратно следует пользоваться только этими методами. Простое приведение типа использовать в большинстве случаев нельзя - кодировка символов при этом не будет учитываться. Например, одной из самых распространённых ошибок является чтение данных побайтно при помощи метода read() из InputStream, а затем приведение полученного значения к типу char:
InputStream is = ..;
int b;
StringBuffer sb = new StringBuffer();
while( (b=is.read())!=-1 )
{
sb.append( (char)b ); // <- так делать нельзя
}
String s = sb.toString();
Обратите внимание на приведение типа - "(char)b". Значения байтов вместо перекодирования просто скопируются в char (диапазон значений 0-0xFF, а не тот, где находится кириллица). Такому копированию соответствует кодировка ISO-8859-1 (которая один в один соответствует первым 256 значениям Unicode), а значит, можно считать, что этот код просто использует её (вместо той, в которой реально закодированы символы в оригинальных данных). Если Вы попытаетесь отобразить полученное значение - на экране будут или вопросики или кракозяблы. Например, при чтении строки "АБВ" в виндовой кодировке может запросто отобразиться что-то вроде такого: "ÀÁÂ". Подобного рода код часто пишут программисты на западе - с английскими буквами работает, и ладно. Исправить такой код легко - надо просто заменить StringBuffer на ByteArrayOutputStream:
InputStream is = ..;
int b;
ByteArrayOutputStream baos = new ByteArrayOutputStream();
while( (b=is.read())!=-1 )
{
baos.write( b );
}
// Перекодирование байтов в строку с использованием кодировки по умолчанию
String s = baos.toString();
// Если нужна конкретная кодировка - просто укажите её при вызове toString():
//
// s = baos.toString("Cp1251");
Более подробно о распространённых ошибках смотрите раздел Типичные ошибки.
8-ми битовые кодировки русских букв
Вот основные 8-ми битовые кодировки русских букв, получившие распространение:
| Кодировка | Ареал распространения | Основное название в Java |
| IBM-866 | MS-DOS, Windows (OEM-кодировка), OS/2 | Cp866 |
| Windows-1251 | Windows (Ansi-кодировка) | Cp1251 |
| КОИ-8 | Unix, большинство русскоязычных писем в Internet | KOI8_R |
| ISO-8859-5 | Unix | ISO8859_5 |
| Macintosh Cyrillic | Mac | MacCyrillic |
Помимо основного названия можно использовать синонимы. Набор их может отличаться в разных версиях JDK. Вот список от JDK 1.3.1:
Cp1251:
Windows-1251
Cp866:
IBM866
IBM-866
866
CP866
CSIBM866
KOI8_R:
KOI8-R
KOI8
CSKOI8R
ISO8859_5:
ISO8859-5
ISO-8859-5
ISO_8859-5
ISO_8859-5:1988
ISO-IR-144
8859_5
Cyrillic
CSISOLatinCyrillic
IBM915
IBM-915
Cp915
915
Причём синонимы, в отличии от основного имени нечувствительны к регистру символов - такова особенность реализации.
Стоит отметить, что эти кодировки на некоторых JVM могут отсутствовать. Например, с сайта Sun можно скачать две разные версии JRE - US и International. В US версии присутствует только минимум - ISO-8859-1, ASCII, Cp1252, UTF8, UTF16 и несколько вариаций двухбайтового Unicode. Всё прочее есть только в International варианте. Иногда из-за этого можно нарваться на грабли с запуском программы, даже если ей не нужны русские буквы. Типичная ошибка, возникающая при этом:
Error occurred during initialization of VM
java/lang/ClassNotFoundException: sun/io/ByteToCharCp1251
Возникает она, как не трудно догадаться, из-за того, что JVM, исходя из русских региональных настроек пытается установить кодировку по умолчанию в Cp1251, но, т.к. класс поддержки таковой отсутствует в US версии, закономерно обламывается.
Файлы и потоки данных
Так же как и байты концептуально отделены от символов, в Java различаются потоки байтов и потоки символов. Работу с байтами представляют классы, которые прямо или косвенно наследуют классы InputStream или OutputStream (плюс класс-уникум RandomAccessFile). Работу с символами представляет сладкая парочка классов Reader/Writer (и их наследники, разумеется).
Для чтения/записи не преобразованных байтов используются потоки байтов. Если известно, что байты представляют собой только символы в некоторой кодировке, можно использовать специальные классы-преобразователи InputStreamReader и OutputStreamWriter, чтобы получить поток символов и работать непосредственно с ним. Обычно это удобно в случае обычных текстовых файлов или при работе с многими сетевыми протоколами Internet. Кодировка символов при этом указывается в конструкторе класса-преобразователя. Пример:
// Строка Unicode
String string = "...";
// Записываем строку в текстовый файл в кодировке Cp866
PrintWriter pw = new PrintWriter // класс с методами записи строк
(new OutputStreamWriter // класс-преобразователь
(new FileOutputStream // класс записи байтов в файл
("file.txt"), "Cp866");
pw.println(string); // записываем строку в файл
pw.close();
Если в потоке могут присутствовать данные в разных кодировках или же символы перемешаны с прочими двоичными данными, то лучше читать и записывать массивы байтов (byte[]), а для перекодировки использовать уже упомянутые методы класса String. Пример:
// Строка Unicode
String string = "...";
// Записываем строку в текстовый файл в двух кодировках (Cp866 и Cp1251)
OutputStream os = new FileOutputStream("file.txt"); // класс записи байтов в файл
// Записываем строку в кодировке Cp866
os.write( string.getBytes("Cp866") );
// Записываем строку в кодировке Cp1251
os.write( string.getBytes("Cp1251") );
os.close();
Консоль в Java традиционно представлена потоками, но, к сожалению, не символов, а байтов. Дело в том, что потоки символов появились только в JDK 1.1 (вместе со всем механизмом кодировок), а доступ к консольному вводу/выводу проектировался ещё в JDK 1.0, что и привело к появлению уродца в виде класса PrintStream. Этот класс используется в переменных System.out и System.err, которые собственно и дают доступ к выводу на консоль. По всем признакам это поток байтов, но с кучей методов записи строк. Когда Вы записываете в него строку, внутри происходит конвертация в байты с использованием кодировки по умолчанию, что в случае виндов, как правило, неприемлемо - кодировка по умолчанию будет Cp1251 (Ansi), а для консольного окна обычно нужно использовать Cp866 (OEM). Эта ошибка была зарегистрированна ещё в 97-ом году (4038677) но Sun-овцы исправлять её вроде не торопятся. Так как метода установки кодировки в PrintStream нет, для решения этой проблемы можно подменить стандартный класс на собственный при помощи методов System.setOut() и System.setErr(). Вот, например, обычное начало в моих программах:
...
public static void main(String[] args)
{
// Установка вывода консольных сообщений в нужной кодировке
try
{
String consoleEnc = System.getProperty("console.encoding","Cp866");
System.setOut(new CodepagePrintStream(System.out,consoleEnc) );
System.setErr(new CodepagePrintStream(System.err,consoleEnc) );
}
catch(UnsupportedEncodingException e)
{
System.out.println("Unable to setup console codepage: " + e);
}
...
Исходники класса CodepagePrintStream Вы можете найти на данном сайте: CodepagePrintStream.java.
Если Вы сами конструируете формат данных, я рекомендую Вам использовать одну из многобайтовых кодировок. Удобнее всего обычно формат UTF8 - первые 128 значений (ASCII) в нём кодируются одним байтом,