Порівняльний аналіз ефективності та складності швидких алгоритмів сортування масивів
3) у випадку виконання умови a[I]> a[J] проводиться обмін місцями кючів a[I] та a[J] і здійснюється крок вліво J:=J-1; при цьому ведучий елемент знову повертається в позицію I.
Цей процес із почерговим зменшенням J та збільшенням I повторюється з обох кінців послідовності до "середини"до тих пір, поки не досягнеться I=J.
Тепер мають місце два факти. По-перше, ключ, що був першим у вихідній послідовності, в результаті такого впорядкування опиняється на "своєму" місці. По-друге, всі елементи зліва будуть меншими за нього, а всі ключі справа - більшими.
Ту ж саму процедуру можна використати для впорядкування лівої і правої підпослідовностей і т. д. до повного сортування всьго масиву. Таким чином розглянутий алгоритм має чітко виражений рекурсивний характер. Виходячи з цього, значення індексів крайніх елементів меншої з двох невідсортованих підпослідовностей варто помістити в стекову структуру даних, і приступити до впорядкування більшої підпослідовності.
Оскільки короткі послідовності скоріше сортуються при допомозі прямих методів, то алгоритм Quick Sort матиме вхідний параметр - деяке число S, що визначає нижню межу його використання. Провівши нескладний математичний аналіз нерівності, яка пов’язує ефективності алгоритму Quick Sort та прямих алгоритмів сортування
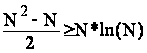 ,
можна встановити
значення числа
S, яке буде нижньою
межею використання
швидкого сортування.
Остання нерівність
дає результат
 .
Однак, якщо крім основних операцій порівняння ключів ще враховувати порівняння індексів та перестановки елементів, то це значення можна збільшити в 2-3 рази.
В якості прикладу наводиться програмна реалізація цього алгоритму у вигляд процедури Quick_Sort. В ній використовується два масиви left і right, де зберігатимуться індексні номери відповідно лівої і правої границь підпослідовностей, які ще будуть впорядковуватися на наступних етапах.
Procedure Quick_Sort;
Const S=20;
Var
k, L, R, i, j : integer;
x : basetype;
left, right : array [1..N] of integer;
Begin
k:=1; left[k]:=1; right[k]:=N;
while k>0 do
begin
L:=left[k]; R:=right[k]; k:=k-1;
while R-L>S do
begin
i:=L; j:=R; x:=a[i];
while j>i do
begin
while x<a[j] do j:=j-1;
if j>i then begin
a[i]:=a[j]; a[j]:=x; i:=i+1
end;
while a[i]<x do i:=i+1;
if j>i then begin
a[j]:=a[i]; a[i]:=x; j:=j-1
end
end;
k:=k+1;
if R-i<=i-L then
begin
left[k]:=i+1; right[k]:=R; R:=i-1
end
else
begin
left[k]:=L; right[k]:=i-1; L:=i+1
end
end;
for i:=L+1 to R do
begin
x:=a[i]; j:=i-1;
while (x<a[j]) and (j>=L) do
begin
a[j+1]:=a[j]; j:=j-1
end;
a[j+1]:=x
end
end
End;
Аналіз алгоритму Quick Sort. Щоб оцінити ефективність алгоритму, позначимо через Q(N) середню кількість кроків, необхідних для впорядкування N елементів. Припустимо також, S=1, тобто не використовується сортування прямими методами на коротких послідовностях.
При першому
проходженні
Quick Sort порівнює
всі елементи
з ведучим і
виконується
не більше ніж
за C*N кроків,
де C - деяка
константа.
Потім потрібно
відсортувати
дві підпослідовності
довжинами I-1
та N-I. Тому середня
кількість
кроків, потрібних
для впорядкування
N елементів,
залежить від
середньої
кількості
кроків, потрібних
для впорядкування
I-1 та N-I елементів
відповідно.
Оскільки всі
можливі значення
 є рівноймовірними,
то спрведлива
наступна оцінка
:
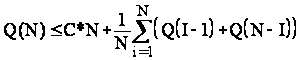 .
Врахувавши, що
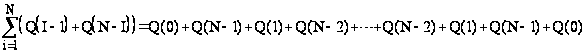 ,
отримаємо
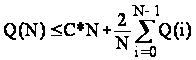 .(1)
Покажемо за
індукцією по
N, що
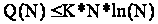 для
 ,
де K=2C+2B, B=Q(0)=Q(1). Останнє
співвіднощення
означає, що
Quick Sort вимагає
постійної
однакової
кількості
кроків для
впорядкування
0 або 1 елемента.
1) N=2 :
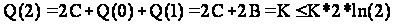 ;
2) припустимо,
що
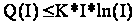 для I=2, 3, ..., N-1 ;
3) перевіримо справедливість для I=N. Співвідношення (1) з врахуванням попереднього припущення можна переписати у вигляді
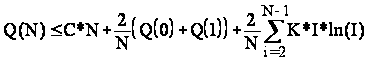 або
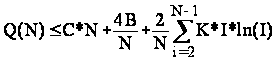 .(2)
Оскільки функція I*ln(I) є опуклою вниз, то для цілих значень аргументу справедлива оцінка
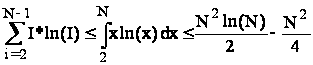
Врахувавши останню нерівність, із співвідношення (2) одержимо
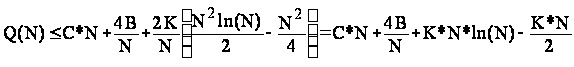 .
Оскільки
 ,
то
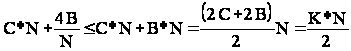 .
Остаточно отримаємо
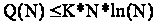 .(3)
Таким чином ефективність алгоритму Quick Sort є величина порядку O(N*ln(N)).
Всі наведені викладки справедливі для аналізу по операціях порівняння. Кількість же перестановок залежить від початкового розміщення елементів у послідовності. Характерно, що для цього методу у випадку зворотньо впорядкованого масиву об’єм переміщень ключів не буде максимальним. Адже на кожному етапі ведучий елемент буде найбільшим і опиниться на своєму місці після першого ж порівняння і перестановки, тобто M=N-1. Максимальна кількість переприсвоєнь ключів співпадатиме з кількістю порівнянь, мінімальна - рівна нулю.
Алгоритм Quick Sort, як і розглянуті прямі методи, описує процес стійкого сортування.
2.3 Сортування вибором при допомозі дерева – алгоритм Тree Sort
Алгоритм сортування деревом ТreeSort власне кажучи є поліпшенням алгоритму сортування вибором. Процедура вибору найменшого елемента удосконалена як процедура побудови так званого сортуючого дерева. Сортуюче дерево - це структура даних, у якій представлений процес пошуку найменшого елемента методом попарного порівняння елементів, що стоять поруч. Алгоритм сортує масив у два етапи.
I етап : побудова сортуючого дерева;
II етап : просівання елементів по сортуючому дереву.
Розглянемо приклад: Нехай масив A складається з 8 елементів. Другий рядок складається з мінімумів елементів першого рядка, які стоять поруч. Кожний наступний рядок складений з мінімумів елементів, що стоять поруч, попереднього рядка.
Ця структура даних називається сортуючим деревом. У корені сортуючого дерева розташований найменший елемент. Крім того, у дереві побудовані шляхи елементів масиву від листів до відповідного величині елемента вузла -розгалуження.
Коли дерево побудоване, починається етап просівання елементів масиву по дереву. Мінімальний елемент пересилається у вихідний масив B і усі входження цього елемента в дереві заміняються на спеціальний символ M. Потім здійснюється просівання елемента уздовж шляху, відзначеного символом M, починаючи з листка, сусіднього з M і до кореня. Крок просівання - це вибір найменшого з двох елементів, що зустрілися на шляху до кореня дерева і його пересилання у вузол, відзначений M.
a6 = min(M, a6)
a6 = min(a6, a8)
a3 = min(a3, a6)
b2 := a3
Просівання елементів відбувається доти, поки весь вихідний масив не буде заповнений символами M, тобто n раз:
For і := 1 to n do begin
Відзначити шлях від кореня до листка символом M;
Просіяти елемент уздовж відзначеного шляху;
B[I] := корінь дерева
end;
Обґрунтування правильності алгоритму очевидно, оскільки кожне чергове просівання викидає в масив У найменший з елементів масиву А, що залишилися.
Сортуюче дерево можна реалізувати, використовуючи або двовимірний масив, або одномірний масиві ST[1..N], де N = 2n-1.
Аналіз алгоритму Tree Sort.
Оцінимо складність алгоритму в термінах M(n), C(n). Насамперед відзначимо, що алгоритм Tree Sort працює однаково на усіх входах, так що його складність у гіршому випадку збігається зі складністю в середньому.
Припустимо, що n - ступінь 2 (n = 2l). Тоді сортуюче дерево має l + 1 рівень (глибину l). Побудова рівня I вимагає n / 2I порівнянь і пересилань. Таким чином, I-ий етап має складність:
C1(n) = n/2+n/4+ ... + 2+1 = n-1, M1(n) = C1(n) = n - 1
Для того, щоб оцінити складність II-го етапу С2(n) і M2(n) помітимо, що кожен шлях просівання має довжину l, тому кількість порівнянь і пересилань при просіванні одного елемента пропорційно l. Таким чином,
M2(n) = O(l n),
C2(n) = O(l n).
Оскільки l = log2n, M2(n)=O(n log2 n)), C2(n)=O(n log2 n), Але З(n) = C1(n) + C2(n), M(n) = M1(n) + M2(n). Тому що C1(n) < C2(n), M1(n) < M2(n),остаточно одержуємо оцінки складності алгоритму Tree Sort за часом:
M(n) = O(n log2 n), C(n) = O(n log2 n),
У загальному випадку, коли n не є ступенем 2, сортуюче дерево будується трохи інакше. "Зайвий" елемент (елемент, для якого немає пари) переноситься на наступний рівень. Легко бачити, що при цьому глибина сортуючого дерева дорівнює [log2 n] + 1. Удосконалення алгоритму II етапу очевидно. Оцінки при цьому змінюють лише мультиплікативні множники. Алгоритм Tree Sort має істотний недолік: для нього потрібно додаткова пам'ять розміру 2n - 1.
2.4Сортування вибором при допомозі дерева – алгоритм Heap Sort
Прямий вибір - повторюваний пошук найменшого елемента серед N елементів, N-1 елементів, N-2 і т.д. Кількість порівнянь при цьому (N2-N)/2. Для підвищення ефективності необхідно залишати після кожного етапу побільше інформації окрім ідентифікації найменшого ключа.
Після N/2 порівнянь можна знайти в кожній парі елементів найменший, після N/4 порівнянь - менший із пари вже вибраних на попередньому кроці і т.д. Виконавши загалом N/2+N/4+...+2+1=N-1 порівнянь, можна побудувати дерево вибору та ідентифікувати його корінь як шуканий найменший елемент. Наприклад
крок I / / / /
44 12 06
крок II / /
12 06
крок III /
06
На наступному етапі сортування проводиться рух вздовж віток, які відмічені мінімальними елементом, і вилучення його з дерева шляхом заміни на пустий елемент.
44[]
/ / / /
44 12 18 []
/ /
12 []
/
[]
Далі здійснюється заповнення "дірок" у дереві. На першому рівні залишається "дірка" від вилученого елемента, а на наступних знову вибирається менший із двох сусідніх попереднього рівня. "Дірка" при порівнянні вважається як завгодно великим значенням.
44[]
/ / / /
44 12 18 67
/ /
12 18
/
12
Елемент, що опинився в корені, - знову найменший. Після N таких кроків дерево стане пустим, в ньому будуть лише одні "дірки" (сортування закінчене). На кожному з N етапів виконується log(N) порівнянь. Тому на весь процес впорядкування потрібно порядку N*log(N) операцій плюс N-1 операцій для побудови дерева. Це значно краще ніж N2 для прямих методів і навіть краще ніж N1,2 для алгоритму Шелла. Однак при цьому виникає проблема збереження додаткової інформації. Тому кожен окремий етап в алгоритмі ускладнюється.
Корисно було б, зокрема, позбутися від "дирок", якими вкінці буде заповнене все дерево, і які породжують багато непотрібних порівнянь. Крім того, виникає потреба такої організації даних за принципом дерева, яка б вимагала N одиниць пам’яті, а не 2N-1. Цього вдалося добитися в алгоритмі Heap Sort, який розробив Д. Уілльямс. Він використав спеціальну деревовидну структуру - піраміду.
Піраміда - це означене, тобто задане елементами кореневе бінарне дерево, яке визначається як послідовність ключів a L , a L+1 , ..., a R , для якої справедливі нерівності
 та
 для
 .(1)
Таким чином бінарне дерево сортувань виду
a1
/
a2=42a3=06
/ /
a4=55a5=94a6=18a7=12
являє собою піраміду, а елемент a1 буде найменшим в розглядуваній множині : a1=min(a 1 , a 2 , ..., a N).
Припустимо, що є деяка піраміда із заданими елементами a L+1 , ..., a R для певних значень L та R, і потрібно ввести новий елемент x, утворюючи таким чином розширену піраміду a L , a L+1 , ..., a R . В якості вихідної візьмемо піраміду a 1 , a 2 , ..., a 7 із попереднього прикладу і добавимо до неї зліва елемент a 1=44. Нова піраміда отримується так : спочатку x ставиться зверху деревовидної структури, а потім він поступово опускається вниз кожен раз в напрямку меншого з двох прилеглих до нього елементів, а сам цей менший елемент переміщується вгору. Процес просіювання продовжується доти, поки в жодній з прилеглих вершин не буде елемента меншого за нововведеного. В розглядуваному прикладі ключ 44 спочатку поміняється місцями з ключем 06, а потім з 12, і в результаті отримується таке дерево
06
/
42
/ /
94 18
Характерно, що такий метод просіювання залишає незмінними умови (1), які визначають піраміду.
Р. Флойд запропонував певний "лаконічний" алгоритм побудови піраміди "на тому ж місці". Вважається, що деяка частина елементів масиву a m , a 2 , ..., a N (m=Ndiv2) вже утворює піраміду - нижній шар відповідного бінарного дерева, для них ніякої впорядкованості не вимагається. Тепер піраміда розширюється вліво; кожен раз добавляється і просіюваннями ставитться у відповідну позицію новий елемент. Ці дії реалізуються проседурою Sift :
Procedure Sift(L, R : integer);
Var
i, j : integer; x : basetype;
Begin
i:=L; j:=2*L; x:=a[L];
if (j<R) and (a[j+1]<a[j]) then j:=j+1;
while (j<=R) and (a[j]<x) do
begin
a[i]:=a[j]; a[j]:=x; i:=j; j:=2*j;
if (j<R) and (a[j+1]<a[j]) then j:=j+1
end
End;
Таким чином, процес формування піраміди із N елементів a 1 , ..., a N "на тому ж місці" є повторюваним виконанням процедури Sift при зміні параметра L=Ndiv2, ..., 1 :
L:=N div 2 +1;
while L>1 do
begin
L:=L-1;
Sift(L, N)
end;
Для ілюстації алгоритму розглянемо попередній варіант масиву :
44 |
44 |
44 |
44 | 42
06
Тут жирним шрифтом виділені добавлювані до піраміди елементи; підкреслені - елементи, з якими проводився обмін.
Для того, щоб отримати не тільки часткове, а і повне впорядкування серед елементів послідовності, потрібно виконати N зсувних етапів. Після кожного проходу на вершину дерева виштовхуватиметься черговий найменший ключ. Знову виникає питання : де зберігати "спливаючі" верхні елементи і чи можна проводити перестановки "на тому ж місці"? Це легко реалізувати, якщо кожен раз брати останню компоненту піраміди - це буде просіюваний ключ x, ховати верхній елемент з попереднього етапу в звільнене позицію, а x зсувати на відповідне місце. Зрозуміло, що після кожного етапу розглядувана піраміда буде скорочуватися на один елемент справа. Таким чином, впорядкування масиву буде здійснено за N-1 прохід :
06 42 12 55 94 18 44 67обмін 67 і 06
67 42 12 55 94 18 44 | 06просіювання 67
12 42 18 55 94 67 44 | 06обмін 44 і 12
44 42 18 55 94 67 | 12 06просіювання 44
18 42 44 55 94 67 | 12 06обмін 67 і 18
67 42 44 55 94 | 18 12 06просіювання 67
42 55 44 67 94 | 18 12 06обмін 94 і 42
94 55 44 67 | 42 18 12 06просіювання 94
44 55 94 67 | 42 18 12 06обмін 67 і 44
67 55 94 | 44 42 18 12 06просіювання 67
55 67 94 | 44 42 18 12 06обмін 94 і 55
94 67 | 55 44 42 18 12 06просіювання 94
67 94 | 55 44 42 18 12 06обмін 94 і 67
94 | 67 55 44 42 18 12 06просіювання 94
94 | 67 55 44 42 18 12 06
Тут жирним шрифтом виділені просіювані по піраміді елементи; підкреслені - елементи, між якими проводився обмін.
Процес сортування описується за допомогою процедури Sift таким чином:
R:=N;
while R>1 do
begin
x:=a[1]; a[1]:=a[R]; a[R]:=x;
R:=R-1;
Sift(1, R)
end;
Як видно з прикладу, отриманий порядок ключів фактично є зворотнім. Це легко виправити, помінявши напрямок відношення порівняння в процедурі Sift на протилежний. Остаточно процедура сортування масиву методом Heap Sort матиме вигляд :
Procedure Heap_Sort;
Var
L, R : integer; x : basetype;
Procedure Sift(L, R : integer);
Var
i, j : integer; x : basetype;
Begin
i:=L; j:=2*L; x:=a[L];
if (j<R) and (a[j]<a[j+1]) then j:=j+1;
while (j<=R) and (x<a[j]) do
begin
a[i]:=a[j]; a[j]:=x; i:=j; j:=2*j;
if (j<R) and (a[j]<a[j+1]) then j:=j+1
end
End;
Begin
L:=N div 2 +1; R:=N;
while L>1 do
begin L:=L-1; Sift(L, N) end;
while R>1 do
begin
x:=a[1]; a[1]:=a[R]; a[R]:=x;
R:=R-1;
Sift(1, R)
end
End;
Аналіз алгоритму Heap Sort. Як вже раніше відмічалося, складність алгоритму по операціях порівняння є величиною порядку O(N*log(N)+N). Кількість переміщень елементів суттєво залежить від стартового розміщення ключів в послідовності.
Однак при початково-впорядкованому масиві не слід чекати максимальної ефективності. Адже об’єм перестановок в цьому випадку є досить великим під час просіювання "важких" елементів після побудови піраміди. Фактично на кожному етапі такого просіювання виконується log(K) перестановок плюс ще N-1 обмін перед просіюванням, де K - кількість елементів в піраміді, в якій проводиться просіювання. Таким чином, в цьому випадку
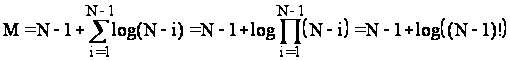 .
Тому можна вважати, що розглядуваний метод як і по порівняннях так і по перестановках має ефективність порядку O(N*log(N)+N).
2.5 Порівняльна характеристика швидкодії деяких швидких алгоритмів сортування
Щоб порівняти швидкодію певних алгоритмів сортування, зокрема Quick_Sort, Heap_Sort, Shell_Sort, ми створили одновимірний масив із елементів n=50000, типу integer. При цьому розглядалися різні варіанти масиву А(n). А саме, коли вихідний масив А(n) вже є відсортований за зростанням (за спаданням), коли всі члени масиву А(n) рівні, а також, коли елементи масиву генеруються випадковим чином. За отриманими результатами ми подували таблицю, яка дає змогу проаналізувати дані, і виявити кращі алгоритми сортування у різних випадках.
| № | Алгоритм сортування | Сортування відсортованого масиву по зростанню (мс) | Сортування по зростанню відсортованого масиву по спаданню (мс) | Сортування масиву, всі елементи однакові (мс) | Сортування масиву генерованого випадковим чином (мс) |
| 1 | Quick_Sort | 17000 | 11000 | 14 | 25 |
| 2 | Heap_Sort | 40 | 40 | 8 | 55 |
| 3 | Shell_Sort | 40 | 50 | 46 | 77 |
Висновки
Отже, ми розглянули як працюють швидкі алгоритми сортування іь спробували визначити їх складність.
Застосування того чи іншого алгоритму сортування для вирішення конкретної задачі є досить складною проблемою, вирішення якої потребує не лише досконалого володіння саме цим алгоритмом, але й всебічного розглядання того чи іншого алгоритму, тобто визначення усіх його переваг і недоліків.
Звичайно, необхідність застосування саме швидких алгоритмів сортування очевидна. Адже прості алгоритми сортування не дають бажаної ефективності в роботі програми. Але завжди треба пам’ятати й про те, що кожний швидкий алгоритм сортування поряд із своїми перевагами може містити і деякі недоліки.
Так, алгоритм сортування деревом, хоча й працює однаково на всіх входах (так, що його складність в гіршому випадку співпадає зі складністю в середньому), але цей алгоритм має і досить суттєвий недолік: для нього потрібна додаткова пам’ять розміром 2n-1.
Розглядаючи такий швидкий алгоритм сортування, як пірамідальне сортування, можна зазначити, що цей алгоритм ефективніший ніж попередній, адже він сортує "на місці" , тобто він не потребує додаткових масивів. Крім того, цей алгоритм (" з точністю до мультиплікативної константи" (4,74)) оптимальний: його складність співпадає з нижньою оцінкою задачі, тобто за критеріями C(n) та M(n) він має складність O(n log2 n), але містить складний елемент в умові. Тобто, в умові A[left] має бути строго менше ніж x , а A[right] - строго більше за x. Якщо ж замість "строго більше" та "строго менше" поставити знаки, що позначають "більше, або дорівнює" та "менше, або дорівнює", то індекси left і right пробіжать увесь масив і побіжать далі. Вийти з цієї ситуації можна було б шляхом ускладнення умов продовження перегляду, але це б погіршило ефективність програми.
В нашій роботі ми розглянули деякі швидкі алгоритми сортування та їх реалізацію мовою Pascal, виконуючи курсову роботу ми реалізували програмно не лише використання швидких методів сортування, а і прямих, дослідили не лише переваги таких алгоритмів, ефективність їх використання, але й визначили деякі недоліки окремих алгоритмів, що заважають вживати їх для вирішення першої ліпшої задачі сортування. Програма, в якій міститься реалізація та демонстрація наявних прямих методів сортування називається Prjami.pas, а швидкі - Shvud.pas.
Отже, головною задачею, яку має вирішити людина, яка повинна розв’язати задачу сортування – це визначення як позитивних, так і усіх негативних характеристик різних алгоритмів сортування, передбачення кінцевого результату. До того ж , треба враховувати головне – чи , можливо, цю задачу задовольнить один з класичних простих алгоритмів сортування.
Література
Абрамов С. А., Зима Е. В. Начала программирования на языке Pascal. - М.: Наука, 1987.
Абрамов В. Г. Введение в язык Pascal: Учебное пособие для студентов вузов по специальности Прикладная математика. – М.: Наука, 1988.
Власик А.П. Практикум з програмування в середовищі Turbo Pascal. Ч 1.- Рівне: НУВГП, 2005. – 179 с.
Джонс Ж., Харроу К. Решение задач в системе Турбо-Паскаль/ Перевод