Диплом Программная система Аттестации ИТ-специалистов
Наличие у человека сертификата означает, что он обладает достаточными знаниями, навыками (включая навыки общения с клиентами) для успешной работы в качестве технического специалиста в вычислительных центрах, что подтверждается экспертами ведущих компаний в области компьютерных технологий. Экзамен охватывает широкий диапазон аппаратных и программных технологий, но не привязан к конкретным программам или производителям.
Сертификация считается пройденной, если Вы успешно сдали 1 теоретический и 6 практических модулей:
- Основные положения информатики (Basic Concepts of Information
Technology) (теоретический)
- Применение компьютера и управление файлами (Using the Computer
and Managing Files)
- Обработка текстов (Word Processing)
- Электронные таблицы (spreadsheets)
- Базы данных (Databases/Filing Systems)
- Презентации (Presentation)
- Обмен информацией (Information and Communication)
specialist/ECDL/
brainbench/xml/bb/homepage.xml
Другой распространённый вариант – это интервью – как метод аттестации с привлечением сторонних экспертов и комиссии по оценке результатов аттестации.[1]
Задачей настоящего дипломного проекта является решение «локальной», для конкретного предприятия проблемы аттестации ИТ-специалистов, как можно более приблизив тематику вопросов к задачам, выполняемым на этом, отдельно – взятом предприятии ОАО «Троицкая ГРЭС».
Архитектура программной системы
Архитектура программной системы представлена на рисунке 3.1 и рисунке 3.1а.
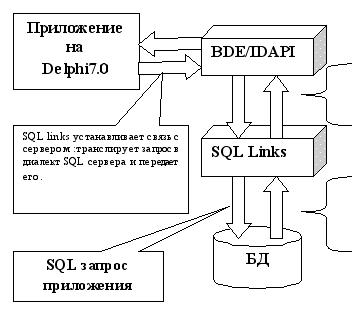
SQL Links транслирует
Ответ клиента и посылает его BDE
Сервер SQL проверяет правильность запроса. выполняет его и отправляет приложению-клиенту
Сервер баз данных
Автоматический контроль ссылочной целостности данных
Встроенная защита данных от несанкционированного доступа
Выполнение хранимых процедур, созданных для обработки данных
Автоматическая генерация уникального ключа
Встроенная возможность резервного копирования данных
ИТА: Аттестация
Начало сессии аттестации
Выбор любого количества категорий, вопросы из которых задавать
Свободное перемещение по базе вопросов, с сохранением уже данных ответов
Возможность выхода из системы с сохранением всех данных ответов
Возможность продолжить сессию аттестации в любое удобное время с сохранением уже данных ответов
Рис.3.1 Архитектура ПС
Приложение включает в себя четыре компонета,составляющие всей системы в
целом, работа с которыми подробно описывается в руководстве пользователя и
администратора в пункте 14 и 10 данного проекта. Как видно архитектура реализует
схему клиент- сервер, которая является наиболее предпочтительней в реализации
данной программной системы аттестации.
ИТА:
Дизайнер-эксперт
Создание категории вопросов
Удаление категории вопросов
Изменение названия категории
Оперативное получение статистической информации по категории (количество вопросов, максимальный балл по категории)
Редактирование вопросов в категории
Встроенный текстовый редактор
Встроенный графический редактор
Возможность передачи текстовой части через буфер обмена
Возможность передачи графической части через буфер обмена
Внесение количества баллов за вариант ответа с автоматическим подсчётом общей суммы баллов за вопрос
Изменение категории вопроса

ИТА: Руководитель
Завершение сессии аттестации
Просмотр результатов аттестации
Построение отчётов по результатам аттестации
Сравнительный анализ результатов аттестации в каждой группе специалистов по каждой категории вопросов
Сравнительный анализ результатов аттестации по каждой категории по всем специалистам
Сравнительный анализ результатов аттестации по каждому специалисту по каждой категории
Сравнительный анализ результатов аттестации по всем вышеперечисленным пунктам в динамике с накоплением знаний.
Сервер баз данных
Автоматический контроль ссылочной целостности данных
Встроенная защита данных от несанкционированного доступа
Выполнение хранимых процедур, созданных для обработки данных
Автоматическая генерация уникального ключа
Встроенная возможность резервного копирования данных

ИТА: Администратор
Создание типа пользователя (от типа пользователя зависит доступ к каким данным открыт пользователю, связанным с этим типом)
Удаление типа пользователя
Создание пользователя и связь его с типом
Удаление пользователя
Завершение сессии аттестации (с автоматическим подсчётом результатов)
Удаление сессии аттестации (с потерей данных аттестации)
Получение оперативной информации о состоянии сервера баз данных
Сервер баз данных
Автоматический контроль ссылочной целостности данных
Встроенная защита данных от несанкционированного доступа
Выполнение хранимых процедур, созданных для обработки данных
Автоматическая генерация уникального ключа
Встроенная возможность резервного копирования данных
ИТА: Аттестация
Начало сессии аттестации
Выбор любого количества категорий, вопросы из которых задавать
Свободное перемещение по базе вопросов, с сохранением уже данных ответов
Возможность выхода из системы с сохранением всех данных ответов
Возможность продолжить сессию аттестации в любое удобное время с сохранением уже данных ответов
Рис . 3.1a Архитектура ПС
4 Разработка структуры баз данных
i.Общая характеристика реляционной модели данных
Основы реляционной модели данных были впервые изложены в статье Е.Кодда [3] в 1970 г. Эта работа послужила стимулом для большого количества статей и книг, в которых реляционная модель получила дальнейшее развитие. Наиболее распространенная трактовка реляционной модели данных принадлежит К.Дейту[4]. Согласно Дейту [4], реляционная модель состоит из трех частей:
Структурной части.
Целостной части.
Манипуляционной части.
Структурная часть описывает, какие объекты рассматриваются реляционной моделью. Постулируется, что единственной структурой данных, используемой в реляционной модели, являются нормализованные n-арные отношения.
Целостная часть описывает ограничения специального вида, которые должны выполняться для любых отношений в любых реляционных базах данных. Это целостность сущностей и целостность внешних ключей.
Манипуляционная часть описывает два эквивалентных способа манипулирования реляционными данными - реляционную алгебру и реляционное исчисление.
В данной главе рассматривается структурная часть реляционной модели.
Типы данных
Любые данные, используемые в программировании, имеют свои типы данных.
Важно! Реляционная модель требует, чтобы типы используемых данных были простыми.
Для уточнения этого утверждения рассмотрим, какие вообще типы данных обычно рассматриваются в программировании. Как правило, типы данных делятся на три группы:
- Простые типы данных.
- Структурированные типы данных.
- Ссылочные типы данных.
Простые типы данных
Простые, или атомарные, типы данных не обладают внутренней структурой. Данные такого типа называют скалярами. К простым типам данных относятся следующие типы:
- Логический.
- Строковый.
- Численный.
Различные языки программирования могут расширять и уточнять этот список, добавляя такие типы как:
- Целый.
- Вещественный.
- Дата.
- Время.
- Денежный.
- Перечислимый.
- Интервальный.
- И т.д.…
Конечно, понятие атомарности довольно относительно. Так, строковый тип данных можно рассматривать как одномерный массив символов, а целый тип данных - как набор битов. Важно лишь то, что при переходе на такой низкий уровень теряется семантика (смысл) данных. Если строку, выражающую, например, фамилию сотрудника, разложить в массив символов, то при этом теряется смысл такой строки как единого целого.
Структурированные типы данных
Структурированные типы данных предназначены для задания сложных структур данных. Структурированные типы данных конструируются из составляющих элементов, называемых компонентами, которые, в свою очередь, могут обладать структурой. В качестве структурированных типов данных можно привести следующие типы данных:
- Массивы
- Записи (Структуры)
С математической точки зрения массив представляет собой функцию с конечной областью определения. Например, рассмотрим конечное множество натуральных чисел

называемое множеством индексов. Отображение

из
множества
 во
множество
вещественных
чисел
 задает
одномерный
вещественный
массив. Значение
этой функции
для некоторого
значения индекса
 называется
элементом
массива, соответствующим
.
Аналогично
можно задавать
многомерные
массивы.
Запись
(или структура)
представляет
собой кортеж
из некоторого
декартового
произведения
множеств.
Действительно,
запись представляет
собой именованный
упорядоченный
набор элементов
 ,
каждый из которых
принадлежит
типу
 .
Таким образом,
запись
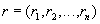 есть
элемент множества
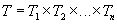 .
Объявляя новые
типы записей
на основе уже
имеющихся
типов, пользователь
может конструировать
сколь угодно
сложные типы
данных.
Общим для структурированных типов данных является то, что они имеют внутреннюю структуру, используемую на том же уровне абстракции, что и сами типы данных.
Поясним это следующим образом. При работе с массивами или записями можно манипулировать массивом или записью и как с единым целым (создавать, удалять, копировать целые массивы или записи), так и поэлементно. Для структурированных типов данных есть специальные функции - конструкторы типов, позволяющие создавать массивы или записи из элементов более простых типов.
Работая же с простыми типами данных, например с числовыми, мы манипулируем ими как неделимыми целыми объектами. Чтобы "увидеть", что числовой тип данных на самом деле сложен (является набором битов), нужно перейти на более низкий уровень абстракции. На уровне программного кода это будет выглядеть как ассемблерные вставки в код на языке высокого уровня или использование специальных побитных операций.
Ссылочные типы данных
Ссылочный тип данных (указатели) предназначен для обеспечения возможности указания на другие данные. Указатели характерны для языков процедурного типа, в которых есть понятие области памяти для хранения данных. Ссылочный тип данных предназначен для обработки сложных изменяющихся структур, например деревьев, графов, рекурсивных структур.
Типы данных, используемые в реляционной модели
Собственно, для реляционной модели данных тип используемых данных не важен. Требование, чтобы тип данных был простым, нужно понимать так, что в реляционных операциях не должна учитываться внутренняя структура данных. Конечно, должны быть описаны действия, которые можно производить с данными как с единым целым, например, данные числового типа можно складывать, для строк возможна операция конкатенации и т.д.
С
этой точки
зрения, если
рассматривать
массив, например,
как единое
целое и не
использовать
поэлементных
операций, то
массив можно
считать простым
типом данных.
Более того,
можно создать
свой, сколь
угодно сложных
тип данных,
описать возможные
действия с этим
типом данных,
и, если в операциях
не требуется
знание внутренней
структуры
данных, то такой
тип данных
также будет
простым с точки
зрения реляционной
теории. Например,
можно создать
новый тип -
комплексные
числа как запись
вида
 ,
где
 .
Можно описать
функции сложения,
умножения,
вычитания и
деления, и все
действия с
компонентами
 и
 выполнять
только внутри
этих
операций. Тогда,
если в действиях
с этим типом
использовать
только
описанные
операции, то
внутренняя
структура не
играет роли,
и тип данных
извне выглядит
как атомарный.
Именно так в некоторых пост реляционных СУБД реализована работа со сколь угодно сложными типами данных, создаваемых пользователями.
Домены
В реляционной модели данных с понятием тип данных тесно связано понятие домена, которое можно считать уточнением типа данных.
Домен - это семантическое понятие. Домен можно рассматривать как подмножество значений некоторого типа данных имеющих определенный смысл. Домен характеризуется следующими свойствами:
Домен имеет уникальное имя (в пределах базы данных).
Домен определен на некотором простом типе данных или на другом домене.
Домен может иметь некоторое логическое условие, позволяющее описать подмножество данных, допустимых для данного домена.
Домен несет определенную смысловую нагрузку.
Например,
домен
 ,
имеющий смысл
"возраст сотрудника"
можно описать
как следующее
подмножество
множества
натуральных
чисел:
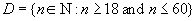
Если тип данных можно считать множеством всех возможных значений данного типа, то домен напоминает подмножество в этом множестве.
Отличие домена от понятия подмножества состоит именно в том, что домен отражает семантику, определенную предметной областью. Может быть несколько доменов, совпадающих как подмножества, но несущие различный смысл. Например, домены "Вес детали" и "Имеющееся количество" можно одинаково описать как множество неотрицательных целых чисел, но смысл этих доменов будет различным, и это будут различные домены.
Основное значение доменов состоит в том, что домены ограничивают сравнения. Некорректно, с логической точки зрения, сравнивать значения из различных доменов, даже если они имеют одинаковый тип. В этом проявляется смысловое ограничение доменов. Синтаксически правильный запрос "выдать список всех деталей, у которых вес детали больше имеющегося количества" не соответствует смыслу понятий "количество" и "вес".
Замечание. Понятие домена помогает правильно моделировать предметную область. При работе с реальной системой в принципе возможна ситуация когда требуется ответить на запрос, приведенный выше. Система даст ответ, но, вероятно, он будет бессмысленным.
Замечание. Не все домены обладают логическим условием, ограничивающим возможные значения домена. В таком случае множество возможных значений домена совпадает с множеством возможных значений типа данных.
Отношения, атрибуты, кортежи отношения
Определения и примеры
Фундаментальным понятием реляционной модели данных является понятие отношения. В определении понятия отношения будем следовать книге К. Дейта
Определение 1. Атрибут отношения есть пара вида <Имя_атрибута : Имя_домена>.
Имена атрибутов должны быть уникальны в пределах отношения. Часто имена атрибутов отношения совпадают с именами соответствующих доменов.
Определение
2.
Отношение
 ,
определенное
на множестве
доменов
 (не
обязательно
различных),
содержит две
части: заголовок
и тело.
Заголовок отношения содержит фиксированное количество атрибутов отношения:
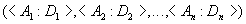
Тело отношения содержит множество кортежей отношения. Каждый кортеж отношения представляет собой множество пар вида <Имя_атрибута : Значение_атрибута>:
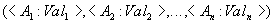
таких
что значение
 атрибута
 принадлежит
домену

Отношение обычно записывается в виде:
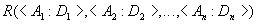 ,
или короче
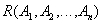 ,
или просто
.
Число атрибутов в отношении называют степенью отношения.
Мощность множества кортежей отношения называют мощностью отношения.
Возвращаясь к математическому понятию отношения, введенному в предыдущей главе, можно сделать следующие выводы:
Вывод 1. Заголовок отношения описывает декартово произведение доменов, на котором задано отношение. Заголовок статичен, он не меняется во время работы с базой данных. Если в отношении изменены, добавлены или удалены атрибуты, то в результате получим уже другое отношение (пусть даже с прежним именем).
Вывод 2. Тело отношения представляет собой набор кортежей, т.е. подмножество декартового произведения доменов. Таким образом, тело отношения собственно и является отношением в математическом смысле слова. Тело отношения может изменяться во время работы с базой данных - кортежи могут изменяться, добавляться и удаляться.
Предварительная структура базы данных, нормализация
Прежде чем начать проектирование базы данных, необходимо определиться какие данных нам необходимо хранить и их взаимосвязь.
Таблица 4.1 Поля таблицы QUESTIONS
|
QUESTIONS – список вопросов |
||
| ID | Integer | Идентификатор вопроса |
| Q_TEXT | BLOB | Текст вопроса |
|
QPICTURE |
BLOB | Граф. часть к вопросу |
| CID | INTEGER | Категория вопроса |
|
Q1 |
SMALLINT | Балл за вариант ответа |
|
Q2 |
SMALLINT | Балл за вариант ответа |
|
Q3 |
SMALLINT | Балл за вариант ответа |
|
Q4 |
SMALLINT | Балл за вариант ответа |
|
Q5 |
SMALLINT | Балл за вариант ответа |
|
Q6 |
SMALLINT |
Балл за вариант ответа |
|
Q7 |
SMALLINT | Балл за вариант ответа |
|
Q8 |
SMALLINT | Балл за вариант ответа |
|
Q9 |
SMALLINT | Балл за вариант ответа |
Таблица 4.2 Поля таблицы USERS
|
USERS – список специалистов |
||
| ID |
INTEGER |
Идентификатор специалиста |
| GID | INTEGER | Принадлежность пользователя к группе |
| TID | INTEGER | Принадлежность пользователя к типу |
| LOGIN | VARCHAR | Ф.И.О специалиста |
| PWD | VARCHAR | Пароль специалиста |
Таблица 4.3 Поля таблицы STORE
|
STORE – данные специалиста |
||
| ID | INTEGER | Идентификатор специалиста |
| UID | INTEGER | Отвечавший пользователь |
| CID | INTEGER | Категория вопросов |
| DATED | VARCHAR |
Дата аттестации |
| PERCS |
SMALLINT |
Результат в % |
Таблица 4.4 Поля таблицы TYPES
|
TYPES – Типы пользователя |
||
| ID | INTEGER | Идентификатор пользователя |
| FLAGS | INTEGER | Признак ответа |
| NAME |
VARCHAR |
Название типа |
Таблица 4.5 Поля таблицы QGROUPS
|
QGROUPS – Категории вопросов |
||
| ID | INTEGER | Идентификатор пользователя |
| NAME | VARCHAR | Категория вопроса |
Таблица 4.6 Поля таблицы GROUPS
|
QGROUPS – Группы пользователей |
||
| ID | INTEGER | Идентификатор пользователя |
| NAME | VARCHAR | Категория группы |
Таблица 4.7 Поля таблицы ASESSIONS
|
ASESSIONS – Активные сессии |
||
| ID | INTEGER | Идентификатор пользователя |
| UID | INTEGER | Отвечавший пользователь |
| NAME | VARCHAR | Ф.И.О пользователя |
| CHOOSENGROUPS | BLOB | Номера выбранной категории |
|
GROUPSRP |
BLOB | Формат отвеченных вопросов |
Нормализация
Отношение находится в Первой Нормальной Форме (1НФ), если оно содержит только скалярные (атомарные) значения [ ].
Отношение
находится
во второй
нормальной
форме
(2НФ)
тогда и только
тогда, когда
отношение
находится в
1НФ и нет не ключевых
атрибутов,
зависящих от
части сложного
ключа. (Неключевой
атрибут
- это атрибут,
не входящий
в состав никакого
потенциального
ключа).
Замечание. Если потенциальный ключ отношения является простым, то отношение автоматически находится в 2 НФ.
Окончательная структура базы данных
Структура базы данных разработана с использованием Case-средства фирмы Platinum – ErWin 3.5.2. и представлена на рисунке 4.1. Описания таблиц базы данных даны в таблице 4.8.
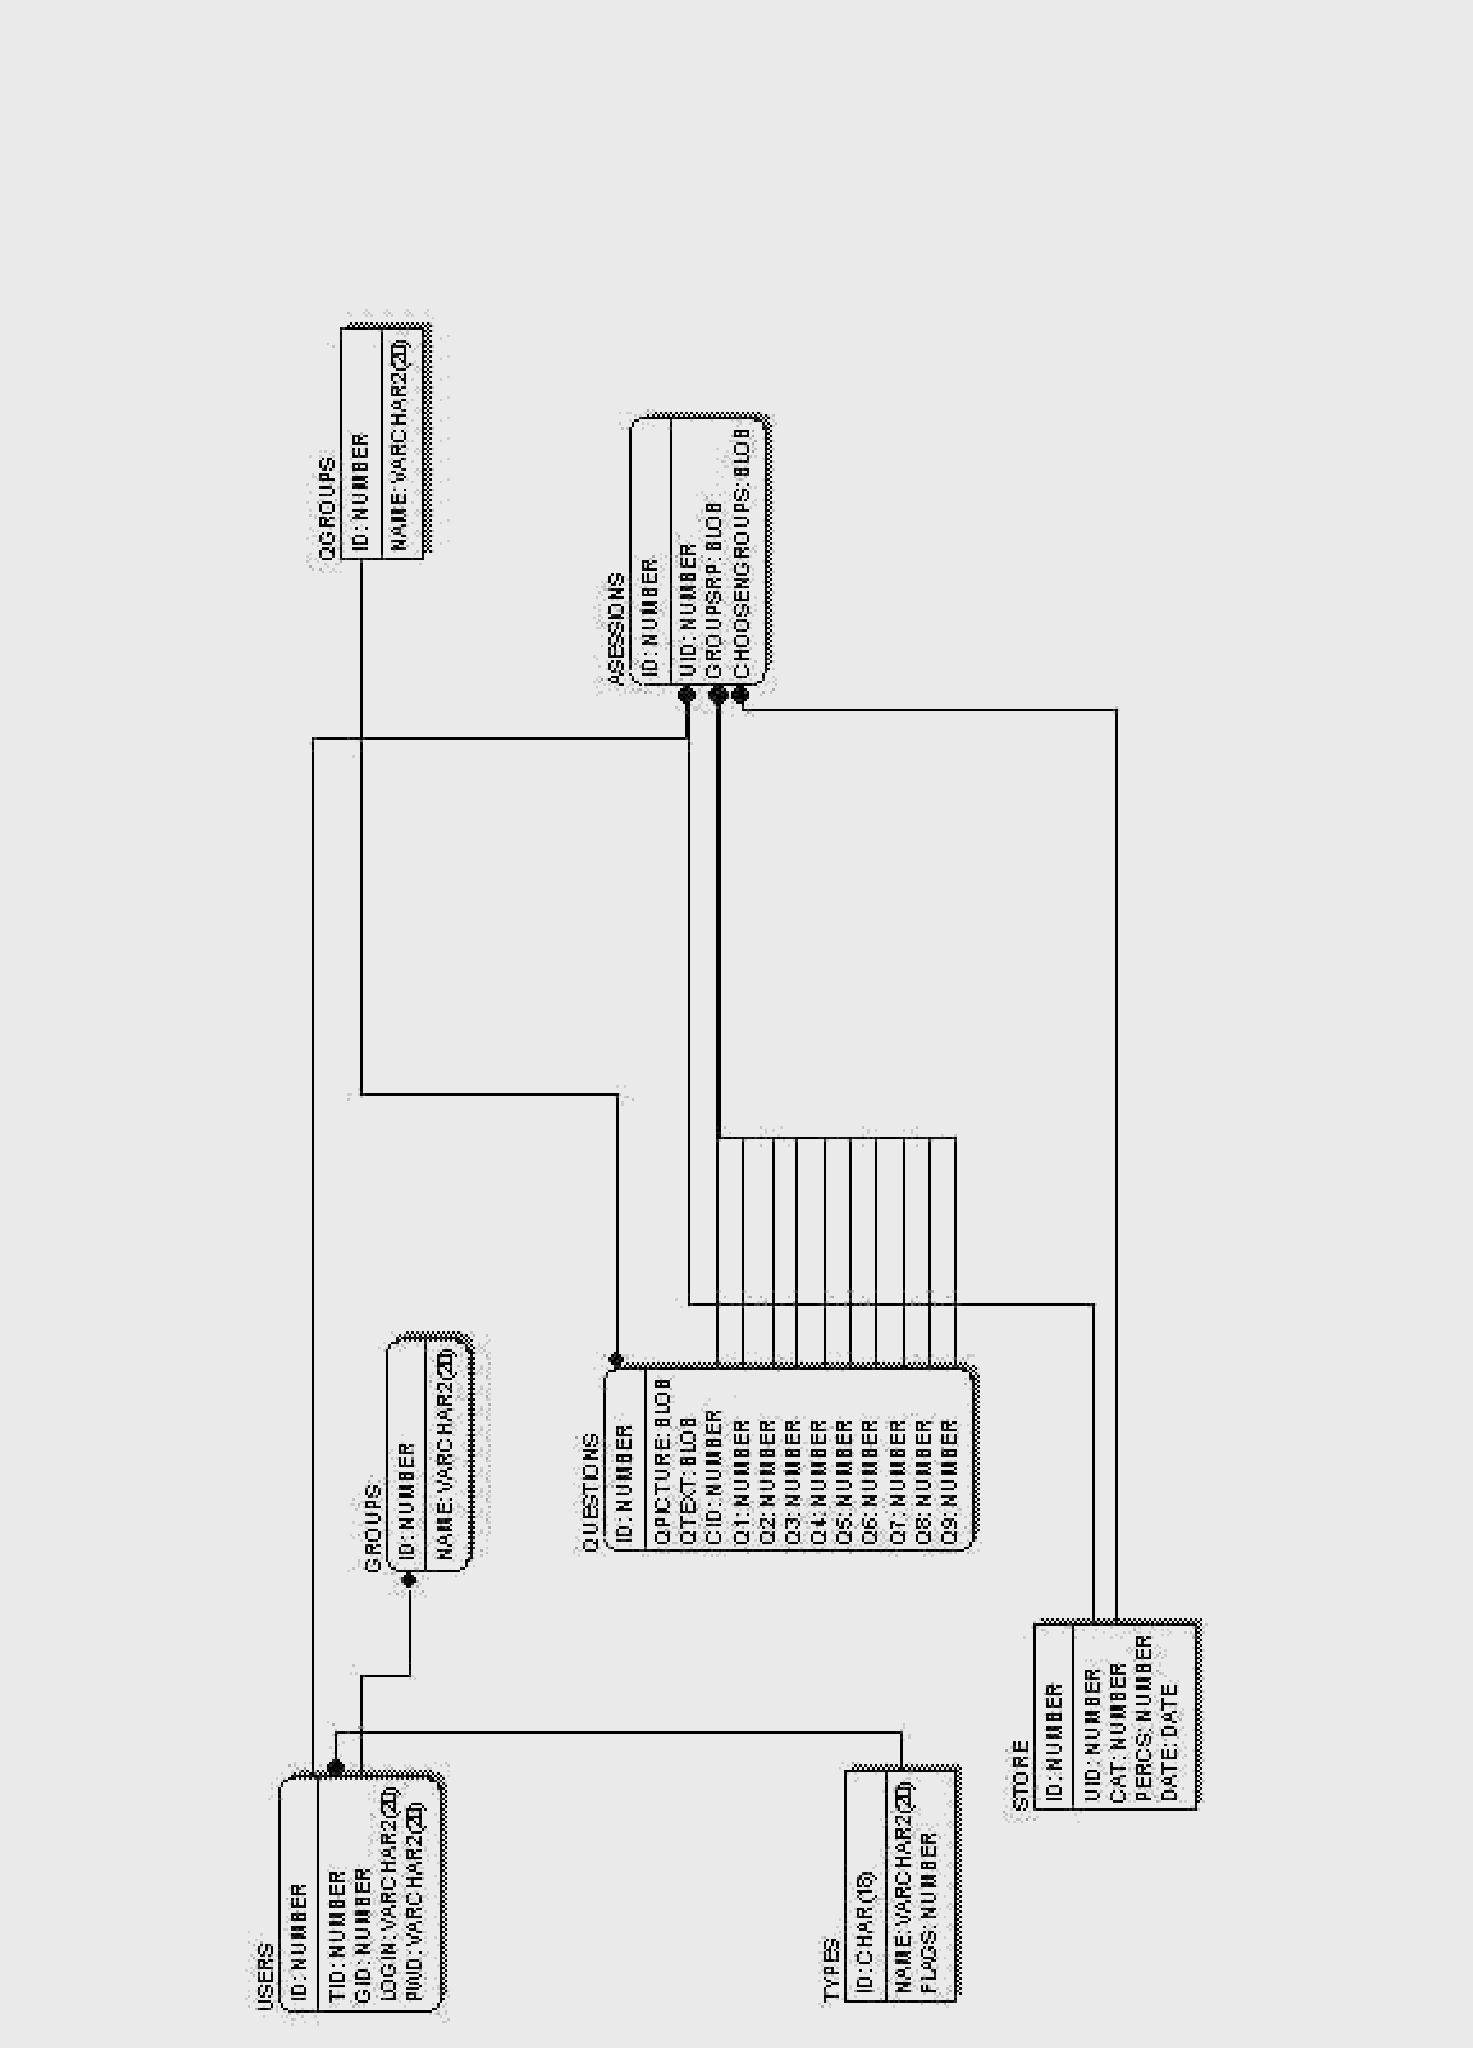
Рис. 4.1 Структура базы данных
Таблица 4.8 Описание таблиц
|
Название таблицы |
Назначение |
Примечание |
| QGROUPS |
Список категорий вопросов |
Для этой таблицы создан генератор и триггер для получения уникального идентификатора |
| QESTIONS | Список вопросов | Для этой таблицы создан генератор и триггер для получения уникального идентификатора |
| USERS | Список специалистов, имя и пароль | Для этой таблицы создан генератор и триггер для получения уникального идентификатора |
| GROUPS |
Список групп специалистов |
Для этой таблицы создан генератор и триггер для получения уникального идентификатора |
| TYPES |
Список типов пользователей. |
Для этой таблицы создан генератор и триггер для получения уникального идентификатора |
| ASESSION | Хранит признак открытой сессии специалистом и дату/время начала сессии |
Контроль за ссылочной целостностью данных осуществляется при помощи первичных ключей (primary key), внешних ключей (foreign key) и триггеров. Полный текст метаданных структуры базы данных дан в приложении 1.
5 Технология проведения аттестации с использованием
данной системы.
a.Технология проведения аттестации на ОАО «Троицкая ГРЭС» и ее недостатки.
На данный момент, на ОАО «Троицкая ГРЭС» действует следующий порядок проведения аттестации ИТ-специалистов рисунок 2.1:
Руководитель группы АСУ готовит вопросы для проведения аттестации.
Назначается срок аттестации и формируется состав комиссии
В назначенный срок специалисты в присутствии комиссии отвечают на подготовленные вопросы в письменном виде в свободной форме
Комиссия проверяет ответы на вопросы и делает заключение по каждому специалисту
Заключения передаются руководителю группы АСУ
Рис 5.1 Порядок проведения аттестации
По составленным заключениям и выносятся соответствующие административные решения:
- О служебном продвижении
- Об изменении характера трудовых обязанностей
- Об изменении оплаты труда или иных материальных условий
- О направлении на учебу
- О необходимости повторной аттестации
В ходе анализа процесса аттестации были выявлены следующие недостатки существующего порядка проведения аттестации:
- Сложно выбрать подходящее время для проведения аттестации,не нарушив
при этом рабочий график всех участвующих (комиссия и специалисты).
- Потеря времени на подготовку вопросов руководителем.
- Нет определённого критерия выбора вопросов для проведения аттестации.
- Как правило, не учитываются реальные задачи, выполняемые
специалистами.
- Неоднозначность оценки результатов аттестации, влияние субъективного
мнения.
- Продолжительность процесса аттестации и подготовки заключения.
В рамках настоящего дипломного проекта был предложен и согласован новый порядок проведения аттестации ИТ-специалистов, с учётом возможностей разработанной программной системы. Модифицированная технология аттестации с использованием программной системы рассматривается в разделе 5.
b.Технология проведения аттестации с использованием данной системы.
Прежде чем описать технологию проведения аттестации данной системы выявим и приведем некоторые варианты использования разрабатываемой системы , с помощью которой руководство получает данные в зависимости от сложившейся ситуации( рис.4.1):
Ситуация: Приём на работу специалиста.
Провести аттестацию кандидатов, построить отчёт по специалистам, выбрать кандидата с максимальным баллом во всех категориях.
Ситуация: Проверка знаний персонала с целью выявления соответствия знаний занимаемой
должности
Построить отчёт по группам специалистов , выбрать специалистов с максимальным баллом в группе. Присвоить
соответствующую категорию или разряд прошедшему проверку в полном объеме.
Рис. 5.2 Варианты использования системы
Вариантов ситуаций может быть множество, так же как и множество ветвей их решения. Здесь мы попытаемся обобщить какие выводы можно сделать по результатам аттестации:
-О служебном продвижении
-Степень готовности специалиста к работе на новом рабочем месте, в
новой должности
-Об изменении характера трудовых обязанностей
-Возможности специалистов приспособится к новым условиям работы
-Какие специалисты требуют большей подготовки
-О взаимозаменяемости специалистов
-О направлении на учебу
-О необходимости повторной аттестации
-Оценить результаты программ обучения персонала
-Об изменении оплаты труда или иных материальных условий
Одним из самых важных является тот факт, что сам процесс был автоматизирован (рис 4.2). Теперь для проведения аттестации, достаточно объявить об этом участникам (специалистам),которым необходимо пройти
тестирование по конкретной категории вопросов. Тот факт, что система позволяет прервать процесс аттестации, не прерывая сессии аттестации с сохранением всех ранее данных ответов, позволяет специалистам самим определить подходящее время для ответа на вопросы, при необходимости прерываться на свою основную работу и продолжить позже. Возникает вопрос, как долго может длиться такая сессия? С точки зрения системы нет ограничений на продолжительность сессии аттестации. Реально же продолжительность устанавливается в организационном порядке исходя из количества вопросов и загруженности специалистов основной работой, причём сроки могут теперь устанавливаться индивидуально.
Завершить сессию аттестации может руководитель либо администратор системы, после чего результаты аттестации уже готовы для анализа руководителем.
Важным так же является тот факт, что теперь специалист отвечает на вопросы на своём рабочем месте в привычной обстановке, что безусловно уменьшает влияние ситуативных факторов и положительно скажется на конечных результатах аттестации.
Тем самым были исключены некоторые недостатки обычного порядка проведения аттестации ИТ-специалистов, однако некоторые ещё остались.
Теперь необходимо определиться с тем, кто готовит вопросы к аттестации. Есть вариант использовать вопросы из внешних источников или сторонних экспертов, но всё же такие вопросы будут далеки от реальных задач. Решение напрашивается само собой – кто же лучше разбирается в тонкостях определённой задачи как не специалист, работающий с этой задачей ?
Был предложен следующий вариант подготовки вопросов к аттестации: Вопросы готовят сами специалисты, каждый специалист для своей задачи, т.е. каждый специалист теперь сам эксперт в рамках задач, которые он выполняет. Вопросы разбиваются на категории в соответствии с выполняемыми задачами на том или ином рабочем месте. Категории вопросов содержат несколько правильных ответов. Каждому правильному ответу присваивается свой вес от 0 до 99 , который в свою очередь влияет на общий балл тестируемого специалиста за конкретный вопрос конкретной категории. Но если в группе ответов на конкретный вопрос будет хоть один неправильный ответ ,то данный вопрос помечается как ошибочный.
Такой подход подготовки вопросов даёт ряд преимуществ:
- Тематика вопросов уходит от общих знаний и становится максимально приближена к конкретным задачам,