Операционные системы "тонких" клиентов
9.4 Управление памятью
В части управления памятью BeOS обеспечивает сегментную модель для приложений, однако, в ней "просматривается" сегментно-страничная реализация. Любая нить может запросить выделение для нее области (area) памяти. Область представляет собой непрерывный участок виртуальной памяти, размер которого задается в системном вызове create_area(). Размер области должен быть кратен размеру страницы (4 Кбайт). Операция создания области возвращает ее адрес в виртуальном адресном пространстве команды. При создании области нить может явно задать адрес в своем виртуальном адресном пространстве, по которому область должна быть размещена, но адрес размещения области обязательно выравнивается по границе страницы. Кроме того, при создании каждой новой области ей присваивается уникальный во всей системе идентификатор. Этот идентификатор может использоваться в вызове delete_area() или передаваться другим командам для совместного использования области.
Области также может быть присвоено имя. Системный вызов find_area() возвращает идентификатор области с заданным именем. Однако, как и в случае с нитями, имя области не является уникальным, и системный вызов find_area() возвращает идентификатор только первой найденной области.
В пределах одной команды все нити "видят" созданную область по одному и тому же виртуальному адресу. При совместном использовании области двумя и более командами, команда, не являющаяся владельцем области, должна получить ее идентификатор и "клонировать" область при помощи системного вызова clone_area(). Параметром этого вызова является идентификатор области, а возвращает он виртуальный адрес области. Этот адрес может отличаться от виртуального адреса области в той команде, в которой область была создана. Клонирование области, однако, не означает дублирования ее данных. Оно просто задает отображение участков виртуального адресного пространства разных команд на одну и ту же реальную память. Изменения в содержимом области, сделанные одной командой, будут немедленно видны в другой команде.
Область явно уничтожается системным вызовом delete_area() или неявно - при завершении всех нитей команды, в которой область была создана. Если, однако, область была клонирована, то ее реальное освобождение происходит при уничтожении (явном или неявном) ее последнего клона.
При создании или клонировании области можно сделать ее защищенной от записи или защищенной от чтения.
При создании области можно также зафиксировать ее в реальной памяти, при этом имеются возможности:
выделить для области физическую память немедленно и исключить ее из страничного обмена;
выделять для области физическую память постранично, по требованию и выделенные страницы исключать ее из страничного обмена;
выделить для области физическую память немедленно, причем в непрерывной области реальной памяти, и исключить ее из страничного обмена.
9.5 Образы
Программные коды, готовые для выполнения, называются в BeOS образами (image). Различаются три вида образов:
образы приложений;
библиотечные образы;
дополнительные (add-on) образы.
Образы приложений являются загрузочными модулями программ. Для их загрузки и связывания применяется системный вызов load_image(). Параметром вызова является имя файла, из которого загружается образ приложения. Этот вызов в чем-то подобен вызову spawn_thread(). Он также создает новую нить. В этой нити будет выполняться функция main() приложения. Но этот вызов создает также и новую команду, "возглавляемую" нитью main запускаемого приложения, а следовательно, и новое виртуальное адресное пространство и другие общекомандные ресурсы. Как и spawn_thread(), load_image() возвращает идентификатор нити. Созданная таким образом нить должна быть запущена на выполнение теми же системными вызовами resume_thread() или wait_for_thread().
Библиотечные образы являются модулями динамической компоновки, подключение (связывание) которых происходит автоматически при загрузке приложения. Библиотечные образы используются совместно всеми приложениями.
Дополнительные образы также являются совместно используемыми модулями динамической компоновки. Но их загрузка и связывание происходят по требованию, уже в процессе выполнения приложения. Загрузка такого модуля выполняется при помощи системного вызова load_add_on(), которому передается имя файла, содержащего дополнительный образ. Вызов load_add_on() возвращает идентификатор загруженного образа, который далее можно использовать в качестве параметра системного вызова get_image_symbol(), чтобы получить адреса внешних символов и входных точек дополнительного образа.
С точки зрения формата дополнительные образы ничем не отличаются от библиотечных. В параметрах системного окружения отдельно задаются каталоги, из которых загружаются библиотечные и дополнительные образы. Манипулируя этими параметрами, можно сделать так, что образ, к одному приложению подключаемый при загрузке, для другого будет дополнительным.
9.6 Устройства и файловые системы
Драйверы в BeOS являются расширениями ядра системы и могут работать в адресном пространстве ядра. В системе различаются три вида драйверов:
драйверы устройств;
драйверы файловых систем;
модули.
Последние являются вспомогательными программными единицами, выполняющими некоторый общий сервис, необходимый для всех или нескольких драйверов устройств (например, управление шиной SCSI). Если первые два вида драйверов доступны для пользовательских приложений через API, то модули полностью скрыты от пользователей и вызываются только из других драйверов.
Обращения к драйверам из приложений выполняются через API POSIX (open(), read(), write() и т.д.). Перевод API POSIX во внутренние системные вызовы ядра BeOS осуществляет "файловая система устройств" devfs. Для того, чтобы драйвер был доступен для devfs, он должен быть записан (опубликован) в соответствующем каталоге иерархической файловой системы.
К сожалению, нам не удалось найти исчерпывающей информации о файловой системе BeOS, но даже та неполная информация, которую нам удалось получить, представляет существенный интерес.
Первая файловая система BeOS не имела иерархической структуры. Вместо этого логическая структура файловой системы поддерживалась "базой данных файлов". Навигация по логической структуре осуществляется средствами, напоминающими средства, принятые в реляционных базах данных - запросами. Поиск файла выполняется запросом, содержащим предикат (иногда довольно сложный), проверяющий значение одного или нескольких атрибутов файла. Хотя бы для одного из атрибутов, участвующих в предикате, должен быть создан индекс. Наряду с запросами, формулируемыми при каждом обращении, в системе существуют и "постоянно живущие" запросы - аналоги представлений (view) в реляционных базах данных. Подобно представлению, постоянный запрос представляет собой не зафиксированную выборку, а зафиксированный предикат, выборка же при каждом обращении выполняется заново. Постоянные запросы представляют собой функциональный аналог каталогов в иерархической файловой системе.
В 1997 г. для BeOS была разработана новая файловая система - BFS. В ней была введена иерархическая структура файловой системы и логическая структура в значительной степени интегрировалась с физической структурой хранения. Однако наряду с иерархической логической структурой BFS поддерживает и индексирование по именам и другим атрибутам файлов и, таким образом, в полном объеме сохраняется возможность альтернативной "реляционной" навигации по файловой системе.
Единицей распределения дискового пространства является блок, размер блока выбирается из ряда: 512 байт, 1 Кбайт, 2 Кбайт, 4 Кбайт, 8 Кбайт. Файл состоит из одного или нескольких экстентов, каждый экстент - целое число последовательных блоков. План размещения файла представляет собой массив описателей экстентов. Каталоги структурированы в виде B+-деревьев. Дескрипторы файлов и элементы каталогов разделены, но несмотря на это, BFS не поддерживает "жесткие" связи (алиасы), а только "мягкие" связи (косвенные файлы). В дескрипторе файла хранятся основные его атрибуты, расширенные же атрибуты хранятся вместе с данными файла.
С введением BFS была введена и концепция виртуальной файловой системы, обеспечивающая для BeOS возможность работы с файловыми системами различных форматов (CDFS и HFS от MacOS). Ядром BeOS формируется корневой каталог виртуальной файловой системы, в котором не могут находится файлы, а только подкаталоги и "мягкие" связи. Другие физические файловые системы монтируются как подкаталоги корневого каталога. Ряд подкаталогов и связей монтируются в корневой каталог автоматически, при загрузке системы. Также автоматически монтируются и еще две виртуальные файловые системы: /dev - виртуальная файловая система устройств и /pipe - виртуальная файловая система программных каналов.
Некоторые другие интересные свойства BFS также определяются спецификой этой файловой системы:
64-разрядный размер файла - важное обстоятельство, если учесть то, что многие файлы в BFS содержат мультимедийную информацию;
использование многопоточности в работе самих модулей BFS - в соответствии с общей концепцией всей BeOS;
журналирование - свойство, которое может показаться роскошью для настольной ОС, но в BFS оно совершенно необходимо для сохранения целостности при сбоях базы данных файлов.
Интересен способ, который использует BeOS для определения типа файла, а следовательно, и приложения, по умолчанию связываемого с визуализацией и обработкой этого файла. В атрибутах файла обеспечивается идентификация типа в соответствии со спецификациями MIME (Multipurpose Internet Mail Extensions). Наряду со стандартными типами MIME, BeOS применяет также и собственные типы, не предусмотренные в MIME, но определяемые также в формате спецификации MIME. При отсутствии у файла MIME-специфицированных атрибутов для определения типа используется расширение файла, и BeOS ведет собственную "базу типов файлов", которые определяют связанные с типом-расширением приложения. BeOS также представляет пользователю возможность назначать собственные интерпретации типа для каждого файла или группы файлов.
Глава 10. Операционная система QNX
10.1 Архитектура
Операционная система QNX [32] производится компанией QNX Software Systems Ltd. с 1980 г. В настоящее время существует версия 6.1 системы. Для нас ОС QNX представляет особый интерес по двум причинам: во-первых, это ОС реального времени, во-вторых, это ОС, построенная на концепции микроядра "в чистейшем виде". Как следствие этого, QNX - легко масштабируемая система
Архитектура ОС QNX показана на рисунке 10.1.
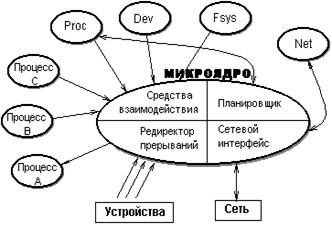
Микроядро QNX имеет минимальный размер (всего 8 Кбайт), и в нем сосредоточены все операции, выполняемые в режиме ядра. Ядро не имеет процессов, его модули всегда выполняются в контексте процесса, их вызвавшего. Модули, сосредоточенные в микроядре, выполняют следующие основные функции:
планирование и переключение процессов и управление реальной памятью (планировщик);
первичную обработку прерываний и перенаправление их адресатам (редиректор прерываний);
обеспечение связей между процессами (средства взаимодействия);
сетевые взаимодействия (сетевой интерфейс).
Все эти функции аппаратно-зависимые и/или требуют высокой эффективности в реализации. Другие функции ОС обеспечиваются системными процессами-менеджерами, которые, однако, выполняются в пользовательском режиме и с точки зрения микроядра ничем не отличаются от процессов пользователей. Типичные конфигурации ОС QNX включают в себя следующие системные процессы:
менеджер процессов (Proc);
менеджер файловой системы (Fsys);
менеджер устройств (Dev);
сетевой менеджер (Net).
Микроядро QNX выполняет всего 57 системных вызовов, однако процессы-менеджеры ОС обеспечивают выполнение большого числа других системных вызовов, что позволило ОС QNX получить сертификат POSIX. Таким образом, ОС QNX может считаться Unix-подобной системой, хотя ее внутренняя структура далека от традиционной структуры ОС Unix.
10.2 Управление процессами
Порождение и планирование процессов обеспечивается менеджером процессов совместно с планировщиком в микроядре. Менеджер процессов выполняет порождение новых процессов, загрузку и завершение процессов. Для создания процессов имеются системные вызовы fork() и exec(), традиционные для Unix, а также spawn() - создание процесса-потомка с выполнением в нем новой программы.
QNX различает процессы, находящиеся в следующих состояниях:
готовые ( среди них - и активный процесс);
ожидающие (6 подвидов - в зависимости от причин ожидания)
мертвые (уже завершившиеся, но не передавшие информации о своем завершении).
Планирование процессов в QNX выполняется по абсолютным приоритетам, то есть, появившийся или разблокированный процесс с более высоким приоритетом вытесняет активный процесс немедленно. При наличии в состоянии готовности нескольких процессов с одинаковым высшим приоритетом разделение процессора между ними выполняется по одной из дисциплин на выбор:
FCFS;
RR;
динамическое изменение приоритета.
В последнем случае изменение приоритета производится по таким правилам:
если активный процесс полностью исчерпал квант времени и есть еще процессы с таким же приоритетом, приоритет активного процесса уменьшается на 1;
если процесс пробыл в очереди готовых процессов, не получая обслуживания на процессоре, 1 сек, его приоритет увеличивается на 1.
Всего в системе имеется 32 градации приоритетов.
В отличие от других систем, в которых процессы реального времени получают наивысший приоритет (в ущерб всем другим процессам), в QNX обеспечение работы в реальном времени состоит в том, что всем процессам обеспечивается высокая реактивность. То есть, если происходит какое-либо событие (прерывание), требующее выполнения определенного процесса, требуемый процесс становится активным после самой минимальной задержки. Реактивность обеспечивается за счет высокой реентерабельности модулей микроядра (то есть, возможности прервать выполнение модуля) и высокой эффективности средств взаимодействия процессов.
Внешнее событие вызывает прерывание. Для обеспечения высокой реактивности прерывание должно обрабатываться немедленно. Но обработка прерывания может быть отложена по следующим причинам:
выполняется обработка прерывания с более высоким приоритетом;
выполняется нереентерабельный код микроядра (при этом обработка прерывания запрещается).
Если первый вид задержек является объективным и оправданным, то второй является нежелательным. В QNX модули микроядра тщательно оптимизированы с целью минимизации размера участков нереентерабельного кода. В результате модули микроядра также являются прерываемыми почти в любом месте. Участки кода с запрещенными прерываниями составляют в среднем всего 9 команд на входе в модуль микроядра и 14 команд - на выходе из модуля.
10.3 Средства взаимодействия
ОС QNX обеспечивает (на уровне микроядра) три средства взаимодействия процессов: сигналы, сообщения и поручения (proxy).
Механизм сигналов соответствует тому, который мы рассмотрели в разделе 9.2 части I. QNX работает с большим количеством типов сигналов, среди которых:
стандартные сигналы, определяемые POSIX;
сигналы, управляющие работой процессов;
специальные сигналы QNX;
сигналы, поддерживающие старые версии Unix.
Процесс может определять способы обработки некоторых (но не всех) сигналов.
Сообщения являются основным способом взаимодействия между процессами в QNX. В отличие от того смысла, который мы вкладывали в этот термин в разделе 9.7 части I, в QNX сообщения являются синхронными, то есть процесс, пославший сообщение, требует обязательного ответа на него.
Обмен сообщениями обеспечиваются вызовами микроядра:
Send() - посылка сообщения:
Recive() - прием сообщения;
Reply() - посылка ответа.
На рисунке 10.2 показан сценарий взаимодействия процессов при посылке сообщения
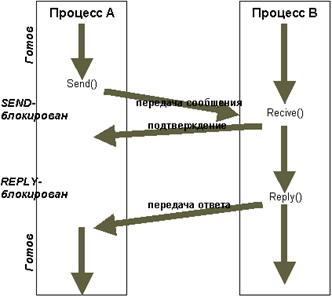
Рисунок 10.2 Сценарий взаимодействия процессов при посылке сообщения
В соответствии с протоколом передачи сообщений различаются следующие подвиды блокировки процесса:
SEND-блокированный процесс - послал сообщение и ожидает подтверждения его приема.
REPLY-блокированный процесс - получил подтверждение приема и ожидает получения ответа.
RECIVE-блокированный процесс - запросил прием сообщения и ожидает его поступления. На рисунке 10.2 состояние RECIVE-блокировки не показано, в него мог бы попасть Процесс B, если бы выполнил системный вызов Recive() прежде, чем Процесс A выполнил Send().
Модель сообщений QNX более всего напоминает взаимодействие процессов по принципу рандеву (см. раздел 8.11 части I), описываемую как:
A!x; ?y
Для взаимодействия процессов необходима "встреча" готовности одного процесса (Процесса A) передать сообщение и готовности другого процесса (Процесса B) принять сообщение. При этом для процессов, участвующих в рандеву, нет необходимости знать о готовности процесса-корреспондента. Процесс, первым пришедший в точку рандеву, просто блокируется (SEND- или RECIVE-блокировкой) до готовности процесса-партнера.
Передача ответа подтверждения не требует, и выполнение вызова Reply() не приводит к блокировке процесса, выполнившего этот вызов.
При необходимости процесс может посылать сообщения нулевой длины и/или ответы нулевой длины - такие приемы применяются для взаимного исключения и синхронизации без обмена данными.
Несколько процессов могут послать сообщения одновременно одному адресату. В этом случае сообщения могут обрабатываться (получаться адресатом) либо в порядке их поступления, либо в соответствии с приоритетами отправителей.
Еще один вызов микроядра -Crecive() - позволяет процессу проверить наличие сообщений для него и, таким образом, избежать RECIVE-блокировки.
Интересно, что, используя механизм сообщений-рандеву, библиотеки системных вызовов QNX обеспечивают интерфейсы других стандартных средств взаимодействия процессов, таких как программные каналы или семафоры.
Третий вид взаимодействия - поручения - обеспечивает асинхронное взаимодействие процессов. Фактически поручения идентичны очередям сообщений, описанным нами в разделе 9.7 части I.
10.4 Файловая система
Администратор файловой системы ОС QNX позволяет стандартным образом организовать хранение и доступ к данным файловых подсистем (томов). С точки зрения логической файловой системы, хранение файлов в QNX подобно тому, какое обеспечивает ОС Unix: общее дерево каталогов с возможностью монтирования новых томов как ветвей этого общего дерева. Обеспечиваются также "жесткие" и "мягкие" связи.
На физическом уровне диск QNX структурирован так, как показано на рисунке 10.3.
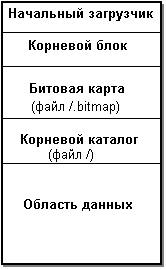
Рисунок 10.3 Структура диска QNX
Загрузчик представляет собой блок начальной загрузки. Он не осуществляет загрузку собственно ОС, а выполняет выбор загрузочного файла ОС.
Корневой блок имеет структуру каталога и содержит информацию о следующих специальных файлах:
файл с именем / - корневой каталог;
файл с именем /.inodes - файл файловых индексов;
файл с именем /.boot - загрузочный файл ОС;
файл с именем /.altboot - альтернативный загрузочный файл ОС.
Загрузчик загружает операционную систему из файла /.boot, но имеется возможность загрузки и из альтернативного файла.
Битовая карта содержит информацию о свободных блоках на диске. Свободному блоку соответствует бит со значением 0, занятому - 1.
Размещение файла на диске QNX показано на рисунке 10.4.
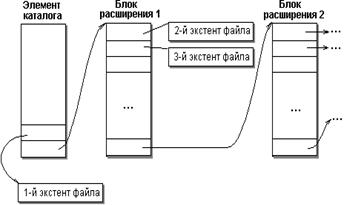
Рисунок 10.4 Размещение файла на диске QNX
Единицей распределения дискового пространства является блок (512 байт). Пространство файлу выделяется экстентами - непрерывными последовательностями, состоящими из целого числа блоков. В элементе каталога, соответствующем файлу, содержится номер начального блока и размер для первого экстента файла. Если файлу выделено более одного экстента, то в элементе каталога содержится номер блока расширения, через который адресуются следующие экстенты файла. Если одного блока расширения недостаточно, последний элемент первого блока расширения адресует второй блок расширения и т.д.
Интересным образом обеспечиваются в QNX жесткие связи (алиасы). Показанная на рисунке 10.4 структура относится к файлу, не имеющему жестких связей. Если же для файла создается жесткая связь, то информация о размещении файла переносится в файловый индекс, находящийся в файле /.inodes. Элемент каталога в этом случае содержит номер файлового индекса, и два разных элемента каталога могут ссылаться на один и тот же файловый индекс, а следовательно, на один и тот же физический файл. Таким образом, файловый индекс для файла создается только тогда, когда нужно разделить информацию о хранении файла в логической и в физической файловых системах.
Файловый индекс создается также и для файла с длинным именем. В обычном элементе каталога предусмотрено место для 16-символьного имени файла. Если длина имени файла превышает 16 символов, для файла создается файловый индекс и информация о размещении файла переносится в файловый индекс. При этом в элементе каталога освобождается место еще для 32 символов имени, таким образом, длина имени файла может достигать 48 символов.
10.5 Управление устройствами
Интерфейс между процессами и устройствами обеспечивается менеджером устройств. Устройства включены в общее пространство имен файловой системы как специальные файлы, находящиеся в подкаталоге .dev. Для процесса устройство представляется как двунаправленный поток байтов. Менеджер устройств управляет прохождением этого потока между процессом и устройством и отчасти осуществляет обработку данных в потоке. С каждым устройством связан блок управления termios, в котором задаются параметры обработки данных, такие как:
алгоритм передачи данных (скорость, контроль четности и т.д.);
отображение символов, вводимых с клавиатуры, на экране;
трансляция вводимых символов;
программное и аппаратное управление потоком данных;
и т.д., и т.п.
Данные, которыми обмениваются менеджер устройств и драйвер, проходят через набор очередей, с каждым устройством связаны по три очереди:
входная очередь;
выходная очередь;
так называемая, каноническая очередь - очередь ввода данных с редактированием.
Общий размер всех трех очередей не превышает 64 Кбайт. Очереди обслуживаются по дисциплине FIFO, независимо от приоритетов процессов, которым принадлежат данные в очередях. Для обеспечения высокой эффективности ввода-вывода сам менеджер устройств выполняется как процесс с высоким приоритетом. Это не сказывается на быстродействии других процессов, так как управление вводом-выводом никогда не занимает процессор надолго. Драйверы также выполняются как отдельные процессы, их приоритеты зависят от особенностей обслуживаемых ими устройств.
Вводимые данные помещаются драйвером во входную очередь. Менеджер устройств выбирает данные из этой очереди только тогда, когда процесс запрашивает данные. Выходные же данные менеджер устройств помещает в выходную очередь и немедленно же активизирует драйвер.
Запрос данных при пустой входной очереди приводит к блокировке процесса. Также блокируется процесс и тогда, когда пытается вывести данные при переполненной выходной очереди.
10.6 Сетевые взаимодействия
С самого начала QNX создавалась как сетевая ОС и это выражается прежде всего в том, что средства взаимодействия локальных и удаленных процессов в QNX одни и те же - сообщения. Процесс не видит разницы во взаимодействии с локальным или удаленным корреспондентом. Такое свойство обеспечивается при помощи "виртуальных каналов", показанных на рисунке 10.5.
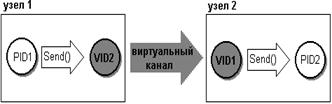
Рисунок 10.5 Посылка сообщения через виртуальный канал
Виртуальный канал создается процессом-отправителем сообщения При этом на узле отправителя и на узле получателя создаются виртуальные процессы, каждый из которых представляет на локальном узле идентификатор процесса - удаленного корреспондента. Реальный процесс имеет реальный идентификатор (PID), виртуальный процесс - виртуальный идентификатор (VID). VID обеспечивает соединение, которое содержит следующую информацию:
локальный PID;
удаленный PID;
удаленный NID (идентификатор узла сети);
удаленный VID.
Процессы QNX имеют символьные имена, причем эти имена могут быть глобальными, доступными во всей сети. Приложение может по имени получить PID процесса - удаленного корреспондента. При этом система автоматически создает виртуальный канал и для приложения этот канал отождествляется с PID корреспондента.
Администратор сети обеспечивает создание виртуальных каналов, буферизацию данных в канале и контроль целостности виртуальных каналов.
10.7 Графическая система Photon
Пользовательский интерфейс QNX строится на базе графической системы Photon. Структура графической системы представляет для нас интерес прежде всего потому, что она следует общим архитектурным концепциям QNX. Это обстоятельство делает графическую систему нетребовательной к ресурсам, легко масштабируемой - от интерфейса встроенного или карманного мобильного устройства до полнофункционального WIMP-интерфейса. Это обеспечивает также то, что возможные сбои графической системы не оказывают влияния на работоспособность всей ОС и требуют только перезапуска отказавшего компонента.
В отличие от других графических систем, которые обеспечивают функции графического интерфейса в монолитной (Windows) или клиент/серверной (X Window) модели, Photon строится на базе компактного графического микроядра и распределения графической функциональности между взаимодействующими процессами. Архитектура графической системы показана на рисунке 10.6, и она очень похожа на архитектуру QNX в целом.
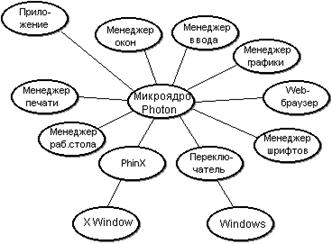
Рисунок 10.6 Архитектура графической системы Photon
Микроядро Photon, которое является процессом QNX, выполняет необходимый минимум графических функций. Микроядро Photon занимает всего 55 Кбайт памяти. Прочие части графической системы - также процессы, которые для выполнения базовых функций обращаются к микроядру Photon, используя средства взаимодействия, обеспечиваемые микроядром QNX. Менеджеры графической системы являются опционными, включение новых менеджеров расширяет функции системы. До некоторой степени ключевым компонентом, определяющим переход от интерфейса встроенной системы к WIMP-интерфейсу, является менеджер окон, который обеспечивает изменение размера, минимизацию, перемещение и т.д. для окон.
Работа системы Photon строится на концепции "трехмерного пространства событий", которая иллюстрируется на рисунке 10.7.
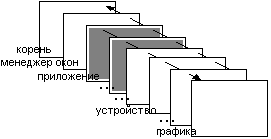
Рисунок 10.7. Движение через пространство событий
Событиями в системе являются как события, инициируемые пользователем (мышью, клавиатурой), так и события, инициируемые процессами. Пространство, через которое движутся события, представляется как набор параллельно размещенных прямоугольных областей. Метафорой, давшей название системе, является движение частицы света (фотона) через ряд стеклянных пластин. На одном конце этого ряда находится корневая область, создаваемая системой, на другом конце - та область, которая представляется пользователю. Процесс, который выполняет какие-либо функции, связанные с интерфейсом, помещает свою область в этот ряд. Каждая область имеет две маски для проходящих через нее событий: маску чувствительности и маску непрозрачности. Установка бита чувствительности для определенного события определяет передачу события для обработки процессу, связанному с областью. Установка для события бита непрозрачности определяет прекращение движения события через пространство. Графические драйверы являются процессами, которые помещают свои области на переднем (ближнем к пользователю) краю ряда. Это обеспечивает также возможность распределенной обработки в сети: приложение с графическим интерфейсом может работать в одном узле сети, а результат его работы отображаться на другом узле. Физический драйвер целевого узел просто помещает свою область на переднем краю пространства событий. Подобным образом обеспечивается и отображение результатов работы приложений QNX в других графических системах: вместо драйвера в пространство событий вставляется область переходника в систему Windows или X Window.
Глава 12. Операционные системы мейнфреймов
12.1 История и архитектура мейнфреймов
Обычно на русский язык термин "мейнфрейм" переводится как "большая ЭВМ универсального назначения". Однако нам представляется, что в настоящее время такое определение уже не является точным. Современные мейнфреймы не универсальны. Они специализированы как компьютеры для обработки больших и сверхбольших объемов данных или как суперсерверы. Название одного из поколений мейнфреймов IBM ESA (Enterprise System Architecture - архитектура систем масштаба предприятия) достаточно точно отражает такую специализацию
Мейнфреймы фирмы IBM [7] имеют почти 40-летнюю историю развития, причем, развитие это протекало эволюционно, во всяком случае, с точки зрения пользователей. При любых изменениях в аппаратной архитектуре каждое следующее поколение мейнфреймов обеспечивало выполнение программного обеспечения, разработанного для предшествующих поколений, почти в полном объеме.
За время существования мейнфреймов неоднократно высказывались и приобретали широкую популярность заявления об их устаревании и скорой кончине, однако, всегда "эти слухи оказывались несколько преувеличенными", и мейнфреймы продолжали существовать и развиваться. В настоящее время в технологиях обработки информации возрастает потребность в существенно централизованных решениях, и новое поколение мейнфреймов оказывается востребованным, как никогда раньше.
Семейство мейнфреймов IBM System/360, появившееся в начале 60-х годов, стало значительной вехой в истории вычислительной техники. Во-первых, это были первые ЭВМ, которые начали выпускаться серийно, а не по индивидуальным проектам, во-вторых, они стали первым семейством ЭВМ, то есть набором моделей с разной производительностью и разной стоимостью, но с переносимостью программного обеспечения с одной модели на другую. Семейство IBM System/360 строилось на базе CISC-процессоров с богатым набором команд и несколькими режимами адресации. Эти процессоры, однако, не поддерживали динамическую трансляцию адресов, поэтому программное обеспечение работало с реальной памятью, привязка адресов осуществлялась при загрузке. (Точнее - во время выполнения, в момент загрузки "базовых" регистров, но загруженная в реальную память программа уже не могла быть перемещена.) Размер адресной шины составлял 24 бит, что позволяло адресовать 16 Мбайт памяти - реальной и виртуальной. Чрезвычайно сильным свойством IBM System/360 явилась архитектура каналов ввода-вывода [8] (см. главу 6 части I). Достоинства мейнфреймов IBM System/360 определили ведущее положение этого семейства на рынке вычислительной техники в течение всех 60-х и начала 70-х годов, и первое время конкуренты IBM, вынуждены были делать собственные компьютеры программно совместимыми с IBM System/360.
Следующим поколением мейнфреймов стало семейство IBM System/370. Принципиальным отличием его от предыдущего поколения явилось введение динамической трансляции адресов. Применялась сегментно-страничная модель трансляции, во всех ОС этого поколения каждому процессу выделялся