Организация информации
Машинное
e
Источник: [5].
Здесь нужно заметить, что характеристики плавающего числа двойной точности будут зависеть от той арифметики, которая используется на конкретной ЭВМ.
Пример
Запишем число 15,375 в двоичном виде:
15.375 = 1111.0112 1.111011*2112
Тогда согласно стандарту IEEE число будет представляться:
single
15,375 = 0 1000.0001.0 111.0110.0000.0000.0000.00002 = 4176000016
long double
15,375 = 0 1000.0000.00010. 1110.1100.0000.0000. … 00002 = 402ЕС0000000000016.
Источник: [5].
Особенности плавающей арифметики могут существенно влиять на результаты расчётов, вплоть до того, что погрешность может сделать невозможным получение какого-либо результата вообще, поэтому знание деталей реализации арифметики плавающих чисел является необходимым для программистов.
Пример
Существует особая характеристика плавающей арифметики – машинное эпсилон. Это число, которое определяется как
 .
Для плавающего числа единичной точности (по IEEE стандарту):
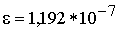 .
Это значит, если написать программу на языке BASIC:
a=1.2
b=1.e-7
print a+b
то результат, который выдаст программа, будет равен 1.2.
Поэтому программы, учитывающие особенности плавающей арифметики могут трактовать все числа, меньшие, чем машинное эпсилон, практически равными нулю.
Цифровое представление изображений
Под изображением будем понимать прямоугольную область, закрашенную непрерывно изменяющимся цветом. Поэтому для представления изображений в целых числах необходимо отдельно дискретизировать прямоугольную область и цвет.
Для описания области она разбивается на множество точечных элементов – пикселов [pixel]. Само множество называется растром [bit map, dot matrix, raster] (см. рис. 1.3), а изображения, которые формируются на основе растра, называются растровыми.
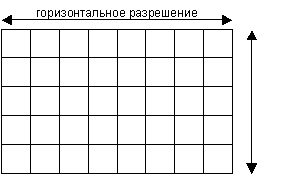 |
Рис.4. Дискретизация области изображения
Число пикселов называется разрешением [resolution]. Часто встречаются значения 640х480, 800х600, 1024х768, 1280х1024. Каждый пиксел нумеруется, начиная с нуля слева направо и сверху вниз.
Для представления цвета используются цветовые модели. Цветовая модель [color model] это правило, по которому может быть вычислен цвет. Самая простая цветовая модель – битовая. В ней для описания цвета каждого пиксела (чёрного или белого) используется всего один бит. Для представления полноцветных изображений используются несколько более сложных моделей. Известно, что любой цвет может быть представлен как сумма трёх основных цветов: красного, зелёного и синего. Если интенсивность каждого цвета представить числом, то любой цвет будет выражаться через набор из трёх чисел. Так определяется наиболее известная цветовая RGB-модель. На каждое число отводится один байт. Так можно представить 224 цвета, то есть примерно 16,7 млн. цветов. Белый цвет в этой модели представляется как (1,1,1), чёрный – (0,0,0), красный (1,0,0), синий (0,0,1). Жёлтый цвет является комбинацией красного и зелёного и потому представляется как (1,1,0).
Пример
Пусть имеется изображение вида
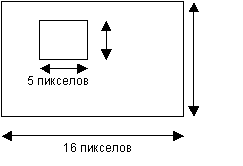 |
Будем считать, что белый цвет представляется нулём, а чёрный – единицей, тогда в однобитовой модели такое изображение представится в виде:
0000000000000000
0000000000000000
0000111110000000
0000100010000000
0000100010000000
0000111110000000
0000000000000000
0000000000000000
В шестнадцатеричном виде этот двоичный набор будет выглядеть так:
00 00 00 00 0F 80 08 80 08 80 0F 80 00 00 00 00
Всего для хранения такого изображения потребуется 16 байт.
Данное изображение легко преобразовать в RGB-модель. Достаточно заменить все нули тройками (1,1,1), а все единицы - тройками (0,0,0). Тогда получим следующее шестнадцатеричное представление изображения:
FF FF FF FF FF FF FF FF FF FF FF FF FF F0 00 1F FF FF
FF F1 FF 1F FF FF FF F1 FF 1F FF FF FF F0 00 1F FF FF
FF FF FF FF FF FF FF FF FF FF FF FF
Для хранения такого изображения потребуется 48 байт.
Цветовая модель RGB [Red-Green-Blue] была стандартизирована в 1931 г. и впервые использована в цветном телевидении. Модель RGB является аддитивной моделью, то есть цвет получается в результате сложения базовых цветов. Существуют и другие цветовые модели, которые для ряда задач оказываются более предпочтительными, чем RGB-модель. Например, для представления цвета в принтере используется субтрактивная CMY-модель [Cyan-Magenta-Yellow], цвет в которой получается в результате вычитания базовых цветов из белого цвета. Белому цвету в этой модели соответствует (0,0,0), чёрному - (1,1,1), голубому - (1,0,0), сиреневому - (0,1,0), жёлтому - (0,0,1). В цветовой модели HSV [Hue-Saturation-Value] цвет представляется через цвет, насыщенность и значение, а в модели HLS [Hue-Lightness-Saturation] через оттенок, яркость и насыщенность. Современные графические редакторы, как правило, могут работать с несколькими цветовыми моделями.
Цифровое представление звука
Звук можно описать в виде совокупности синусоидальных волн определённых частоты и амплитуды. Частота волны определяет высоту звукового тона, амплитуда – громкость звука. Частота измеряется в герцах (Гц [Hz]). Диапазон слышимости для человека составляет от 20 Гц до 17000 Гц (или 17 кГц).
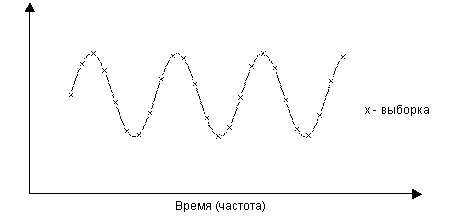 |
Рис. 5. Дискретизация звукового сигнала
Задача цифрового представления звука, таким образом, сводится к задаче описания синусоидальной кривой. Принцип такого представления изображён на рис. 1.5.
Каждой дискретной выборке присваивается целое число – значение амплитуды. Количество выборок в секунду называется частотой выборки [sampling rate]. Количество возможных значений амплитуды называется точностью выборки [sampling size]. Таким образом, звуковая волна представляется в виде ступенчатой кривой. Ширина ступеньки тем меньше, чем больше частота выборки, а высота ступеньки тем меньше, чем больше точность выборки.
Пример
Возможности наиболее распространённой современной аппаратуры предусматривают работу с частотой выборки до 44,1 кГц, что позволяет правильно описывать звук частотой до 22,05 кГц. Точность выборки имеет всего два значения 8 бит и 16 бит. То есть для представления амплитуды 8-битного звука используется 28 = 256 уровней амплитуды.
Сжатие данных
Внутреннее представление данных характеризуется избыточностью. Например, при кодировании символов русского алфавита можно учесть частоту, с которой эти символы встречаются в предложениях русского языка. Тогда для цифрового представления текста потребуется меньшее количество информации. Объём данных имеет большое значение не только для хранения, но также непосредственно влияет на скорость передачи данных по каналам вычислительных сетей. Поэтому были разработаны специальные методы (алгоритмы сжатия данных [data compression]), с помощью которых можно существенно уменьшить объём данных. Существуют как универсальные алгоритмы, которые рассматривают данные как простую последовательность битов, так и специализированные, которые предназначены для сжатия данных определённого типа (изображений, текста, звука и видео). Эффективность сжатия характеризуется коэффициентом сжатия [compression ratio], который определяется как отношение размера исходных данных к размеру сжатых. В некоторых случаях этот коэффициент достигает значения 10.
Пример
Рассмотрим принцип сжатия простейшего универсального RLE-метода. Для этого рассмотрим представление изображения, полученного в примере выше.
Особенность данного представления заключается в том, что в нём содержатся длинные последовательности подряд идущих нулей или единиц. В RLE-методе предлагается ставить сначала значение числа повторений, а затем повторяющегося числа. Тогда сжатое закодированное изображение получит вид:
С4 00 0F 80 08 80 08 80 0F 80 С4 00
Здесь число С используется как признак последовательности одинаковых символов. То есть С4 означает, что далее идёт последовательность из 4 символов. Размер хранимого изображения уменьшился с 16 до 12 байт. Коэффициент сжатия равен 1,33. Эффективность сжатия будет зависеть от размера и содержания изображения. Если то же самое изображение преобразовать в цветовую RGB-модель, то в сжатой форме оно получит вид:
СD FF F0 00 1F C3 FF F1 FF 1F C3 FF F1 FF 1F C3 FF F0 00 1F CE FF
То есть вместо 48 байт сжатое изображение занимает 22 байта, а коэффициент сжатия равен 2,18.
Алгоритмы сжатия широко применяются для более компактного хранения изображений. Для этого было разработано большое число графических форматов растровых изображений.
Пример
Наиболее популярными являются графические форматы: BMP [Bit MaP], PCX, GIF [Graphics Interchange Format], TIFF [Tagged Image File Format], JPEG [Joint Photographic Experts Group], которые по существу различаются между собой используемыми методами сжатия. Форматы BMP и PCX используют RLE-алгоритм, форматы GIF и TIFF – LZW-алгоритм, JPEG использует одноимённый алгоритм сжатия.
Звук и видео также требуют для своего цифрового представления очень большого объёма памяти, поэтому без алгоритмов сжатия работа с видео и звуковыми данными была бы невозможной. Фактическим стандартом для представления звука стал формат MP3, а для представления видеоданных – формат MPEG.
Внешнее представление данных
Файлы и каталоги
Любые данные, представленные в виде совокупности целых чисел, хранятся в памяти ЭВМ в виде файлов. Файл [file] – именованная целостная совокупность данных, причём не имеет значения, каких именно данных. Для файла данные – это лишь набор целых чисел в двоичной форме, поэтому файл – это просто последовательность байтов. Для пользователя имеют значение лишь два признака, которые характеризуют файл как таковой: имя файла и его размер. Размер файлов измеряется в байтах.
Рис. 6. Дерево каталогов
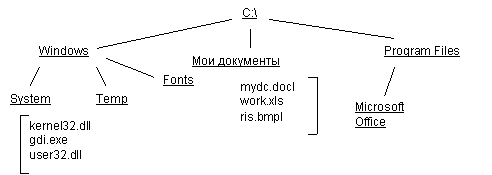 |
Как правило, файлы сортируются пользователем согласно определённым признакам по группам. Список такой группы называется каталогом [directory]. Таким образом, организуется особая иерархическая структура – дерево каталогов (см. рис. 1.6 – имена каталогов подчёркнуты).
Вершина такого дерева называется корневым каталогом [root directory]. Имя корневого каталога всегда строго определено (на рис. 1.6 - C:) и зависит от файловой системы (см. тему 3).
Модели и базы данных
Многие объекты в конкретных прикладных задачах могут быть представлены не в двоичной форме, а в виде сложной информационной структуры. Например, чертёж детали можно представить в виде совокупности отрезков прямых. Тогда в памяти ЭВМ нужно будет хранить не растр, а совокупность вещественных чисел, описывающих координаты концов отрезков.
Формализованное описание информационных структур и операций над ними называется моделью данных [data model].
Пример
Например, для описания шрифтов применяются три модели: битовая, векторная и true-type. Рассмотрим, как можно представить символ «С» с помощью битовой модели.
Битовая модель использует тот же принцип, что и битовая цветовая модель для растровых изображений. Каждому символу отводится матрица фиксированного размера. Пусть матрица имеет размер 8х10:

После такого графического представления символа, его можно описать десятью числами, размером 1 байт каждое:
00 3С 66 С0 С0 С0 66 3С 00 00
Такие описания составляются для всех символов алфавита, цифр, знаков препинания и помещаются в один файл – файл битового шрифта. Все символы, которые выводятся в текстовом режиме, представлены посредством битовых шрифтов и записаны в ПЗУ.
Рассмотренное в примерах выше изображение можно представить через описание четырёх отрезков прямых линий, задавая координаты концов отрезков:
(4,2-8,2) (4,2-4,5) (4,5-8,5) (8,5-8,2)
Для такого описания требуется 16 чисел. В результате появляется возможность различных геометрических преобразований изображения (масштабирование, повороты, растяжения и др.). Такой способ описания изображений называется векторным и широко используется в проектировании. Но нужно чётко понимать, что при выводе на экран монитора данное изображение будет представлено в растровой форме.
В реальных задачах для описания данных требуется очень много файлов, причём данные, содержащиеся в этих файлах, некоторым образом связаны между собой. Например, описание информации по деятельности некоторой судоходной компании будет включать в себя технические данные по судам компании, дислокацию судов, данные по участкам водных путей, размерам канальных и портовых сборов, данные по фрахтовым ставкам, данные для определения эксплуатационных расходов по каждому судну и т.д. Поэтому управление файлами в таких случаях оказывается очень сложным. Чтобы преодолеть эти сложности, исходные данные должны быть организованы в базу данных [data base] – совокупность взаимосвязанных данных, сохраняемых и управляемых в соответствии с некоторыми правилами. Эти правила также называются моделью данных. Конкретное построение базы данных и используемая модель данных определяются решаемой задачей.
Пример
Существуют несколько моделей данных: сетевая, иерархическая, реляционная, объектно-ориентированная. В последнее время наиболее широко используемой является реляционная модель данных. Согласно этой модели все данные организуются в совокупность связанных таблиц. Вопросы, связанные с проектированием баз данных изучаются в специальном курсе «Базы и банки данных».
Обработка данных
Понятие программы
Решение задачи на ЭВМ – это процесс получения результатных данных на основе обработки исходных с помощью программы.
Программа [program, routine] – это просто последовательность команд, понятных ЭВМ, или машинных команд. Машинные команды [computer instruction] представляют собой целые числа, принимая которые, ЭВМ производит строго определённые действия. Набор этих команд зависит от конкретной ЭВМ и носит название машинного языка [computer (machine) language]. Машинные команды, как и данные, хранятся в файлах, однако, файлу с командами можно передать управление компьютером. Такие файлы также называют программами.
Пример
Пусть в некотором файле записана следующая последовательность чисел:
B8 05 03 BB-00 00 CD 16-CD 20
Если запустить этот файл на исполнение (то есть передать ему управление ЭВМ) на ЭВМ с процессором Pentium в ОС Windows95, то клавиатура будет работать быстрее. Всего в данной последовательности закодировано четыре машинных команды.
Понятие алгоритма и алгоритмического языка
Любая программа составлена в соответствии с некоторым алгоритмом. Алгоритм [algorithm] – это конечный набор предписаний, для которого указано, как и в какой последовательности эти предписания необходимо применять к исходным данным задачи, чтобы получить её решение. Алгоритм – это общий метод решения задачи, конкретное выражение которого будет оформлено в виде программы. Алгоритм даёт возможность чисто механически решать любую задачу из некоторого класса однотипных задач. Алгоритм может быть описан различными способами: формульно, графически, посредством некоторого алгоритмического языка. Алгоритмический язык [algorithmic language] – система обозначений, предназначенная для точного описания алгоритмов для ЭВМ и ли достаточная для автоматического нахождения таких алгоритмов. Такие языки являются искусственными языками со строго определёнными синтаксисом и пунктуацией, поэтому они не допускают свободного толкования для своих конструкций, как это характерно для естественного языка. Существует большое количество языков программирования, предназначенных