Лекции по количественной оценке информации
Кроме общего понятия избыточности существуют частные виды избыточности.
Избыточность, обусловленная неравновероятным распределением символов в сообщении,
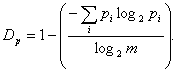 (46)
Избыточность, вызванная статистической связью между символами сообщения,
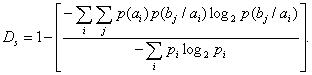 (47)
Полная информационная избыточность
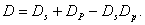 (48)
Избыточность, которая заложена в природе данного кода, получается в результате неравномерного распределения в сообщениях качественных признаков этого кода и не может быть задана одной цифрой на основании статистических испытаний.
Так при передаче десятичных цифр двоичным кодом максимально загруженными бывают только те символы вторичного алфавита, которые передают значения, являющиеся целочисленными степенями двойки. В остальных случаях тем же количеством символов может быть передано большее количество цифр (сообщений). Например, тремя двоичными разрядами мы можем передать и цифру 5, и цифру 8, т. е. на передачу пяти сообщений тратится столько же символов, сколько тратится и на восемь сообщений.
Фактически для передачи сообщения достаточно иметь длину кодовой комбинации
 ,
где N - общее количество передаваемых сообщений.
L можно представить и как
 ,
где  и —соответственно качественные признаки первичного и вторичного алфавитов. Поэтому для цифры 5 в двоичном коде можно записать
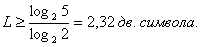
Однако эту цифру необходимо округлить до ближайшего целого числа, так как длина кода не может быть выражена дробным числом. Округление, естественно, производится в большую сторону. В общем случае, избыточность от округления

где 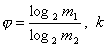 — округленное до ближайшего целого числа значение . Для нашего примера
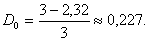
Избыточность — не всегда нежелательное явление. Для повышения помехоустойчивости кодов
избыточность необходима и ее вводят искусственно в виде добавочных  символов (см. тему
6). Если в коде всего п разрядов и
 из них несут
информационную нагрузку, то
 =
 характеризует абсолютную
корректирующую избыточность, а величина
 характеризует относительную
корректирующую избыточность.
Информационная избыточность - обычно явление естественное, заложена она в первичном алфавите. Корректирующая избыточность - явление искусственное, заложена она в кодах, представленных во вторичном алфавите.
Наиболее эффективным способом уменьшения избыточности сообщения является построение оптимальных кодов.
Оптимальные коды[5] - коды с практически нулевой избыточностью. Оптимальные коды имеют минимальную среднюю длину кодовых слов - L. Верхняя и нижняя границы L определяются из неравенства
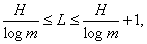 (49)
где Н - энтропия первичного алфавита, т - число качественных признаков вторичного алфавита.
В случае поблочного кодирования, где каждый из блоков состоит из М независимых букв , минимальная средняя длина кодового блока лежит в пределах
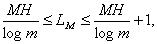 (50)
Общее выражение среднего числа элементарных символов на букву сообщения при блочном кодировании
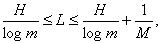 (51)
С точки зрения информационной нагрузки на символ сообщения поблочное кодирование всегда выгоднее, чем побуквенное.
Суть блочного кодирования можно уяснить на примере представления десятичных цифр в двоичном коде. Так, при передаче цифры 9 в двоичном коде необходимо затратить 4 символа, т. е. 1001. Для передачи цифры 99 при побуквенном кодировании - 8, при поблочном - 7, так как 7 двоичных знаков достаточно для передачи любой цифры от 0 до 123; при передаче цифры 999 соотношение будет 12 - 10, при передаче цифры 9999 соотношение будет 16 - 13 и т. д. В общем случае «выгода» блочного кодирования получается и за счет того, что в блоках происходит выравнивание вероятностей отдельных символов, что ведет к повышению информационной нагрузки на символ.
При построении оптимальных кодов наибольшее распространение нашли методики Шеннона—Фано и Хаффмена.
Согласно методике Шеннона - Фано построение оптимального кода ансамбля из сообщений сводится к следующему:
1-й шаг. Множество из сообщений располагается в порядке убывания вероятностей.
2-й шаг. Первоначальный ансамбль кодируемых сигналов разбивается на две группы таким образом, чтобы суммарные вероятности сообщений обеих групп были по возможности равны. Если равной вероятности в подгруппах нельзя достичь, то их делят так, чтобы в верхней части (верхней подгруппе) оставались символы, суммарная вероятность которых меньше суммарной вероятности символов в нижней части (в нижней подгруппе).
3-й шаг. Первой группе присваивается символ 0, второй группе символ 1.
4-й шаг. Каждую из образованных подгрупп делят на две части таким образом, чтобы суммарные вероятности вновь образованных подгрупп были по возможности равны.
5-й шаг. Первым группам каждой из подгрупп вновь присваивается 0, а вторым - 1. Таким образом, мы получаем вторые цифры кода. Затем каждая из четырех групп вновь делится на равные (с точки зрения суммарной вероятности) части до тех пор, пока в каждой из подгрупп не останется по одной букве.
Согласно методике Хаффмена, для построения оптимального кода N символы первичного алфавита выписываются в порядке
убывания вероятностей. Последние  символов, где [6] и - целое число, объединяют в некоторый новый символ с вероятностью, равной сумме вероятностей
объединенных символов Последние символы с учетом образованного символа вновь объединяют, получают новый, вспомогательный символ, опять выписывают символы в
порядке убывания вероятностей с учетом вспомогательного символа и т. д. до тех пор, пока сумма вероятностей т оставшихся символов после -го выписывания в порядке убывания вероятностей не даст в сумме вероятность, равную 1. На практике обычно, не производят многократного
выписывания вероятностей символов с учетом вероятности вспомогательного символа, а обходятся элементарными геометрическими построениями, суть которых
сводится к тому, что символы кодируемого алфавита попарно объединяются в новые символы, начиная с символов, имеющих наименьшую вероятность. Затем с учетом
вновь образованных символов, которым присваивается значение суммарной вероятности двух предыдущих, строят кодовое дерево, в вершине которого стоит
символ с вероятностью 1. При этом отпадает необходимость в упорядочивании символов кодируемого алфавита в порядке убывания вероятностей.
Построенные по указанным выше (либо подобным) методикам коды с неравномерным распределением символов, имеющие минимальную среднюю длину кодового слова, называют оптимальным, неравномерным, кодами (ОНК). Равномерные коды могут быть оптимальными только для передачи сообщений с равновероятным распределением символов первичного алфавита, при этом число символов первичного алфавита должно быть равно целой степени числа, равного количеству качественных признаков вторичного алфавита, а в случае двоичных кодов - целой степени двух.
Максимально эффективными будут те ОНК, у которых
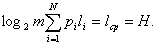
Для двоичных кодов
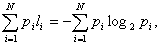 (52)
так как log22 = 1. Очевидно, что равенство (52) удовлетворяется при условии, что длина кода во вторичном алфавите
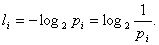
Величина  точно равна Н,
если
 , где п - любое целое число. Если п не является целым числом для всех значений букв
первичного алфавита, то
 и, согласно основной
теореме кодирования[7], средняя длина кодового слова приближается к энтропии источника сообщений по мере
укрупнения кодируемых блоков.
Эффективность ОНК. оценивают при помощи коэффициента статистического сжатия:
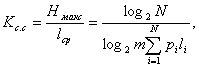 (53)
который характеризует уменьшение количества двоичных знаков на символ сообщения при применении ОНК по сравнению с применением методов нестатистического кодирования и коэффициента относительной эффективности
 (54)
который показывает, насколько используется статистическая избыточность передаваемого сообщения.
Для наиболее общего случая неравновероятных и взаимонезависимых символов
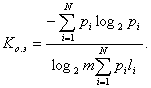
Для случая неравновероятных и взаимозависимых символов
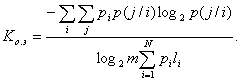
ТЕМА 6. ОБНАРУЖЕНИЕ И ИСПРАВЛЕНИЕ ОШИБОК В СООБЩЕНИЯХ
Понятие об идее коррекции ошибокДля того чтобы в принятом сообщении можно было обнаружить ошибку это сообщение должно обладать некоторой избыточной информацией, позволяющей отличить ошибочный код от правильного Например, если переданное сообщение состоит из трех абсолютно одинаковых частей, то в принятом сообщении отделение правильных символов от ошибочных может быть осуществлено по результатам накопления посылок одного вида, например 0 или 1. Для двоичных кодов этот метод можно проиллюстрировать следующим примером:
10110 - переданная кодовая комбинация;
10010 - 1-я принятая комбинация;
10100 - -я принятая комбинация;
00110 - 3-я принятая комбинация;
10110 - накопленная комбинация.
Как видим, несмотря на то, что во всех трех принятых комбинациях были ошибки, накопленная не содержит ошибок[8].
Принятое сообщение может также состоять из кода и его инверсии. Код и инверсия посылаются в канал связи как одно целое. Ошибка на приемном конце выделяется при сопоставлении кода и его инверсии.
Для того чтобы искажение любого из символов сообщения привело к запрещенной комбинации, необходимо в коде выделить комбинации, отличающиеся друг от друга в ряде символов, часть из этих комбинаций запретить и тем самым ввести в код избыточность. Например, в равномерном блочном коде считать разрешенными кодовые комбинации с постоянным соотношением нулей и единиц в каждой кодовой комбинации. Такие коды получили название кодов с постоянным весом. Для двоичных кодов число кодовых комбинаций в кодах с постоянным весом длиной в п символов равно
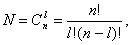 (55)
где  - число единиц в кодовом слове. Если бы не
существовало условия постоянного веса, то число комбинаций кода могло бы быть гораздо большим, а именно . Примером кода с постоянным весом может служить стандартный телеграфный код № 3 (см. приложение
4). Комбинации этого кода построены таким образом, что на 7 тактов, в течение которых должна быть принята одна кодовая комбинация, всегда приходятся три
токовые и четыре безтоковые посылки. Увеличение или уменьшение количества токовых посылок говорит о наличии ошибки.
Еще одним примером введения избыточности в код является метод суть которого состоит в том, что к исходным кодам добавляются нули либо единицы таким образом, чтобы сумма их всегда. была четной или нечетной. Сбой любого одного символа всегда нарушит условие четности (нечетности), и ошибка будет обнаружена. В этом случае комбинации друг от друга должны отличаться минимум в двух символах, т. е. ровно половина комбинаций кода является запрещенной (запрещенными являются все нечетные комбинации при проверке на четность или наоборот).
Во всех упомянутых выше случаях сообщения обладают избыточной информацией. Избыточность сообщения говорит о том, что оно могло бы содержать большее количество информации, если бьг не многократное повторение одного и того же кода, не добавление к коду его инверсии, не несущей никакой информации, если бы. не искусственное запрещение части комбинаций кода и т. д. Но все перечисленные виды избыточности приходится вводить для того, чтобы можно было отличить ошибочную комбинацию от правильной.
Коды без избыточности обнаруживать, а тем более исправлять ошибки не могут[9]. Минимальное количество символов, в которых любые две комбинации кода отличаются друг от друга, называется кодовым расстоянием. Минимальное количество символов, в которых все комбинации кода отличаются друг от друга, называется минимальным кодовым расстоянием. Минимальное кодовое расстояние - параметр, определяющий помехоустойчивость кода и заложенную в коде избыточность. Минимальным кодовым расстоянием определяются корректирующие свойства кодов.
В общем случае для обнаружения r ошибок минимальное кодовое расстояние
 (56)
Минимальное кодовое расстояние, необходимое для одновременного обнаружения и исправления ошибок,
 (57)
где s - число исправляемых ошибок.
Для кодов, только исправляющих ошибки,
 (58)
Для того чтобы определить кодовое расстояние между двумя комбинациями двоичного кода, достаточно просуммировать эти комбинации по модулю 2 и подсчитать число единиц в полученной комбинации.
Понятие кодового расстояния хорошо усваивается на примере построения геометрических моделей кодов. На геометрических моделях в вершинах n-угольников, где n-значность кода, расположены кодовые комбинации, а количество ребер n-угольника, отделяющих одну комбинацию от другой, равно кодовому расстоянию.
Если кодовая комбинация двоичного кода А отстоит от кодовой комбинации В на расстоянии d, то это значит, что в коде А
нужно d символов заменить на обратные, чтобы получить код В, но это не означает, что нужно d добавочных символов, чтобы код обладал данными корректирующими
свойствами. В двоичных кодах для обнаружения одиночной ошибки достаточно иметь 1 дополнительный символ независимо от числа информационных разрядов кода, а
минимальное кодовое расстояние 
Для обнаружения и исправления одиночной ошибки соотношение между числом информационных разрядов и числом корректирующих разрядов должно удовлетворять следующим условиям:
 (59)
 60)
при этом подразумевается, что общая длина кодовой комбинации
 .
(61)
Для практических расчетов при определении числа контрольных разрядов кодов с минимальным кодовым расстоянием удобно пользоваться выражениями:
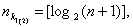 (62)
если известна длина полной кодовой комбинации п,