Теория искусственного интеллекта
4. Действие – РП подвергается изменению путем добавления в нее заключения сработавшего правила. Если в правой части правила содержится указание на какое-либо действие, то оно выполняется.
Интерпретатор (МВ) работает циклически. В каждом цикле он просматривает все правила, чтобы выявить те, которые совпадают с известными на данный момент фактами из РП. После выбора правило срабатывает, его заключение заносится в РП, и цикл повторяется снова. В одном цикле может сработать только одно правило.
Если несколько правил успешно сопоставлены с фактами, то МВ производит выбор по определенному критерию единственного правила, которое срабатывает в данном цикле.
Цикл работы МВ показан на рис.
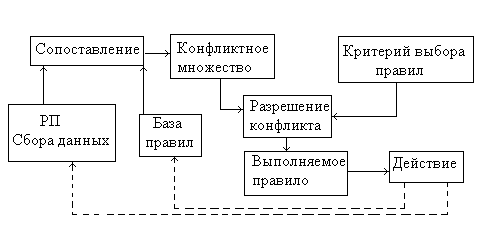
Работа МВ зависит только от состояния РП и от состава базы знаний. На практике обычно учитывается история работы, т.е поведение МВ запоминается в памяти состояний, которая содержит протокол системы. (рис. ).
Пример:
П1. Если (отдых летом) И (человек активный)
ТО (ехать в горы)
П2. Если (любит солнце) ТО (отдых летом)
Предположим, что в систему поступили факты: человек активный и любит солнце.
1-проход.
Шаг 1. Пробуем П!, не работает (не хватает данных – отдых летом)
Шаг 2. Пробуем П2, работает, б базу поступает факт – отдых летом.
2-й проход.
Шаг 3. Пробуем П1, работает. Активизируется цель (ехать в горы), которая выступает как совет.
Стратегия управления выводом.
От метода поиска зависит порядок применения и срабатывания правил. Процедура выбора сводится к определению направления поиска и способа его осуществления.
Прямой и обратный вывод. В системах с прямым выводом по известным фактам отыскивается заключение, которое следует из этих фактов. Если такое заключение найдено, то оно заносится в РП. Такой вывод называют выводом, управляемым данными.
При обратном выводе вначале выдвигается гипотеза, а затем МВ как бы возвращается назад, переходя к фактам, пытаясь найти те, которые подтверждают гипотезу. Если она правильна, то выдвигается следующая гипотеза, детализирующая первую и являющуюся по отношению к ней подцелью. Далее отыскиваются факты, подтверждающие истинность подчиненной гипотезы. Вывод такого типа называется управляемым целями. Применяется в тех случаях, когда цели известны и их сравнительно немного.
В системах с более сотен правил желательно использовать стратегию управления выводом, позволяющую минимизировать время поиска решения и тем самым повысить эффективность работы системы. К числу таких стратегий относятся поиск в глубину, поиск в ширину, разбиение на подзадачи и альфа-бета стратегия.
При поиске в глубину в качестве подцели выбирается та, которая соответствует следующему, более детальному уровню описания задачи.
При поиске в ширину анализируются все начальные варианты. Разбиение на подзадачи заключается в выделении подзадач, решение которых рассматривается как достижение промежуточных целей. Альфа-бета стратегия заключается в удалении ветвей, неперспективных для успешного поиска.
Работа продукционной системы инициируется начальным описанием (состоянием) задачи. Из продукционного множества правил выбираются правила, пригодные для применения на очередном шаге. Эти правила могут создавать так называемое конфликтное множество. Для выбора правил из конфликтного множества существуют стратегии разрешения конфликтов, которые могут быть достаточно простыми, например, выбор первого правила. Могут быть и сложными эвристическими правилами. Следует отметить, что конфликтные множества представляют собой простейшие базы целей.
Кроме базовой структуры продукционных систем необходимы дополнительные средства – управление данными, уточняющими смысл:
Триплет: объект – атрибут (необходимый признак) – значение;
Пример; робот – степень подвижности – 4.
Четверка: – атрибут (необходимый признак) – значение – степень достоверности.
Пример: сверло – материал Р!* - стойкость 25 мин. – достоверность 0,7.
Условная часть может состоять из одного или нескольких условий, соединенных связкой И. Заключительная часть показывает данные, которыми следует пополнить РП при выполнении условной части. На практике при необходимости расширяют эти правила. Например, используют связку ИЛИ. В условной части, вводят условную часть с вычислениями на основании содержимого РП, либо вводят заключительную часть с пометкой – не дополнять содержимое РП.
Визуально такое отношение можно представить в виде графа с древовидной структурой (рис. ).
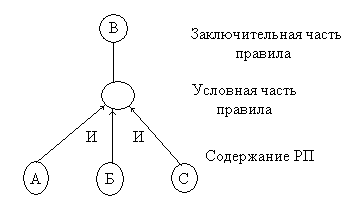
Если существует множество правил, из которых выводится одно и то же заключение, то выполняется процедура ИЛИ над всеми заключениями из этих правил. Таким образом всю систему продукций можно представить в виде одного графа И/ИЛИ (рис. ).
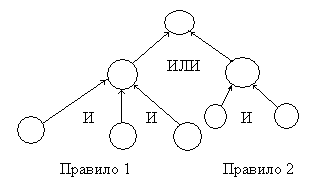
Система, реализующая прямую цепочку рассуждений, на основании имеющихся условий делает возможным логические выводы. Система, реализующая обратную цепочку рассуждений по имеющимся выводам, ищет необходимые для них условия.
По такому графу обратный вывод – это поиск пути на графе. Управление последовательностью поиска осуществляется механизмом вывода. Могут быть использованы различные стратегии поиска. Используются также системы с двунаправленными выводами, где сначала оценивается небольшой объем полученных данных и выбирается гипотеза (прямой вывод), а затем запрашиваются данные для принятия решения о пригодности данной гипотезы.
Для повышения эффективности функционирования ИС в проблемной области с увеличением числа правил используются методы группирования, упорядочения информации в РП, предварительной компиляции правил в виде графа.
Пример работы продукционной системы. Рассматривается роботизированный участок.
Правило 1: ЕСЛИ (станок без заготовки) (1)
И (заготовка на накопителе) (2)
ТО (робот подает заготовку на станок) (3)
Правило 2: ЕСЛИ (накопитель подал заготовку в загрузочную позицию) (4)
ТО (заготовка в загрузочной позиции)
Действия:
Допустим, в РП вносятся 1 и 4 образцы и рассматривается возможность применения правил. Сначала МВ сопоставляет образцы из условной части правил с образцами в РП.
Если все образцы имеются в РП, то условная часть считается истинной, в противном случае – ложной. Т.к. в условной части (2) отсутствует, то условная часть правила 1 считается ложной. Но правило 2 выполняется, т.к. посылка (4) верна, поэтому МВ выполняет его заключительную часть, и образец (2) заносится в РП.
3. Вторично применяется правило 1, т.к. правило 2 уже было применено и выбыло из числа кандидатов. Т.к. (1) истина и (2) истина, то (3) – вывод. В итоге правил, которые можно было бы применить не остается и система останавливается.
4. Для описания задач часто используют дерево решений.
Семантические сети
В бытовом понимании семантика означает смысл слова, действия, художественного произведения и т.п. Семантическая сеть – это граф, вершинам которого сопоставляются понятия (объекты, процессы, явления), дуги графа – это отношения между вершинами.
Возможные отношения в семантических сетях (не полный список):
Агент – это то, что (тот, кто) вызывает действие. Агент часто является подлежащим в предложении. Например, «Иванов ударил мяч».
Объект – это то, на что (на кого) направлено действие. В предложении объект часто выполняет роль прямого дополнения. Например, «Робот взял пирамиду».
Инструмент – это средство, которое используется агентом для выполнения действия. Например, «Иванов открыл дверь с помощью ключа».
Соагент – служит как подчиненный партнер главному агенту. Например, «Иванов сдал экзамен с помощью Петрова».
Пункт отправления и пункт назначения – это отправная и конечная позиция при перемещении агента или объекта. Например, «Робот переместился от одного станка к другому».
Траектория – это перемещение от пункта отправления к пункту назначения. Например, «Они прошли через дверь по ступенькам на лестницу».
Средство доставки – то в чем или на чем происходит перемещение. Например, «Иванов всегда едет домой на машине».
Местоположение – то место, где произошло (происходит, будет происходить) действие. Например, «Он работал за столом».
Потребитель – то лицо, для которого выполняется действие. Например, «Иванов собрал шпаргалки для Кати».
Сырье – это, как правило, материал из которого что-то сделано или состоит. Обычно сырье вводится предлогом из. Например, «Иванов собрал робот из интегральных схем».
Время – указывает на момент совершения действия. Например, «Он закончил работу поздно вечером».
Пример семантической сети: Поставщик осуществил поставку изделий по заказу клиента до 1 июня 2008 г. в количестве 1000 шт.
Поиск в семантической сети: Какой объект находится на желтом блоке?
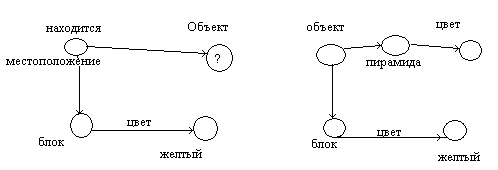
Совместив запрос с сетью получим ответ – пирамида.
Классификация сетей.
По структуре:
Сети простого типа – у которых вершины не имеют собственной внутренней структуры.
Однородные сети – при одинаковых отношениях между вершинами.
Сети иерархического типа – таким сетям свойственны структуры с вершинами разного ранга, имеющими разный уровень или подчиненность от низших к высшим.
По характеру отношений, приписываемых дугам сети:
Функциональные сети. Дуги отражают тот факт, что вершина, из которой выходит дуга, играет по отношению к вершине, куда идет дуга, роль аргумента. Описания, соответствующие вершине – функции, задают процедуру нахождения результата.
Сценарии – однородные сети, в которых в качестве единственного отношения выступает отношение нестрогого порядка (например, отношение «не раньше, чем»), которое допускает одновременность. Чаще всего эти отношения определяют все возможные последовательности событий.
Семантические сети – в отличие от двух первых – неоднородны и иерархичны.
Семантические сети делятся на интенсиональные и экстенсиональные. Интенсиональная сеть содержит интенсиональные знания и описывает общую структуру модернизируемой предметной области на основе абстрактных объектов и отношений, т.е. обобщенных представителей некоторых классов объектов и отношений. Например, такие объекты как Производственный участок, груз, деталь могут являться обобщенными понятиями множества значений от которых образуется множество имен конкретных производственных участков (токарный, прессовый и т.п.), множество имен грузов (заготовка, кассета), множество классов деталей (болт, вал, гайка и т.п.).
Экстенсиональная семантическая сеть описывает экстенсиональные знания о модернизируемых объектах, являясь как бы «фотографией» его текущего состояния.
Интенсиональная сеть предложения «Робот сверлит отверстие в детали сверлом диаметром 10 мм.
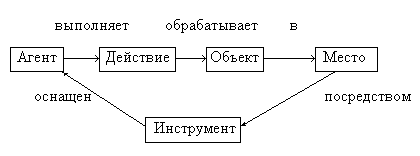
Рис. Интенсиональная сеть.
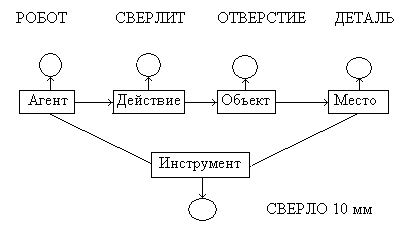
Рис. Экстенсиональная сеть.
В семантических сетях используются три основных типа объектов: понятия, события, свойства.
Понятие – это сведения об абстрактных или физических объектах предметной области. Общие понятия интерпретируются как множество параметров или констант.
События – это действия, которые могут внести изменения в предметную область .Результатом события является некоторое новое состояние предметной области. Можно задать желаемое (целевое) состояние предметной области и поставить задачу отыскания в семантической сети последовательности событий, приводящей к новому состоянию.
Свойства – используются для уточнения понятий или событий. Для понятий это особенности или характеристики (цвет, размеры, качество). Для свойств - продолжительность, время, место.
Семантические отношения делят на четыре класса: лингвинистические, логические, теоретико-множественные и квантифицированные.
Лингвинистические – наиболее употребительные – падежные, к которым относятся агент и т.п. Другой тип – это характеризация глаголов и атрибутивных отношений. К характеризации глаголов относятся наклонение, время, род, число, залог. Атрибутивные отношения – цвет, форма, размер. Например: «Большие красные шары».
Логические отношения представляют собой операции алгебры логики..
Теоретико-множественные – это подмножество, супермножество, элемент множества, отношение части и целого и др. Этот класс отношений используется для построения иерархических соподчиненных структур, для представления обобщенной информации.
Квантифицированные отношения – это логические кванторы общности и существования.. Логические кванторы применяются для представления знаний декларативного типа. Например: «каждый станок требует профилактического ремонта», «Существует робот А, который может обслуживать станки группы В».
Важным понятием в семантических сетях является десигнат – уникальное внутрисистемное имя, которое ставится в соответствие некоторому объекту в предметной области, если о нем в данный момент времени нет полной информации. Например, «Станок С1 имеет накопитель». Это предложение имеет неопределенность относительно характеристик накопителя. По мере поступления информации будут уточняться емкость накопителя и другие данные.
(F1: имеет агент Станок объект D1)
(D1: имя накопитель)
(D1: габарит ______)
(D1: емкость _______)
F1 – метка факта, D1 – метка десигната.
В момент первого напоминания вводится информация, которая используется в дальнейшем. В семантических сетях информация может представляться в фреймовом виде..
При построении интеллектуальных банков данных на основе семантических сетей основным принципом их организации является разделение экстенсиональных и интенсиональных знаний, при этом экстенсиональные семантические сети являются основой базы данных, а интенсиональные сети – основой базы знаний.
Особенности представления знаний в семантических сетях состоят в следующем:
- в семантической сети могут быть представлены такие виды объектов как понятия, события, специализированные методы решения. Увеличение номенклатуры объектов снижает однородность сети и приводит к необходимости увеличения набора механизмов и методов вывода.
- многомерность семантических сетей позволяет представить в них сложные семантические отношения, связывающие отдельные понятия, понятия и события в предложении, а также предложения в текстах.
- на каждой стадии формирования решения можно четко разделить полное знание системы (полная семантическая сеть) и текущее знание – возбуждаемый участок сети, в котором производятся некоторые операции (процесс вывода, понимания и т.п.).
Известны многие варианты семантических сетей, общие характеристики которых сводятся к следующему:
- описание объектов предметной области происходит на уровне естественного языка;
- все знания, включая вновь поступающие факты, а также специализированные методы решения, накапливаются в относительно однородной структуре памяти;
- определяется ряд более или менее унифицированных семантических отношений между объектами, которым ставятся в соответствие унифицированные методы вывода;
- запросы вместе с методами вывода определяют участки знания (семантической сети), имеющие отношение к поставленной задаче, фиксируя тем самым понимание запроса и вытекающую из него цепь выводов, соответствующих решению задачи; выводы в семантических сетях отличаются значительной полнотой.
Управление выводом.
Механизм вывода использует метод генерации выводов, так называемый «метод распространяющейся активности и техники пересечений». Процесс осуществляется построением на основе введенных высказываний цепочек возможных выводов во всех направлениях до тех пор, пока в сети не обнаружится пересечение или не найден фрагмент, отражающий поставленный запрос к базе знаний. Недостаток – сложность организации процедуры вывода. Область применения семантических сетей – системы обработки естественного языка, системы технического зрения и другие.
Фреймовое представление знаний
Все типы моделей знаний перед их применением в конкретной системе необходимо заполнить информацией, уточняющей используемые общие символы и понятия. Модель без наполнения информацией до уровня соответствия единичной реальной системе называется абстрактной.
В обычном диалоге значительная часть информации не выражается собеседником определенно и ясно (умалчивается). Предполагается, что оба собеседника хорошо знают тему разговора и нет смысла лишний раз описывать очевидные детали, которые являются стандартными для данной ситуации.
Термин фрейм (frame – рамка, остов) предложен в 1975 г. Марвеллом Минским. Фрейм – это единица представления знаний, заполненная в прошлом, детали которой могут быть изменены согласно текущей ситуации, т.е. это минимальное описание, которое еще сохраняет сущность описываемого явления и такое, что дальнейшее ее сокращение приводит к потере сущности. Получается, что фрейм – это абстрактный образ, объект или ситуация.
Фрейм отражает основные свойства объекта или явления. Информация в фреймах записывается в виде списка свойств, называемых во фрейме слотами (slot – паз, щель), таким образом, слот является основной структурной единицей фрейма.
Пример. Слова «комната» порождает у слушателя образ комнаты «жилое помещение» с четырьмя стенами, окнами и дверью, площадью 12-30 м2. Из этого описания ничего нельзя убрать (убрав окна, получаем чулан), но в нем есть «дырки» или «слоты» - это незаполненные значения некоторых атрибутов. Например, количество окон, высота потолка и т.п. В теории фреймов такой образ называется фреймом комнаты.
Слот представляет собой пару: имя слота и его значение. В качестве значения слота могут выступать константы (факты), выражения с переменными, ссылки на другие слоты и т.п.
Слот может иметь структуру, элементы которой сами являются слотами. Фрейм состоит из конечного значения слотов. Слотам фреймов могут быть приписаны по умолчанию некоторые стандартные значения. Значения, присвоенные по умолчанию, могут быть заменены значениями, подходящими для обрабатываемой ситуации.
Различают фреймы-образцы или прототипы, хранящиеся в базе знаний, и фреймы-экземпляры, которые создаются для отображения реальных фактических ситуаций на основе поступающих данных. Фрейм-прототип – это интенсиональное описание некоторого множества фреймов-примеров.
Пример фрейма-прототипа: ДАТА
(ДАТА) (месяц)(имя)(день)(целые числа){1,2…31}(год)(функция) (день недели)(перечень {понед.,….,воскр.} (функция)
В слоте (месяц) на месте значения записано ИМЯ, т.е. значением слота может быть любое буквенное выражение. Значение слота ДЕНЬ являются целые числа, причем перечень их приводится в слоте.
В качестве функции могут быть использованы любые функции языка LISP. Так, в слоте ГОД с использованием языка LISP могут быть организованы следующие процедуры. Если во входном предложении указан ГОД, то он вносится в поле значения фрейма-примера; если год не указан, то активизируется процедура, которая заполняет значение текущим годом. Такого рода функция называется «по умолчанию».
В слоте «день недели» можно организовать процедуры, которые при обработке входного сообщения будут вызываться автоматически, для проверки на непротиворечивость значения дня недели, указанного пользователем, либо вычисления этого значения.
Конкретный пример может выглядеть следующим образом:
(ISA) ДАТА)(месяц)(июнь)(день)(вторн.)
Метка ISA обозначает, что данный слот является фреймом-примером.
Модель фрейма является достаточно универсальной, т.к. существуют не только фреймы для обозначения объектов и понятий, но и другие типы:
- фреймы-сценарии, используемые для обозначения объектов и понятий (лекция, собрание, заем);
- фреймы-роли (отец, мать, менеджер, кассир, клиент);
- фреймы-сценарии (собрание акционеров, празднование дня рождения)ж
- фреймы-ситуации (тревога, авария, рабочий режим работы устройства) и другие.
Формально как модуль для отображения образа структура фрейма может быть представлена следующим образом:
(имя фрейма)
(имя 1-го слота); (значение 1-го слота)
(имя 2-го слота); (значение 2-го слота)
………………………………………….
………………………………………….
(имя N-го слота); (значение N-го слота)
Ту же запись можно представить в виде таблицы
| Имя фрейма | |||
| Имя слота | Значение слота |
Способ получения слота |
Присоединенная процедура |
Иногда применяют другой вариант:
| Имя фрейма | |||
| Имя слота |
Указатель типа данных |
значение слота |
Присоединенная процедура |
Значения столбцов этой таблицы:
1. Имя слота – идентификатор, присваиваемый фрейму; это имя – единственное в данной системе, т.е. уникальное имя.
2. Имя слота – идентификатор, присваиваемый слоту; это уникальное имя во фрейме, к которому он принадлежит. Обычно имя слота не несет никакой смысловой нагрузки, но в ряде случаев может иметь специфический смысл. В их число входят слоты IS-A или A KIND OF (орел), показывающие фрейм-родитель данного фрейма (АКО-связи), слот указателей дочерних фреймов, слоты дат изменения, имен пользователей , текста комментариев и др. Такие слоты называются системными и используются при редактировании БЗ и управлении выводом.
3.Указатель типа данных, показывает, что за значение хранится в слоте. Возможные типы значений: INTEGER – целый, REAL – действительный, BOOL – булев, указатель на другой фрейм, LISP – вызываемая процедура.
4. Значение слота – должно совпадать с указанным типом данных этого слота.
Дополнительные столбцы предназначены для описания способа получения слотом его значения и возможного присоединения к тому или иному слоту специальных процедур, которые выполняются, когда информация в слотах (значения атрибутов) меняется. С каждым слотом можно связать любое число процедур.
Процедуры должны решать следующие задачи:
1.поместить новую информацию в слот;
2.удалить информацию из слота;
3.обработать обращение к информации пока не заполненного слота.
Конкретные процедуры, включаемые в слот, делят на два типа:
- процедуры-демоны – активизируются автоматически каждый раз, когда данные попадают в соответствующий фрейм-пример или удаляются из него.
С помощью процедур этого типа автоматически выполняются все рутинные операции, связанные с ведением баз данных и знаний (обновление).
- процедуры-слуги – активизируются только по запросу. Например, если пользователь не указал год, то активизируется процедура-слуга.
Фреймы и слоты описывают ситуацию в семантических форматах. С каждым слотом фрейма связаны описания условий, которые должны быть соблюдены, чтобы могло произойти означивание слота. В более сложных случаях условия могут касаться отношения между значениями, выбираемыми сразу для нескольких слотов.
В качестве значения слота может выступать имя другого фрейма, так образуются сети фреймов.
Существуют несколько способов получения слотом значений во фрейме-экземпляре:
- по умолчанию от фрейма-образца (Delauf – значение);
- через наследование свойств от фрейма, указанного в слоте АКО;
- по формуле, указанной в слоте;
- через присоединенную процедуру;
- явно из диалога с пользователем;
- из базы данных.
Важнейшим свойством теории фреймов является заимствование из теории семантических сетей наследование свойств. Такое наследование происходит по АКО-связям (A-King-Of – это). Слот АКО указывает на фрейм более высокого уровня иерархии, откуда неявно наследуются, т.е. переносятся, значения аналогичных слотов.
Пример:
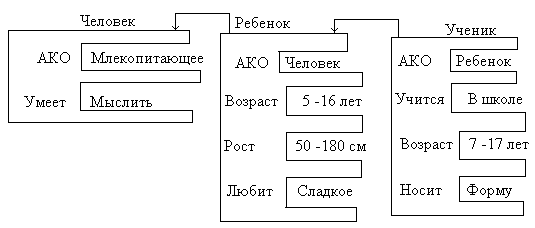
Рис.
Понятие «ученик» наследует свойства фреймов «ребенок» и «человек», которые находятся на более высоком уровне иерархии, На вопрос: «любят ли ученики сладкое?» следует ответ - «да», т.к. этим свойством обладают все дети, указанные во фрейме «ребенок».
Пример из области машиностроения:
| Станок | ||
| АКО | Изделие | |
| Функция | Резание | |
|
Серийность производства |
Серийное, индивидуальное | |
| Обрабатывающий центр | ||
| АКО | Станок | |
| Группа | Сверлильно-расточной | |
| Операции |
Сверление, фрезерование, растачивание |
|
| Управление | УЧПУ | |
| Модель 2204 ВМФ4 | ||
| АКО | Обрабатывающий центр | |
| Рабочая зона | Размеры, мм | 250*250*400 |
| Тип системы ЧПУ | Контурно-позиционная | |
| Устройство ЧПУ | Модель | 2С42 |
| Инструмент. магазин | Кол-во инструментов | 30 |
«Модель 2204 ВМФ4» наследует свойства фреймов «обрабатывающий центр» и «станок», находящиеся на более высоком уровне иерархии.
Наследование свойств может быть частичным, т.к. возраст для учеников не наследуется из фрейма «ребенок», поскольку указан в собственном фрейме.
Основным преимуществом фреймов как модели представления знаний является то, что они отражают концептуальную основу организации памяти человека, а также ее гибкость и наглядность. Концепция фреймов позволяет строить иерархические структуры фреймов. Допускается до пяти уровней вложения, что важно для организации механизма наследования.
Одна из вершин выделяется для предикатного (функционального) символа, остальные – для аргументов определенного символа. Для каждой аргументной вершины дана область допустимых значений, что позволяет интерпретировать вершину как слот. Такое определение близко к понятию факт в семантических сетях.
Конкретные фреймы:
Фрейм соединение предназначен для описания различных типов соединений, встречающихся в технических системах. «Субъект Х соединяет объект У с объектом Z способом W».
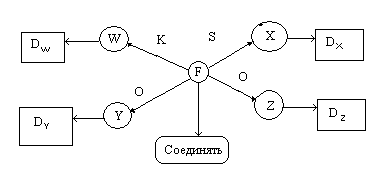
Дуги имеют метки падежных отношений: S – субъект, О – объект, К – отношение «посредством чего», Dj – области допустимых значений действующего аргумента.
Фрейм-назначение служит для описания процессов через назначение отдельных элементов, участвующих в них. «Насос (Н) перекачивает газ (Г) от источника тепла (ИТ) к теплообменнику (ТО)»
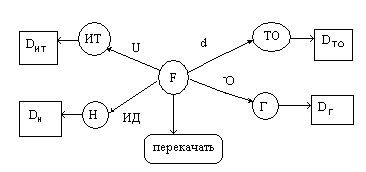
Символами И и d обозначаются падежные отношения соответственно «источник действия» и «приемник действия».
Фрейм-закон функционирования предназначен для описания аналитических законов изменения отдельных параметров во времени. Ситуация: Вычислить параметр в момент времени t с использованием функции f, имеющей аргументы a1, a2, …….an. Метки дуг Vf вид функции, - время, Гц = результат применения функции.
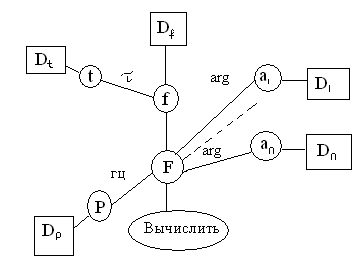
Можно выделить три основных процесса, происходящих во фреймовых системах:
1.Создание экземпляра фрейма. Для создания необходимо найти подходящий фрейм и заполнить его слоты информацией, описывающей специфику рассматриваемой ситуации.
3.Активация фреймов.
3.Организация вывода, заключающегося в процессе поиска и активации в сети фреймов до нахождения наиболее соответствующего и построение на его основе экземпляра фрейма.
В системах представления знаний, основанных на фреймах, используют три основных подхода для организации процессов обработки информации:
1) информационно-вычислительный процесс организуется пользователем с привлечением языка программирования (например LISP).
2) Для систем фреймов вводится единый вычислительный процесс, основой которого является выбор фреймов, управляющих дальнейшими вычислениями.
3) Определяются подклассы фреймов, для которых разрабатываются специфические алгоритмы, опирающиеся на индивидуальные свойства подклассов.
Специальные языки представления знаний в сетях фреймов: FRL, KRL, экспертные системы МОДУС, TRISTAN и др.
План
1. Нечеткие знания. Общие положения (Инженерия знаний и нечёткость).
1.1 Определение. Причины нечеткости знаний.
1.2 Нечёткая логика.
1.3 Нечеткие множества.
Введение
Пожалуй, наиболее поразительным свойством человеческого интеллекта является способность принимать правильные решения в обстановке неполной и нечеткой информации. Построение моделей приближенных рассуждений человека и использование их в компьютерных системах будущих поколений представляет сегодня одну из важнейших проблем науки.
Значительное продвижение в этом направлении сделано 30 лет тому назад профессором Калифорнийского университета (Беркли) Лотфи А. Заде (Lotfi A. Zadeh). Его работа "Fuzzy Sets", появившаяся в 1965 году в журнале Information and Control, № 8, заложила основы моделирования интеллектуальной деятельности человека и явилась начальным толчком к развитию новой математической теории.
Что же предложил Заде? Во-первых, он расширил классическое канторовское понятие множества, допустив, что характеристическая функция (функция принадлежности элемента множеству) может принимать любые значения в интервале (0;1), а не только значения 0 либо 1. Такие множества были названы им нечеткими (fuzzy). Л.Заде определил также ряд операций над нечеткими множествами и предложил обобщение известных методов логического вывода modus ponens и modus tollens.
Введя затем понятие лингвистической переменной и допустив, что в качестве ее значений (термов) выступают нечеткие множества, Л.Заде создал аппарат для описания процессов интеллектуальной деятельности, включая нечеткость и неопределенность выражений.
Дальнейшие работы профессора Л.Заде и его последователей заложили прочный фундамент новой теории и создали предпосылки для внедрения методов нечеткого управления в инженерную практику.
Уже к 1990 году по этой проблематике опубликовано свыше 10000 работ, а число исследователей достигло 10000, причем в США, Европе и СССР по 200-300 человек, около 1000 - в Японии, 2000-3000 - в Индии и около 5000 исследователей в Китае.
В последние 5-7 лет началось использование новых методов и моделей в промышленности. И хотя первые применения нечетких систем управления состоялись в Европе, наиболее интенсивно внедряются такие системы в Японии. Спектр приложений их широк: от управления процессом отправления и остановки поезда метрополитена, управления грузовыми лифтами и доменной печью до стиральных машин, пылесосов и СВЧ-печей. При этом нечеткие системы позволяют повысить качество продукции при уменьшении ресурсов и энергозатрат и обеспечивают более высокую устойчивость к воздействию мешающих факторов по сравнению с традиционными системами автоматического управления.
Другими словами, новые подходы позволяют расширить сферу приложения систем автоматизации за пределы применимости классической теории. В этом плане любопытна точка зрения Л.Заде: "Я считаю, что излишнее стремление к точности стало оказывать действие, сводящее на нет теорию управления и теорию систем, так как оно приводит к тому, что исследования в этой области сосредоточиваются на тех и только тех проблемах, которые поддаются точному решению. В результате многие классы важных проблем, в которых данные, цели и ограничения являются слишком сложными или плохо определенными для того, чтобы допустить точный математический анализ, оставались и остаются в стороне по той причине, что они не поддаются математической трактовке. Для того чтобы сказать что-либо существенное для проблем подобного рода, мы должны отказаться от наших требований точности и допустить результаты, которые являются несколько размытыми или неопределенными".
Смещение центра исследований нечетких систем в сторону практических приложений привело к постановке целого ряда проблем таких, как новые архитектуры компьютеров для нечетких вычислений, элементная база нечетких компьютеров и контроллеров, инструментальные средства разработки, инженерные методы расчета и разработки нечетких систем управления и многое другое.
1. Нечеткие знания
Обширной областью эффективного применения интеллектуальных систем как средства построения информационных систем нового поколения является область нечетких знаний. Это связано с тем, что во всех предметных областях существенное место занимают некорректные, нечетко формулируемые задачи и реальный человеческий способ рассуждения (опирающийся на естественный язык) не может быть описан в рамках традиционных математических формализмов, предполагающих однозначность интерпретации. Другими словами, знания чаще всего нечетки. «Для того, чтобы ИС вышли за рамки простых символьных выводов и приблизились к мышлению человека, необходимы методы представления нечетких знаний и механизмы выводов, работающие в их среде.» Исии. Возникла необходимость создания теории, позволяющей формально описывать нестрогие, нечеткие понятия и моделировать рассуждения, содержащие такие понятия.
Все недоопределённости в знаниях можно классифицировать следующим образом:
недетерминированность выводов,
многозначность,
ненадежность,
неполнота,
нечеткость или неточность. Именно этому классу уделяется внимание ниже.
1.1 Определение. Причины нечеткости знаний
Нечеткими называются такие знания, которые допускают суждения об относительной степени истинности или ложности.
Типы,