Ответы на вопросы по курсу “Системное программирование”
· первый операнд - сегментный регистр, второй - регистр общего назначения. Результат помещается в сегментный регистр, причем задание регистра CS в таком формате команды не применяется.
· первый операнд - регистр общего назначения, второй - сегментный регистр. Результат помещается в регистр общего назначения.
Команды, работающие с одним операндом, могут работать с регистрами общего назначения, адресами памяти или с сегментными регистрами.
Способы адресации операндов. В программах на Assembler применяются следующие типы адресации операндов:
· регистровая;
· прямая;
· непосредственная;
· косвенная;
· базовая;
· индексная;
· базово-индексная.
Регистровая адресация подразумевает использование в качестве операнда регистра процессора, например: push DS mov BP,SP
При прямой адресации один операнд представляет собой адрес памяти, второй - регистр: mov DATA, АХ
Непосредственная адресация применяется, когда операнд длиной в байт или слово находится в ассемблерной команде: mov AX,4Ch
При использовании косвенной адресации исполнительный адрес формируется исходя из сегментного адреса в одном из сегментных регистров и смещения в регистрах ВХ, ВР,SI или DI, например: mov АL, [ВХ], mov АН, [SI].
В случае применения базовой адресации исполнительный адрес являетсй суммой значения смещения и содержимого регистра ВР или ВХ, например:
mov АХ, [ВР + 6]
mov [ВХ + Delta], АХ
При индексной адресации исполнительный адрес определяется как сумма значений указанного смещения и содержимого регистра SI или DI так же, как и при базовой адресации, например:
mov DX, [SI+5]
mov ES: [DI]+6, AL
Базово-индексная адресация подразумевает использование для вычисления исполнительного адреса суммы содержимого базового и индексного регистров, а также смещения, находящегося в операторе, например:
mov ВХ, [BP][SI]
mov ES:[BX+DI],AX
Кэш-память – сверхоперативная память, обращение к которой намного быстрее, чем к оперативной и в которой хранятся наиболее часто используемые участки последней. При обращении к памяти сначала нужные данные ищутся в кэш-памяти. При отсутствии производится обращение к оперативной памяти, в результате общее время доступа к памяти сокращается.
Состав типичных систем команд. Комплексный набор команд и RISC – процессоры.
Программно доступные ресурсы процессора. Управление последовательностью операций. Условные и безусловные переходы. Понятие о механизме прерываний.
В процессоре, как правило, программно доступными являются большинство регистров – ячеек памяти, расположенных непосредственно на процессоре. В 8086 недоступным для непосредственного чтения и изменения является только счетчик команд IP. Остальные регистры 8088, а также 8 регистров сопроцессора доступны программисту. Изменение последовательности выполняемых операций осуществляется при выполнениии команд условного и безусловного перехода. Команды условного перехода передают управление по адресу, заданному операндом, в зависимости от состояния отдельных битов флагового регистра, кроме команды JCXZ, которая проверяет состояние регистра СХ. Модификацию флагов можно произвести как непосредственно, так и выполнив команду сравнения CMP, которая установит флаги по результату операции. Примеры команд условного перехода: JA, JE, JNE, JB, JZ, JL. Команда безусловного перехода JMP передает управление по указанному адресу.
Прерывания – специфические сигналы, посылаемые процессору устройством или программой, когда требуется его немедленное вмешательство. В этом случае он останавливает всякую другую деятельность и вызывает программу-обработчик прерывания. По окончании ее работы он продолжает прерванную работу с того места, где она остановилась.
Прерывания бывают 2 типов –
а)аппаратные (генерируются схемами ПК в ответ на какое-либо действие, например, при нажатии клавиши на клавиатуре генерируется прерывание 9). Иногда аппаратные прерывания генерируются устройством в случае некорректной работы программы, например деление на 0.
б)программные – генерируются программой для вызова различных подпрограмм из ОЗУ и ПЗУ.
Аппаратные прерывания процессор обрабатывает в порядке приоритета (важности). Прерывания, требующие немедленной реакции процессора – немаскируемые (NMI). Такие прерывания процессор обрабатывает перед всеми остальными, часто они сигнализируют об аварийных ситуациях.
Классификация объектных данных в программах на языках высокого уровня. Агрегатныеданные: векторы, массивы, структуры, множества и их отображение на реальную ОП.
Большинство современных ЯВУ определяет понятие типа данных. Оно применяется ко всем объектам данных и определяет набор физический набор свойств и операций присущих данным этого типа. Различают языки со строгой типизацией (PASCAL) и со свободной (ASSEMBLER). Тип данных определяется как рекурсивное использование базовых предопределенных типов + агрегатирование. Агрегатирование – включает в себя описание массивов, структур, множеств, объединений.
Базовые типы
Перичислимый тип – объект данного типа может принимать одно из перечисленных заранее значений. Целые числа, действительные числа, символьные данные, битовые данные, указатель (типизированный и нетипизированный).
Агрегатирование
Массив – каждому элементу ставится в соответствие его индекс. Необходимо иметь возможность переводить индекс в адрес памяти. Для одномерных массивов проекция элементов на ОП выглядит как @A[i]=@A[0]+i*l, где l-длина элемента массива. Для многомерного есть 2 случая – размещение по строкам и по столбцам. Для двумерного массива прекция элемента @A[i,j]=@A[0]+i*lстр+j*lэл-та, где lстр – длина строки, а lэл-та – размер элемента. Если ЯВУ позволяет массивы переменной длины, то к массиву должен быть приписан скрытый элемент данных, наз. дополнительным вектором. Он должен содержать информацию о последних измененных размерностях для правильной индексации.
Структура – совокупность элементов различных типов. Длина структуры равна сумме длин всех ее членов. Чтобы обратиться к структуре по памяти, надо знать, где расположена структура, и смещение элемента внутри структуры.
Объединение – похоже на структуру, но все члены объединения расположены на одном участке памяти.Описывает одни и те же данные “с разных точек зрения”. Размер объединения совпадает с размером самого большого члена объединения.
Множество – представление набора элементов. Могут быть ограниченные и динамические. Представлены в виде битовых полей – 1 означает наличие элемента, 0 – отсутсвие. Длина равна числу элементов разделить на 8 и дополнена до кратности 8 в большую сторону. Доступ – через логические операции.
Указатели и динамические структуры данных: стеки, списки, очереди, деревья.
Указатель – тип данных, хранящих адрес в памяти других данных. В зависимости от типизации указатель может быть нетипизированным (содержать просто адрес в памяти) и типизированным (указывать только на элемент определенного типа).
Стек – хранилише данных однородного типа с дисциплиной “последним пришел-первым вышел” (LIFO).
| ß | SP | |
Над стеком определены операции PUSH, POP (затолкнуть, извлечь).
При операции PUSH указатель стека SP увеличится на 1, при извлечении уменьшится на 1.
Природа стека делает необходимым соответствие операций PUSH и POP. Если его нет, то возможно 2 ситуации:
а) переполнение – SP вышел за пределы верхнего значения
б) антипереполнение –“- нижнего.
Очередь – структура данных с дисциплиной FIFO – “первым вошел, первым вышел”.
| ßtp | ||
| ßhp |
Здесь HP – указатель на последнее значение, tp – номер последнего выбранного элемента. Если HP=TP – очередь пуста.
ENQ x - добавляем в очередь
HP=HP+1
A[HP]=x
DEQ x - извлекаем из очереди
TP=TP+1
x = A[TP]
Особые ситуации - так же как и со стеком.
Для реализации динамических структур данных используют т.н. кучу (heap). Это объем памяти, в котором можно выделить участок для произвольного элемента данных. Для кучи есть 2 операции: выделения памяти ALLOCATE и освобождения FREE. Эти функции не делают никаких действий с собственно памятью. При выделении программист получает адрес, а при освобождении доступный объем кучи становится больше. Одного адреса для этих операций недостаточно, требуется еще и размер элемента данных.
Списки – сложные динамические структуры данных, представляющие собой структуры, содержащие указатели на другие подобные структуры. Если такой указатель в структуре 1 – односвязный список, если 2 – двусвязный, если много – многосвязный. Стек и очередь можно легко представить в виде одно- и двусвязного списка. Списки характеризуются тем, что для них легко реализуется любая дисциплина ввода-вывода за счет простого добавления и удаления элемента.
Для добавления элемента достаточно выделить под него память и присвоить адрес памяти нового элемента соответствующему предыдущему элементу. Для удаления элемента память из-под него освобождается, а указателям на него присваивается некоторое зарезервированное значение NULL – “указатель на ничто”.
|
struct s *next; |
data; struct s *next; |
data; struct s *next; |
NULL |


 data;
Односвязный список
|
struct s *prev; struct s *next; |
data; struct s *prev; struct s *next; |
data; struct s *prev; struct s *next; |
NULL |


 data;
Двусвязный список
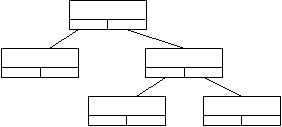
Дерево – структура данных, в которой каждому элементу может соответствовать несколько подчиненных элементов, например, для бинарного дерева – два подчиненных элемента. Структура для представления такого дерева – данные и указатели на левого и правого потомков. На таком списке реализуются все операции по обходу деревьев.
 |
|||||||
 |
|||||||
 |
 |
||||||
NULL NULL
 |
 |
 |
 |
NULL NULL NULL NULL
Структура двоичного дерева. Каждый элемент содержит поле данных и два указателя - на левого и правого потомков.
Способы выделения памяти в программах: абсолютное, статическое, динамическое и автоматическое распределения. Механизм стека и кучи при реализации процессоров языка программирования.
Статическое выделение памяти – выделение памяти под данные внутри сегмента данных программы. Такие данные существуют на протяжении всей жизни программы до ее завершения.
Автоматическое распределение – выделение памяти под данные в стеке. Такие данные существуют на протяжении работы текущей подпрограммы (функции или процедуры), затем уничтожаются.
Динамическое выделение – выделение памяти под данные самой программой, когда это необходимо. Время жизни таких данных зависит от программы.
В стеке размещаются данные для возврата из подпрограмм, а также их аргументы и автоматические данные. Все это может потребовать достаточно большого размера стека. Как правило, программист может определять размер стека в программе.
Куча. Для реализации динамических структур данных используют т.н. кучу (heap). Это объем памяти, в котором можно выделить участок для произвольного элемента данных. Для кучи есть 2 операции: выделения памяти ALLOCATE и освобождения FREE. Эти функции не делают никаких действий с собственно памятью. При выделении программист получает адрес, а при освобождении доступный объем кучи становится больше. Одного адреса для этих операций недостаточно, требуется еще и размер элемента данных. Если указатель типизированный, размер будет получен автматически. В случае нетипизированного указателя размер должен быть передан в функцию.
Для реализации кучи ЯВУ снабжаются диспетчерами памяти, которые выделяют и освобождают память, имеют сведения о ее фрагментации, знают наибольший кусок свободной памяти и ее общее количество и т.п. При ненадобности память должна своевременно освобождаться. При использовании динамической памяти возможноа ситуация образования «мусора» – кусков памяти, на которые утеряны ссылки, но которые не были своевремменно освобождены, поэтому менеджер считает их занятыми. Для оптимизации известна процедура “уборка мусора” – перестройка динамических структур с освобождением памяти из-под тех данных, на которые отсутствуют ссылки.
Среды ссылок: глобальная, локальная и нелокальная их реализация в исполняющих системах ЯВУ.
Понятие программного модуля: подпрограммы, функции, сопрограммы.
Модульное программирование подразумевает разбиение программы на подпрограммы по специфике обрабатываемых данных. Для этой цели в ЯВУ используются функции и процедуры. При вызове подпрограммы в стеке сохраняется текущее значение счетчика команд (ближняя модель вызова) и значение сегмента кода (дальняя модель вызова). При использовании дальней модели вызова подпрограмма необязательно должна находиться в том же сегменте, что и вызывающая программа. По окончании выполнения кода подпрограммы эти данные восстанавливаются, управление передается