Проектирование корпоративных информационных систем и управление
В основе концепции склада данных лежат две основные идеи:
Интеграция разъединенных детализированных данных (детализированных в том смысле, что они описывают некоторые конкретные факты, свойства, события и т.д.) в едином хранилище. В процессе интеграции должно выполняться согласование рассогласованных детализированных данных и, возможно, их агрегация. Данные могут поступать из исторических архивов корпорации, оперативных баз данных, внешних источников.
Разделение наборов данных, используемых для оперативной обработки, и наборов данных, применяемых для решения задач анализа.
Некоторых проблемы реализации складов данных:
неоднородность программной среды;
распределенный характер организации;
повышенные требования к безопасности данных;
необходимость наличия многоуровневых справочников метаданных;
потребность в эффективном хранении и обработке очень больших объемов информации.
Склад данных практически никогда не создается на пустом месте. Почти всегда конечное решение будет разнородным, т.е. в нем будут использоваться автономно разработанные программные средства. Прежде всего это касается формирования интегрированного согласованного набора данных, которые могут поступать из разнородных баз данных, электронных архивов, публичных и коммерческих электронных каталогов, справочников, статистических сборников. При построении склада данных приходится решать задачу построения единой, согласованно функционирующей информационной системы на основе неоднородных программных средств и решений. При выборе средств реализации склада данных приходится учитывать множество факторов, включающих уровень совместимости различных программных компонентов, легкость их освоения и использования, эффективность функционирования и т.д.
В концепции склада данных предопределено то, что операционная аналитическая обработка может выполняться в любом узле сети независимо от места расположения основного хранилища. Хотя при аналитической обработке данные только читаются, и потребность в синхронизации отсутствует, для достижения эффективности необходимо поддерживать репликацию данных в разных узлах сети. (На самом деле, все не так просто. Одним из требований к складам данных является то, чтобы свежая информация поступала на склад как можно быстрее. Т.е. потенциально любая модификация оперативной базы данных может инициировать добавление данных к складу данных, а тогда потребуется обновить и все реплики, для чего синхронизация все-таки нужна.)
Собранная вместе согласованная информация об истории развития корпорации, ее успехах и неудачах, о взаимоотношениях с поставщиками и заказчиками, об истории и состоянии рынка дает возможность анализа прошлой и текущей деятельности корпорации и построения прогнозов для будущего. Эта информация настолько ценна для корпорации, что нельзя допустить возможности ее утечки . В системах, основанных на складах данных, оказывается недостаточной защита данных в стиле языка SQL, которую обеспечивают обычные коммерческие СУБД (этот уровень защиты соответствует классу C2 в соответствии с классификацией Оранжевой Книги Министерства обороны США). Для обеспечения должного уровня защиты доступ к данным должен контролироваться не только на уровне таблиц и их столбцов, но и на уровне отдельных строк (это уже соответствует классу B1 Оранжевой Книги). Приходится также решать вопросы аутентификации пользователей, защиты данных при их перемещении в склад данных из оперативных баз данных и внешних источников, защиты данных при их передаче по сети.
Если роль метаданных (обычно содержащихся в таблицах-каталогах) в оперативных информационных системах достаточно ограничена, то для OLAP-систем наличие развитых метаданных и средств их предоставления конечным пользователям является одним из основных условий успешной реализации. Например, прежде, чем менеджер корпорации задаст системе свой вопрос, он должен понять, какая информация имеется, насколько она актуальна, можно ли ей доверять, сколько времени может занять формирование ответа и т.д. Для пользователя OLAP-системы требуются метаданные, по крайней мере, следующих типов:
Описания структур данных, их взаимосвязей.
Информация о хранимых на складе данных и поддерживаемых им агрегатах данных.
Информация об источниках данных и о степени их достоверности. Одна и та же информация могла попасть в склад данных из разных источников. Пользователь должен иметь возможность узнать, какой источник был выбран основным, и каким образом производились согласование и очистка данных.
Информация о периодичности обновлений данных. Желательно знать не только то, какому моменту времени соответствуют интересующие его данные, но и когда они в следующий раз будут обновлены.
Информация о владельцах данных. Пользователю OLAP-системы может оказаться полезной информация о наличии в системе данных, к которым он не имеет доступа, о владельцах этих данных и о действиях, которые он должен предпринять, чтобы получить доступ к данным.
Статистические оценки времени выполнения запросов. До выполнения запроса полезно иметь хотя бы приблизительную оценку времени, которое потребуется для получения ответа, и объема этого ответа.
Уже сейчас известны примеры складов данных, содержащих терабайты информации. По данным консалтинговой компании Meta Group, около половины корпораций, использующих или планирующих использовать склады данных, предполагает довести их объем до сотен гигабайт. Проблемой таких больших хранилищ является то, что накладные расходы на внешнюю память возрастают нелинейно при возрастании объема хранилища. Исследования, проведенные на основе тестового набора TPC-D, показали, что для баз данных объемом в 100 гигабайт потребуется внешняя память объемом в 4.87 раза большая, чем нужно собственно для полезных данных. При дальнейшем росте баз данных этот коэффициент увеличивается.
В последнее время все более популярной становится идея совместить концепции склада и рынка данных в одной реализации и использовать склад данных в качестве единственного источника интегрированных данных для всех рынков данных. Тогда естественной становится такая трехуровневая организация OLAP-системы:
На первом уровне реализуется корпоративный склад данных на основе одной из развитых современных реляционных СУБД. Это хранилище интегрированных в основном детализированных данных. Реляционные СУБД обеспечивают эффективное хранение и управление данными очень большого объема, но не слишком хорошо соответствуют потребностям OLAP-систем, в частности, в связи с требованием многомерного представления данных.
На втором уровне поддерживаются рынки данных на основе многомерной системы управления базами данных (примером такой системы является Oracle Express Server). Он может содержать ссылки на склад данных и добирать оттуда информацию по мере поступления запросов. Конечно, это несколько увеличивает время отклика, но зато снимает проблему ограниченного объема многомерной базы данных.
Наконец, на третьем уровне находятся клиентские рабочие места конечных пользователей, на которых устанавливаются средства оперативного анализа данных.
2. Примеры реализации технологии складов данных у крупнейших компаний.
Компания IBM
Решение компании IBM называется A Data Warehouse Plus. Целью компании является обеспечение интегрированного набора программных продуктов и сервисов, основанных на единой архитектуре. Основой складов данных является семейство СУБД DB2. Преимуществом IBM является то, что данные, которые нужно извлечь из оперативной базы данных и поместить в склад данных, находятся в системах IBM. Поэтому естественная тесная интеграция программных продуктов.
Предлагаются три решения для складов данных:
Изолированный рынок данных. Предназначен для решения отдельных задач вне связи с общим хранилищем корпорации.
Зависимый рынок данных. Аналогичен изолированному рынку данных, но источники данных находятся под централизованным контролем.
Глобальный склад данных. Корпоративное хранилище данных, которое полностью централизовано контролируется и управляется. Глобальный склад данных может храниться централизовано или состоять из нескольких распределенных в сети рынков данных.
Oracle
Решение компании Oracle в области складов данных основывается на двух факторах: широкий ассортимент продуктов самой компании и деятельность партнеров в рамках программы Warehouse Technology Initiative. Возможности Oracle в области складов данных базируются на следующих составляющих:
наличие реляционной СУБД Oracle 7, которая постоянно совершенствуется для лучшего удовлетворения потребностей складов данных;
существование набора готовых приложений, обеспечивающих возможности разработки склада данных;
высокий технологический потенциал компании в области анализа данных;
доступность ряда продуктов, производимых другими компаниями.
Hewlett Packard
Работы, связанные со складами данных, выполняются в рамках программы OpenWarehouse. Выполнение этой программы должно обеспечить возможность построения складов данных на основе мощных компьютеров HP, аппаратуры других производителей и программных компонентов. Основой подхода HP являются Unix-платформы и программный продукт Intelligent Warehouse, который предназначен для управления складами данных. Основа построения складов данных, предлагаемая HP, оставляет свободу выбора реляционной СУБД, средств реинжиниринга и т.д.
Sybase
Стратегия компании в области складов данных основывается на разработанной ей архитектуре Warehouse WORKS. В основе подхода находится реляционная СУБД Sybase System 11, средство для подключения и доступа к базам данных OmniCONNECT и средство разработки приложений PowerBuilder. Компания продолжает совершенствовать свою СУБД для лучшего удовлетворения потребностей складов данных (например, введена побитная индексация).
Informix Software
Стратегия компании в отношение складов данных направлена на расширение рынка для ее продукта On-Line Dinamic Parallel Server. Предлагаемая архитектура склада данных базируется на четырех технологиях: реляционные базы данных, программном обеспечении для управления складом данных, средствах доступа к данным и платформе открытых систем. Три последние компонента разрабатываются партнерами компании. После выхода Универсального Сервера, основанного на объектно-реляционном подходе, можно ожидать, что и он будет использоваться для построения складов данных.
AT&T GIS
Решение компании направлено на решение проблем корпораций, у которых одинаково сильны потребности и в системах поддержки принятия решений, и в системах оперативной аналитической обработки данных. Предлагаемая архитектура называется Enterprise Information Factory и основывается на опыте использования системы управления базами данных Teradata и связанных с ней методах параллельной обработки.
SAS Institute
Компания считает себя поставщиком полного решения для организации склада данных. Подход основан на следующем:
обеспечение доступа к данным с возможностью их извлечения из самых разнообразных хранилищ данных (и реляционных, и нереляционных);
преобразование данных и манипулирование ими с использованием 4GL;
наличие сервера многомерных баз данных;
большой набор методов и средств для аналитической обработки и статистического анализа.
Software AG
Деятельность компании в области складов данных происходит в рамках программы Open Data Warehouse Initiative. Программа базируется на основных продуктах компании ADABAS и Natural 4GL, собственных и приобретенных средствах извлечения и анализа данных, средстве управления складом данных SourcePoint. SourcePoint позволяет автоматизировать процесс извлечения и пересылки данных, а также их загрузки в склад данных.
Существует еще целый ряд компаний, которые прямо или косвенно связаны с технологией складов данных, но мы ограничимся перечисленными, поскольку их продукты и подходы кажутся наиболее продвинутыми.
Глобально распределенные информационные системы
В мире существует громадное количество готовых к использованию информационно-вычислительных ресурсов. Они создавались в разное время, для их разработки использовались разные подходы. Почти всегда при разработке новой информационной системы можно найти подходящие по своим функциям уже работающие готовые компоненты. Проблема состоит в том, что при их создании не учитывались требования интероперабельности. Эти компоненты не понимают один другого, они не могут работать совместно. Желательно иметь механизм или набор механизмов, которые позволят сделать такие независимо разработанные информационно-вычислительные ресурсы интероперабельными.
Первым шагом на пути решения проблемы интеграции информационных ресурсов была попытка создать средства, позволяющие интегрировать набор разнородных баз данных (иерархических, сетевых, реляционных и т.д.). Такие средства должны были обеспечить возможность работы с неоднородными базами данных в единой концептуальной модели данных. Известные подходы основывались на использовании в качестве единой модели реляционной модели данных.
Несмотря на высокий уровень проработки системы управления интегрированными распределенными неоднородными базами данных так и не вышли за пределы академических экспериментов. Видимо, это связано с целым рядом причин, основной из которых, является то, что реляционная модель данных слишком ограничена, чтобы ее можно было использовать в качестве единой концептуальной модели.
Тем не менее, проблема интеграции остается очень актуальной, и в последние годы все большее число специалистов соглашаются с тем, что ее можно и нужно решать на основе объектно-ориентированного подхода.
Проблема интеграции неоднородных автономно разработанных информационно-вычислительных ресурсов рассматривалась в двух контекстах. Первый контекст - повторное использование (reusability) существующих и доступных по сети ресурсов. Второй контекст - облегчение разработки корпоративных информационных систем, отдельные компоненты которых создаются разными, территориально распределенными группами, каждая из которых в силу исторических причин использует наиболее привычную для нее технологию. Например, канадская компания BNR для разработки новых программных продуктов использует коллективы программистов из разных стран мира. Некоторые группы предпочитают использовать Си++, другие - объектный Лисп, третьи - Smalltalk и т.д. Но в результате должна появиться единая, реально работающая, программная система.
Но имеется и третий контекст, контекст унаследованных систем (legacy systems). В любой крупной, долгое время существующей корпорации накапливаются информационные подсистемы, разработанные в соответствии с морально устаревшими технологиями. Например, трудно найти корпорацию с возрастом больше 25 лет, в которой не использовались бы информационные подсистемы, созданные на основе ранних аппаратно-программных платформ компании IBM. Базы данных таких подсистем содержат громадные объемы ценной информации, и корпорация просто не может обойтись без их использования. С другой стороны, унаследованные системы очень трудно сопровождать и поддерживать. Очень часто программная часть системы написана на языке ассемблера, а люди, которые писали эти программы, больше не работают в корпорации. Возникают проблемы и с аппаратной частью.
Для корпорации было бы желательно перевести унаследованные информационные подсистемы на новые технологии, но работоспособность унаследованной системы может быть настолько важна для корпорации, что эту систему нельзя вывести из использования даже на короткое время.
Одно из наиболее признанных решений проблемы унаследованных систем основывается также на объектно-ориентированном подходе. Идея состоит в том, что "вокруг" системы создается объектная оболочка. Естественно, что при этом порождается и новый объектный интерфейс системы, но до поры сохраняется и ее старый интерфейс. После этого параллельно все другие подсистемы корпорации постепенно переводятся на использование нового интерфейса реконструируемой подсистемы, а сама эта подсистема переделывается в соответствии с современными технологиями. В конце концов, когда сторонние подсистемы полностью готовы работать в новом интерфейсе, и процесс переделки унаследованной подсистемы завершен, она заменяется на вновь разработанный вариант.
2. Аналитический раздел
2.1 Объект Управления
Объект управления: Департамент технического управления и поддержки широкополосного доступа компании ОАО "Вымпелком"( Компания оказывает широкий спектр услуг корпоративным и частным клиентам, число основных услуг, предоставляемых компанией, входят телефонизация объектов и подключение к сети Интернета; мобильная телефония; предоставление услуг междугородней и международной телефонной связи; построение корпоративных сетей (как физических, так и виртуальных); предоставление услуг передачи данных; организация видеоконференций; IP-телефония; веб-хостинг и colocation (размещение серверов заказчиков в технической зоне ОАО «Вымпелком»); продажа универсальных карт «Телефон+Интернет»). Основной деятельности департамента технического управления и поддержки является помощь в настройке соединения с сетью, абоненту; тестирование клиентского оборудования; тестирование качества соединения с сетью и многое другое.(витос можеш сам еще дописать чо вы там делаете) СОТРИ!!!!
2.2 Описание Орг. Структуры объекта управления
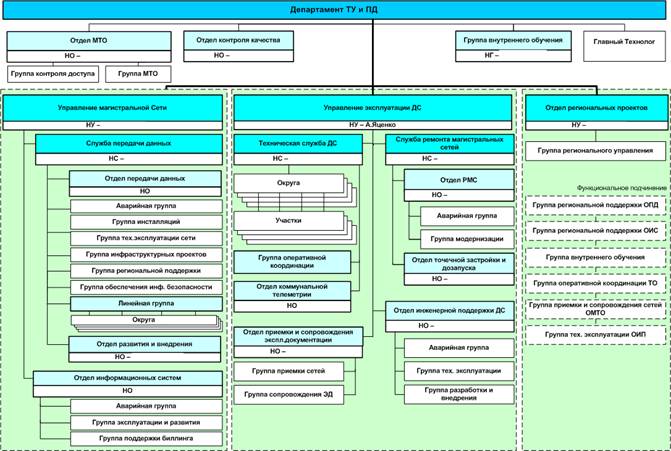
Ниже представлена организационная структура управления департамента технического управления и поддержки широкополосного доступа.
Структура представляет собой вертикальную модель иерархической системы управления с элементами горизонтальной модели.
Модель описывает внутриорганизационные отношения и их участников в департаменте.
2.3 Информационная система объекта управления.
В компании используется огромное количество информационного, программного и технического обеспечения. Ниже представлены системы, которые используются для обработки обращений клиентов.
Help desk - Intranet система, доступ к которой осуществляется через браузер. HelpDesk решаtn задачи автоматизации процедур регистрации запросов, поступающих в подразделения IT, планирования и контроля работы персонала технической поддержки в крупных компаниях, контроля выполнения работ. Основными функциями систем являются:
Автоматизация регистрации и обработки заявок от пользователей, поступающих в службу технической поддержки, хранение и оперативное представление информации о составе оборудования, программного обеспечения пользователей, поддержка автоматического контроля правил выполнения