Интерпретатор языка Пролог
Пусть исходные
предложения
задаются в виде
 и
 и переменные,
входящие в
,
не встречаются
в
и обратно. Пусть
 и
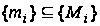 - такие два
подмножества
и
,
что для объединения
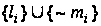 существует
наиболее общий
унификатор
 .
Тогда говорят,
что два предложения
и
разрешаются,
а новое предложение
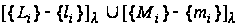 является их
резольвентой.
Резольвента
представляет
выведенное
предложение,
и процесс образования
резольвенты
из двух "родительских"
предложений
называется
резольвенцией.
Иными словами
мы хотим иметь
возможность
находить
доказательство
того, что некоторая
правильно
построенная
формула W в
исчислении
предикатов
логически
следует из
некоторого
множества S
правильно
построенных
формул. Это
задача эквивалентна
задаче доказательства
того, что множество
 неудовлетворимо.
Процессы выявления
неудовлетворимости
некоторого
множества
предложений
называются
процессами
опровержения.
Принцип резольвенции непротиворечив и полон. Непротиворечивость означает, что если когда-нибудь мы придем к пустому предложению, то исходное множество обязано быть неудовлетворимым. Полнота означает, что если исходное множество неудовлетворимо, то, в конце концов, мы придем к пустому предложению.[2]
1.3.2 Методы поиска доказательства в исчислении предикатов
1.3.2.1 Исчисление предикатов при решении задач
Иногда достаточно только знать, следует ли логически правильно построенная формула W из некоторого множества S правильно построенных формул. Если W не следует из S, то, возможно, мы захотим знать, следует ~W из S. Конечно, в силу неразрешимости исчисления предикатов не всегда можно установить, следует ли W из S.
В других
приложениях
нужно знать
значение элемента
x (если он существует),
при котором
данная правильно
построенная
формула W (содержащая
x в качестве
переменной)
логически
следует из
некоторого
множества S
правильно
построенных
формул. Иными
словами, мы
хотели бы знать,
следует ли
логически
правильно
построенная
формула
 ,
и если да, то
каков тот частный
случай переменной
x. Проблема поиска
доказательства
правильно
построенной
формулы
,
исходя из S, является
обычной проблемой
доказательства
в исчислении
предикатов,
но для построения
удовлетворяющего
частного случая
требуется,
чтобы метод
доказательства
был "конструктивным".
Часто утверждения, относящиеся к задаче, делаются в форме фраз на разговорном языке, например английском. Поэтому естественно возникает вопрос, в каких случаях можно осуществить автоматический перевод с английского языка на язык исчисления предикатов. Написано несколько программ, позволяющих в ограниченных рамках перевод с естественного языка на язык предикатов, но способность работать с естественным языком пока находится в весьма неудовлетворительном состоянии.[1]
1.3.2.2 Стратегии перебора
Непосредственное применение принципа резольвенции соответствует простой процедуре полного перебора при построении опровержения. Такой перебор мы начинается множества S, к которому добавляется резольвенты всех пар предложений в S с тем, чтобы образовать множество R. Затем добавляются резольвенты всех пар предложений в R с тем, чтобы образовать множество R(R(S))=R2(S), и т.д. Этот метод перебора как правило непригоден для практики, так как множества R(S), R2(S),… слишком быстро разрастаются. Практические процедуры доказательства определяются стратегиями перебора, применяемыми для его ускорения. Такие стратегии бывают трех типов: стратегии упрощения, стратегии очищения и стратегии упорядочения.[2]
1.3.2.3 Стратегии упрощения
Иногда множество предложений удается упростить, исключив из него некоторые предложения или исключив из предложений определенные литералы. Эти упрощения таковы, что упрощенное множество предложений выполнимо тогда и только тогда, когда выполнимо исходное множество предложений. Таким образом, применение стратегий упрощения позволяет снизить скорость роста новых предложений.
Исключение тавтологий.
Любое предложение, содержащее литерал и его дополнение (такое предложение называется тавтологией), можно отбросить, так как любое невыполнимое множество, содержащее тавтологию, остается невыполнимым и после ее удаления.
Исключение путем означивания предикатов.
Иногда появляется возможность означить (выяснить значение истинности) литералы, и это оказывается удобнее, чем включать соответствующие предложения в S. Такое означивание легко провести для константных частных случаев. Например, если предикатная буква E обозначает отношение равенства, то означивание константных частных случаев типа E(7,3), когда они появляются, провести легко, хотя нам бы не хотелось добавлять к S полную таблицу, содержащих много константных частных случаев литералов E(x,y) и ~E(x,y).
Если какой-нибудь литерал предложения получает значение истинности T, то все предложения можно отбросить, не нарушая при этом свойства невыполнимости оставшегося множества. Если же какой-нибудь литерал при означивании получает значение истинности F, то из этого предложения можно исключить данное вхождение литерала.[2]
Исключение подслучаев.
Предложение
 называется
подслучаем
предложения
,
если существует
такая подстановка
 ,
что
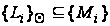 .
Например,
 - подслучай
предложения
 ,
- подслучай
предложения
 ,
- подслучай
предложения

 - подслучай
предложения
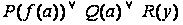 .
Предложение в S, являющиеся подслучаем другого предложения в S, можно исключить из S, не нарушая свойства невыполнимости оставшегося множества. Отбрасывание предложений, являющихся подслучаями других, часто ведет к значительному уменьшению числа резольвенций, необходимых для нахождения доказательства.[2]
1.3.2.4 Стратегии очищения
Стратегии
очищения основаны
на тех теоретических
результатах
в теории доказательства
с помощью
резольвенций,
в которых
утверждается,
что для нахождения
опровержения
не нужны все
резольвенции.
Иными словами,
достаточно
выполнить
резольвенции
только для
предложений,
удовлетворяющих
определенным
требованиям.
Обозначим через
 объединение
множества S и
множества всех
резольвент
всех пар предложений
из S , удовлетворяющих
критерию C. Ясно,
что
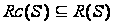 .
Про стратегию
очищения,
использующую
критерий C, говорят,
что в ней используется
"резольвенция
по отношению
к C". Для применения
такой стратегии
сначала вычисляется
,
затем
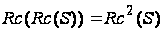 и т.д. до тех пор,
пока при некотором
n в
 не окажется
пустого предложения
обозначемого
nil.
Потенциальное достоинство стратегии очищения, в том, что на каждом уровне требуется меньше резольвенций. Однако уровень, на котором появляется пустое предложение, обычно возрастает, так что стратегия очищения приводит обычно к узконаправленному, но более глубокому перебору. Стратегия очищения полезна лишь в том случае, если она уменьшает все затраты усилий на перебор, включая усилия, необходимые для проверки критерия C.[2]
1.3.2.5 Формы доказательства с отфильтровыванием
предшествующих вершин
Доказательство с отфильтровыванием предшествующих вершин производится с использованием AF-графа. Граф опровержения имеет AF-форму, если каждая из его вершин соответствует одному из следующих предложений:
базовому предложению;
предложению, непосредственно следующему за базовым;
предложению, непосредственно следующему за двумя небазовыми предложениями A и B, из которых B предшествует A (отсюда термин отфильтровывание предшествующих вершин).
Граф в виде лозы представляет собой частный случай графа в AF-форме: каждая из его вершин соответствует либо предложению 1, либо предложению 2. Но граф типа лозы существует не для всех неудовлетворимых множеств. Ниже приведен пример такого графа.[2]
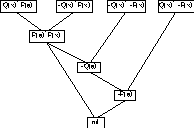
Рис 1.1. Вид графа в AF-форме.
1.3.2.6 Стратегии поддерживающего множества
Стратегией поддерживающего множества называют стратегию, в которой выбирается такое непустое множество K исходного множества предложений S, что множество S-K удовлетворимо. Например, в качестве K можно взять множество предложений, возникающих из отрицания доказываемой теоремы. Говорят, что предложения в K имеют поддержку. При поиске опровержения допустимыми считаются резольвенты лишь тех пар предложений, в которых, по крайней мере, одно имеет поддержку, каждому предложению, построенному в результате резольвенции, также придается поддержка.
Так как множество S-K удовлетворимо, существует граф опровержения, имеющий AF-форму, у которого верхней вершиной служит один из элементов множества K. Таким образом, стратегия поддерживающего множества полна, поскольку она допускает все резольвенции, допускаемые AF-стратегией.[2]
1.3.2.7 Стратегии упорядочения
На основе резольвенций, обеспечиваемых различными стратегиями очищения, иногда можно искать опровержение, упорядочив выполняемые резольвенции. В стратегиях упорядочения не запрещаются никакие типы резольвенций, а лишь даются указания на то, какие из них надо выполнять в первую очередь. Стратегии упорядочения соответствуют эвристическим стратегиям перебора для поиска на графах. При хорошем упорядочении не обязательно вычислять все элементы множеств R(S), R2(S) и т.д. Если пустое предложение появляется впервые на уровне n, что хочется думать, можно прямо направить на этот уровень, не заполняя нижние уровни.
Две довольно эффективные стратегии упорядочения – это стратегия предпочтения одночленам и стратегия наименьшего числа компонент. В стратегии предпочтения одночленам делается попытка сначала построить резольвенты между одночленами, т.е. предложениями, содержащими один литерал. Если это удается, то сразу же получается опровержение. Если же не могут найти пару одночленов, у которых есть резольвента, то пытаются найти резольвенту для пар одночлен-двучлен и т.д. Как только какая-нибудь пара предложений разрешается, полученную резольвенту сразу сопоставляют с одночленами с тем, чтобы найти возможные резольвенты. Во избежание совершения невыгодной цепочки одночленных резольвенций обычно устанавливается граничный уровень.
Стратегия предпочтения одночленам оправдана гарантированным укорочением длины предложений, вызываемым одночленными резольвентами. Так как цель построения резольвент состоит в образовании пустого предложения, то стратегия предпочтения одночленам напрашивается сама собой. При введении граничных уровней для возможности использования и других резольвенций такая стратегия не препятствует нахождению опровержения и, как правило, сильно ускоряет процесс перебора.
Стратегия наименьшего числа компонент упорядочивает резольвенции согласно длине получаемых резольвент. Так, два предложения, дающие наиболее короткую резольвенту, разрешаются в первую очередь. Эта стратегия в некотором смысле дороже, поскольку до выполнения резольвенции надо подсчитать длины потенциальных резольвент и упорядочить их.[2]
1.4 Анализ характеристик существующих интерпретаторов
В настоящее время существует несколько интерпретаторов и компиляторов языка Пролог.
СиПролог (CProlog). Поставщиком является отдел архитектуры Университета Эдинбурга. Эта версия переносится практически на любой 32-разрядный компьютер с операционной системой UNIX. Синтаксис СиПролога совпадает с синтаксисом DEC-10 Пролога. Встроенного редактора не существует. У отладчика имеются всего четыре команды:
Call - вызов первой фразы предиката
Back To - вызов второй и последующих фраз
Exit - процедура выполнена успешно
Fail - система достигла конца множества фраз.[2]
Квинтус Пролог (Quintus Prolog). Поставляется фирмой Quintus Computer Systems Inc. Он Предназначен для ЭВМ под управлением UNIX и VMS. Квинтус Пролог можно запускать либо как самостоятельный процесс, либо через специальный интерфейс с редактором EMACS. Отладчик аналогичен отладчику СиПролога, но обладает большим количеством команд.[2]
Пролог-2. Поставляется фирмой Expert Systems Int. Работает под управлением MS-DOS. Поддерживает свой механизм виртуальной памяти, что позволяет писать программы, работающие с большим количеством данных. Из-за особого механизма виртуальной памяти программу необходимо разбивать на модули и указывать явно, должен ли находится модуль в реальной памяти или возможно его размещение в виртуальной. Имеется встроенный редактор. Отладчик аналогичен отладчику СиПролога.[2]
Эрити Пролог (Arity Prolog). Поставщик Arity Corp. Работает под управлением MS-DOS или совместимой операционной системы. Имеет механизм виртуальной памяти со страничной организацией. Встроенного редактора нет, отладчик аналогичен предыдущим.[2]
Турбо Пролог (Turbo Prolog). Поставщик Borland Int. Работает под управлением MS-DOS. Является полноценным компилятором, вследствие чего обладает строгим контролем типов. Создан собственный оконный интерфейс с четырьмя окнами: редактор, отладчик, консоль и окно сообщений об ошибках. Сообщения отладчика аналогичны сообщениям отладчика СиПролога.[6]
Visual Prolog. Поставщик Prolog Development Center. Работает под управлением Windows 3.1 и выше. Обладает развитым оконным интерфейсом. Позволяет создавать полноценные приложения для Windows с использованием окон. Сообщения отладчика аналогичны СиПролог.
Основным недостатком всех рассмотренных диалектов языка Пролог является то, что база данных у них должна храниться в оперативной памяти, либо в виртуальной, когда реальные базы данных могут занимать десятки и сотни мегабайт. Вторым недостатком является то что, ни один из диалектов не поддерживает современные базы данных, а подключает базы данных, содержащиеся в текстовых файлах и представляющих собой, по сути, часть Пролог-программы.
1.5 Необходимость разработки интерпретатора языка Пролог
Отсутствие возможности работы с универсальными базами данных у вышеперечисленных версий языка Пролог заставляют разработчиков писать программы на универсальных языках программирования. Вследствие этого, увеличивается время разработки программ для баз данных, так как универсальные языки программирования, такие как С, Паскаль и проч., не имеют удобных встроенных средств работы с базами данных.
Также все перечисленные выше версии Пролога имеют недостаточно удобный интерфейс и средства отладки, либо совсем его не имеют, что уменьшает скорость разработки программ на Прологе.
1.6 Выбор языка программирования
На выбор языка программирования влияют следующие факторы:
характер решаемой задачи;
имеющиеся в наличии системные библиотеки;
поддреживаемые компилятором платформы.
По характеру решаемой задачи, для программирования интерпретатора требуется язык программирования, позволяющий:
гибко работать с динамически выделяемой памятью;
иметь объектно-ориентированное расширение;
иметь средства обработки исключительных ситуаций;
получать высокоскоростной код.
Перечисленным требованиям удовлетворяют С++ и Паскаль. До недавнего времени Паскаль (и его диалект Delphi) значительно уступал С++ по возможности формирования высокоскоростного кода. Но теперь в компилятор Delphi 4 был встроен оптимизатор, который позволяет формировать высокоскоростной код.
Также в пользу Delphi 4 говорит и то, что он теперь может оперировать с динамическими массивами, то есть с такими массивами, количество элементов которых может меняться в процессе выполнения программы.
Borland Delphi 4 генерирует код для операционных систем Windows 95, 98 и NT. Имеет средства визуального построения приложений.
2 Конструкторская часть
2.1 Синтаксис программ на Прологе в нотации Бэкуса-Наура
Программа::=предложение <предложение>
Предложение::=утверждение, управляющая команда
Утверждение::=голова.проб_символ
Голова :- хвост.проб_символ
Голова if хвост.проб_символ
Управляющая команда::=
целевое утверждение
<,целевое утверждение>.проб_символ
Голова::=целевое утверждение
Хвост::=целевое утверждение
<,целевое утверждение>
Целевое утверждение::=атом|структура
Проб_символ::=пробел, возврат каретки[6]
2.2 Общая структура интерпретатора
Интерпретатор языка Пролог состоит из следующих частей:
Предкомпилятор;
Интерпретатор.
Предкомпилятор выполняет перевод исходных данных в объекты интерпретатора. Исходными данными для предкомпилятора являются:
Текст программы;
Типы пользователя;
Описания внешних данных (структур баз данных);
Описания предикатов программы.
Интерпретатор на основе выполненных предкомпилятором действий и созданных им объектов выполняет программу с помощью алгоритма бэктрекинга.
2.2.1 Принцип работы предкомпилятора
Предкомпилятор состоит из двух основных частей:
Лексический анализатор
Синтаксический анализатор.
Лексический анализатор выполняет разбор текста программы на лексемы. В ходе работы лексического анализатора формируется массив лексем, соответствующих программе.
Синтаксический анализатор на основе массива лексем, полученных от лексического анализатора, формирует объект программы.
2.2.1.1 Работа лексического анализатора
Для удобства работы лексический анализатор склеивает весь текст программы в одну длинную строку. Такое склеивание можно проводить, так как максимальная длина строки в Delphi 4 равна 2 гигабайтам. При склеивании строк, в конце каждой строки ставится пара символов Enter и пробел. Это делается для того, чтобы удобно можно было вычислить положение лексемы в тексте программы.
Лексический анализатор просматривает текст программы символ за символом, пропуская символы, заключенные между фигурными скобками. В ходе просмотра анализатор выделяет цепочку символов, которая похожа на лексему, после чего передает управление анализатору лексем.
Анализатор лексем, получив строку с предполагаемой лексемой, пытается сначала сопоставить ее со стандартными лексемами (арифметические знаки, точка, запятая и т.п.). Если строка не является стандартной лексемой, то далее анализатор лексем пытается найти ее среди предикатов, функций и баз данных. В случае неудачи анализатор проверяется строку, является ли она правильным идентификатором. Если да, то это переменная. Если лексема начинается и кончается кавычками, то это строка. На заключительном этапе проверяется, может ли лексема быть числом.
Если ни одно из условий не было выполнено, то выдается сообщение об ошибке.
На выходе анализатора лексем формируется объект лексемы, в котором хранится тип лексемы, ее строковый вид, а также положение лексемы в тексте программы.
Потом из полученных лексем создается массив.
2.2.1.2 Синтаксический анализатор
На начальном этапе массив лексем разбивается на несколько подмассивов по одному для каждого предиката. При разбиении массива проверяется следующее правило: каждое предложение начинается с имени предиката и заканчивается точкой. Таким образом, выделяются лексемы соответствующие каждому предикату.
Затем работа продолжается с каждым из подмассивов отдельно. Пользуясь вышеописанным правилом, выделяется отдельное предложение и отправляется на синтаксический анализ.
Предложение в Прологе имеет следующий формат:
ИмяПредиката (Параметр1, Параметр2, …) if
Условие1(Параметр11, Параметр12, …),
Условие2(Пераметр21, Параметр22, …),
УсловиеN(ПараметрN1, ПараметрN2, …).
При синтаксическом анализе, во-первых, проверяется заголовок предложения. Проверяется имя предиката и параметры (их количество и тип) и наличие слова “if”. Если в качестве параметра стоит переменная, то считается, что переменная может быть любого типа, а константы подвергаются жесткому контролю.
Из массива лексем предложения выделяются отдельные условия. В этом случае должны быть выполнены следующие требования:
Все условия разделены запятыми друг от друга;
Цепочка условий заканчивается точкой;
Внутри условия все скобки (круглые и квадратные) должны быть закрыты.
Проверка условий делится на три части в зависимости от типа первой лексемы:
Вызов предиката, если первая лексема - имя предиката;
Вызов базы данных, если первая лексема - имя базы данных;
Вычисление арифметического выражения - во всех остальных случаях.
При синтаксическом анализе вызовов предикатов и баз данных выполняется разбор параметров примерно такой же, как при анализе заголовка предложения.
При анализе арифметического выражения строится дерево, соответствующее выражению.
2.2.1.3 Анализ арифметического выражения
Если на вход поступает массив из одного элемента, то немедленно формируется лист арифметического дерева, и программа выходит из функции.
Среди всего массива лексем находится оператор с наинизшим приоритетом, причем операции, которые находятся внутри скобок в рассмотрение не берутся. В Прологе приоритеты операций распределены следующим образом:
1. *,/
2. +,-
3. >,<.>=,<=,<>
4. and,or
5. =
Если операция не найдена и первая и последняя лексема – парные круглые скобки, то необходимо их снять и вызвать опять функцию построения арифметического дерева. Возможен другой вариант при отсутствии найденной операции: первая лексема – функция, вторая – открывающая круглая скобка, последняя – закрывающая круглая скобка. В этом случае необходимо запустить процедуру нахождения параметров функции.
После того, как нашли нужную операцию, массив делится на две части – левую и правую. Если левый или правый массив пустой, то сообщить об ошибке.
В ходе выполнения следующих действий мы из арифметического выражения получаем дерево.
Например: A=5+func(6+C,D,E)/E-4
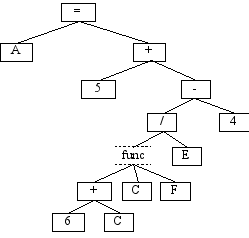
Рис 2.1. Дерево арифметического выражения.
2.2.1.4 Анализ параметров предикатов
Параметры на анализатор параметров поступают в скобках. Начиная с первой значимой лексемы, ищется полная запись параметра с таким условием, что запись параметра должна заканчиваться запятой или закрывающейся скобкой, и внутри параметра все круглые и квадратные скобки должны быть закрыты. Таким образом, формируется массив лексем параметра.
По первой лексеме массива можно определить, что это за параметр:
Если это название структуры – то структура,
Если левая квадратная скобка – то список,
Если число или строка – то константа,
Если идентификатор – то переменная.
Если выяснили, что параметром является список или структура, то отправляемся на специальные функции анализа списков или структур, где выделяются отдельные элементы списка или структуры и выясняется их тип.
2.2.1.5 Проверка типов параметров
На вход поступает объект с параметром и имя типа, с которым сравнивается параметр. На выходе мы должны выдать логическое значение, говорящее может ли параметр хотя бы теоретически относиться к сравниваемому типу.
Если параметром является переменная, то считается, что она может быть любого типа. Числовые, строковые и логические константы могут быть опознаны сразу.
Сложнее дело обстоит со структурами и списками, а также анализом составных типов.
При анализе составного типа необходимо выяснить, относится ли параметр к одному из типов составного типа. Если да, значит необходимо возвратить истину.
Рассматривая структуру, мы должны проверить тип каждого из элементов, составляющих структуру. Если все элементы имеют правильные типы, то возвратить истину.
Список может быть записан двумя способами:
[Элемент1, Элемент2, … , ЭлементN]
[Голова|Хвост]
В первом случае мы должны проверить тип каждого из элементов.
При рассмотрении второго случая необходимо учитывать то, что Голова имеет тип элемента списка, а Хвост – тип списка.
2.3 Работа интерпретатора
Функция работы интерпретатора представляет собой рекурсивную функцию, выполняющую алгоритм бэктрекинга.
Алгоритм бэктрекинга заключается в следующем. Для первого оператора Пролог-программы интерпретатор находит решение, удовлетворяющее этому оператору. Если решение было найдено, то переходим к следующему оператору. На втором операторе, с учетом результатов на предыдущем шаге, программа пытается решение для второго оператора. Если решение было найдено, то программа идет дальше. В противном случае, программа должна вернуться на шаг назад и подобрать другое решение для первого условия, а затем опять попытаться выполнить второе условие. Такой процесс идет до тех пор, пока не будет выполнено последнее условие, и предложение будет объявлено истинным. Или, если программа не сможет больше подобрать решения для первого условия, то все предложение будет объявлено ложным.
Принцип действия интерпретатора основан на рекурсивном вызове функции TPrologProgram.ExecutePredicate, которая выполняет предикат. На вход функции поступает объект TStackNode, в котором содержатся входные параметры, а также номер предложения, с которого необходимо начинать выполнять предикат. Функция ExecutePredicate возвращает логическое значение, указывающее на то, было ли найдено решение для предиката или нет. Входные и выходные параметры предиката хранятся в поле InputParameters.
Последовательность действий, которые выполняет функция ExecutePredicate, выглядит следующим образом:
В каждое предложение программа пытается подставить входные параметры. Если подстановка прошла успешно (это определяется функцией FindNamedAreas), то интерпретатор пытается выполнить это предложение. В противном случае просмотр продолжается.
Необходимо найти решение для каждого из условий предложения. Интерпретатор проходит по каждому из условий предложения последовательно.
Перед выполнением условия проверяется, запускается на оно на прямом пути или на обратном. Если на прямом пути, то в дополнительный стек заносится еще один элемент TSubStackNode, в котором содержатся следующие данные: само условие, список имен созданных на данном шаге переменных и список имен переменных свободных до текущего шага. Если условие запускается на обратном пути, то объект TSubStackNode не создается, так как был создан ранее.
Если
текущее условие
предикат или
база данных,
то для них
необходимо
создать новый
объект TStackNode и
сформировать
пакет входных
параметров.
Затем, если
текущее условие
база данных,
то вызывается
функция обработки
баз данных
ExecuteExtDataPredicate, если условие
стандартный
предикат, то
- ExecuteStandardPredicate, и, если
это предикат
пользователя
то рекурсивно
вызывается
ExecutePredicate.
Если текущее
условие - выражение,
то выполняется
функция
ExecuteArithmeticTerm.
Если после своего выполнения условие вернуло значение False, то запускается механизм обратного прохода. Уничтожается последний элемент TSubStackNode, и программа возвращается к предыдущему условию и пытается найти новое решение для него.
Если все условия были выполнены, то формируются выходные параметры и функция возвращает истину. В противном случае, программа возвращается к пункту 1 и пытается найти еще одно предложение, соответствующее входным данным.
Если были исчерпаны все предложения и ни для одно не было найдено решения, то необходимо возвратить False.
2.3.1 Выполнение обращений к базам данных
Обращение к базе данных происходит с помощью SQL-запросов.
При первом обращении к базе данных создается объект SQL-запроса и сам запрос.
Формат SQL-запроса
SELECT <поле1>,…,<полеN>
FROM <имя базы данных>
WHERE
<поле1>=<значение1> and
<поле2>=<значение2> and
…
<полеN>=<значениеN>
В запросе используются только условия-равенства, так как в Прологе при сопоставлении значении на входе в предикат используется только сравнение.
В список условий помещаются только те поля, значения которых на входе определены.
При первом обращении к базе берется первая запись из запроса.
При последующих вызовах базы данных (в случае обратного пути в бэктрекинге) объект SQL-запроса не создается, а используется ранее созданный, и применяется функция Next для доступа к следующей записи.
Таким образом, доступ к базе данных осуществляется как обычным предикатам, которые состоят только из предложений-фактов.
2.3.2 Вычисление арифметических выражений
На основе построенного при компиляции дерева арифметического выражения достаточно несложно, используя рекурсию, вычислить выражение.
На вход функции поступает объект с деревом арифметического выражения и объект со списком переменных, созданных ранее программой.
Программа смотрит, если в корне дерева находится арифметическая операция, то рекурсивно вызывается функция вычисления выражений для левой и правой частей выражения, которые в свою очередь являются деревьями арифметического выражения.
Дерево может состоять из одного элемента, если это константа или переменная. На этом шаге рекурсия заканчивается и возвращается значение константы или переменной (если до этого в списке переменных ее не значилось, то создается новая переменная).
2.4 Объекты, используемые компилятором и интерпретатором
2.4.1 Объекты переменных TPrologVariable, TPrologVariables,
TPrologVariableList, TPrologVariableStruct
Для преставления переменных всех типов (целые, дробные, строки, логические, списки, структуры) служит класс TPrologVariable. Для определения типа переменной служит поле iType. В поле Data хранится указатель на данные, соответствующие типу. Для простых типов (целые, дробные, строки, логические) – это указатель на соответствующий тип. Конструктор создает переменную без типа. Деструктор автоматически освобождает память для переменной любого типа. Для этого класса опеределены следующие методы:
procedure CreateVariable(DomainType:string; vName:string) - создание переменной типа DomainType с именем vName;
procedure DestroyVariable - уничтожение переменной (эта процедура не является деструктором, так как не уничтожает сам объект, а только освобождает память)
function CreateCopy:TPrologVariable - создание точной копии переменной;
procedure AssignVariable (v:TPrologVariable) - присваивание значения переменной.
Для представления списков введен класс TPrologVariableList, в котором хранится имя типа списка, имя типа элемента списка, тип представления списка (в виде перечисления элементов или «голова-хвост»), а также динамический массив, содержащий объекты TPrologVariable, являющиеся элементами списка.
В структурах (TPrologVariableStruct) аналогично хранится имя типа