Принципы организации параллелизма выполнения машинных команд в процессорах
Необходимость предсказания адреса «целевой» инструкции вызвана тем, что этот адрес может быть извлечён из x86-инструкции перехода и вычислен только на финальной стадии декодирования, с большой задержкой. Более того, даже простое выделение инструкций переменной длины из считанного блока и поиск среди них инструкций перехода займёт какое-то время. Поэтому в процессорах архитектуры x86 предсказание производят по целому блоку, без разбиения его на составляющие инструкции.
В современных процессорах для предсказания адреса перехода обычно используют специальную таблицу адресов переходов BTB (Branch Target Buffer). Эта таблица устроена подобно кэшу и содержит адреса инструкций, на которые ранее производились переходы. Например, в процессоре P-III таблица BTB имеет размер 512 элементов и организована в виде 128 наборов с ассоциативностью 4. Для адресации набора используются младшие разряды адреса 16-байтового блока инструкций. Если в этом блоке есть инструкции перехода, и если эти инструкции отрабатывали ранее, то алгоритм предсказания может очень быстро найти адрес целевой инструкции в таблице BTB и начать считывание блока, содержащего эту инструкцию. Адреса целевых инструкций помещаются в BTB в момент отставки соответствующих инструкций перехода.
В других современных процессорах размер таблицы BTB достигает 2048 элементов (K8) и 4096 элементов (P-4). Организация данной подсистемы в процессоре K8 несколько отличается от классической и основывается на предварительной разметке блоков инструкций в так называемых массивах селекторов перед помещением их в I-кэш. Эти селекторы привязаны к положению инструкций в I-кэше и при их вытеснении оттуда сохраняются в L2-кэше (в так называемых ECC-битах, предназначающихся для коррекции ошибок). Элементы таблицы BTB также привязаны к положению инструкций в I-кэше и теряются при их вытеснении. Это несколько снижает эффективность предсказания адресов переходов в процессоре K8.
Для предсказания направления условного перехода используется другой механизм, основанный на изучении поведения переходов в программе в процессе её выполнения (своего рода «сбор статистики»). Этот механизм учитывает как локальное поведение конкретной инструкции перехода (например, «как правило, переходит», «как правило, не переходит»), так и глобальные закономерности («чередуется по определённому закону» и т.п.). История поведения инструкций условного перехода записывается в специальных структурах, обычно называемых «таблицами истории переходов» (Branch History Table, BHT). Современные механизмы предсказания переходов обеспечивают правильное предсказание более чем в 90 процентах случаев.
Перечислим некоторые механизмы, используемые в новом процессоре P8, имеющем наиболее совершенную систему предсказания переходов:
сочетание локального и глобального механизмов для предсказания «обычных» инструкций перехода с учётом истории их поведения;
статический предсказатель для инструкций, совершающих переход в первый раз, основанный на эмпирических закономерностях (например, «переход назад» обычно предсказывается как совершённый, так как может означать переход по циклу, а «переход вперёд» — как несовершённый);
предсказатель коротких циклов, распознающий такие переходы и определяющий число итераций цикла (позволяет правильно предсказать момент выхода из цикла);
предсказатель косвенных переходов, определяющий целевые адреса для различных исполнений инструкции перехода (с учётом возможного чередования этих адресов);
предсказатель целевых адресов для инструкций выхода из подпрограммы, использующий небольшой аппаратный стек для запоминания адресов возврата (Return Address Stack) для эффективной отработки инструкций Call — Return.
В других процессорах компании Intel используется только часть перечисленных механизмов. Эти механизмы совершенствуются с каждым новым поколением процессоров.
В процессорах AMD K8 и IBM PPC970 используются более простые механизмы предсказания обычных переходов, и отсутствуют механизмы предсказания циклов и чередующихся косвенных переходов.
Если после формирования анализируемых признаков оказалось, что направление перехода выбрано верно, все полученные результаты переписываются из буфера по месту назначения, а выполнение программы продолжается в обычном порядке. Если направление перехода предсказано неверно, то буфер результатов очищается. Также очищается и конвейер, содержащий команды, находящиеся на разных этапах обработки, следующие за командой условного перехода. При этом аннулируются результаты всех уже выполненных этапов этих команд. Конвейер начинает загружаться с первой команды другой ветви программы. Так как конвейерная обработка эффективна при большом числе последовательно выполненных команд, то перезагрузка конвейера приводит к значительным потерям производительности. Поэтому вопросам эффективного предсказания направления ветвления разработчики всех процессоров уделяют большое внимание.
Методы предсказания переходов делятся на статические и динамические. При использовании статических методов до выполнения программы для каждой команды условного перехода указывается направление наиболее вероятного ветвления. Это указание делается или программистом с помощью специальных средств, имеющихся в некоторых языках программирования, по опыту выполнения аналогичных программ либо результатам тестового выполнения программы, или программой-компилятором по заложенным в ней алгоритмам. Статические методы предсказания ветвлений слишком упрощены; они предписывают всегда выполнять или не выполнять определенные типы переходов. В некоторых процессорах (не принадлежащих к семейству x86) команды содержат «намек» на направление предполагаемого перехода, который компилятор может сделать на основе ожидаемого им поведения программы.
Но в целом более эффективное решение — динамический алгоритм предсказания ветвлений, который учитывает направления переходов, реализовывавшиеся этой командой при выполнении программы. Например, подсчитывается количество переходов, выполненных ранее по тому или иному направлению, и на основании этого определяется направление перехода при следующем выполнении данной команды. Динамический алгоритм предсказания ветвлений на самом деле оценивает поведение команд перехода за предшествующий период времени (поскольку один и тот же переход часто выполняется более чем один раз, например, в цикле). Благодаря информации о предыстории предсказания будущих ветвлений могут делаться гораздо более точно. Таблица предсказания ветвлений организуется по ассоциативному принципу, подобно кэш-памяти, ее элементы доступны по адресу команды, ветвление которой предсказывается. В некоторых реализациях элемент таблицы предсказания ветвления является счетчиком, значение которого увеличивается при правильном предсказании и уменьшается при неправильном. При этом значение счетчика определяет преобладающее направление ветвлений. Если требуется осуществить смену значения счетчика команд, то необходим, по крайней мере, один такт для распознавания команды ветвления, модификации счетчика команд и выборки команды по заданному значению счетчика команд. Эти задержки вызывают пустые такты в конвейерах процессора. Более сложные решения используют буферы, содержащие наборы команд для двух возможных результатов ветвлений.
Возможно также использование «отложенных переходов», когда одна или несколько команд после команды ветвления выполняются безусловно.
В момент определения действительного значения условия ветвления вносится изменение в историю ветвления. Если предсказание было неверным, то должна инициироваться выборка правильных команд. Результаты команд, которые были условно выполнены, должны быть аннулированы.
Механизм предсказания переходов работает одновременно с декодером инструкций и независимо от него. Благодаря эффективной реализации предсказания адреса перехода в процессорах P-III, P-M, P-M2, P8 и K8 при правильном предсказании теряется всего 1 такт. Это означает, что минимальное время, затрачиваемое на итерацию цикла (либо на один переход в цепочке переходов) составляет 2 такта. По существу, предсказатель переходов в таком цикле (или цепочке) работает в своём независимом цикле, состоящем из двух стадий — предсказания и считывания нового блока кэша — а декодер и прочие подсистемы процессора обрабатывают инструкции из вновь считываемых блоков. Поскольку предсказатель переходов «просматривает» целый блок, который может содержать большое число инструкций, то он может «опережать» декодер в своём просмотре. Благодаря этому переход может быть совершён раньше, чем исчерпаются инструкции в текущем блоке, и указанной потери такта не произойдёт — этот такт будет скрыт на фоне бесперебойной работы декодера.
В процессоре PPC970 предсказатель переходов работает менее эффективно — при правильном предсказании теряется 2 такта, а минимальное время итерации цикла составляет 3 такта. Хотя предсказатель просматривает инструкции с некоторым опережением, это может лишь частично скрыть потерю указанных двух тактов, и в результате эффективность исполнения перехода окажется ниже, чем в других процессорах.
Когда инструкция перехода попадёт в функциональное устройство для исполнения, будет выяснено, правильно предсказан этот переход, или нет. В момент её отставки при неправильном предсказании перехода все последующие инструкции будут отменены, и начнётся считывание инструкций из I-кэша по правильному адресу. Такую процедуру называют сбросом конвейера, а время (в тактах), которое было потрачено на выполнение инструкции перехода с момента её считывания из кэша, называют длиной конвейера непредсказанного перехода. Это время характеризует чистую потерю в идеальных условиях, когда инструкция проходила через все этапы «гладко» и нигде не задерживалась по внешним причинам. В реальных условиях потеря на неправильно предсказанный переход может оказаться выше.
Длина конвейера непредсказанного перехода не всегда указывается в документации и известна весьма приблизительно. Её довольно трудно замерить, так как современные предсказатели переходов работают достаточно эффективно и не позволяют добиться гарантированной доли неправильных предсказаний в тестах. Можно дать следующие примерные оценки длины конвейера: P-III — 11, P-M — 12, P-4 — 20, P-4E — 30, P8 — 14, K8 — 11, PPC970 — 13. Нужно учесть, что в процессорах P-4 и P-4E длина такта меньше, чем в других процессорах, и потеря на непредсказанный переход, выраженная в «нормализованных» тактах с учётом соотношения 1:1.4, составит соответственно 15 и 22.
6 Матричные процессоры
Конвейеры и суперскалярная архитектура обычно повышают скорость работы всего лишь в 5-10 раз. Чтобы увеличить производительность в 50, 100 и более раз, нужно создавать компьютеры с несколькими процессорами.
В любой параллельной компьютерной системе процессоры, выполняющие разные части единого задания, должны как-то взаимодействовать друг с другом, чтобы обмениваться информацией. Как именно должен происходить обмен? Для этого было предложено и реализовано две стратегии: мультипроцессоры и мультикомпьютеры. Ключевое различие между стратегиями состоит в наличии или отсутствии общей памяти. Это различие сказывается как на конструкции, устройстве и программировании таких систем, так и на их стоимости и размерах.
6.1 Матричные процессоры
Многие задачи в физических и технических науках предполагают использование массивов или других упорядоченных структур. Часто одни и те же вычисления могут производиться над разными наборами данных в одно и то же время. Упорядоченность и структурированность программ, предназначенных для выполнения такого рода вычислений, очень удобны в плане ускорения вычислений за счет параллельной обработки команд.
Матричный процессор (array processor) состоит из большого числа сходных процессоров, которые выполняют одну и ту же последовательность команд применительно к разным наборам данных. Первым в мире таким процессором был ILLIAC IV (Университет Иллинойс). Схематически он изображен на рисунке 6.1. Первоначально предполагалось сконструировать машину, состоящую из четырех квадрантов, каждый из которых содержал матрицу размером 8 х 8 из блоков процессор/память. Для каждого квадранта имелся один блок контроля. Он рассылал команды, которые выполнялись всеми процессорами одновременно, при этом каждый процессор использовал собственные данные из собственной памяти (загрузка данных происходила при инициализации). Это решение, значительно отличающееся от стандартной фон-неймановской машины, иногда называют архитектурой SIMD (Single Instruction-stream Multiple Data-stream - один поток команд с несколькими потоками данных). Из-за очень высокой стоимости был построен только один такой квадрант, но он мог выполнять 50 млн операций с плавающей точкой в секунду. Если бы при создании машины использовалось четыре квадранта, она могла бы выполнять 1 млрд операций с плавающей точкой в секунду, и вычислительные возможности такой машины в два раза превышали бы возможности компьютеров всего мира.
6.2 Векторный процессор
С точки зрения программиста, векторный процессор (vector processor) очень похож на матричный. Как и матричный, он чрезвычайно эффективен при выполнении последовательности операций над парами элементов данных. Однако в отличие от матричного процессора, все операции сложения выполняются в одном блоке суммирования, который имеет конвейерную структуру. Компания Cray Research, основателем которой был Сеймур Крей, выпустила множество моделей векторных процессоров, начиная с модели Сгау-1 A974.
Оба типа процессоров работают с массивами данных. Оба они выполняют одни и те же команды, которые, например, попарно складывают элементы двух векторов. Однако если у матричного процессора столько же суммирующих устройств, сколько элементов в массиве, векторный процессор содержит векторный регистр, состоящий из набора условных регистров. Эти регистры загружаются из памяти единственной командой, которая фактически делает это последовательно. Команда сложения попарно складывает элементы двух таких векторов, загружая их из двух векторных регистров в суммирующее устройство с конвейерной структурой. В результате из суммирующего устройства выходит другой вектор, который либо помещается в векторный регистр, либо сразу используется в качестве операнда при выполнении другой операции с векторами.
Матричные процессоры в настоящее время не выпускаются, но принцип, на котором они основаны, по-прежнему актуален. Аналогичная идея применяется в наборах ММХ- и SSE-команд процессоров Pentium 4, и она успешно решает задачу ускоренного выполнения мультимедийных программ. В этом отношении компьютер ILLIAC IV можно считать одним из прародителей процессора
Pentium 4.
6.3 Внутрипроцессорная многопоточность
Для всех современных конвейеризованных процессоров характерна одна и та же проблема - если при запросе к памяти слово не обнаруживается в кэшах первого и второго уровней, на загрузку этого слова в кэш уходит длительное время, в течение которого конвейер простаивает. Одна из методик решения этой проблемы называется внутрипроцессорной многопоточностью (on-chip multithreading). Она позволяет процессору одновременно управлять несколькими программными потоками и тем самым маскировать простои. Вкратце принцип можно изложить так: если программный поток 1 блокируется, процессор может обеспечить полную загрузку аппаратуры, запустив программный поток 2.
Основополагающая идея проста, реализуется она разными способами. Первый из них, называемый мелкомодульной многопоточностью (fine-grained multithreading), применительно к процессору, способному вызывать одну команду за такт, иллюстрирует рисунок 6.2. На рисунке 6.2 а-в изображено три программных потока (А, В, С), соответствующих 12 машинным циклам. В ходе первого цикла поток А выполняет команду A1. Поскольку эта команда завершается за один цикл, при наступлении второго цикла запускается команда А2. Ее обращение в кэш первого уровня оказывается неудачным, поэтому до извлечения нужного слова из кэша второго уровня проходит два цикла. Исполнение потока продолжается в цикле 5. Как показано на рисунке, потоки В и С также регулярно простаивают. В рамках такого решения вызов последующей команды до завершения предыдущей не осуществляется. Точнее, при наличии сложного счетчика обращений в некоторых случаях это допустимо, но такую возможность мы для простоты исключаем.
При мелкомодульной многопоточности простой маскируется путем исполнения потоков "по кругу", то есть в смежных циклах запускаются разные потоки (рисунок 6.2 г). К моменту наступления цикла 4 обращение к памяти, инициированное командой A1, завершается, поэтому даже если команде A2 нужен результат команды A1, она запускается. В таком случае максимальная продолжительность простоя составляет два цикла, то есть при наличии трех программных потоков простаивающая операция все равно завершается вовремя. При простое в 4 цикла для беспрерывной работы понадобилось бы 4 программных потока, и т. д.
Поскольку разные программные потоки никак друг с другом не связаны, каждому из них нужен свой набор регистров. Он должен быть указан для каждой вызываемой команды, и тогда аппаратное обеспечение будет знать, к какому набору регистров при необходимости нужно обращаться. Следовательно, максимальное число одновременно исполняемых программных потоков определяется в период разработки микросхемы.
Обращениями к памяти причины простоя не ограничиваются. Иногда для исполнения следующей команды требуется результат предыдущей команды, который еще не вычислен. В других случаях команда вызвана быть не может, так как она следует за условным переходом, направление которого еще неизвестно. Общее правило формулируется так: если в конвейере k ступеней, но по кругу можно запустить, по меньшей мере, k программных потоков, то в одном потоке в любой отдельно взятый момент не может выполняться более одной команды, поэтому конфликты между ними исключены. В такой ситуации процессор может работать на полной скорости, без простоя.
Естественно, далеко не всегда число доступных потоков равно числу ступеней конвейера, поэтому некоторые разработчики предпочитают методику, называемую крупномодульной многопоточностью (coarse-grained multithreading), которую иллюстрирует рисунок 6.2, д. В данном случае программный поток А продолжает выполняться последовательно, вплоть до простоя. При этом теряется один цикл. Далее происходит переключение на первую команду программного потока B (B1). Так как эта команда сразу переходит в состояние простоя, в цикле 6 выполняется уже команда C1. Так как каждый раз при простое команды теряется один цикл, по своей эффективности крупномодульная многопоточность, казалось бы, уступает мелкомодульной, однако у нее есть одно существенное преимущество - за счет меньшего числа программных потоков значительно сокращается расход ресурсов процессора. При недостаточном количестве активных потоков эта методика оптимальна.
Судя по нашему описанию, при крупномодульной многопоточности просто выполняется переключение между потоками, однако это - не единственный предусматриваемый данной методикой вариант действий. Есть возможность немедленного переключения с команд, которые потенциально способны вызвать простой (например, загрузка, сохранение и переходы), без выяснения, действительно ли намечается простой. Эта стратегия позволяет переключаться раньше обычного (сразу после декодирования команды) и исключает бесконечные циклы. Иными словами, исполнение продолжается до того момента, пока не обнаружится возможность возникновения проблемы, после чего следует переключение. Такие частые переключения роднят крупномодульную многопоточность с мелкомодульной.
Вне зависимости от используемого варианта многопоточности, необходимо как-то отслеживать принадлежность каждой операции к тому или иному программному потоку. В рамках мелкомодульной многопоточности каждой операции присваивается идентификатор потока, поэтому при перемещениях по конвейеру ее принадлежность не вызывает сомнений. Крупномодульная многопоточность предусматривает возможность очистки конвейера перед запуском каждого последующего потока. В таком случае четко определяется идентичность потока, исполняемого в данный момент. Естественно, данная методика эффективна только в том случае, если паузы между переключениями значительно больше времени, необходимого для очистки конвейера.
Все сказанное относится к процессорам, способным вызывать не более одной команды за тактовый цикл. Однако мы знаем, что для современных процессоров это ограничение не актуально. Применительно к изображению на рисунке 6.3 мы допускаем, что процессор может вызывать по 2 команды за цикл, однако утверждение о невозможности запуска последующих команд в случае простоя предыдущей остается в силе. Рисунок 6.3, а иллюстрирует механизм мелкомодульной многопоточности в сдвоенном суперскалярном процессоре. Как видно, в потоке А первые две команды запускаются во время первого цикла, однако в потоке В во втором цикле запускается только одна команда.
В суперскалярных процессорах есть еще один способ организации многопоточности - так называемая синхронная многопоточность (simultaneous multithreading), которую иллюстрирует рисунок 6.3, в. Эта методика представляет собой усовершенствованный вариант крупномодульной многопоточности, где каждый программный поток может запускать по две команды за такт, однако в случае простоя с целью обеспечения полной загрузки процессора запускаются команды следующего потока. При синхронной многопоточности полностью загружаются все функциональные блоки. В случае невозможности запуска команды из-за занятости функционального блока выбирается команда из другого потока. На рисунке предполагается, что в цикле 11 простаивает команда B8, поэтому в цикле 12 запускается команда С7.
6.4 Многопоточность в Pentium 4
Разобравшись с теорией многопоточности, рассмотрим практический пример - Pentium 4. Уже на этапе разработки этого процессора инженеры Intel продолжали работу над повышением его быстродействия без внесения изменений в программный интерфейс. Рассматривалось пять простейших способов:
повышение тактовой частоты;
размещение на одной микросхеме двух процессоров;
введение новых функциональных блоков;
удлинение конвейера;
использование многопоточности.
Самый очевидный способ повышения быстродействия заключается в том, чтобы повысить тактовую частоту, не меняя другие параметры. Как правило, каждая последующая модель процессора имеет несколько более высокую тактовую частоту, чем предыдущая. К сожалению, при прямолинейном повышении тактовой частоты разработчики сталкиваются с двумя проблемами: увеличением энергопотребления (что актуально для портативных компьютеров и других вычислительных устройств, работающих на аккумуляторах) и перегревом (что требует создания более эффективных теплоотводов).
Второй способ - размещение на микросхеме двух процессоров - сравнительно прост, но он сопряжен с удвоением площади, занимаемой микросхемой. Если каждый процессор снабжается собственной кэш-памятью, количество микросхем на пластине уменьшается вдвое, но это также означает удвоение затрат на производство. Если для обоих процессоров предусматривается общая кэш-память, значительного увеличения занимаемой площади удается избежать, однако в этом случае возникает другая проблема - объем кэш-памяти в пересчете на каждый процессор уменьшается вдвое, а это неизбежно сказывается на производительности. Кроме того, если профессиональные серверные приложения способны полностью задействовать ресурсы нескольких процессоров, то в обычных настольных программах внутренний параллелизм развит в значительно меньшей степени.
Введение новых функциональных блоков также не представляет сложности, но здесь важно соблюсти баланс. Какой смысл в десятке блоков АЛУ, если микросхема не может выдавать команды на конвейер с такой скоростью, которая позволяет загрузить все эти блоки?
Конвейер с увеличенным числом ступеней, способный разделять задачи на более мелкие сегменты и обрабатывать их за короткие периоды времени, с одной стороны, повышает производительность, с другой, усиливает негативные последствия неверного прогнозирования переходов, кэш-промахов, прерываний и других событий, нарушающих нормальный ход обработки команд в процессоре. Кроме того, чтобы полностью реализовать возможности расширенного конвейера, необходимо повысить тактовую частоту, а это, как мы знаем, приводит к повышенным энергопотреблению и теплоотдаче.
Наконец, можно реализовать многопоточность. Преимущество этой технологии состоит во введении дополнительного программного потока, позволяющего ввести в действие те аппаратные ресурсы, которые в противном случае простаивали бы. По результатам экспериментальных исследований разработчики Intel выяснили, что увеличение площади микросхемы на 5 % при реализации многопоточности для многих приложений дает прирост производительности на 25 %. Первым процессором Intel с поддержкой многопоточности стал Хеоn 2002 года. Впоследствии, начиная с частоты 3,06 ГГц, многопоточность была внедрена в линейку Pentium 4. Intel называет реализацию многопоточности в Pentium 4 гиперпоточностью (hyperthreading).
7 Закон Амдала. Закон Густафсона
7.1 Ускорение, эффективность, загрузка и качество
Параллелизм достигается за счет того, что в составе вычислительной системы отдельные устройства присутствуют в нескольких копиях. Так, в состав процессора может входить несколько АЛУ, и высокая производительность обеспечивается за счет одновременной работы всех этих АЛУ. Второй подход был описан ранее.
Рассмотрим параллельное выполнение программы со следующими характеристиками:
О(n) — общее число операций (команд), выполненных на n-процессорной системе;
Т(n) — время выполнения О(n) операций на n-процессорной системе в виде числа квантов времени.
В общем случае Т(n) < О(n), если в единицу времени n процессорами выполняется более чем одна команда, где n > 2. Примем, что в однопроцессорной системе T(1)= О(1).
Ускорение (speedup), или точнее, среднее ускорение за счет параллельного выполнения программы — это отношение времени, требуемого для выполнения наилучшего из последовательных алгоритмов на одном процессоре, и времени параллельного вычисления на n процессорах. Без учета коммуникационных издержек ускорение S(n) определяется как
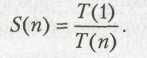
Как правило,
ускорение
удовлетворяет
условию S(n)
 n.
Эффективность
(efficiency) n-процессорной
системы — это
ускорение на
один процессор,
определяемое
выражением
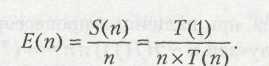
Эффективность
обычно отвечает
условию 1/n
Е(n)
n. Для более
реалистичного
описания
производительности
параллельных
вычислений
необходимо
промоделировать
ситуацию, когда
параллельный
алгоритм может
потребовать
больше операций,
чем его последовательный
аналог.
Довольно часто организация вычислений на n процессорах связана с существенными издержками. Поэтому имеет смысл ввести понятие избыточности (redundancy) в виде
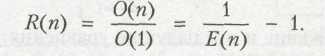
Это отношение
отражает степень
соответствия
между программным
и аппаратным
параллелизмом.
Очевидно, что
1
R(n)
n.
Определим еще одно понятие, коэффициент полезного использования или утилизации (utilization), как
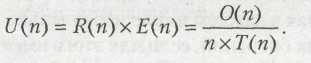
Тогда можно утверждать, что
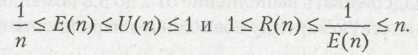
Рассмотрим пример. Пусть наилучший из известных последовательных алгоритмов занимает 8 с, а параллельный алгоритм занимает на пяти процессорах 2 с. Тогда:
S(n) = 8/2 = 4;
Е(n) = 4/5 = 0,8;
R(n) = 1/0,8 - 1 = 0,25.
Собственное ускорение определяется путем реализации параллельного алгоритма на одном процессоре.
Если ускорение, достигнутое на n процессорах, равно n, то говорят, что алгоритм показывает линейное ускорение.
В исключительных ситуациях ускорение S(n) может быть больше, чем n. В этих случаях иногда применяют термин суперлинейное ускорение. Данное явление имеет шансы на возникновение в двух следующих случаях:
Последовательная программа может выполняться в очень маленькой памяти, вызывая свопинги (подкачки), или, что менее очевидно, может приводить к большему числу кэш-промахов, чем параллельная версия, где обычно каждая параллельная часть кода выполняется с использованием много меньшего набра данных.
Другая причина повышенного ускорения иллюстрируется примером. Пусть нам нужно выполнить логическую операцию A1 v A2, где как A1 так и А2 имеют значение «Истина» с вероятностью 50%, причем среднее время вычисления Ai, обозначенное как T(Ai), существенно различается в зависимости от того, является ли результат истинным или ложным.
Пусть
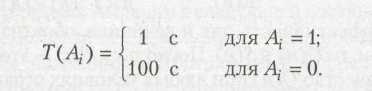
Теперь получаем четыре равновероятных случая (Т — «истина», F — «ложь»):
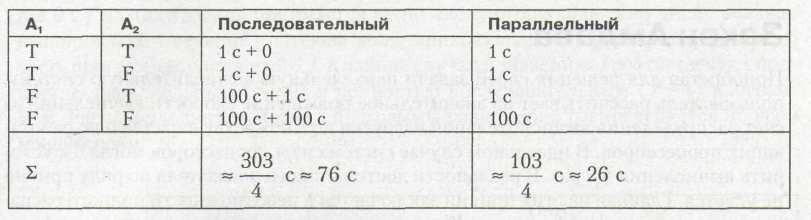
Таким образом, параллельные вычисления на двух процессорах ведут к среднему ускорению:
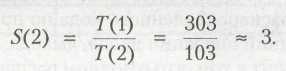
Отметим, что суперлинейное ускорение вызвано жесткостью последовательной обработки, так как после вычисления еще нужно проверить А2. К факторам, ограничивающим ускорение, следует отнести:
Программные издержки. Даже если последовательные и параллельные алгоритмы выполняют одни и те же вычисления, параллельным алгоритмам присущи добавочные программные издержки — дополнительные индексные вычисления, неизбежно возникающие из-за декомпозиции данных и распределения их по процессорам; различные виды учетных операций, требуемые в параллельных алгоритмах, но отсутствующие в алгоритмах последовательных.
Издержки из-за дисбаланса загрузки процессоров. Между точками синхронизации каждый из процессоров должен быть загружен одинаковым объемом работы, иначе часть процессоров будет ожидать, пока остальные завершат свои операции. Эта ситуация известна как дисбаланс загрузки. Таким образом, ускорение ограничивается наиболее медленным из процессоров.
Коммуникационные издержки. Если принять, что обмен информацией и вычисления могут перекрываться, то любые коммуникации между процессорами снижают ускорение. В плане коммуникационных затрат важен уровень гранулярности, определяющий объем вычислительной работы, выполняемой между коммуникационными фазами алгоритма. Для уменьшения коммуникационных издержек выгоднее, чтобы вычислительные гранулы были достаточно крупными, и доля коммуникаций была меньше.
Еще