Современная криптография
Модификация (переделка).
Борис изменяет сообщение и утверждает, что данное (измененное) сообщение послал ему Александр.
Подделка.
Борис формирует сообщение и утверждает, что данное (измененное) сообщение послал ему Александр.
Активный перехват.
Владимир перехватывает сообщения между Александром и Борисом с целью их скрытой модификации.
Для защиты от модификации, подделки и маскировки используются цифровые сигнатуры.
Маскировка (имитация).
Владимир посылает Борису сообщение от имени Александра .
В этом случае для защиты также используется электронная подпись.
Повтор.
Владимир повторяет ранее переданное сообщение, которое Александра посылал ранее Борису . Несмотря на то, что принимаются всевозможные меры защиты от повторов, именно на этот метод приходится большинство случаев незаконного снятия и траты денег в системах электронных платежей.
Наиболее действенным методом защиты от повтора являются
использование имитовставок,
учет входящих сообщений.
Протоколы электронной подписи
Протоколы (схемы) электронной подписи являются основными криптографическим средством обеспечения целостности информации.
Схема Эль Гамаля.
Пусть обоим участникам протокола известны некоторое простое число p, некоторой порождающей g группы Z*p и некоторая хэш-функция h.
Подписывающий выбирает секретный ключ x ÎR Z*p-1 и вычисляет открытый ключ y = g-x mod p. Пространством сообщений в данной схеме является Zp-1 .
Для генерации подписи нужно сначала выбрать uÎR Zp-1. Если uÏR Z*p-1 (что проверяется эффективно), то необходимо выбрать новое u. Если же u ÎR Z*p-1 , то искомой подписью для сообщения m является пара (r,s), где r = gu mod p и
s = u-1(h(m) +xr) mod (p-1). Параметр u должен быть секретным и может быть уничтожен после генерации подписи.
Для проверки подписи (r,s) для сообщения m необходимо сначала проверить условия r Î Z*p и s Î Zp-1 . Если хотя бы одно из них ложно, то подпись отвергается. В противном случае подпись принимается и только тогда, когда gh(m) º yrrs(mod p ).
Вера в стойкость схемы Эль Гамаля основана на (гипотетической) сложности задачи дискретного логарифмирования по основанию g.
Схема Фиата – Шамира.
Для ее обеспечения центр обеспечения безопасности должен выбрать псевдослучайную функцию f, криптографическую хэш-функцию h, а также выбрать различные большие простые числа p, q и вычислить n = pq. Число n и функции f и h являются общедоступными и публикуются центром, а числа p и q должны быть секретными. Кроме того, схема использует два натуральных параметра l и t.
Для каждого пользователя центр обеспечения безопасности генерирует идентификационную информацию I, содержащую, например, имя пользователя, его адрес, идентификационный номер и т. п., и для каждого j = 1,…,l вычисляет
yi = f(I,j), отбирает среди них квадратичные вычеты по модулю n (изменив обозначения, мы считаем, что yi для всех j = 1,…,l являются квадратичными вычетами по млдулю n), и вычисляет xi – наименьший квадратичный корень по модулю n из yi-1 mod n. Числа yi играют роль открытого ключа, а xi – секретного. Так как эти ключи вычисляются с использованием I, схема Фивта – Шамира относится к схемам, основанным на идентификационной информации (identity based). В другом варианте схемы Фиата – Шамира сразу выбираются (псевдослучайным образом) параметру yi. На практике идентификационная информация I и/или открытый ключ (y1,…,yl) каждого пользователя помещаются в некоторый справочник, доступный всем пользователям для чтения, но не доступный для записи. Для обеспечения аутентичности, данные в этом справочнике заверяются подписью центра обеспечения безопасности. Секретный ключ (x1,…,xl) и идентификационная информация I могут быть помещены на интеллектуальную карточку пользователя.
Для генерации подписи для обеспечения m подписывающий
выбирает uiÎR Zn (каждое ui – независимо друг от друга) и вычисляет ri = ui2 mod n для i = 1,…,t;
вычисляет h(m,r1,…,rt) и полагает биты eij(i = 1,…,t, j = 1,…,t) равными первым lt битам h(m,r1,…,rt);
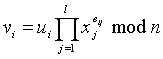
вычисляет для i = 1,…,t.
Искомой подписью для сообщения m является набор (eij, vi | i = 1,…,t, j = 1,…,l)
Для проверки подписи (eij, vi | i = 1,…,t, j = 1,…,l) для сообщения m подписывающий
вычисляет vj = h(I,j) для j = 1,…,l или берет их из общедоступного справочника и сравнивает их с имеющимися в подписи (если обнаружено несовпадение – подпись отвергается);
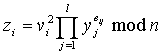
вычисляет для i = 1,…,t.
Подпись принимается тогда и только тогда, когда первые lt битов h(m,z1,…,zt) равны eij.
Несомненным достоинством схемы Фмата – Шамира является отсутствие дискретного экспонентрирования, что делает схему весьма эффективной. Но с другой стороны, в этой схеме длины ключей и подписи значительно больше, чем в схемах типа Эль Гамаля.
Схема стандарта электронной подписи ANSI США (DSA)
Эта схема аналогична схеме Эль Гамаля, но несколько эффективнее, так как в ней порядок g меньше, чем в схеме Эль Гамаля. Пусть в открытом доступе имеются некоторые простые числа p,q такие, что q | p-1, а также элемент g порядка q группы Z*q и хэш-функция h, действующая из пространства сообщений в Z*q .Параметры p,q,g и хэш-функция h могут быть выбраны центром обеспечения безопасности. Подписывающий выбирает секрктный ключ x ÎR Zq и вычисляет открытый ключ y = gx mod p. Для генерации подписи для сообщения m нужно выбрать u ÎR Z*q {1} и вычислить r = gu mod p mod q и s = u-1 (h(m) +xr) mod q. Параметр u должен быть секретным и может быть уничтожен после вычисления r и s. Если r = 0 или s = 0, то выбираются новое значение u и процесс генерации подписи повторяется. В противном случае (r,s) – искомая подпись для сообщения m.
Для проверки подписи (r,s) для сообщения m необходимо сначала проверить условие 0 < r < q и 0 < s <q. Если хотя бы одно из них ложно, то подпись отвергается. В противном случае подпись принимается тогда и только тогда, когда
gvh(m)yvr mod p mod q = r, где v = s-1 mod q.
Схема стандарта электронной подписи ГОСТ.
Пусть p,q,g,h,x,y имеют тотже смысл, что и в схеме DSA. Для генерации подписи для сообщения m нужно выбрать u ÎR Z*q {1} и вычислить
r = gu mod p mod q и s = u-1 (h(m) +xr) mod q. Параметр u должен быть секретным и может быть уничтожен после вычисления r и s. Если r = 0 или s = 0, то выбираются новое значение u и процесс генерации подписи повторяется. В противном случае (r,s) – искомая подпись для сообщения m.
Для проверки подписи (r,s) для сообщения m необходимо сначала проверить условие 0 < r < q и 0 < s <q. Если хотя бы одно из них ложно, то подпись отвергается. В противном случае подпись принимается тогда и только тогда, когда
gwsy-wr mod p mod q = r, где w = h(m)-1 mod q.
Схема RSA .
В схеме RSA подписывающий выбирает два различных больших простых числа p и q, которые играют роль секретного ключа, и публикует открытый ключ (n,e), где
n = pq, а e – некоторое число, взаимно простое с j(n) = (p-1)(q-1) (j - функция Эйлера). Подписью для сообщения m является s(m) = h(m)d mod n , где
d = e-1 mod j(n)(очевидно, что, зная p и q, можно эффективно вычислить d) и h – хэш-функция. Проверка подписи s для сообщения m состоит в проверке сравнения
se º h(m) (mod n) .
Схема RSA достаточно эффективна и широко используется на практике. Вера в стойкость схемы основана на (гипотетической) трудности задачи факторизации целых чисел.
Глава 3. Хэш-функции.
Хэш-функции являются необходимым элементом ряда криптографических схем. Под этим термином понимаются функции, отображающие сообщения произвольной длинны (иногда длинна сообщения ограничена, но достаточно большим числом) в значения фиксированной длинны. Последние часто называют хэш-кодами. Таким образом, у всякой хэш-функции h имеется большое количество коллизий, т.е. пар значений x ¹ y таких, что h(x) = h(y). Основное требование, предъявляемое к хеш-функциям, состоит в отсутствии эффективных алгоритмов поиска коллизий.
В ряде криптографических приложений, особенно в схемах электронной цифровой подписи, необходимым элементом является криптографически стойкая
хэш-функция.
Практические методы построения хэш-функций можно условно разделить на три группы: на основе какого-либо алгоритма шифрования, на основе какой-либо известной вычислительно трудной математической задачи и методы построения "с нуля".
Наиболее эффективной с точки зрения программной реализации, оказываются хэш-функции построенные "с нуля".
В данной дипломной работе в качестве алгоритма построения хэш-функции использовался алгоритм Ривеста MD5, который будет описан ниже.
Универсальные семейства хэш-функций.
Понятие универсального семейства хэш-функций было введено в 1979 г. Картером и Вегманом [CW].
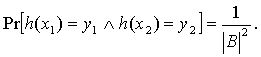 |
Определение 1. Пусть А и В - два конечных множества и H - семейство функций из А в В. H называется универсальным семейством хэш-функций если для любых х1 ¹ х2 Î А и y1,y2 Î В
Вероятность берется по случайному равновероятному выбору функции h из семейства Н.
Обычно предполагается, что мощность образа (множества В) меньше, чем мощность прообраза (А), и что хэш-функции "сжимают" входные слова. Как правило, рассматриваются семейства хэш-функций, которые переводят множество всех двоичных строк длины п в множество всех двоичных строк длины m, где m < п. Говоря неформально, универсальное семейство хэш-функций — это метод "перемешивания" с сокращением длины строк, при котором выходные значения распределены равномерно.
Семейство хэш-функций из определения 1 принято назвать 2-универсалъным семейством. Если в этом определении заменить пары значений x и y на наборы из k значений, то получим определение k-универсального семейства хэш-функций .
Лемма о композиции [DeSY]. Пусть H1 и Н2 - 2-универсальные семейства, хэш-функций, действующих из C1 в C2 и из С2 в С3 соответственно.
Тогда
Н = {h == h2 о h1 | h1 Î H1, h2 Î H2},
где o обозначает композицию, является 2-универсальным семейством хэш-функции, действующих из C1 в C3.
Нас эти семейства интересуют в основном как инструмент для определения и построения семейств односторонних хэш-функций.
С прикладной точки зрения универсальные семейства хэш-функций должны удовлетворять некоторым дополнительным требованиям.
Во-первых, хэш-функции должны быть эффективно вычислимыми. Часто это требование включают в определение универсального семейства и формализуют следующим образом.


 У каждой хэш-функции h Î H имеется достаточно короткое описание h и существуют два эффективных алгоритма, первый из
которых по запросу и выдает случайное h Î H, а второй по h аргументу x вычисляет h{x).
Во-вторых, во многих случаях требуются семейства хэш-функций, которые определяются не на строках только данной фиксированной длины, а на строках всех длин (или бесконечной последовательности длин). В этом случае множество Нп, которое действует согласно определению 1 на строках длины п, называют коллекцией хэш-функций, а универсальным семейством называют {Нп}.
В-третьих, для криптографических приложений иногда требуется так называемое свойство доступности коллизий (collision accessibility). Оно требует существования эффективного алгоритма, который по данным х1 и х2 выбирает h Î H такую, что
h(х1) = h(х2), равновероятным образом среди всех функций из Н, удовлетворяющих этому свойству.
Пусть F = GF(2k) и chop: {0,1}k ® {0,1}k-1 - функция, которая просто отбрасывает последний бит. Тогда семейство хэш-функций {chop(ax+b)} является 2-универсальным и удовлетворяет свойству доступности коллизий.
Пусть А = {0,1}n и В {0,1}m. Для х Î {0,1}n и у Î {0,1}n+m-1 определим конволюцию у о х элементов у и х как вектор длины m, i-я координата которого
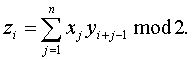 |
определяется по формуле
Тогда семейство H = { (a о х) Å b | a Î {0,1}n+m-1 , b Î {0,1}m} представляет собой универсальное семейство хэш-функций.
Семейства односторонних хэш-функций.
Пусть {n1i} и { n0i} - две возрастающие последовательности натуральных чисел такие) что для всех i n1i ³ n0i и существует такой полином q, что q(n0i,) ³ n1.
(такие последовательности полиномиально связаны).
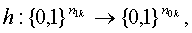 |
Пусть Нk - коллекция функций такая, что для всех h Î Hk
 и
пусть .
Предположим, что А - вероятностный алгоритм, работающий за поли-номиальное время, который на входе k выдает строку x Î {0,1}n1k, называемую исходным значением, и затем для данной случайной h Î Hk пытается найти у Î {0,1}n1k такое, что h{x) = h{y), но х ¹ у.
Определение 2. Семейство U называется универсальным семейством односторонних хэш-функций, если для всех полиномов р, для всех полиномиальных вероятностных алгоритмов А и всех достаточно больших k выполняются следующие условия:
x Î {0,1}n1k - исходное значение для А, то
Рг[А(h,x) = у, h{x) - h(y), у ¹ х] < 1/p(n1k),
где вероятность берется по всем h из Hk и по всем случайным выборам алгоритма А.
2. Для любой h Î Hk существует описание h. полиномиальной (от n1k) длины такое, что по этому описанию и по х значение h(x) вычислимо за полиномиальное время.
3. Коллекция Hk доступна, т. е. существует алгоритм G, который на входе k равномерно по вероятности генерирует описание функции h Î Hk .
Заметим, что Hk рассматривается как набор описаний функций: два разных описания могут соответствовать одной и той же функции.
В данном определении А - это машина Тьюринга (однородная модель). Определение универсального семейства односторонних хэш-функций, а котором А - полиномиальная схема (неоднородная модель) формулируется аналогично, но в п. 1 вероятность берется только по выбору h из Hk.
Также заметим, что это семейство называется семейством хэш-функций с трудно обнаружимыми коллизиями.
Алгоритмы построения хэш-функций.
N –хэш.
Алгоритм разработан Nippon Telephone & Telegraph. N- хэш использует блоки длинной 128 бит, размешивающую функцию. На вход пошаговой хэш-функции в качестве аргумента поступают очередной блок сообщения Mi длинной 128 бит и хэш-код hi-1 предыдущего шага.
h0 = I, где I – синхропосылка.
hi = g(Mi,hi-1) Å Mi Å hi-1.
Хэш-кодом всего сообщения объявляется хэш-код, получаемый в результате преобразования последнего блока текста.
Функция g вначале меняет местами старшие и младшие части (по 64 бита каждая) хэш-кода предыдущего шага, покоординатно складывая полученное значение с величиной 1010…..1010 и текущим блоком текста Mi. Полученная величина поступает на вход каскада из N (n = 8) преобразующих функций. Вторым аргументом каждой из преобразующих функций является хэш-код предыдущего шага, сложенный покоординатно с одной из восьми констант.
На рисунке 1 использованы следующие условные обозначения:
EXG –старшая и младшая части входного блока меняются местами;
V =1010…1010 (128 бит) в двоичной записи.
Vj = d||Aj1||d||Aj2||d||Aj3||d||Aj4; здесь || обозначает конкатенацию бинарных строк;
d = 00…00 в двоичной записи;
Ajk = 4 * (j-1) + k (k = 1,2,3,4: Ajk длинной 8 бит);
PS – преобразующая функция.
На рисунке 2 представлена схема преобразующей функции. Каждый из аргументов при этом разбивается на 4 блока:X1||X2||X3||X4, P= P1||P2||P3||P4, схема вычисления функции f представлена на рисунке 3.
S0(a,b) = (левый циклический сдвиг на 2 бита) ((a+b)mod256):
S1(a,b) = (левый циклический сдвиг на 2 бита) ((a+b+1)mod256):
Результат действия преобразующей функции PS предыдущего шага становится входным аргументом очередной преобразующей функции PS.
Процесс,