Алгоритмы поиска подстроки в строке
Type
TBMTable = Array [0..255] of Integer;
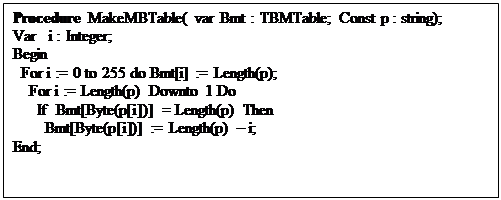
Реализация процедуры, вычисляющая таблицу смещений для образца p, представлена в приложении 5.
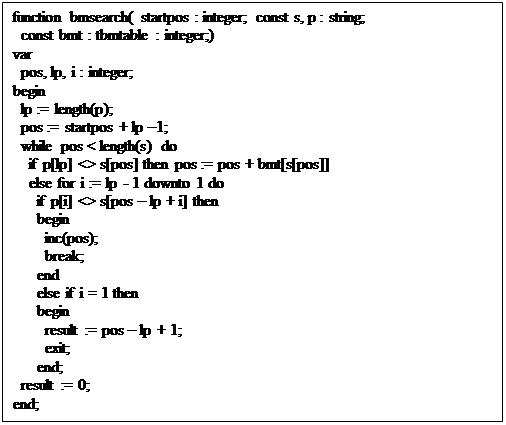
Теперь пишется функция, осуществляющая поиск (см. Приложение 6).
Параметр StartPos позволяет указать позицию в строке s, с которой следует начинать поиск. Это может быть полезно в том случае, если надо найти все вхождения p в s. Для поиска с самого начала строки следует задать StartPos равным 1. Если результат поиска не равен нулю, то для того, чтобы найти следующее вхождение p в s, нужно задать StartPos равным значению «предыдущий результат плюс длина образца».
Глава 2. Практическая часть.
Дан некоторый текст, в котором следует найти фрагмент этого текста.
Данную задачу можно интерпретировать как поиск подстроки в строке.
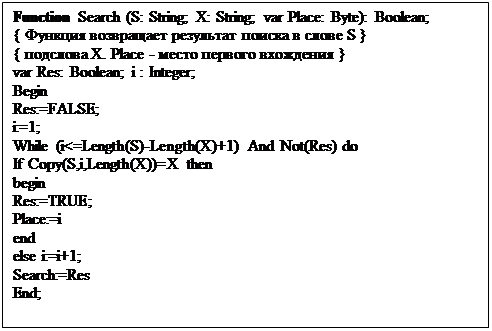
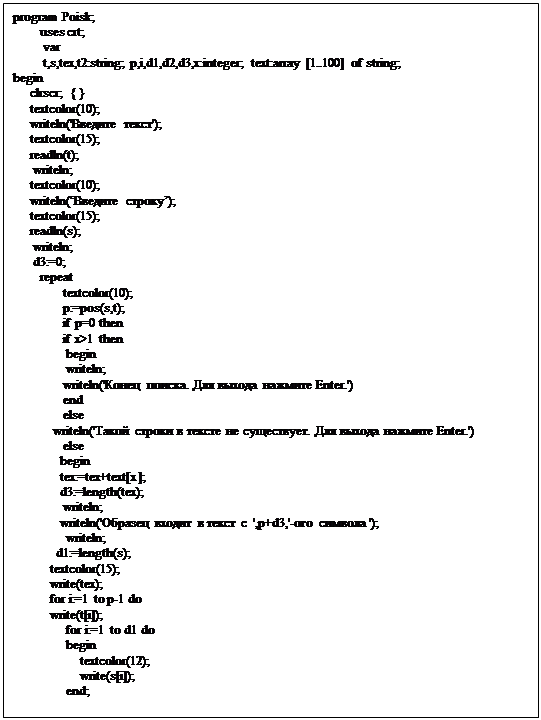
Эту задачу я реализовал при помощи алгоритма последовательного (прямого) поиска. Программный код задачи реализовал на языке программирования Turbo Pascal 7.1 и он представлен в приложении 7.
Описание работы программы.
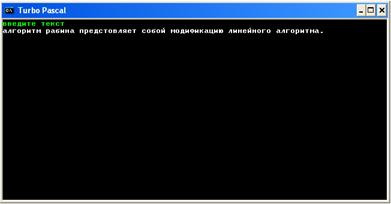
После запуска программа запрашивает ввод текста:
Например, введём следующий текст: ”алгоритм рабина представляет собой модификацию линейного алгоритма.”
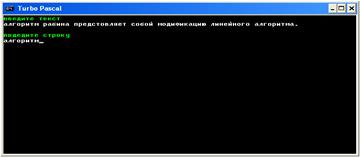
Далее программа запрашивает ввод строки(подстроки) для поиска:
Например, вводим фрагмент текста: ”алгоритм”
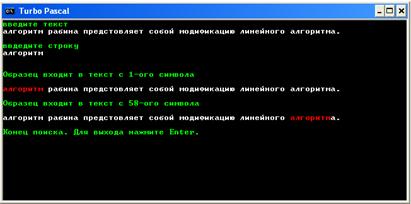
После ввода, программа ищет строку в тексте, если строка существует то программа выводит текст на экран, выделяет строку красным цветом и выдает с какого символа начинается строка:
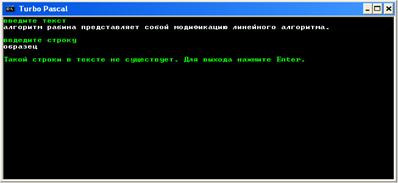
Если фрагмента нет в тексте, то программа выдаст сообщение о том, что данной строки в тексте не существует:
Глава 3. Анализ алгоритмов
В курсовой работе я рассмотрел несколько алгоритмов. Была проведена оценка их временной и емкостной сложности. Экспериментальный анализ состоял в измерении времени, за которое алгоритм выполняет конкретно поставленную задачу.
Задача: Имеется несколько текстовых файлов, содержащих 10000 записей вида:
§ строка
§ подстрока (имеющаяся в данной строке)
§ место вхождения
§ длина подстроки,
причем с разными максимальными длинами строк и подстрок.
Алфавит кириллицы содержит 32 буквы, поэтому длина строки будет не более 10, 100, 250 символов.
Проводится поиск подстрок в строках для каждого из алгоритмов и измеряется время работы программы. При этом будет учитываться следующее:
· строки предварительно загружаем в оперативную память (в виде массива), причем время считывания в массив не учитывается. Предобработка (создание таблиц перехода) входит в общее время.
· каждый алгоритм запускается 5 раз, время выбирается наименьшее.
Эксперимент проходил на ПК:
Процессор Intel Pentium IV 2,66Ггц
1024 Мб ОЗУ
Компилятор Turbo Pascal 7.1
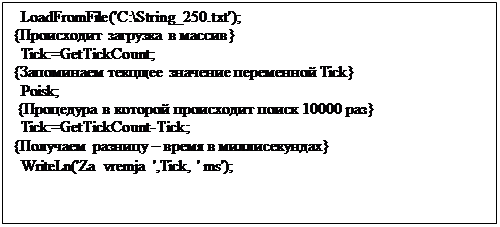
Фрагмент кода тестируемой программы приводится в Приложении 8.
Такой замер времени даст приблизительные результаты, так как напрямую зависит от характеристик и загрузки процессора. Поэтому во время проведения эксперимента, отключались все сторонние и фоновые приложения, которые не влияют на работу программы. При запуске одной и той же задачи можно получить разное время, поэтому совершается несколько запусков, из которых выбирается наилучший результат.
Эксперимент проводился для четырех алгоритмов – представителей классов алгоритмов. Так как все алгоритмы ставились в одинаковые условия, то можно провести их сравнительный анализ. Заметим, что данный анализ применим только для данных параметров поиска, и при иных условиях может отличаться.
|
| Алгоритм | Время выполнения (мс) | ||
| Длина ≤10 | Длина ≤100 | Длина ≤250 | |
| Послед. Поиск | 15 | 93 | 234 |
| Алгоритм Рабина | 15 | 63 | 93 |
| КМП | 5 | 30 | 50 |
| БМ | 31 | 31 | 32 |
Из таблицы видно, что алгоритм Бойера – Мура справился с экспериментальной задачей быстрее остальных. Следует, однако, заметить, что его эффективность растет лишь с увеличением длины строки и, соответственно, длины образца. Так при длине строки меньшей или равной 10 символов, он показал себя хуже, чем последовательный поиск. Аналогичные результаты показывает и алгоритм КМП, как для коротких, так и для длинных слов. Его можно использовать как универсальный, когда неизвестны длины строки и образца.
Алгоритм Рабина, при его схожести с последовательным работает быстрее, а его простота и малые трудозатраты на реализацию, делают его привлекательным для использования в неспециальных программах.
Наихудший результат показал алгоритм последовательного поиска. Как предполагалось лишь при небольшом увеличении длины строки, он работает существенно медленнее остальных алгоритмов.
Заключение
В процессе выполнения курсовой работы были рассмотрены различные алгоритмы поиска подстроки в строке и проведен их сравнительный анализ, результаты которого представлены в таблице 2 (см. приложение 9).
Изучив полученные результаты легко можно сделать вывод, что алгоритм Бойера – Мура является ведущим по всем параметрам. Но, как показывает эксперимент, алгоритм Кнута – Мориса - Пратта, превосходит алгоритм БМ на небольших длинах образца. Поэтому нельзя сделать вывод, что какой-то из алгоритмов является самым оптимальным. Каждый алгоритм эффективно работает в определенных классах задач, об этом еще говорят различные узконаправленные улучшения каждого из алгоритмов. Таким образом, тип алгоритмов поиска подстроки в строке следует выбирать только после точной постановки задачи, определение её целей и функциональности, которая она должна реализовать.
Только после этого этапа необходимо переходить к реализации программного кода.
В связи с глобализацией информации в сети internet был разработан интеллектуальный поиск. Который позволяет найти документ по смыслу содержащейся в нем информации, то есть документы по заданной теме. В системе реализован алгоритм с использованием компьютерной обработки документа. Согласно гипотезе Ципфа смысл документа зависит от частоты терминов, встречающихся в документе. Однако гораздо важнее не сама частота слова, а то, насколько часто в текущем документе это слово встречается относительно других слов.
Список используемой литературы:
1) Альсведе Р., Вегенер И. "Задачи поиска" , 1982г, Издательство "Мир"
2). Ахо, Альфред Структура данных и алгоритмы [Текст]. – М.: Издательский дом «Вильямс», 2000. - 384 с.
3). Белоусов А. Дискретная математика [Текст]. – М.: Издательство МГТУ им. Н.Э. Баумана, 2001. – 744 с.
4). Брайан, К. Практика программирования [Текст].- СПб:. Невский диалект, 2001. - 381 с.
5). Вирт, Н. Алгоритмы и структуры данных [Текст].– М:. Мир, 1989. – 360 с.
6) Кнут, Д. Искусство программирования на ЭВМ [Текст]: Том 3. – М:. Мир, 1978. – 356 с.
7). Кормен, Т. Алгоритмы: построение и анализ [Текст]/ Т. Кормен, Ч. Лейзерсон, Р. Ривест - М.: МЦНМО, 2002. М.: МЦНМО, 2002.
8). Успенский В. Теория алгоритмов: основные открытия и приложения [Текст]. – М.: Наука, 1987. – 288 с.
9). Шень, А. Программирование: теоремы и задачи [Текст]. – М.: Московский центр непрерывного математического образования, 1995.
Электронные источники.
1) ipkro.isu/informat/methods/findsort/
2) delphikingdom/asp/viewitem.asp?catalogid=65
3) revolution./programming/00013926_0.html
4) ric.uni-altai/fundamental/pascal1/lab15/l15-teor.htm
5) rsdn/article/alg/textsearch.xml
Приложение 1
Реализация алгоритма последовательного поиска
Приложение 2
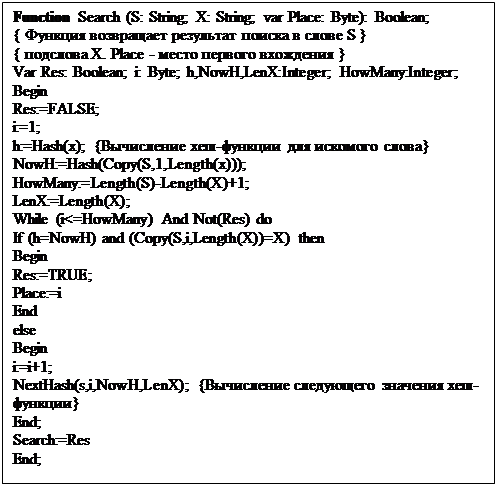
Реализация алгоритма Рабина
Приложение 3
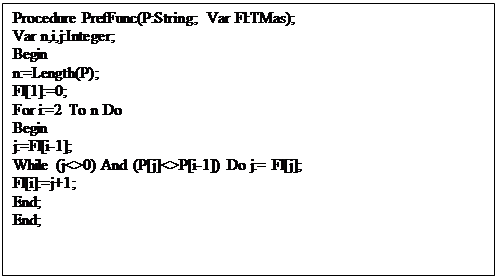
Алгоритм Кнута-Морриса-Пратта
Нахождение наибольшего искомого префикса.
Приложение 4
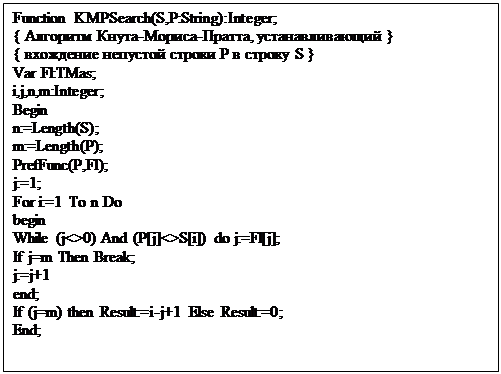
Реализация алгоритма Кнута-Морриса-Пратта
Приложение 5
Алгоритм Бойера-Мура
Реализация процедуры, вычисляющая таблицу смещений для образца p.
Приложение 6
Алгоритм Бойера-Мура
Функция, осуществляющая поиск.
Приложение 7
Реализация программного кода
|
Приложение 8
Фрагмент кода тестируемой программы
Приложение 9
Общие результаты с анализов рассмотренных алгоритмов
|
| Примечания | Алгоритмы, основанные на алгоритме последовательного поиска | Малые трудозатраты на программу, малая эффективность | Алгоритм Кнута-Морриса-Пратта | Универсальный алгоритм, если неизвестна длина образца | Алгоритм Бойера-Мура | Алгоритмы этой группы наиболее эффективны в обычных ситуациях. Быстродействие повышается при увеличении образца или алфавита. | |
| Время работы (мс) при длине строки ≤250 | 234 | 93 | 31 | 32 | |||
| Затраты памяти | нет | нет | O(m) |
Если Вам нужна помощь с академической работой (курсовая, контрольная, диплом, реферат и т.д.),
обратитесь к нашим специалистам. Более 90000 специалистов готовы Вам помочь.
Бесплатные корректировки и доработки. Бесплатная оценка стоимости работы.
Нужна помощь в написании работы?
Мы - биржа профессиональных авторов (преподавателей и доцентов вузов). Пишем статьи РИНЦ, ВАК, Scopus.
Помогаем в публикации. Правки вносим бесплатно.
Похожие рефераты: | |||