Использование XML совместно с SQL
cmd.Properties("xml root") = "my_root"
cmd.Execute , , adExecuteStream
Dim str
str = cmdStream.ReadText
do
loop while ie.Busy
ie.Document.writeln CStr(str)
ie.Document.close
ie.visible = 1
Здесь я использовал новую аннотированную схему и шаблон трансформации.
Аннотированная схема:
|
<?xml version="1.0" encoding="windows-1251" ?> <Schema xmlns="urn:schemas-microsoft-com:xml-data" xmlns:sql="urn:schemas-microsoft-com:xml-sql" xmlns:dt="urn:schemas-microsoft-com:datatypes">
<ElementType name="Авторы" sql:relation="authors"> <AttributeType name="Имя" dt:type="string" /> <AttributeType name="Фамилия" dt:type="string" /> <AttributeType name="Адрес" dt:type="string" /> <attribute type="Имя" sql:field="au_fname" /> <attribute type="Фамилия" sql:field="au_lname" /> <attribute type="Адрес" sql:field="address" /> </ElementType> </Schema> |
Шаблон трансформации:
|
<?xml version="1.0" encoding="windows-1251" ?> <xsl:stylesheet xmlns:xsl="w3/1999/XSL/Transform" version="1.0">
<xsl:template match = "*"> <xsl:apply-templates /> </xsl:template> <xsl:template match = "/"> <html> <body> <table border="1" style="table-layout:fixed" width="600"> <tr bgcolor="teal"> <th><font color="white">Имя</font></th> <th><font color="white">Фамилия</font></th> <th><font color="white">Адрес</font></th> </tr> <xsl:for-each select="my_root/Авторы"> <tr> <td><font color="teal"><xsl:value-of select="@Имя"/></font></td> <td><font color="teal"><xsl:value-of select="@Фамилия"/></font></td> <td><font color="teal"><xsl:value-of select="@Адрес"/></font></td> </tr> </xsl:for-each> </table> </body> </html> </xsl:template> </xsl:stylesheet> |
XML-документ на стороне клиента
Предположим, ваш SQL Server работает в очень напряженном режиме, и вы не хотите нагружать его еще больше, заставляя формировать XML-документы. Можно сделать так: создать обычный рекордсет и загрузить его в формате XML в объект DOMDocument или какой-либо другой. Решение на первый взгляд здравое, однако, поработав немного с таким документом, вы поймете, что это не то. Во-первых, структура такого XML-документа задается жестко без возможности изменения. Во-вторых, схема сохраняется в формате XDR, а он уже стар и может не удовлетворять вашим потребностям. К тому же возникают проблемы с выполнением шаблонов и XPath-запросами. Для решения этих (и многих других) проблем был создан новый сервисный провайдер – SQLXMLOLEDB. Как и другие сервисные провайдеры (например, MSDataShape) он предназначен только для преобразования результирующего набора строк в нужный формат. Так как SQLXMLOLEDB ничего не знает о форматах протоколов обмена данными с SQL-серверами, он использует для этого соответствующий провайдер. К сожалению, провайдер SQLXMLOLEDB пока умеет работать совместно только с SQLOLEDB-провайдером для SQL Server, однако в будущем (по крайней мере, я очень надеюсь) он сможет работать с другими провайдерами, например, MSDAORA (провайдер для Oracle). Если такая поддержка будет встроена, у нас будет возможность получать XML-документы от источников, которые не поддерживают XML напрямую.
В режиме форматирования XML-документа на клиенте можно использовать в запросе предикат GROUP BY и агрегатные функции, недоступные в режиме формирования XML-документа на сервере (в режиме FOR XML AUTO). Как и любой другой сервисный провайдер, SQLXMLOLEDB предоставляет свой синтаксис запросов. К счастью, он не так сложен, как, например, синтаксис провайдера MSDataShape и ограничивается, по существу, следующим:
| Оператор | Назначение |
| FOR XML RAW | Аналогичен серверному FOR XML RAW |
| FOR XML NESTED | Аналогичен серверному FOR XML AUTO |
| FOR XML EXPLICIT | Аналогичен серверному FOR XML EXPLICIT |
Архитектура формирования документов на клиентской стороне изображена на рисунке 1.
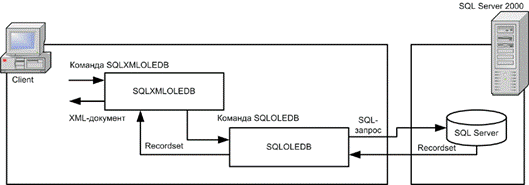
Рисунок 1.
| Возможность | Формирование на клиенте | Формирование на сервере |
| Использование предиката GROUP BY и агрегатных функций совместно с FOR XML AUTO (NESTED) | Да | Нет |
| Возможность получения одновременно нескольких рекордсетов | Нет | Да |
| Задание имен элементов результирующего документа с помощью псевдонимов таблиц | Нет | Да |
Другие отличия вы можете найти в MSDN. Давайте перейдем к примерам.
Шаблон с агрегатными функциями
Ниже приведен пример использования FOR XML NESTED и атрибута client-side-xml. Шаблон возвращает документ с названиями городов и количеством авторов в каждом городе. Атрибут client-side-xml устанавливается в 1, что говорит об использовании клиентского форматирования.
|
<?xml version="1.0" ?> <my_root xmlns:sql="urn:schemas-microsoft-com:xml-sql"> <sql:query client-side-xml="1"> select count(*) as number_of_authors,city from authors group by city order by number_of_authors desc for xml nested </sql:query> </my_root> |
Формирование XML-документа на клиенте с помощью ADO
У объекта Command есть свойство ClientSideXML, которое позволяет формировать XML-документ на клиенте. Рассмотрим пример:
|
<% Const adCmdText = 1 Const adExecuteStream = &H400 Response.ContentType = "text/xml" ' Creating the objects Dim conn,cmd Set conn = Server.CreateObject("ADODB.Connection") Set cmd = Server.CreateObject("ADODB.Command") conn.Provider = "sqlxmloledb" conn.Open "Data Source=server;Initial catalog=pubs;Data Provider=sqloledb", _ "user","password" Dim s s = "select count(*) as number_of_authors,city" & _ "from authors" & _ "group by city" & _ "order by number_of_authors desc" & _ "for xml nested" Set cmd.ActiveConnection = c cmd.Properties("ClientSideXML") = "True" cmd.CommandType = adCmdText cmd.CommandText = s cmd.Properties("Output Stream") = Response cmd.Properties("xml root") = "root" cmd.Execute , , adExecuteStream Set cmd = nothing Set conn = nothing %> |
В качестве основного провайдера задан провайдер SQLXMLOLEDB. Провайдер SQL Server’а задается с помощью строки Data Provider=sqloledb. Чтобы указать, что используется клиентское форматирование, свойство ClientSideXML установлено в true. Следует заметить, что это свойство (т.е. клиентское форматирование) можно использовать только для типа adCmdText. При вызове хранимых процедур его устанавливать нельзя.
Апдейтаграммы и XML Bulk Load
В этом разделе мы рассмотрим способы изменения данных (удаление, добавление и правка) с помощью XML-документов. Какие достоинства у этого метода перед использованием SQL-инструкций непосредственно в шаблоне? Во-первых, апдейтаграммы намного понятнее простым пользователям или неосведомленным программистам. Хотя синтаксис написания апдейтаграмм не так уж и прост, он подчиняется обычным правилам XML и, если вы совсем не разбираетесь в SQL, апдейтаграммы – лучший выбор. Кроме этого, вы просто не имеете другой столь же эффективной альтернативы, как XML Bulk Load для загрузки больших, очень больших объемов XML-данных. Но обо всем по порядку.
Апдейтаграммы
Апдейтаграммы – это особый тип шаблонов, в котором вместо запроса на выборку данных хранится информация, необходимая для изменения данных. Синтаксис их таков:
|
<your_root xmlns:updg="urn:schemas-microsoft-com:xml-updategram" [mapping-schema="your_schema.xml"]> <updg:header> <updg:param name="param1_name" /> <updg:param name="param2_name" /> </updg:header> <updg:sync> <updg:before> xml-узлы </updg:before> <updg:after [updg:returnid="your_id"]> xml-узлы </updg:after> </updg:sync> </your_root> |
Как видно из синтаксиса, апдейтаграмма может иметь параметры. Они, как обычно, задаются в URL и, как обычно, могут опускаться. Раздел header не является обязательным, но на практике без него обойтись трудно. Раздел before, по существу, определяет запись, над которой будет производиться действие. Он обязателен для изменения или удаления данных. В случае вставки его можно опустить. Раздел after определяет, как будет выглядеть найденная запись после выполнения апдейтаграммы. В случае удаления его указывать не нужно. Раздел sync определяет границы транзакции и буквально трансформируется в команды begin trans и commit trans. В случае неудачного выполнения шаблона транзакция откатывается с помощью rollback trans.
|
ПРИМЕЧАНИЕ Все аспекты работы апдейтаграмм хорошо видны в профайлере. Если у вас возникают вопросы, рекомендую сразу же им воспользоваться. |
В каком случае может возникнуть ошибка? Причин много:
Раздел before не может однозначно определить запись, над которой будет производиться действие. Например, если вы захотите удалить все записи, у которых поле age равно 33, то в ответ получите ошибку Ambiguous delete, unique identifier required. Другая ошибка возникает, когда такую запись невозможно найти совсем. В этом случае генерируется сообщение Empty delete, no deletable rows found для операции удаления, или Empty update, no updatable rows found для операции обновления.
Откат транзакции в триггере.
Ошибка ограничения (constraint violation).
Для того чтобы SQL Server понял, какие таблицы и поля ему изменять, вы можете использовать аннотированные схемы XDR или XSD. Если схема не используется, по умолчанию названия элементов соответствуют названиям таблиц, названия и значения атрибутов – названию и значению полей соответственно.
Добавление данных
Для вставки данных используется раздел after. Раздел before опускается. Если вы хотите получить на выходе значение колонки identity, укажите атрибут returned (и атрибут at-identity, см. далее). Для элемента, обозначающего таблицу, вы можете дополнительно указать три атрибута:
id – будет рассмотрен в разделе Обновление данных;
at-identity – позволяет получить в результирующий XML-документ значение вставленного поля для колонки identity. Например, пусть имеется такая таблица
| create table test1(_id int identity,fld1 int) |
Вот шаблон, который вставляет в нее данные:
|
<ROOT xmlns:updg="urn:schemas-microsoft-com:xml-updategram"> <updg:sync> <updg:after updg:returnid="ident_field"> <test1 fld1="23" updg:at-identity="ident_field"/> </updg:after> </updg:sync> </ROOT> |
Результатом выполнения команды «server/server_pubs/template/upd1.xml» будет следующий документ:
|
<ROOT xmlns:updg="urn:schemas-microsoft-com:xml-updategram"> <returnid><ident_field>1</ident_field></returnid> </ROOT> |
guid – предназначен для генерации глобально уникального идентификатора (GUID).
Давайте рассмотрим более сложный пример с использованием схемы. Вот схема:
|
<?xml version="1.0" encoding="windows-1251" ?> <xsd:schema xmlns:xsd="w3/2001/XMLSchema" xmlns:sql="urn:schemas-microsoft-com:mapping-schema"> <xsd:element name="Авторы" sql:relation="authors"> <xsd:complexType> <xsd:attribute name="Имя" type="xsd:string" sql:field="au_fname" /> <xsd:attribute name="Фамилия" type="xsd:string" sql:field="au_lname" /> <xsd:attribute name="Идентификатор" type="xsd:string" sql:field="au_id" /> <xsd:attribute name="Контракт" type="xsd:integer" sql:field="contract" default="1"/> </xsd:complexType> </xsd:element> </xsd:schema> |
Здесь мы явно использовали аннотации, так как названия XML-узлов составлены на русском. После выполнения следующего шаблона:
|
<?xml version="1.0" encoding="windows-1251" ?> <ROOT xmlns:updg="urn:schemas-microsoft-com:xml-updategram"> <updg:sync mapping-schema="upd_schema.xml"> <updg:after> <Авторы Имя="alex" Фамилия="shirshov" Идентификатор="123-15-3452"/> </updg:after> </updg:sync> </ROOT> |
мои имя и фамилия (да простят мне читатели нескромность) окажутся в таблице authors.
Обновление данных
Для обновления данных нужно использовать раздел before для определения обновляемых данных, и раздел after для определения конечных значений данных.
Давайте разберем пример:
|
<?xml version="1.0" encoding="windows-1251" ?> <ROOT xmlns:updg="urn:schemas-microsoft-com:xml-updategram"> <updg:sync mapping-schema="upd_schema.xml"> <updg:before> <Авторы Имя="alex" Фамилия="shirshov" Идентификатор="123-15-3452" updg:id="for_update"/> </updg:before> <updg:after> <Авторы Имя="Алексей" Фамилия="Ширшов" Идентификатор="123-15-3452" updg:id="for_update"/> <Авторы Имя="alex" Фамилия="shirshov" Идентификатор="123-15-3453" updg:id="for_insert"/> </updg:after> </updg:sync> </ROOT> |
Работает он так: сначала находится запись, однозначно идентифицируемая в разделе before (ее мы вставили в предыдущем примере). Этой записи, с помощью атрибута id, присваивается идентификатор. Зачем он нужен? Так как в разделе after мы указали две записи, то возникает неоднозначность: одну из них нужно использовать для вставки, а другую для обновления. Чтобы эту неоднозначность разрешить, в разделе after присутствует ссылка на найденную в разделе before запись посредством атрибута id. В результате выполнения шаблона будут исправлены имя и фамилия в записи с идентификатором 123-15-3452, а также добавлена новая запись.
Удаление
Это совсем тривиальная задача, главное помнить, что в разделе before запись должна однозначно определяться.
|
<?xml version="1.0" encoding="windows-1251" ?> <ROOT xmlns:updg="urn:schemas-microsoft-com:xml-updategram"> <updg:sync mapping-schema="upd_schema.xml"> <updg:before> <Авторы Имя="alex" Фамилия="shirshov" Идентификатор="123-15-3453"/> </updg:before> </updg:sync> </ROOT> |
В этом примере будет удалена запись с идентификатором 123-15-3453.
|
ПРИМЕЧАНИЕ Атрибуты «Имя» и «Фамилия» приведены здесь для того, чтобы вам проще было понять, какая строка удаляется. Так как идентификатор уникально определяет запись, их можно было не указывать. |
Более подробную информацию об апдейтаграммах с примерами можно найти в MSDN или в [10].
XML Bulk Load
Предположим, у вас имеется XML-документ, содержимое которого нужно «залить» в базу. Методов решения проблемы, как всегда, очень много, и вся сложность состоит в выборе наиболее подходящего. Вы можете загрузить документ в DOMDocument и в цикле, выбирая значения элементов и атрибутов, производить добавление данных с помощью инструкции SQL. Если вы не знакомы с объектной моделью DOM, то можете написать свой парсер. Такое лобовое решение обычно принимают самые отважные и «крутые» программисты, которые не боятся трудностей написания нового парсера, изучения SQL и начальства. Что ж, лично я (хотя начальства не особо боюсь) к такой категории себя отнести не могу. Мне нужно решение, которое опирается на уже существующие возможности и технологии. Второе, что приходит в голову – передать XML-документ в хранимую процедуру и с помощью OPENXML «залить» данные в таблицу. Решение здравое и наиболее эффективное в большинстве случаев. Но