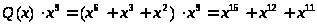Расчет информационных характеристик дискретного канала
H(A) = -(0,25*(-2) + 0,35*(- 1,51) + 0,15*(- 2,73) + 0,25*(-2) = -(-0,5 - 0,53 – 0,41 – 0,5) = 1,94 [бит/символ]
3)Максимальная энтропия источника сообщений Hmax(A)
Hmax(A)= log N=log 4=2 [бит/символ]
где N-количество символов в алфавите сообщения.
4)Информационные потери при передаче каждого символа ai определяет частная условная энтропия H(B/ai ):
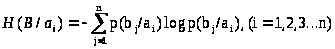 [бит/символ]
H(B/a1 )= -(0,9*(-0,15) + 0,05*(-4,32) + 0,03*(-5,05)+0,02*(-5,64) =
-(-0,1368 – 0,2161 – 0,1518 – 0,1129) = 0,6175 [бит/символ]
H(B/a2 )= -(0,1*(-3,32) + 0,84*(-0,25) + 0,06*(-4,05)+0) =
-(-0,3321 – 0,2112 – 0,2435 – 0) = 0,787 [бит/символ]
H(B/a3 )= -(0 + 0,01*(-6,64) + 0,98*(-0,03)+0,01*(-6,64)) =
-(-0 – 0,0664 – 0,0286 – 0,0664) = 0,1614 [бит/символ]
H(B/a4 )= -(0 + 0 + 0,01*(-6,64)+0,99*(-0,0145)) =
-(-0– 0 – 0,0664 – 0,0144) = 0,081 [бит/символ]
5)Средние потери информации при передаче одного символа определяет общая условная энтропия источника Н(B/А):
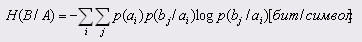
H(B|A) = 0,25*0,6175 + 0,35*0,787 + 0,15*0,1614 + 0,25*0,081 = 0,1543 + 0,2755 + 0,0242 + 0,02 = 0,4743 [бит/символ]
6)Общие потери информации в канале святи при передаче сообщения, состоящего из 250 символов I
I = k H (B / A) = 2500,737476 = 184 [бит]
где k – количество символов в переданном сообщении.
Среднее количество информации, принятое приемником на один символ, определяется энтропией приемника Н(B)
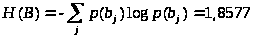 [бит/символ]
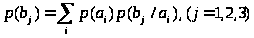
p(b1) = 0,9*0,25 + 0,35*0,1 + 0 + 0 = 0,225 + 0,035 = 0,26
p(b2) = 0,05*0,25 + 0,84*0,35 + 0,01*0,15 +0 = 0,0125+0,294+0,0015 =0,35
p(b3) = 0,03*0,25 + 0,06*0,35 + 0,98*0,15+0,01*0,25 = 0,0075+0,021+ 0,147+0,0025 = 0,178
p(b4) = 0,02*0,25 + 0 + 0,01*0,15 + 0,99*0,25 = 0,005 + 0+0,0015+ 0,2475=0,254
H(B) = -(0,26*(-1,94) + 0,35*(-1,7) + 0,178*(-2,49) + 0,254*(-1,97)) = -
-(-0,5 – 0,5234 – 0,4432 – 0,5) = 1,974 [бит/символ]
8) Максимальная энтропия приемника, Hmax(B)
Hmax(B)= log N = log 4 =2 [бит/символ]
9)Среднее количество принятой приемником информации, на один символ с учетом потерь информации, I (A, B)
I
(A,
B)
= H
(B)
– H
(B
/ A)
=
 -
 =
1,5 [бит/символ]
10) Скорость модуляции дискретного канала, n
n= =
 =500
[бод]
11) Продуктивность дискретного канала сообщений, H’(A)
H’(A)= [бод]
H’(A)
=
 =
970,3227 [бод]
12) Скорость передачи информации, R
R =
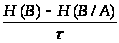
R= (1,974 - 0,4743)/0,002 = 749,8676 [бод]
13) Пропускная способность (емкость) дискретного канала связи определяется максимальной скоростью передачи: C=max R
С=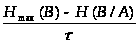
C= =
762,8716 [бод]
14) Коэффициент эффективности дискретного канала связи Kэ
Kэ= =
 =0,9829
15) Критическая скорость передачи Rкр
Rкр= =
 =
393,102 [бод]
Оценка надёжности и эффективности дискретного канала связи
Оценка теоремы Шеннона по скорости
R<Rкр
749,8676 > 393,102
Оценка выполнения теоремы по кодированию
H’(A) < C
970,3227 > 762,8716
Рекомендации по повышению надёжности и эффективности
Из-за невыполнения теоремы о скорости передачи невозможным становится восстановление исходного сообщения. При кодировании и декодировании информации вероятность ошибки может быть сколь угодно велика. Для улучшения эффективности необходимо увеличить емкость канала С.
Теоремы Шеннона не выполняются, а значит, наш канал связи не является эффективным и надежным.
Построение канальной матрицы объединения
Найдем безусловные вероятности появления сигналов на входе приемника по формуле:
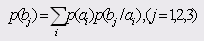
Зная КМИ можно построить КМО: р(аi,,bj)= p(ai)p(bj/аi)
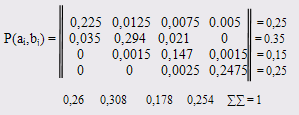
Построение канальной матрицы приемника
Зная КМО мы можем построить КМП, найдя элементы по формуле :
p(ai / bj)= p(ai,bj)/p(bj)
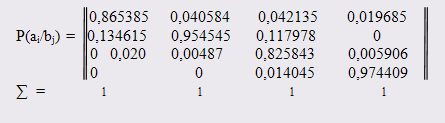
Часть 2. Теория кодирования
6. Оптимальное кодирование. Идея сжатия
Основной характеристикой дискретного канала связи является скорость передачи данных. При избыточности переданного сообщения скорость передачи уменьшается. Для исключения избыточности сообщения используют математические и программные средства компрессии данных без потери содержания информации, в том числе оптимальное кодирование.
Оптимальное кодирование применяют для того, чтобы:
сжимать данные (компрессия);
снижать время передачи данных при той же скорости передачи;
уменьшить возможные потери и искажения данных;
архивировать данные, эффективно использовать память.
Основная идея оптимального кодирования лежит в том, что символам сообщения, которые имеют большую вероятность, присваивают короткие бинарные коды, то есть образуются бинарные кодовые слова разной длины – неравномерные коды. Оптимальным неравномерным кодом (ОНК) называется такой код, для которого средняя длина кода есть минимальной.
Такая идея сжатия была применена в азбуке Морзе, где наиболее встречающимся символам соответствовали наиболее короткие коды. Сам алфавит состоял из точек и тире.
6.1 Равномерный двоичный код (РДК), корневое бинарное дерево РДК, длина кода РДК, сообщение в РДК
Составление сообщения
Нам дано сообщение:
Х= "Остановите землю, я сойду"
Длина сообщения Lx=24 [символа]
Алфавит сообщения
Найдём алфавит нашего сообщения:
A={о,с,т,а,н,в,и,е,з,м,л,ю,я,с,й,д,у,_. }
Длина алфавита La=21 [символ]
Вероятности
На данном этапе вычисления РДК нам требуется вычислить вероят-ности появления каждого символа в алфавите сообщения. Для этого мы воспользуемся формулой:
pi = vi/ ls
где vi - количество раз, которое символ встречается в сообщении.
Сумма vi должна соответствовать длине исходного сообщения.
Таблица данных, РДК
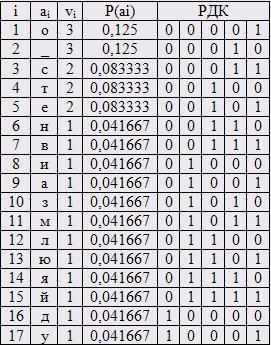
Таким образом, наше сообщение будет выглядеть:
SРДК=00001000110010001001001100000100111010000010000101000100101000100101011011000110100010011100001000011000001011111000010001
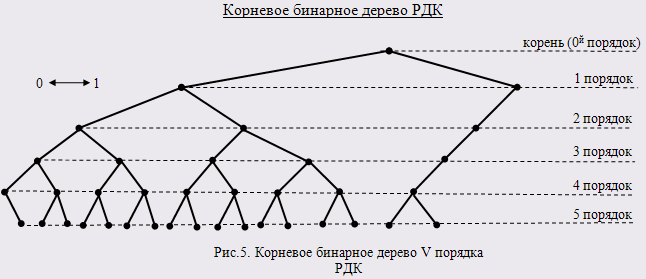
6.1.6 Длина сообщения
Длина сообщения, записанного в РДК равна:
lsрдк = ls · lрдк
где lрдк = 5 бит.
Таким образом, длина сообщения:
lsрдк = 24·5 = 120 бит
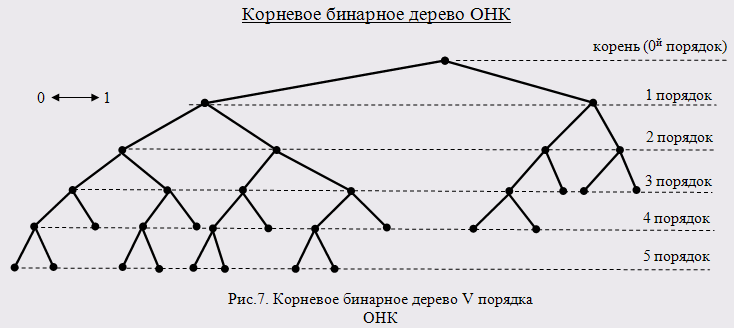
6.2 Оптимальный неравномерный код ОНК Шеннона-Фано, алгоритм расчета ОНК, средняя длина, энтропия, коэффициент сжатия, коэффициент эффективности, сообщение в ОНК, критерий Фано, корневое бинарное дерево ОНК Шеннона-Фано
Расчёт ОНК
Оптимальный неравномерный код (ОНК) мы будем рассчитывать по методу Шеннона-Фано, который ещё называют методом бисекции.
Для вычисления ОНК вся работа разбивается на несколько этапов.
Предварительный шаг: вероятности появления символа в сообщении ранжируются по убыванию.
Шаг первый: все вероятности разбиваются на две равновероятные группы. Символам верхней секции назначим 0, символам нижней секции – 1. Первый бит ОНК вычислен.
Шаг второй: каждую группу делим на две равновероятные подгруппы. Верхним подгруппам присваивается 0, нижним – 1. и т. д.
Деление заканчивается, когда в подгруппе остаётся один символ.
Нахождение ОНК
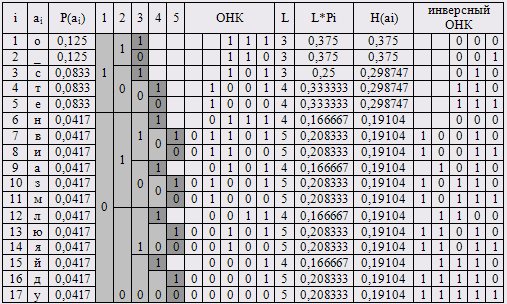
Критерий Фано однозначного декодирования ОНК: ни одно слово ОНК не является началом другого слова ОНК. Это ещё называется свойством префиксности.
Критерий Фано позволяет однозначно декодировать сжатое сообщение SОНК . Сообщение в ОНК будет выглядеть:
SОНК=111101100101010111111011010110010011000110010011000010000011001010010010011010111100010001100000
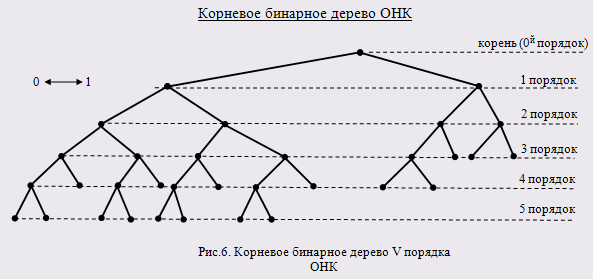
Характеристики ОНК
Средняя длина ОНК
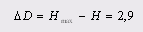
Lcp.онк= 4.23 [бит]
Энтропия ОНК
H(A)= 1,18 [бит/символ]
Максимальная энтропия
Hmax= log 17= 4,08 [бит/символ]
Относительная энтропия
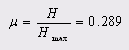
Информационная избыточность
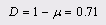
Абсолютная недогруженость
Коэффициент сжатия
Кс = 1- Lcp.онк/ LРДК = 0,15 = 15 %
Коэффициент эффективности Кэ
Кэ=Н/ Lcp.онк = 0,27
Эффективность ОНК тем выше, чем больше средняя длина ОНК стремится к энтропии.
6.3 Оптимальный неравномерный ОНК Хаффмана, алгоритм расчета ОНК, средняя длина, энтропия, коэффициент сжатия, коэффициент эффективности, сообщение в ОНК, КБД
Расчет ОНК Хаффмена
При расчёте оптимального неравномерного кода Хаффмена нам потребуются вероятности появления символов в нашем сообщении. Они у нас уже рассчитаны и выстроены в порядке убывания.
Сам оптимальный неравномерный код Хаффмена мы будем вычислять при помощи алгоритма Хаффмена:
Шаг 1. "Склеиваются" две самых маленьких вероятности.
Шаг 2. В усечённом алфавите снова "склеивают" две самых маленьких вероятности.
Объединение вероятностей заканчивается, когда в усечённом алфавите остаётся лишь одна вероятность.
Критерий Фано
Полученный ОНК Хаффмена обязан обладать свойством пре-фиксности, то есть ни одно слово ОНК не должно являться началом другого слова. Критерий Фано позволяет однозначно декодировать сжатое сообщение.
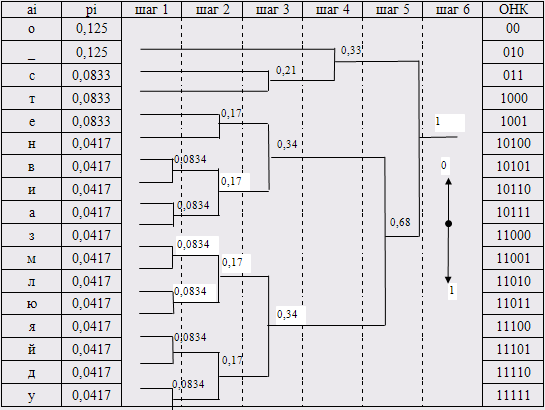
Cообщение примет вид:
S=1001101011011111001001010101100011101010011101000100001100010111101111111001100101101000
Характеристики ОНК
Средняя длина ОНК
Lcp.онк= 4.23 [бит]
Энтропия ОНК
H(A)= 1,18 [бит/символ]
Максимальная энтропия
Hmax= log 17= 4,08 [бит/символ]
Относительная энтропия
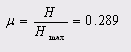
Информационная избыточность
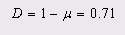
Абсолютная недогруженость
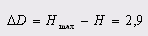
Коэффициент сжатия
Кс = 1- Lcp.онк/ LРДК = 0,15 = 15 %
Коэффициент эффективности Кэ
Кэ=Н/ Lcp.онк = 0,27
Эффективность ОНК тем выше, чем больше средняя длина ОНК стремится к энтропии.
6.4 Эффективность ОНК
Однозначно декодировать ОНК можно с помощью критерия Фано, который говорит о свойстве префиксности, которым обладают коды. Благодаря сжатию информации возможно значительно сократить исходный код.
Эффективность ОНК можно определить с помощью коэффициента эффективности, то есть чем ближе Кэ стремится к единице, тем эффективнее оптимальный неравномерный код.
ОНК не обладает избыточностью, так как к нему не прикрепляются контрольные биты.
7. Помехоустойчивое кодирование. Назначение
Назначение помехоустойчивого кодирования состоит в защите данных от действия помех.
Эти коды делятся на две группы:
Обнаруживающие коды – коды только обнаруживают ошибки, но не указывают их адрес
Корректирующие коды – обнаруживают наличие ошибки, вычисляют адрес ошибки (позицию), в котором появился ошибочный бит.
7.1 Обнаруживающие коды
Двоичный код становится обнаруживающим за счет добавления дополнительных контрольных бит.
Можно назвать следующие обнаруживающие коды: обнаруживающий код четности (ОКЧ), обнаруживающий код удвоения (ОКУ), обнаруживающий код инверсией (ОКИ), обнаруживающий код стандартный телеграфный код № 3 и другие.
7.1.1 Обнаруживающий код четности (ОКЧ)
Данный двоичный код дополняется одним контрольным битом в конце слова.
nи - длина информационной части, количество бит.
nк - длина контрольной части.
n = nи + nк - длина слова.
Пример.
Генерация.
Пусть исходное слово 0101.
Макет ОКЧ - 0101К,
где К – контрольный бит, равно сумме по модулю 2 информационных бит исходника.
К = 0 101
= 0
ОКЧ (n; nи )
ОКЧ (5; 4) = 01010
Проверим:
S = 0
1010
= 0 -
 ошибки , то есть
ошибки не существует
| Количество ошибок | Передано | Принято | Наличие ошибки |
| Нет ошибок | 01010 | 01010 |
S
= 0,
|
| 1 ошибка | 01010 | 11010 |
S
= 1,
|
| 2 ошибки | 01010 | 11011 |
S
= 0,
|
| 3 ошибки | 01010 | 10011 |
S
= 1,
|
| 4 ошибки | 01010 | 10111 |
S
= 0,
|
Недостаток: ОКЧ позволяет определять наличие ошибки при нечетном их количестве и не определяет ошибку при их четном количестве.
Эффективность.
1. Минимальное количество контрольных бит.
2. Просто и удобный алгоритм генерации кода и диагностики (обнаружения ошибок).
7.1.2 Обнаруживающий код удвоения (ОКУ)
Генерация ОКУ.
Пусть исходное сообщение будет 0101.
Макет ОКУ: 0101 К1 К2 К3 К4,
где nи = 0101 и nк = К1 К2 К3 К4, то есть nи = nк.
Контрольные биты равны соответствующим информационным битам.
ОКУ (8; 4) = 01010101
Диагностика.
При диагностике суммируются по модулю 2 информационная и контрольная части ОКУ.
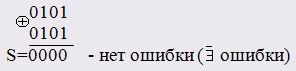
Во всех остальных случаях ошибка существует.
Передано 01010101.
Принято 00010101.
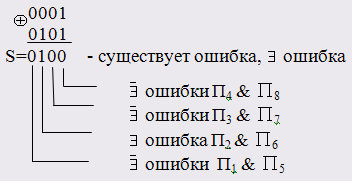
Эффективность ОКУ.
Обнаруживает любое число ошибок и приблизительно указывает адрес ошибки;
Простота алгоритма генерации и диагностики;
Недостаток – избыточность, длина контрольной части 100%.
7.1.3 Обнаруживающий код инверсии (ОКИ)
Генерация ОКИ.
Пусть исходное сообщение будет 0101.
Макет ОКИ: 0101 К1 К2 К3 К4,
где nи = 0101 и nк = К1 К2 К3 К4, то есть nи = nк.
Контрольные биты ОКИ равны инверсии соответствующих бит
информационной части исходника.
ОКУ (8; 4) = 01011010
Диагностика.
При диагностике суммируются по модулю 2 информационная и
контрольная части ОКУ.
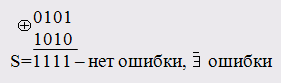
Если S
= 1 – ошибка не
существует.
S=0
-
 ошибка
Передано 01011010.
Принято 10011011.
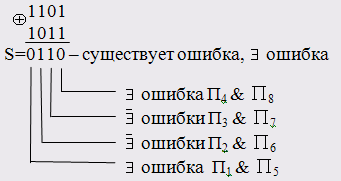
Эффективность ОКИ.
Обнаруживает любое число ошибок и приблизительно указывает адрес ошибки.
Простота алгоритма генерации и диагностики.
Недостатком является избыточность, длина контрольной части 100%.
7.1.4 Обнаруживающий код Стандартный телеграфный код (ОК СТК №3) №3
Количество единиц в двоичном коде называется весом кода.
Для всех символов, букв, цифр, спецзнаков разработаны двоичные коды весом, равным 3 ( т. е. содержат 3 единицы).
Диагностика.
Если в принятом двоичном слове количество единиц равно 3, то ошибки нет. Во всех остальных случаях ошибка есть.
Символ с ошибкой не корректируется, а удаляется.
7.2 Корректирующий систематический код Хэмминга: генерация, диагностика, коррекция, декодирование
Генерация КСКХ.
Определим количество контрольных бит и их позиции по формуле:
Пi=2j-1 => kj —> Пi
Отсюда получаем:
для K1, j=1, Пi =21-1=20=1 , K1 →П1 ;
для K2, j =2, Пi =22-1=21=2 , K2 →П2 ;
для K3, j =3, Пi =23-1=22=4 , K3 →П4 ;
для K4, j =4, Пi =24-1=23=8 , K4 →П8 ;
Макет КСКХ
nи = 7 бит, nk = 4 бит, n = 7+4 = 11 бит.
| Позиции | П1 | П2 | П3 | П4 | П5 | П6 | П7 | П8 | П9 | П10 | П11 |
| Макет | к1 | к2 | 1 | к3 | 0 | 0 | 1 | к4 | 1 | 0 | 0 |
Определим правила четности Хемминга.
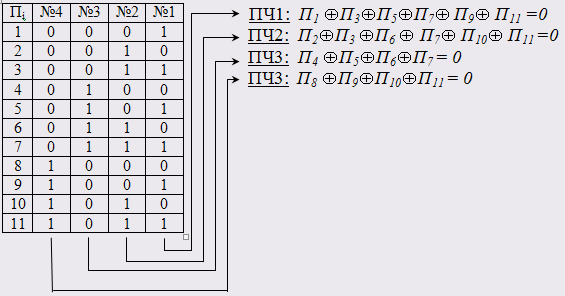
Вычислим значения контрольных бит. Макет КСКХ обработаем правилами четности, получим уравнения с одной переменной, решив которые, найдем значения к.
ПЧ1 =>
к110110
= 0. к11=
0
→
k1
= 1
ПЧ2 =>
к210100
= 0. к20=
0
→
k2
= 0
ПЧ3 =>
к3001
= 0. к31=
0 →
k3
= 1
ПЧ4 =>
к400
= 0. к41=
0
→
k4
= 1
| Позиции | П1 | П2 | П3 | П4 | П5 | П6 | П7 | П8 | П9 | П10 | П11 |
| Макет | к1 | к2 | 1 | к3 | 0 | 0 | 1 | к4 | 1 | 0 | 0 |
| КСКХ | 1 | 0 | 1 | 1 | 0 | 0 | 1 | 1 | 1 | 0 | 0 |
КСКХ(11;7) = 10110011100
Диагностика.
Передан КСКХ: 10110011100
Принят: 10111011100
Обрабатываем КСКХ правилами четности:
ПЧ1 =>
110110
= 1 →
АО=1
ПЧ2 =>
010100
= 0 →
АО=0
ПЧ3 =>
1101
= 1 →
АО=1
ПЧ4 =>
1100
= 0 →
АО=0
АО=01012=510
АО =П5
Коррекция.
Заключается в инверсии ошибочной позиции П5:1→0
КСКХ(11;7) = 10110011100
Декодирование.
Заключается в удалении контрольных бит: 1001100
Эффективность. Контрольные биты размещаются между битами исходника. Код содержит минимальное количество контрольных бит и является плотноупакованным.
7.3 Корректирующий циклический код: генерация, диагностика, коррекция, декодирование
Корректирующий циклический код (КЦК) определяет и корректирует одну ошибку. Широко употребляется в станках с числовым программным управлением (ЧПУ).
Контрольные биты размещаются в конце информационной части кода. Значения контрольных бит вычисляются с помощью порождающего полинома.
Диагностика наличия ошибки и вычисление её адреса также выполняются с помощью порождающего полинома.
Генерация КЦК.
Дано сообщение:
Л = 1001101
nи = 7 бит
Построим корректирующий циклический код.
Запишем исходник в форме полинома
К = 1001100

 =Q(x).
nи = 7 бит, nk = nи+2=9 бит, n = 7+9 = 16 бит.
Макет строится путем сдвига исходника на 9 бит влево