Варианты алгоритма возведения в степень: повышение точности и ускорение
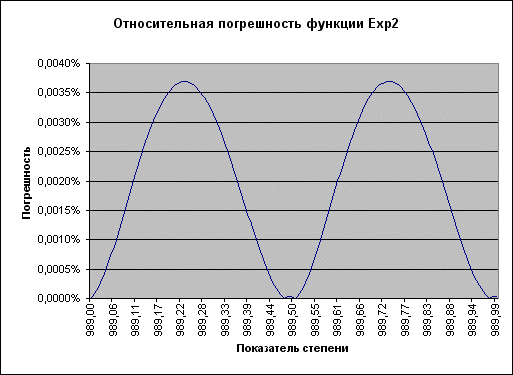
Рисунок 1. Максимальная погрешность приближения функции Exp2=2**x (при x менее 990) не превышает 0,004%.
|
СОВЕТ Мы отсекли отрезки, лежащие правее точки x=990. Следовательно, размер таблицы коэффициентов можно несколько сократить: индекс последнего элемента должен быть 990*2=1980, а не 1998. “Лишние” 19 последних строк таблицы можно просто удалить. Логично также изменить текст комментария в начале функции Exp2. |
Новый вариант функции возведения в степень
Изменим реализацию возведения в степень в соответствии с предложенной аппроксимацией для 2**x:
|
function New_Power(x,y:FLOATTYPE):FLOATTYPE; //abs(y*log2(x))<990 asm fld y fld x fldz //Сравним основание степени fcomip st,st(1) // с 0 и соответственно установим флаги процессора je @Zero FYL2X //Стек: ST(0)=t=y*log2(x) fldz fcomip st,st(1) //Флаги выставляем соответственно числу 0-y*log2(x) ja @Reverse //Если 0>y*log2(x), то сосчитаем 2**|y*log2(x)|, а после инвертируем call Core_Exp2 jmp @Exit @Zero: fxch st(1) fstp st //Освобождаем ненужный регистр jmp @Exit @Reverse: fabs //Берем абсолютную величин call Core_Exp2 fld1 //Считаем обратное значение: fdivrp //1/(2**|y*log2(x)|) @Exit: end; |
|
ПРЕДУПРЕЖДЕНИЕ В этом фрагменте используется инструкция FCOMIP, впервые появившаяся на процессорах Pentium Pro. Любителям антиквариата придется использовать вместо пары команд FCOMIP / JE блок |
|
FCOMP FSTSW TEST AX, 16384 JNZ @Zero //Вместо je @Zero |
|
ПРЕДУПРЕЖДЕНИЕ А вместо FCOMIP / JA - блок |
|
FCOMP FSTSW TEST AX, 256 or 16384 //0<= y*log2(x) ? JZ @Reverse //Нет, случай со взятием обратного значения |
|
ПРЕДУПРЕЖДЕНИЕ Вдобавок в этом случае изменяется регистр EAX. |
Результаты тестирования отражены на графиках:
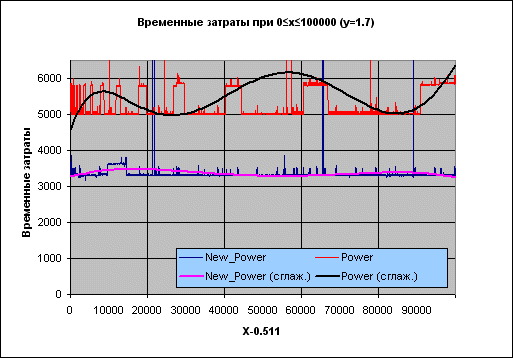
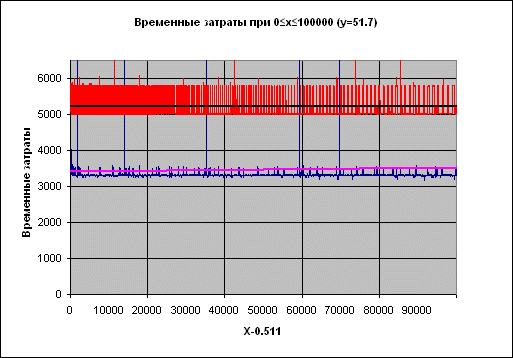
Рисунок 2. Временные затраты: New_Power – новая функция, Power – из состава RTL Borland Delphi.
Подпись X-0.511 на оси абсцисс отражает тот факт, что при проведении испытаний брались значения целые значения X, к которым затем прибавлялось число 0.511, чтобы гарантировать, что основание степени – число нецелое (т.е. чтобы рассматривать по возможности общий случай).
Черная линия поверх красного набора – сглаженные временные затраты функции Power, фиолетовая поверх синего – функции New_Power.
Замеры временных затрат производились с помощью инструкции RDTSC (процессоры начиная с Pentium):
|
function time:int64; //Вспомогательная функция для подсчета времени работы asm rdtsc end; |
и далее в коде
|
t:=time(); ... writeln(time()-t); |
RDTSC возвращает в регистровой паре EDX:EAX число тактов процессора, прошедших с момента последнего сброса (reset). Машинный код инструкции – 0Fh, 31h.
Относительная погрешность ведет себя на удивление стабильно, изменяясь в пределах от 0 до 0,0040%. Поэтому достаточно представительным множеством значений аргумента является, к примеру, промежуток (0, 1000).
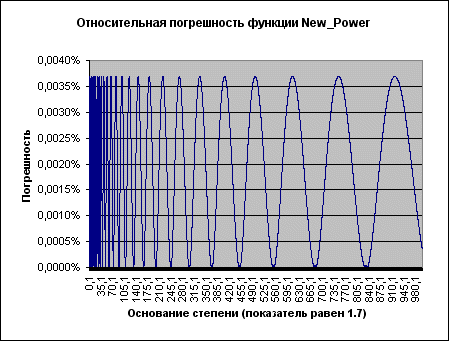
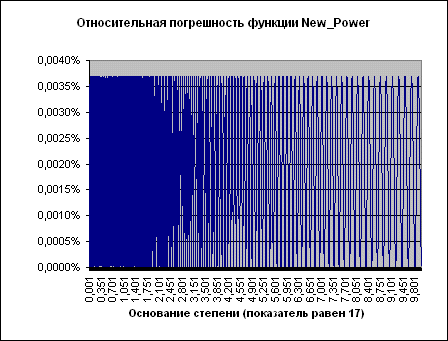
Рисунок 3.
Видно, что оцененная относительная погрешность (фактически - отклонение от значения, возвращаемого встроенной функцией) на самом деле не превосходит 0.004% !
В случае показателя степени 17 колебания становятся намного чаще, однако общая картина та же.
Аппроксимация функции log2x и “специализация” возведения в степень
Логарифмирование плохо поддается аппроксимации с помощью кубических сплайнов – точнее, мне удалось это сделать, причем с весьма высокой точностью, но лишь ценой проигрыша по времени в сравнении с использованием FYL2X. Однако здесь есть что предпринять и не прибегая к сплайнам.
Как известно, функция ln(1+x) при |x|<1 разлагается в ряд Тейлора следующим образом:
ln(1+x)=x-x2/(1*2)+x3/(1*2*3)+…+ xi/i!+…
Если абсолютная величина x достаточно мала, члены ряда, уже начиная с третьего, достаточно слабо сказываются на результате. Поэтому для значений x, достаточно близких к 1 (чтобы остаться в оговоренных выше рамках приемлемых погрешностей, x должен отстоять от 1 не больше чем на 0.01), вычисление log2(x)=ln(x)/ln(2)=ln(x)*log2(e)=ln(1+(x-1))*log2(e) можно заменить вычислением (t-t*t/2)*log2(e), где t=x-1.
Это позволяет построить еще один вариант функции возведения в степень для значений основания, близких к 1. В нем нет инструкции FYL2X, а вместо нее присутствует блок инструкций, помеченных символом “ * ” (знак “~” означает приближенное равенство):
|
function New_Power_XNear1(x,y:FLOATTYPE):FLOATTYPE; // abs(y*log2(x))<990 asm fld y fld x fldz fcomip st,st(1) je @Zero fld1 (*) fsub st(1),st (*) fld st(1) (*) //st(0)=1; st(1)=st(3)=t=x-1, st(2)=1, st(4)=y fld1 (*) fadd st,st (*) fdivp st(2),st (*) //st(0)=st(2)=t, st(1)=1/2, st(3)=y fmul st,st (*) fmulp st(1),st (*) //st(0)=1/2*t*t, st(1)=t, st(2)=y fsubp st(1),st (*) //st(0)=t-t*t/2 ~ ln(x), st(1)=y fldl2e (*) //Загружаем константу log2(e) fmulp (*) //st(0)~log2(x), st(1)=y fmulp (*) //st(0)~y*log2(x) fldz fcomip st,st(1) ja @Reverse call Core_Exp2 jmp @Exit @Zero: fxch st(1) fstp st //Освобождаем ненужный регистр jmp @Exit @Reverse: fabs call Core_Exp2 fld1 fdivrp @Exit: end; |
Таким образом, нам в этом случае (при x, близких к 1) удается избавиться от всех инструкций FPU, принадлежащих к группе трансцендентных, что приводит к впечатляющему росту производительности:
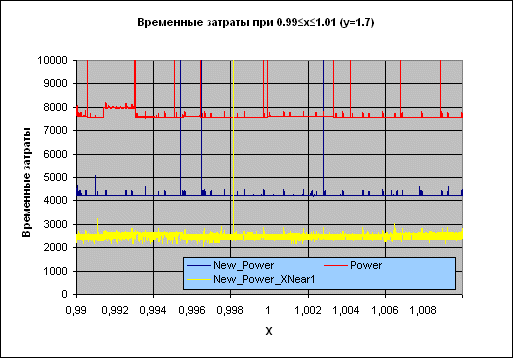
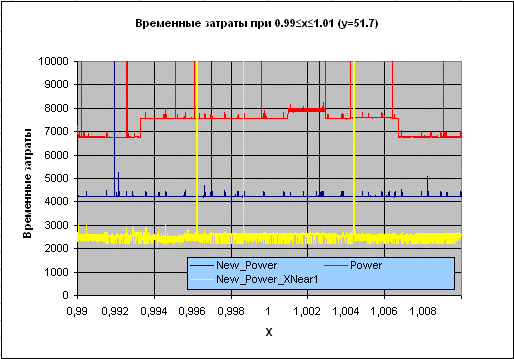
Рисунок 4. Временные затраты: New_Power_XNear1 – специализированный вариант New_Power.
К сожалению, с ростом показателя степени максимальная погрешность растет, оставаясь, впрочем, в оговоренных пределах (т.е. меньше 0,1%; более того – меньше 0,01%) даже при очень больших показателях:
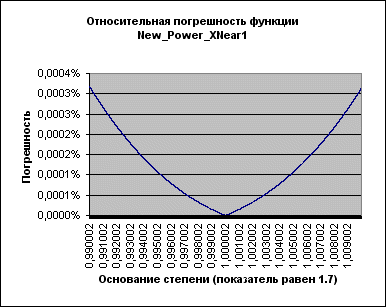
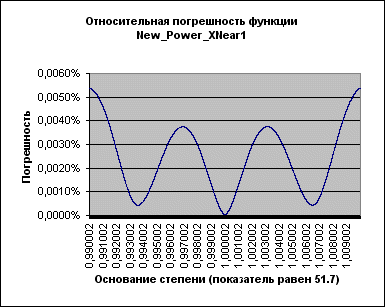
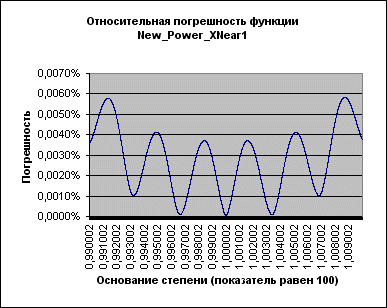
Рисунок 5.
Заключение
Таким образом, нам удалось получить функции, превосходящие встроенную по скорости от двух до четырех раз при погрешности порядка 0.004% - 0.01%. Не исключено, что существует возможность провести более качественную и более выгодную в смысле временных затрат аппроксимацию функций; возможно, даже по другому принципу, а не так, как это было сделано здесь (т.е. исходя из соотношения x**y=2**(y*log2(x)) ).
Для тех же случаев, когда необходима высокая точность вычислений, в качестве первого камня фундамента была рассмотрена функция, исправляющая недостаток Delphi RTL. Несомненно, это направление также достойно дальнейших исследований с целью ускорить заведомо медленные вычисления с повышенной точностью.
Список литературы
Intel® Architecture Software Developer’s Manual: том 2, Instruction set reference. Можно найти на сайте Intel www.intel.
Intel® VTune™ Performance Analyzer, гипертекстовая справка. И вообще, VTune – замечательный инструмент для поиска шероховатостей в программе.
Intel® Pentium® 4 and Intel® Xeon™ Processor Optimization Reference Manual. Все там же, на сайте Intel.
Для подготовки данной работы были использованы материалы с сайта rsdn/