Алгоритмы параллельных процессов при исследовании устойчивости подкрепленных пологих оболочек
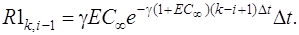 (34)
При решении задач ползучести для
оболочек при каждом значении параметра нагрузки  решается
итерационная задача
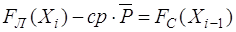 (35)
до тех пор, пока прогибы не будут резко возрастать (в 10-15 раз по сравнению с первоначальным значением).
Начальное приближение  находится из решения линейно-упругой задачи
(24).
Второй вариант соотношений 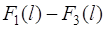 получается, если взять
 в виде (5) и тогда (так как деформации при
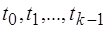 считаются известными, то производные от них
по
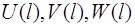 равны нулю)
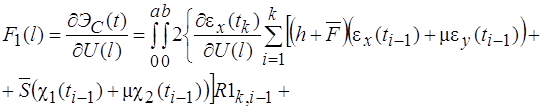
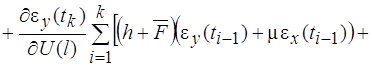
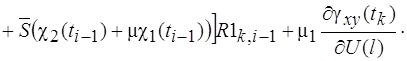
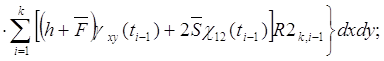 (36)
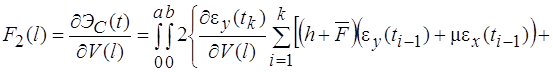
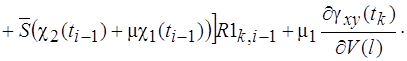
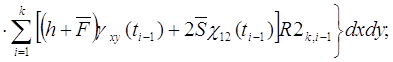 (37)
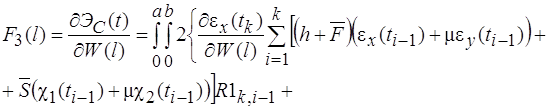
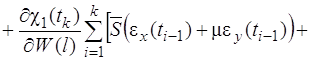
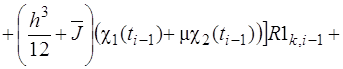
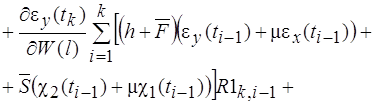
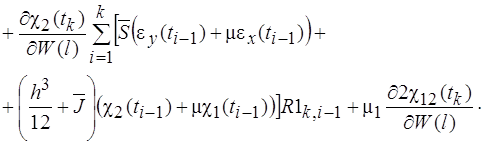
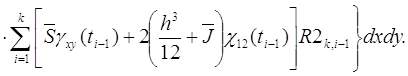 (38)
Таким образом, выражения 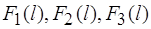 оказываются одинаковыми, как для , взятого в виде (4), так и для , взятого в виде (5). При учете
геометрической нелинейности такого полного совпадения не будет. При
использовании
 в виде (5) значение правых частей
системы (15) будут несколько больше, чем при использовании в виде (4), что пойдет в запас прочности.
2.1 Программа PologObolochka
Программа предназначена для расчетов прочности и устойчивости оболочек при учете геометрической и физической нелинейностей и ползучести материала и разработана Беркалиевым Р.Т. [11] Программа может быть запущенна под любой версией ОС Windows, начиная с версии NT.
Программа состоит из нескольких базовых блоков:
Получение коэффициентов С систем алгебраических уравнений линейно-упругой задачи;
Метод итераций для геометрически и физически-нелинейной задачи;
Построения графиков устойчивости;
Построение 3-D графиков устойчивости;
Метод итераций ползучести (с построением графиков);
Построение 3-D графиков ползучести.
От физической модели не зависит блок 1, все остальные блоки зависят от нее. Таким образом, в зависимости от физической линейности или нелинейности вызываются соответствующие блоки. Блок 1 и блок 2 являются базовыми для расчета любой задачи.
Блок 1: Получение коэффициентов С систем алгебраических уравнений линейно-упругой задачи.
Блок вычисляет коэффициенты C для составления базовой системы уравнений модели расчета, и записывает их в файл, чтобы в дальнейшем, для этой же задачи загрузить их из файла. Коэффициенты вычисляются по ряду параметров, которые запрещено менять в дальнейших вычислениях, при расчете текущей задачи.
Блок 2: Метод итераций для геометрически и физически-нелинейной задачи.
Метод итераций проводит расчет устойчивости как физически линейных, так и физически нелинейных моделей оболочек, в зависимости от выбранной модели.
В процессе метода итераций, по заданному фильтру PausePW, сохраняются значения P, U, V, W, PS, PN в файл, и сохраняется последнее состояние метода. В дальнейшем оттуда берутся данные для продолжения метода итераций, в случае его аварийного завершения. Таким образом, метод итераций может быть прерван в любой момент времени и потом продолжен с момента его прерывания.
Блок 3: Построения графиков устойчивости.
По заданному фильтру составляется зависимость P-W. Из файла метода Итераций берутся эти значения, и вычисляются прогибы, для P-W, и заносятся в файл. Блок составляет файл зависимости P-W, по которому может быть построен график зависимости.
Блок 4: Построение 3-D графиков устойчивости.
По заданному фильтру составляются поля прогибов и напряжений для оболочки для физически линейной или нелинейной модели. Вычисления ведутся только для тех значений, нагрузка-P, которые попадают в список заданных нагрузок, для которых запрашивались прогибы и напряжения.
Из файла блока метода итераций
считывается U, V, W, PS, PN, для заданных P,
и вычисляют поля прогибов W (x,y) и напряжений  (x,y) и они записываются в
файлы. По сохраненным расчетам могут быть построены графики. Интенсивность
напряжений (x,y) вычисляется в
зависимости от материала (хрупкие или пластичные).
Блок 5: Метод итераций ползучести.
По заданному фильтру блок производит расчет ползучести оболочки для физически линейной или нелинейной модели. Из файла метода итераций считываются U, V, W, PS, PN, для заданных P. Для каждого P инициализируется система уравнений ползучести, и ведется расчет ползучести материала, и составляется зависимость W-t, которая записывается в файл. Эта зависимость может быть в дальнейшем представлена в графическом виде.
Блок 6: Построение 3-D графиков ползучести.
По заданному фильтру производится расчет полей прогибов и напряжений для физически линейной или нелинейной задачи. Из файла метода итераций считываются U, V, W, PS, PN, для выбранного P. Инициализируется система уравнений, и ведется расчет. Для заданных точек по времени составляются поля прогибов и напряжений, в зависимости от материала и физической модели оболочки, которые записываются в файлы. По результатам расчета могут быть построены графические зависимости.
Для графического представления зависимостей используется математический пакет Maple, начиная с версии Maple 6.
Для расчета любой задачи входными данными являются выбор физической модели: физически линейная или физически нелинейная (рис.2).
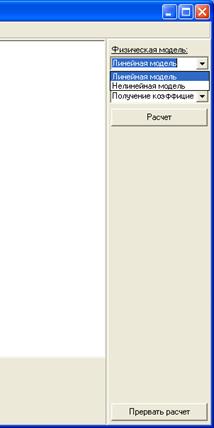
Рис.2. Выбор модели
Входными данными являются:
Dim_a - Линейный размер оболочки;
Kksi - Кривизна оболочки вдоль направления X;
Keta - Кривизна оболочки вдоль направления Y;
lambda - Соотношение длин сторон вдоль направления X и Y оболочки;
Mu - Коэффициент Пуассона;
J_m - Количество ребер жесткости вдоль направления X;
I_n - Количество ребер жесткости вдоль направления Y;
AutomaticModeRebra - Режим ввода центральных координат ребер жесткости;
F_j - Высота ребер жесткости вдоль направления X;
F_i - Высота ребер жесткости вдоль направления Y;
rj - Ширина ребер жесткости вдоль направления X;
ri - Ширина ребер жесткости вдоль направления Y;
temporaryRebraX - Центральные координаты ребер жесткости вдоль направления X;
temporaryRebraY - Центральные координаты ребер жесткости вдоль направления Y;
N - Количество аппроксимирующих функций;
N_Simps - Разбиение при вычислении интегралов для коэффициентов СЛАУ;
P_KON - Конечная нагрузка;
d_P - Шаг по нагрузке метода Итераций;
PausePW - Шаг по нагрузке вывода результатов расчета;
epsilon - Точность метода Итераций;
Iter_X1 - Координата X вычисления прогиба оболочки для метода Итераций;
Iter_Y1 - Координата Y вычисления прогиба оболочки для метода Итераций;
Ust_X1 - Координата X вычисления прогиба оболочки для построения 1-й зависимости P-W;
Ust_Y1 - Координата Y вычисления прогиба оболочки для построения 1-й зависимости P-W;
Ust_X2 - Координата X вычисления прогиба оболочки для построения 2-й зависимости P-W;
Ust_Y2 - Координата Y вычисления прогиба оболочки для построения 2-й зависимости P-W;
Ust_P - Значения нагрузок для вывода полей прогиба и интенсивности оболочки;
CreepEnd - Порог превышения прогиба для вычисления ползучести оболочки;
Creep_X1 - Координата X вычисления прогиба оболочки для построения 1-й зависимости W-t;
Creep_Y1 - Координата Y вычисления прогиба оболочки для построения 1-й зависимости W-t;
Creep_X2 - Координата X вычисления прогиба оболочки для построения 2-й зависимости W-t;
Creep_Y2 - Координата Y вычисления прогиба оболочки для построения 2-й зависимости W-t;
Creep_P - Значения нагрузок для вычисления ползучести оболочки;
DimP_Time - Значение нагрузки для вывода динамических полей прогиба и интенсивности оболочки;
CreepTime - Значения времени для вывода динамических полей прогиба и интенсивности оболочки при заданной нагрузке;
Material - Тип материала (для упругих материалов задача ползучести не рассчитывается);
constM - Константа физической нелинейности.
При вводе данных программа показывает подсказку по каждому параметру (рис.3).
После ввода всех параметров можно приступать к расчету.
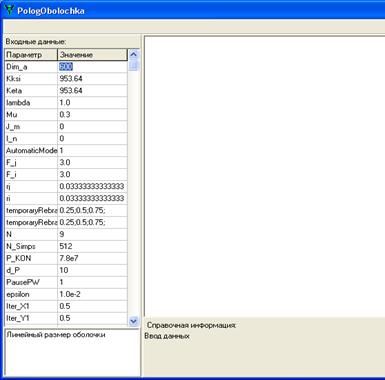
Рис.3. Ввод входных данных
Глава 3. Распараллеливание процесса вычисления. Основы, принципы, практическое применение
Распараллеливание процесса вычисления - процесс адаптации алгоритмов, записанных в виде программ, для их эффективного исполнения на вычислительной системе параллельной архитектуры. Заключается либо в переписывании программ на специальный язык, описывающий параллелизм и понятный трансляторам целевой вычислительной системы, либо к вставке специальной разметки (например, инструкций MPI или OpenMP[1]). [1]
История
В 1973 году Джон Шох и Джон Хапп из калифорнийского научно-исследовательского центра Xerox PARC написали программу, которая по ночам запускалась в локальную сеть PARC и заставляла работающие компьютеры выполнять вычисления.
В 1988 году Арьен Ленстра и Марк Менес написали программу для факторизации длинных чисел. Для ускорения процесса программа могла запускаться на нескольких машинах, каждая из которых обрабатывала свой небольшой фрагмент. Новые блоки заданий рассылались на компьютеры участников с центрального сервера проекта по электронной почте. Для успешного разложения на множители числа длиной в сто знаков этому сообществу потребовалось два года и несколько сотен персональных компьютеров.
С появлением и бурным развитием интернета всё большую популярность стала получать идея добровольного использования для распределённых вычислений компьютеров простых пользователей, соединённых через интернет.
В январе 1996 года стартовал проект GIMPS по поиску простых чисел Мерсенна.
28 января 1997 года стартовал конкурс RSA Data Security на решение задачи взлома методом простого перебора 56-битного ключа шифрования информации RC5. Благодаря хорошей технической и организационной подготовке проект, организованный некоммерческим сообществом distributed, быстро получил широкую известность.
17 мая 1999 года на базе платформы BOINC запущен проект SETI@home, занимающийся поиском внеземного разума путем анализа данных с радиотелескопов (анализ данных проводился и раньше, но без использования грид).
Такие проекты распределённых вычислений в интернете, как SETI@Home и Folding@Home обладает не меньшей вычислительной мощностью, чем самые современные суперкомпьютеры. Интегральный объем вычислений на платформе BOINC по данным на 16 мая 2010 года составляет 5.2 петафлопс, в то время как пиковая производительность самого мощного суперкомпьютера (Jaguar - Cray XT5-HE) - "всего" 2.3 петафлопс. Проект отмечен в Книге рекордов Гиннеса как самое большое вычисление.
Распараллеливание может быть ручным, автоматизированным и полуавтоматизированным. Для оценки эффективности его качества применяются следующие критерии:
Ускорение  , где
 -
время исполнения распараллеленной программы на p процессорах,
 - время исполнения исходной программы. В
идеальном случае (отсутствие накладных расходов на организацию параллелизма) равна
 .
Загруженность 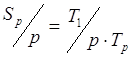 , показывающая долю использования процессоров.
В идеальном случае равна 1, или 100%. Эта величина зачастую гораздо более
наглядно характеризует эффективность параллелизма в серии испытаний при разных , чем
 ,
особенно на графиках.
При распараллеливании важно учитывать не только формальный параллелизм структуры алгоритма, но и то, что обменные операции в параллельных ЭВМ происходят, как правило, значительно медленнее арифметических. С этим связано существование львиной доли накладных расходов на организацию параллелизма.
В информатике параллельный алгоритм, противопоставляемый традиционным последовательным алгоритмам, - алгоритм, который может быть реализован по частям на множестве различных вычислительных устройств с последующим объединением полученных результатов и получением корректного результата.
Некоторые алгоритмы достаточно просто поддаются разбиению на независимо выполняемые фрагменты. Например, распределение работы по проверке всех чисел от 1 до 100000 на предмет того, какие из них являются простыми, может быть выполнено путем назначения каждому доступному процессору некоторого подмножества чисел с последующим объединением полученных множеств простых чисел (похожим образом реализован, например, проект GIMPS[2]).
С другой стороны, большинство известных алгоритмов вычисления значения числа π не допускают разбиения на параллельно выполняемые части, т.к требуют результата предыдущей итерации выполнения алгоритма. Итеративные численные методы, такие как, например, метод Ньютона или задача трёх тел, также являются сугубо последовательными алгоритмами. Некоторые примеры рекурсивных алгоритмов достаточно сложно поддаются распараллеливанию.
Параллельные алгоритмы весьма важны ввиду постоянного совершенствования многопроцессорных систем и увеличения числа ядер в современных процессорах. Обычно проще сконструировать компьютер с одним быстрым процессором, чем с множеством медленных процессоров (при условии достижения одинаковой производительности). Однако производительность процессоров увеличивается главным образом за счет совершенствования техпроцесса (уменьшения норм производства), чему мешают физические ограничения на размер элементов микросхем и тепловыделение. Указанные ограничения могут быть преодолены путем перехода к многопроцессорной обработке, что оказывается эффективным даже для малых вычислительных систем.
Сложность последовательных алгоритмов выражается в объеме используемой памяти и времени (числе тактов процессора), необходимых для выполнения алгоритма. Параллельные алгоритмы требуют учета использования еще одного ресурса: подсистемы связей между различными процессорами. Существует два способа обмена между процессорами: использование общей памяти и системы передачи сообщений.
Системы с общей памятью требуют введения дополнительных блокировок для обрабатываемых данных, налагая определенные ограничения при использовании дополнительных процессоров.
Системы передачи сообщений используют понятия каналов и блоков сообщений, что создает дополнительный трафик на шине и требует дополнительных затрат памяти для организации очередей сообщений. В дизайне современных процессоров могут быть предусмотрены специальные коммутаторы (кроссбары) с целью уменьшения влияния обмена сообщениями на время выполнения задачи.
Еще одной проблемой, связанной с использованием параллельных алгоритмов, является балансировка нагрузки. Например, поиск простых чисел в диапазоне от 1 до 100000 легко распределить между имеющимися процессорами, однако некоторые процессоры могут получить больший объем работы, в то время как другие закончат обработку раньше и будут простаивать. Проблемы балансировки нагрузки еще больше усугубляется при использовании гетерогенных вычислительных сред, в которых вычислительные элементы существенно отличаются по производительности и доступности (например, в грид-системах).
Разновидность параллельных алгоритмов, называемая распределенными алгоритмами, специально разрабатываются для применения на кластерах и в распределенных вычислительных системах с учетом ряда особенностей подобной обработки.
В данной работе был выбран интерфейс MPI для распараллеливания процесса, так как он наиболее удобен для создаваемого программного пакета. Ведь заранее неизвестно, какие вычислительные машины и какой конфигурации будут использоваться. MPI позволяет эмулировать[3] вычислительные машины на ядрах одного процессора, что, в некоторых случаях, гораздо более эффективнее при вычислениях.
3.1 Message Passing Interface
Message Passing Interface (MPI, интерфейс передачи сообщений) - программный интерфейс (API) для передачи информации, который позволяет обмениваться сообщениями между процессами, выполняющими одну задачу. Разработан Уильямом Гроуппом, Эвином Ласком и другими.
MPI является наиболее распространённым стандартом интерфейса обмена данными в параллельном программировании, существуют его реализации для большого числа компьютерных платформ. Используется при разработке программ для кластеров и суперкомпьютеров. Основным средством коммуникации между процессами в MPI является передача сообщений друг другу. Стандартизацией MPI занимается MPI Forum. В стандарте MPI описан интерфейс передачи сообщений, который должен поддерживаться как на платформе, так и в приложениях пользователя. В настоящее время существует большое количество бесплатных и коммерческих реализаций MPI. Существуют реализации для языков Фортран 77/90, Си и Си++.
Стандарты MPI
Большинство современных реализаций MPI поддерживают версию 1.1 Стандарт MPI версии 2.0 поддерживается большинством современных реализаций, однако некоторые функции могут быть реализованы не до конца.
В MPI 1.1 (опубликован 12 июня 1995 года) поддерживаются следующие функции:
передача и получение сообщений между отдельными процессами;
коллективные взаимодействия процессов;
взаимодействия в группах процессов;
реализация топологий процессов;
В MPI 2.0 (опубликован 18 июля 1997 года) дополнительно поддерживаются следующие функции:
динамическое порождение процессов и управление процессами;
односторонние коммуникации