Психологическая интуиция искусственных нейронных сетей
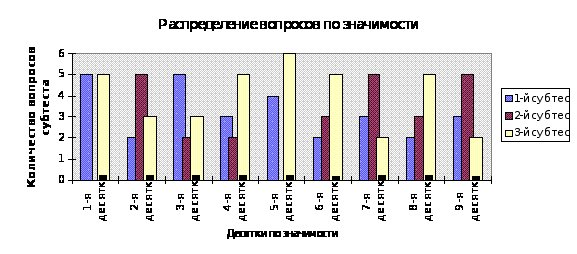
Для вопросов первого субтеста виден эксцесс распределения в сторону большей значимости, второго - в сторону меньшей, а вопросы третьего - относительно равномерно распределены по всему интервалу.
Была произведена серия экспериментов с целью выяснить достаточный для нейросети объем опросника. На каждом этапе исключалась половина из имеющихся вопросов опросника.
При исключении половины вопросов скользящий контроль консилиума сетей, обученных на выборке по всем группам, дал среднюю погрешность в 24%, при исключении трех четвертей вопросов - в 28% и, наконец, при исключении семи восьмых нейросети обучиться не смогли.
Таким образом, примерно половина вопросов и без того изначально минимизированного теста оказалась для нейросети избыточной, даже приводящей к ухудшению оценки качества предсказания. Оптимальным можно признать опросник из половины вопросов, максимальных по своей значимости для нейронной сети, поскольку результаты тестирования для него лучше чем для всех остальных вариантов, включая и полный набор вопросов.
3.6 Оценка оптимизации задачника нейросетью с позиций теории информации
Разницу между первоначальным (заданным психологом) и требуемым нейросети для успешного решения задачи объемом опросника можно оценить с позиций теории информации [95].
Начальное количество информации, содержащейся в тесте можно оценить исходя из того, что вопросы первого и третьего тестов бинарны (варианты ответов «Да» и «Нет», вероятность наступления каждого из них - 0.5), а ответы на вопросы второго - могут с равной вероятностью соответствовать наступлению одного из трех событий, которые будем считать равновероятными (варианты ответов «А», «Б» и «В», p=0.333). Тогда, исходя из формулы Шеннона
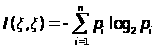
и учитывая, что количество вопросов в первом субтесте - 29, во втором - 25 и в третьем - 36 можем вычислить суммарное количество информации, содержащееся в ответах на вопрос теста:
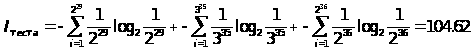 .
После исключения половины вопросов из-за их малой значимости для нейронной сети в оптимизированном опроснике осталось 16 вопросов первого субтеста, 9 - второго и 20 - третьего. Количество информации, оставшееся после оптимизации:
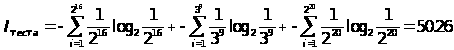 ,
то есть количество информации при оптимизации сократилось несколько более чем вдвое.
3.7 Эксперименты по предсказанию парных взаимоотношений
В этой серии экспериментов предполагалось установить, способны ли нейросети воспроизвести взаимоотношения пары испытуемых.
Обучающие выборки имели следующую структуру: № - номер примера, ID_From - номер оценивающего, ID_From - имя оценивающего, ID_To - номер оцениваемого, Name_To - имя оценивающего, w1_1_From - w3_36_From - ответы на вопросы опросника А.Г. Копытова, данные оценивающим, w1_1_To - w3_36_To - ответы на вопросы опросника А.Г. Копытова, данные оцениваемым, Ocen - данная оценка.
В задачник включались строки, соответствующие всем клеткам социометрической матрицы кроме диагональных, отвечающих за самооценку испытуемых.
Был сформирован задачник по группе 5-го курса. В него вошли 132 примера, по которым было произведено обучение соответствующего числа сетей по методике скользящего контроля.
В силу большой трудоемкости задачи обучения по выбооркам такого объема и размерности (обучение одной сети занимает около 40 мин.) обучения консилиумов не проводилось.
Результат скользящего контроля следующий: средняя относительная ошибка предсказания парных взаимоотношений в группе составила 33,1%.
Затем
было вычислено
среднее расстояние
 между
случайными
оценками
 и
 ,
вычисляемое,
как и в п.3.4, по
формуле
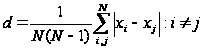 ,
где N - количество примеров обучающей выборки.
Данная величина составила 6.612 (или, относительно шкалы измерения признака, 66.12%), то есть отличие предсказания сети от случайного почти двукратное.
Таким образом, можно говорить, что нейронные сети могут предсказывать не только усредненный статус члена группы, но и взаимоотношения между двумя произвольно взятыми личностями.
Выводы главы 3
Нейронная сеть способна на основе только психологических свойств исследуемых, без привлечения фактов социальной истории исследуемых личностей, интуитивно порождать прогноз результатов социометрического эксперимента на базе, со средней ошибкой 23-30%.
Данный прогноз общезначим для всех исследуемых с равным социальным статусом и устойчив относительно состава группы.
Аппарат нейронных сетей позволяет оптимизировать психодиагностические тестовые методики по объему точнее, чем это доступно даже опытному психологу.
Глава 4. Полутораслойный предиктор с произвольными преобразователями
4.1 Постановка проблемы
Функция
F на R задана
набором своих
значений в
случайных
точках пространства
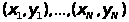 .
Построим ее
аппроксимацию
при помощи
комбинаций
 -
функций из
набора
 ,
гладких и непрерывно
дифференцируемых.
Тогда
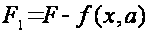 -
ошибка аппроксимации
F функцией
 ;
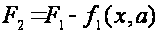 -
ошибка предыдущего
шага аппроксимации
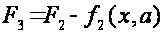
Аппроксимация
может вестись
не только подбором
коэффициентов,
но и выбором
на каждом шаге
функций
 из
.
Таким образом
может быть
получено разложение
функции F в
сходящийся
ряд вида:
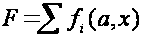
Решение задачи аппроксимации может быть получено путем минимизации функционала качества, соответствующего квадрату отклонения:
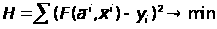 ,
Задача состоит в приближении функции F, заданной исходной выборкой точек, при помощи нейросети-предиктора с неизвестным заранее количеством нейронов и видом функции, используемой в преобразователе каждого из нейронов.
Решение может быть представлено как итерационный процесс, состоящий из следующих шагов:
- Подключение нового нейрона;
- Оптимизация ошибки предсказания значений в заданных точек для текущего нейрона путем подбора функции преобразователя, ее параметров и весов синапсов;
Если заданная точность достигнута, то процесс можно остановить, в противном случае - процесс повторяется сначала, причем параметры уже обученных нейронов фиксируются, так что каждый новый нейрон обучается вычислять погрешность, оставшуюся от предыдущих.
Количество итераций процесса исчерпания ошибки может быть также ограничено из условия превышения нижней оценки константы Липшица для конструируемой нейронной сети над верхней оценкой выборочной константы Липшица.
4.2 Аналитическое решение
Пусть
 - приближаемое
очередным слоем
значение. Тогда
 - само значение
приближаемой
функции в точках
экспериментальной
выборки, а
 и последующие
- погрешности
вычисления
на соответствующем
шаге.
Обучение ведется оптимизацией параметров сети каким либо из градиентных методов по всему задачнику.
Тогда при обучении k-го нейрона
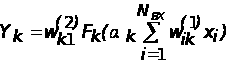 ,
соответственно H (функция ошибки) для всего задачника будет иметь вид
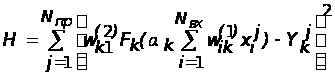 ,
то есть в качестве критерия близости аппроксимируемой и аппроксимирующей функций выбрана сумма квадрата ошибки по всей обучающей выборке.
Для
обучения каждого
очередного
нейрона используются
частные производные
функции
 по весам синапсов
первого слоя
 :
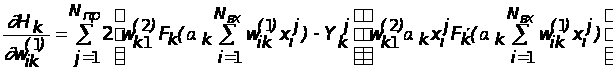 ,
параметру
нейрона

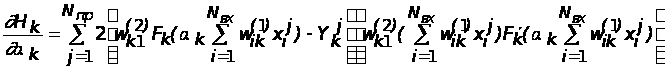
и
весу синапса
второго (выходного)
слоя
 соответствующему
данному нейрону
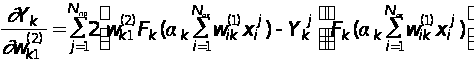 ,
где
 - число примеров
обучающей
выборки.
Однако, если вычисление функции H связано с затратами процессорного времени порядка TH, то вычисление ее градиента традиционным способом потребует времени порядка
TgradH=nTH,
где n - число переменных функции H. Учитывая, что в задачах, для которых традиционно применяются нейросети, величина n может достигать нескольких тысяч, аналитическое решение для вычисления градиента функции ошибки следует признать неприемлемым.
Однако при описании решающей функции F в виде сети автоматов вычисление градиента функции ошибки H может быть представлено как функционирование системы, двойственной исходной. При таком подходе
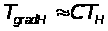 ,
где C - константа, не зависящая от размерности n и в большинстве случаев примерно равная 3.
Таким образом, мы приходим к записи решения исходной задачи в идеологии нейронных сетей.
4.3 Запись решения в идеологии нейросетей
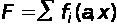 может быть
представлен
как нейронная
сеть, имеющая
структуру,
показанную
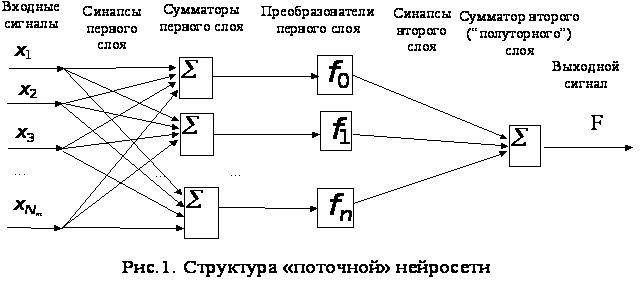
на рис.1.
Тогда вычисление градиента функции ошибки H можно производить, используя схему, двойственную данной. При этом решение задачи может быть существенно упрощено применением следующего приема. Поскольку обучение следующего слоя начинается тогда, когда предыдущие уже обучены, а их связи зафиксированы, то, фактически, каждый нейрон обучается отдельно от других, а в качестве значения, вычисляемого k-м нейроном берется погрешность вычисления функции предыдущими k-1 - нейронами, или Fi.
Процесс обучения всей сети сводится этим ее разбиением к ряду последовательных процессов обучения структур вида, представленного на рис. 2.
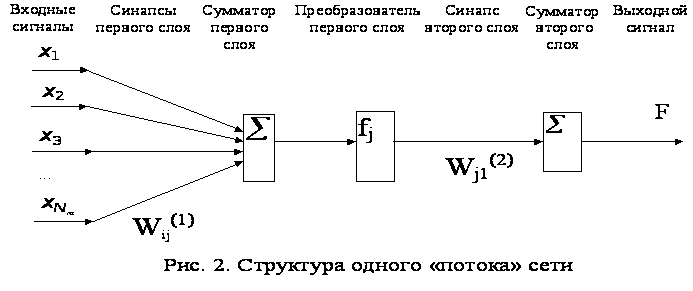
Здесь x1 - xN - входные сигналы сети, Wij(1) - синапсы первого слоя от i-го входа к j-му сумматору первого слоя, Wj1(2) - синапсы второго слоя от j-го преобразователя к выходному сумматору, fj - j-й преобразователь, символом обозначаются тривиальные сумматоры.
Далее в тексте такая структура будет именоваться «потоком сети» или просто «потоком».
Вычисление производных H (функции ошибки) для сети, представляющего собой один «поток», можно вести на основе аппарата двойственных функций и алгоритма обратного распространения ошибки. Схема прохождения сигналов при обратном функционировании показана на рис. 3.
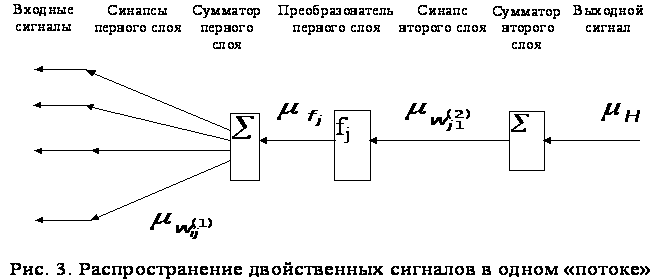
Здесь
 - двойственный
сигнал от функции
оценки, передаваемый
без изменения
через тривиальный
сумматор второго
слоя,
 - двойственный
сигнал от
соответствующего
синапса второго
слоя,
 - двойственный
сигнал от
преобразователя
j-го «потока»,
передающийся
сумматору для
раздачи на
синапсы,
 - двойственные
сигналы соответствующих
синапсов первого
слоя.
4.4 Алгоритмическая часть
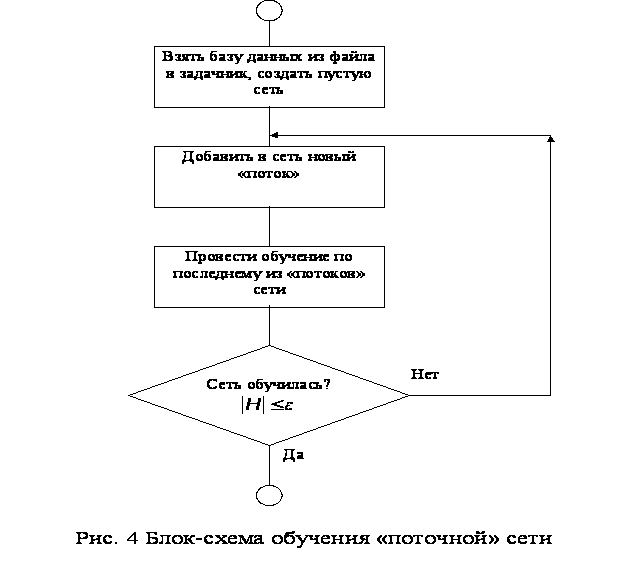
Обучение сети, состоящей из «потоков» производится в соответствии с алгоритмом, представленным на рис. 4.
Здесь H - значение оценки сети, накопленное по всему задачнику, - константа малости ошибки.
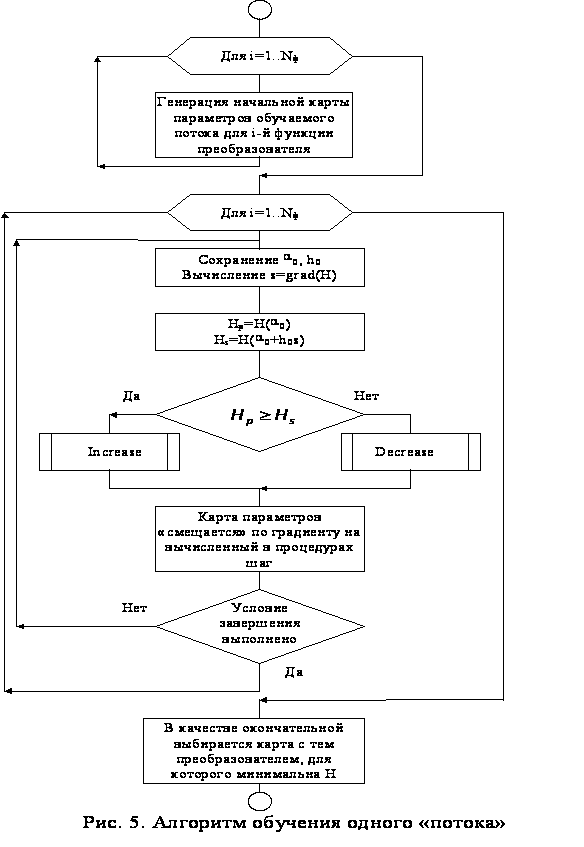
Для обучения каждого из потоков используется алгоритм, показанный на рис.5. Здесь Nф - общее число функций, по которому идет обучение, o - карта параметров сети, h0 - шаг оптимизации в начале цикла, s - градиент функции оценки H по обучаемым параметрам.
Используемое в алгоритме условие остановки формируется из двух подусловий, скомбинированных через «или»:
Число
шагов оптимизации,
во время которых
 превысило
заранее заданную
величину (при
обучении
использовалось
значение Nsh=15),
то есть сеть
в данной конфигурации
уже не может
улучшить оценку;
Достигнуто
заданное значение
функции оценки
 ,
то есть сеть
уже обучена.
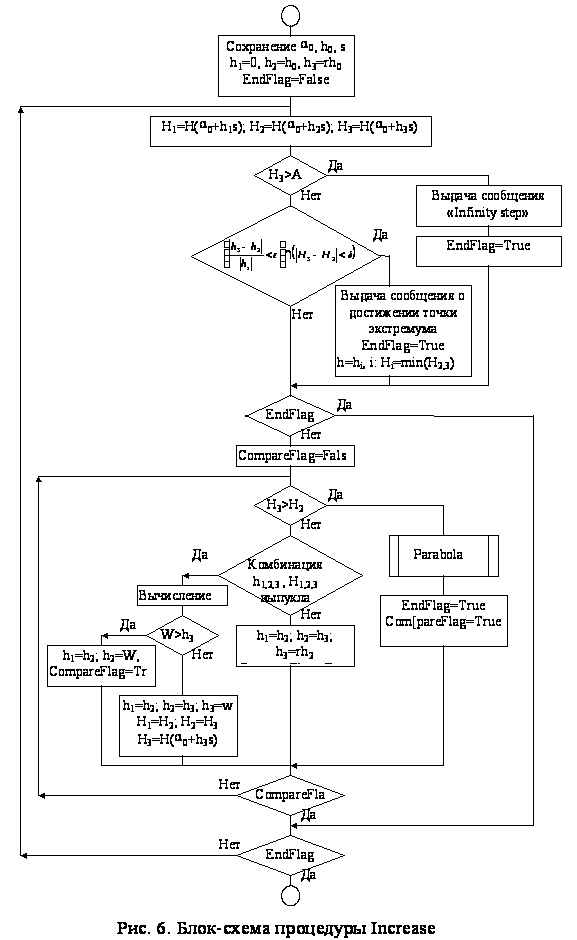
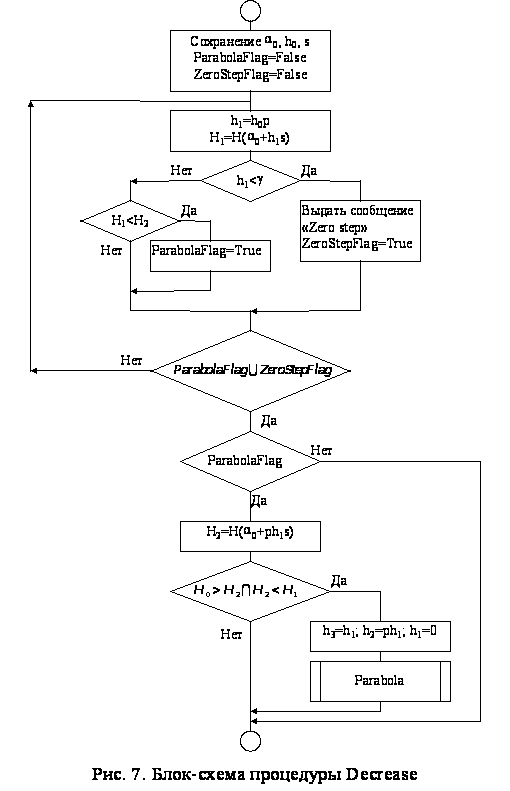
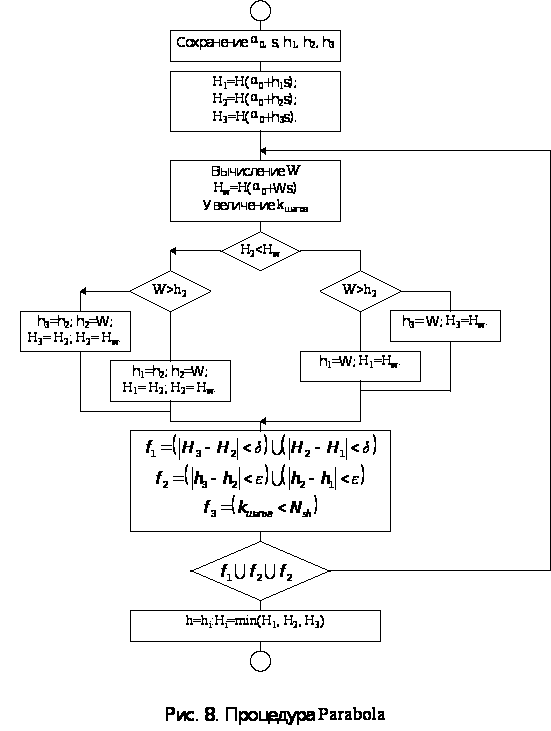
При обучении одного потока используются процедуры подбора шага оптимизации - Increase (поиск шага в сторону возрастания, блок-схему см. на рис. 6), Decrease (поиск шага в сторону убывания, блок-схему см. на рис. 7) и Parabola (поиск оптимального шага по формулам параболического поиска блок-схему см. на рис. 8).
В процедурах используются следующие обозначения:
H(...) - функция оценки сети, накопленная по всему задачнику;
h1, h2, h3 - различные значения величины шага оптимизации, используемые при ее подборе;
W - величина шага в вершину параболы, проходящей через точки (h1, H1), (h2, H2), ( h3, H3). Вычисляется по формуле:
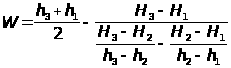
H1, H2, H3 - значения функции ошибки, соответствующие смещению обучаемых параметров по направлению градиента на величину шага h1, h2 и h3.
Условие выпуклости комбинации h1,2,3, H1,2,3 определяется формулой
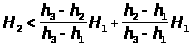
Если выражение истинно, то условие выпуклости выполнено.
Теперь, рассмотрев алгоритмы обучения сети, перейдем к описанию компонентов, структуры и функционирования сети.
4.5 Оценка информационной емкости нейронной сети при помощи выборочной константы Липшица
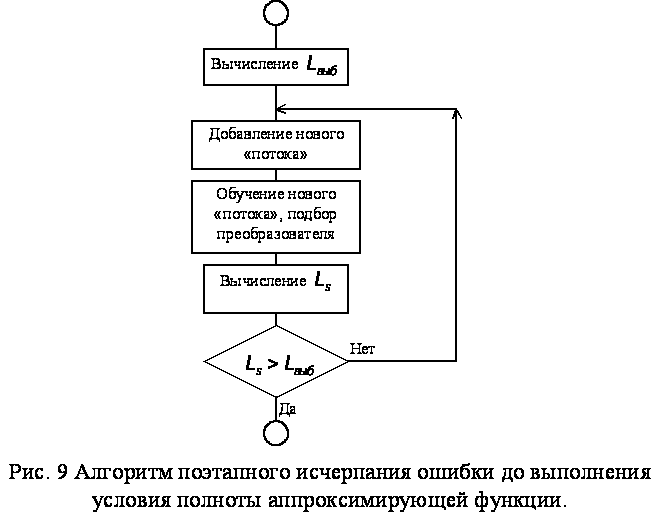
Условие
остановки
процесса пошагового
исчерпания
ошибки может
основываться
также на оценке
полноты функции,
заданной нейронной
сетью. В случае,
если число
элементов сети
задано (для
каждого шага
наращивания
«поточной»
это так) и значения
ее параметров
ограничены
на определенном
интервале (это
условие выполняется
наложением
ограничений
на параметры
сети), данное
условие можно
сформулировать
с использованием
константы
Липшица. Константа
Липшица вектор-функции
 в области D
определяется
как
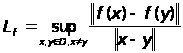 .
Верхняя грань
может быть
вычислена по
области определения
D. В качестве
оценки расстояния
используется
евклидова
норма.
Для
суперпозиции
вектор-функций
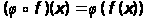
 .
Для
линейной комбинации
функций
 оценка константы
Липшица
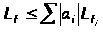 .
Константа
Липшица для
адаптивного
сумматора,
работающего
по формуле
 имеет вид
 .
Тогда
для стандартной
комбинации,
состоящей из
матрицы входных
синапсов, сумматора
и преобразователя
- нейрона с гладкой
функцией активации

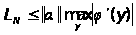 .
Для
прямой суммы
вектор-функций
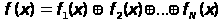 константа
Липшица может
быть оценена
как
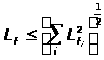 .
Таким
образом, для
слоя нейронов
с подбираемыми
преобразователями
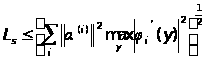 ,
где
 - вектор весов
синапсов, приходящих
на входной
сумматор i-го
нейрона, а
 - функция i-го
преобразователя.
Если
заменить всю
область определения
функций D
на конечное
множество
(задачник), то
условие, определяющее
требуемый объем
нейронной сети
можно получить,
сравнивая
 с оценкой константы
Липшица для
обучающей
выборки
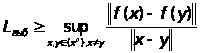 .
 является нижней
оценкой константы
Липшица аппроксимируемой
функции. Нейросеть
может реализовать
данную функцию
только в том
случае, когда
 .
4.6 Соглашение о терминологии
Изложение вопросов, связанных со структурой и функционированием сети, тесно связано с программной реализацией задачи. Поэтому по тексту будут встречаться ссылки на реальные структуры программы.
Для описания компонентов сети был использован аппарат объектно-ориентированного программирования [28], реализованный в среде разработки программ Borland Delphi Developer v.3.0. (см. [44], [45], [58], [63], [75], [76])
Базовым понятием в языке программирования Object Pascal, встроенном в Delphi, является класс - особый вид записи, включающий поля и методы.
Экземпляр класса называется объектом.
Понятие поле для объекта аналогично понятию поля для записи.
Метод - процедура или функция, описанная внутри класса и предназначенная для операции над его полями.
4.7 Компоненты сети
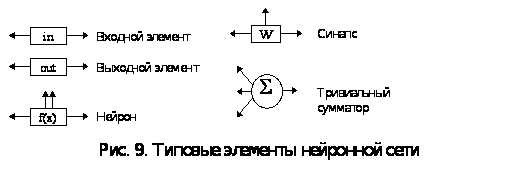
Традиционный состав элементов сети (см. главу 1) включает в себя следующие элементы: нейрон, синапс, сумматор. Кроме того, в число типовых включены входной и выходной элементы.
На рис. 9 показаны схематические изображения элементов сети, которые далее будут использованы в схемах, описывающих структуру и функционирование программной модели.
4.8 Общий элемент сети
Базовым типом элементов, используемых для описания нейронной сети, является общий элемент сети - класс, инкапсулирующий основные свойства и методы, характерные для всех компонентов сети. Название этого класса в программной реализации - TNetPiece.
Объекты данного класса включают в себя следующие поля:
NextPiece - указатель на следующий элемент сети;
PriorPiece - указатель на предыдущий элемент сети;
ForwOut - значение сигнала, передающегося элементом вперед при прямом функционировании;
BackOut - значение сигнала, передающегося элементом назад при обратном функционировании.
Набор методов включает в себя:
Create - описание создания объекта;
Destroy - действия при разрушении (удалении) объекта;
ForwardTact - действия элемента во время такта прямого функционирования;
BackwardTact - действия элемента во время такта обратного функционирования;
При описании методов ForwardTact и BackwardTact они были оставлены пустыми, так как функционирование конкретных элементов сети существенно различно.
Однако введение этих методов имеет достаточно глубокий смысл, поскольку класс TNetPiece является предком всех прочих классов, описывающих элементы сети, и наличие типовых процедур прямого и обратного функционирования позволяет использовать такие свойства модели объектно-ориентированного программирования как наследование свойств и методов и полиморфизм. Подробнее этот тезис будет раскрыт ниже.
4.9 Вход сети
Для связи сети с задачником и передачи используются объекты класса TNetInput - входной элемент сети.
Данный класс является потомком TNetPiece, и поэтому наследует его набор полей и методов этого класса, а кроме того добавлено поле SourceSignal, которое содержит номер поля задачника, с которого данный вход сети забирает значение.
Методы ForwardTact и BackwardTact перекрыты, то есть их код заменен на тот, который соответствует назначению входного элемента.
Метод ForwardTact выполняет передачу значения из соответствующего данному элементу поля задачника на выходной сигнал элемента, поле ForwOut.
Метод BackwardTact передает двойственный сигнал следующего элемента на свой двойственный сигнал (поле BackOut).
4.10 Выход сети
Выходной элемент сети описывает класс TNetOutput, также являющийся потомком TNetPiece.
В методах ForwardTact и BackwardTact заложены действия элемента при прямом и обратном тактах функционирования.
Метод ForwardTact выполняет передачу сигнала от выхода предыдущего на выход данного элемента, кроме того в поле H заносится значение ошибки сети при вычислении функции Y.
Метод BackwardTact передает на обратный выход элемента (поле BackOut) значение двойственного сигнала. Двойственный сигнал H представляет собой производную функции ошибки по выходному сигналу сети:
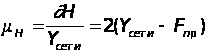 ,
где
 - аппроксимированное
значение функции,
выдаваемое
сетью,
 - значение
аппроксимируемой
функции в данном
примере.
4.11 Синапс сети
Для описания синапсов сети используются объекты класса TNetSynapse. Как наследник класса TNetPiece он наследует все его поля и методы. Помимо этого в список полей включены Alpha - параметр, представляющий собой вес синапса, и MuAlpha - сигнал, двойственный весу синапса.
На такте прямого функционирования метод ForwardTact снимает выходной сигнал предыдущего элемента, умножает его на вес