Распараллеливание многоблочных задач для SMP-кластера
Аннотация
Оптимизация распределения данных и вычислений между процессорами является важным шагом при распараллеливании многоблочных задач. В первом разделе описаны параллельные системы и актуальность многоблочного метода. Во втором и третьем разделе определены цели и задачи данной работы. В четвертом и пятом разделе приводится обзор существующих алгоритмов и предлагается эффективный метод отображения подзадач, допускающих распараллеливание. В шестом разделе описана практическая реализация. Полученный результат в будущем может быть усовершенствован путём ввода в рассмотрение неоднородных вычислительных систем, а также учёта затрат на коммуникации.
Оглавление
1 Введение
1.1 Параллельная ЭВМ и распределенные системы
1.2 Многоблочный метод решения сложных задач
1.3 Программирование параллельных ЭВМ
2 Цель работы
3 Постановка задачи
4 Обзор существующих решений
4.1 Алгоритм сокращения критического пути (CPR)
4.2 Упаковка в контейнеры
4.3 Алгоритмы EVAH
5 Исследование и построение решения задачи
5.1 Первоначальные предложения по отображению
5.2 Эволюция предложений по отображению
6 Описание практической части
6.1 Обоснование выбранного инструментария
6.2 Общая архитектура разработанного средства
6.3 Схема работы средства
6.4 Характеристики функционирования
7 Заключение
8 Список цитируемой литературы
1 Введение
В истории развитии микропроцессоров и больших интегральных схем известен закон Мура. В 1965 году в процессе подготовки выступления, Гордон Мур сделал такое наблюдение: новые модели микросхем разрабатывались спустя более-менее одинаковые периоды — 18-24 месяца — после появления их предшественников, а емкость их при этом возрастала каждый раз примерно вдвое. Но даже при такой скорости развития мощность отдельных вычислительных машин не может удовлетворять современные потребности физиков-математиков. Появились суперкомпьютеры и кластеры, разработаны параллельные алгоритмы, распределенные методы и системы. Для работы на таких системах нужно распараллеливать программы, а также в таких распределенных системах важную роль играет балансировка вычислений.
1.1 Параллельная ЭВМ и распределенные системы
В настоящее время идет развитие параллельной высокопроизводительной вычислительной техники по следующим направлениям:
Векторно-конвейерные компьютеры. Конвейерные функциональные устройства и набор векторных команд - это две особенности таких машин. В отличие от традиционного подхода, векторные команды оперируют целыми массивами независимых данных, что позволяет эффективно загружать доступные конвейеры, т.е. команда вида A=B+C может означать сложение двух массивов, а не двух чисел. Характерным представителем данного направления является семейство векторно-конвейерных компьютеров CRAY куда входят, например, CRAY EL, CRAY J90, CRAY T90, новые CRAY X1/X1E.
Параллельные компьютеры с общей памятью. Вся оперативная память таких компьютеров разделяется несколькими одинаковыми процессорами. Это снимает проблемы предыдущего класса, связанные с необходимостью явного выделения векторных операций в программе, а также позволяет распределить неоднородную работу (например, пока один процессор складывает, одновременно с ним другой может умножать), но добавляет новые - число процессоров, имеющих доступ к общей памяти, по чисто техническим причинам нельзя сделать большим. В данное направление входят многие современные многопроцессорные SMP-компьютеры или, например, отдельные узлы компьютеров HP Exemplar, HP Superdome и Sun StarFire.
Массивно-параллельные компьютеры с распределенной памятью. Идея построения компьютеров этого класса тривиальна: возьмем серийные микропроцессоры, снабдим каждый своей локальной памятью, соединим посредством некоторой коммуникационной среды - вот и все. Достоинств у такой архитектуры масса: если нужна высокая производительность, то можно добавить еще процессоров, если ограничены финансы или заранее известна требуемая вычислительная мощность, то легко подобрать оптимальную конфигурацию и т.п.
Однако есть и решающий "минус", сводящий многие "плюсы" на нет. Дело в том, что межпроцессорное взаимодействие в компьютерах этого класса идет намного медленнее, чем происходит локальная обработка данных самими процессорами. Именно поэтому написать эффективную программу для таких компьютеров очень сложно, а для некоторых алгоритмов иногда просто невозможно. К данному классу можно отнести компьютеры Intel Paragon, IBM SP1, Parsytec, в какой-то степени IBM SP2 и CRAY T3D/T3E/X1/XMT, хотя в этих компьютерах влияние указанного минуса значительно ослаблено. К этому же классу можно отнести и сети компьютеров, которые все чаще рассматривают как дешевую альтернативу крайне дорогим суперкомпьютерам.
Кластеры. Вычислительный кластер – это мультикомпьютер, состоящий из множества отдельных компьютеров (узлов), связанных между собой единой коммуникационной системой. Каждый узел имеет свою локальную оперативную память. При этом общей физической оперативной памяти для узлов не существует. Если в качестве узлов используются мультипроцессоры (мультипроцессорные компьютеры с общей памятью), что в настоящее время является повсеместно практикуемым, то такой кластер называется SMP-кластером. Коммуникационная система обычно позволяет узлам взаимодействовать между собой только посредством передачи сообщений, но некоторые системы могут обеспечивать и односторонние коммуникации - позволять любому узлу выполнять массовый обмен информацией между своей памятью и локальной памятью любого другого узла. Если все входящие в состав вычислительного кластера узлы имеют одну и ту же архитектуру и производительность, то мы имеем дело с однородным вычислительным кластером. Иначе – с неоднородным.
Кластерное направление, строго говоря, не является самостоятельным, а скорее представляет собой комбинации предыдущих трех. Но именно это направление является наиболее перспективным в настоящее время.
1.2 Многоблочный метод решения сложных задач
Известно, что при решении сложных физико-математических задач, например в задачах вычислительной гидроаэродинамики со сложной геометрией (газовая динамика, обтекание самолета, внутреннее течение в реакторах, и т.д.) построение единой целой сетки для расчетной области является трудным процессом, а одинаковая подробность приведет к излишним затратам ресурсов – нужны сетки разные – для одних областей более грубые, для других – более точные. Для решения данной проблемы можно применить подход многоблочного метода:
Физическая область может быть разбита на несколько зон или блоков. Границы блоков могут не соответствовать границам физической области.
Для каждого блока отдельно строится сетка в соответствии с граничными условиями.
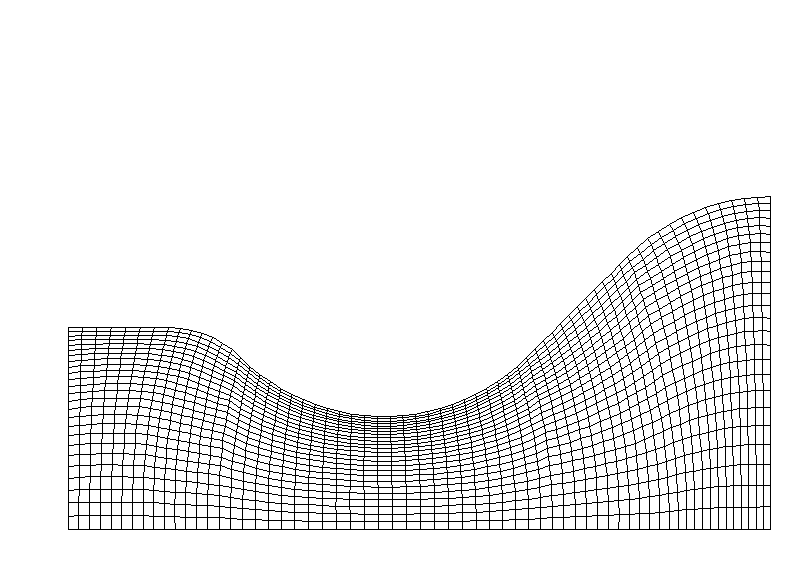
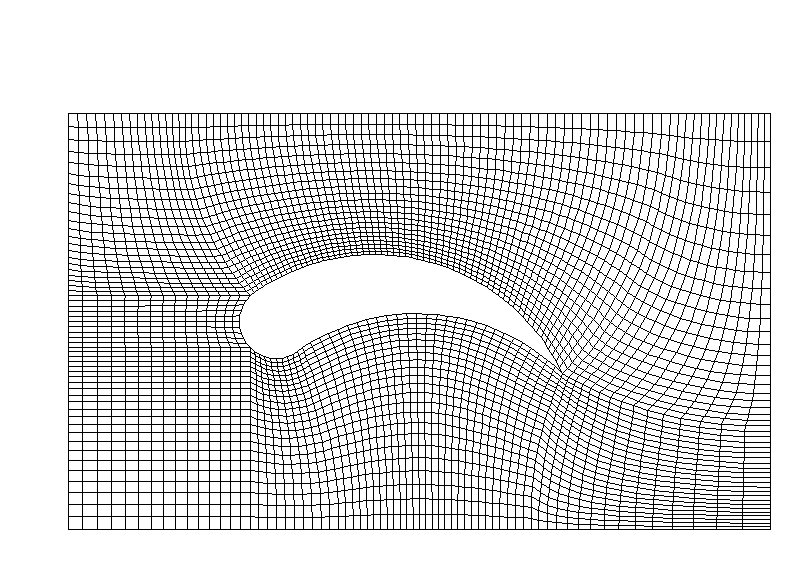
Рисунок 1. Примеры сеток в многоблочном методе
При счете многоблочной задачи подзадачи для блоков считаются практически независимо, обмениваясь только границами с соседними блоками после каждого временного шага. При большом количестве блоков сбалансированное их распределение по вычислителям может дать заметный выигрыш во времени исполнения всей задачи по сравнению с другими распределениями. Также возможно построение более эффективного распределения при использовании параллелизма внутри подзадач.
1.3 Программирование параллельных ЭВМ
Чтобы считать задачу на параллельном вычислителе, она должна быть распараллелена. Распараллеливать может:
пользователь - сразу написав параллельную программу. Разработка параллельной программы с помощью специализированного набора средств программирования предполагает либо использование специального языка программирования параллельного компьютера, либо традиционного языка программирования последовательных машин, расширенного набором спецификаций параллельной обработки данных, либо традиционного языка и библиотеки, реализующей конкретную модель параллельного выполнения.
Для научно-инженерных расчетов применяются следующие модели программирования:
Модель передачи сообщений
Каждый процесс обладает собственным локальным адресным пространством. Для синхронизации и обработки общих данных используется передача сообщений. Стандартом интерфейса передачи сообщений является MPI.
Модель с общей памятью
Все процессы разделяют единое адресное пространство. Доступ к общим данным регулируется с помощью примитивов синхронизации. Стандартом для моделей с общей памятью стал OpenMP.
Модель параллелизма по данным
В этой модели данные разделяются между узлами вычислительной системы, а последовательная программа их обработки преобразуется компилятором в программу либо в модели передачи сообщений, либо в модели с общей памятью. При этом вычисления распределяются по правилу собственных вычислений: каждый процессор выполняет вычисления данных, распределенных на него. Примером реализации этой модели является стандарты HPF1 и HPF2. На модели параллелизма по данным была также разработана отечественная система DVM.
пользователь вместе со специальной программой-распараллеливателем в автоматизированном режиме - указывая свойства последовательной программы
автоматический распараллеливатель – он извлекает параллелизм самостоятельно из последовательной программы и распараллеливает ее в автоматическом режиме без участия пользователя
В каждом варианте есть свои недостатки. В первых двух пользователю приходится активно участвовать в процессе распараллеливания (а в первом и вовсе написать новую – параллельную программу), а в третьем зачастую получаются неэффективные результаты.
Подавляющее большинство программ для систем с распределенной памятью в настоящее время разрабатываются в модели передачи сообщений (MPI). Языки, поддерживающие модель параллелизма по данным (HPF, Fortran-DVM, C-DVM), значительно упрощают разработку программ, но их использование очень ограничено. Кардинальные изменения архитектуры ЭВМ (многоядерность, использование в качестве ускорителей графических процессоров) требуют появления новых языков высокого уровня, обеспечивающих более высокий уровень автоматизации программирования, в том числе и при создании многоблочных программ.
Всем используемым на многопроцессорных ЭВМ с распределенной памятью языкам программирования (включая и DVM-языки) присущ один серьезный недостаток – ручное отображение подзадач на процессоры. Для большого количества подзадач и большого количества процессоров сделать вручную эффективное отображение очень затруднительно.
2 Цель работы
Целью данной работы являются следующие шаги по развитию средств поддержки многоблочных программ в DVM-системе:
обеспечить автоматическое (а не только ручное) отображения подзадач на процессоры
обеспечить балансировку загрузки процессоров за счет эффективного отображения подзадач с учетом возможности их параллельного выполнения.
3 Постановка задачи
Дана многоблочная программа на языке Fortran-DVM, использующая механизм подзадач DVM.
Требуется разработать и реализовать эффективный алгоритм автоматического отображения подзадач на процессоры; изменить способ кодирования операций отображения и запуска подзадач, чтобы обеспечить использование алгоритма автоматического отображения; сравнить характеристики выполнения исходной программы с ручным отображением и программы с автоматическим отображением.
4 Обзор существующих решений
4.1 Алгоритм сокращения критического пути (CPR)
CPR предложен разными авторами из голландского политехнического университета Delft и французского института INRIA. Сначала алгоритм был разработан для планировщика задач в многопроцессорных системах, где граф задач можно моделировать в виде ориентированного ациклического графа. Существуют и другие подходы для решения такого рода задач (TwoL, CPA, TSAS) [5], но CPR показывает самый приемлемый результат.
CPR можно применить для распределения многоблочных задач (при условии возможности построения ориентированного ациклического графа).
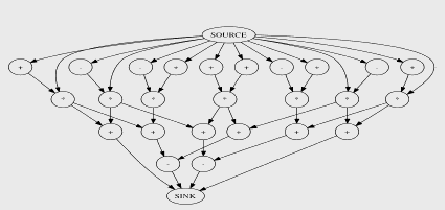
Рисунок 2. Иллюстрация ориентированного ациклического графа блоков
Определение
Критический путь (T): самый длинный путь в графе (от входа до выхода).
Верхний критический путь блока t (Tv): самый длинный путь от входа до t
Нижний критический путь блока t (Tn): самый длинный путь от t до выхода
P - количество процессоров в системе.
N(t) - Количество процессоров, выделенных для блока t.
Описание алгоритма
Шаг 1. Для каждого блока ti выделен один процессор N(ti) = 1. Построить расписание.
Шаг 2. Пусть X – множество всех блоков, для которых выделено меньше P процессоров.
Шаг 3. Пусть блок t – блок, у которого сумма Tv + Tn максимальная.
Выделить для t дополнительный процессор, N(t) = N(t) + 1. Построить новое текущее расписание.
Если после выделения, новый критический путь T’ < T то T = T’, иначе N(t) = N(t) – 1 и блок t исключить из множества X и считать предыдущее расписание текущим.
Шаг 4. Повторяем шаг 3 пока X не пусто
Суть алгоритма состоит в выделении максимально возможного количества процессоров для каждого блока с целью сокращения критического пути (т.е. сокращение общего времени выполнения всех блоков). Данный алгоритм исходит из наличия алгоритма построения расписания.
Алгоритм эффективный, учитывает зависимости между блоками, но не рассматривает проблему назначения групп процессоров для конкретных блоков и составления расписания их прохождения.
4.2 Упаковка в контейнеры
Bin-packin это множество алгоритмов для решения задачи: объекты различных объемов должны быть упакованы в конечное число контейнеров так, чтобы минимизировать количество используемых контейнеров. В нашем случае упаковка в контейнеры используется для равномерного распределения задач по всем процессорам.
Упаковка в контейнеры без разбиения объектов
Имеем список объектов L=(a1, a2, …, an) и их размеры s(ai) Є {1, 2, …, U}. Размер контейнеров V больше U, количество контейнеров m. Отсортируем список объектов по размеру в убывающем порядке. Первые m объектов упаковывать соответственно будем в m контейнеров. С остальными объектами действуем по принципу: упаковывать в контейнер, у которого занимаемого места меньше всего.
Упаковка в контейнеры с разбиением объектов
Существует два возможных варианта упаковки в контейнеры с разбиением объектов [4]: с сохранением и с увеличением объема данных. Будем рассматривать вариант с увеличением объема данных, так как после разбиения часто появляются дополнительные коммуникации между фрагментами.
Имеем список объектов L=(a1, a2, …, an) и их размеры s(ai) Є {1, 2, …, U}, U – размер контейнеров.
Введем некоторые понятия:
Эффективность алгоритма A: RA(L) = A(L)/OPT(L), где A(L) – нужное количество контейнеров когда применяем алгоритм A на список объектов L, OPT(L) – оптимальное количество контейнеров для данного списка объектов.
R называется асимптотической эффективностью в худшем случае, если
R = inf{r>=1: для некоторых N>0, RA(L)<=r для всех L где OPT(L)>=N}
Алгоритм А называется алгоритмом без лишнего разбиения если:
a) Разбивает объект только тогда, когда его размер больше размера контейнера
б) Разбивает объект на два фрагмента так, чтобы первый фрагмент вместится полностью в одном из контейнеров
в) Открывает новый контейнер только тогда, когда в уже открытых контейнерах нельзя упаковать новый фрагмент.
Известно, что для всех алгоритмов упаковки в контейнеры без лишнего разбиения:
R <= U/(U-2), U>2
Теперь рассмотрим алгоритмы NF, NFD, NFI, FFD-I
NF - Next-Fit
На каждом шаге открываем только один контейнер, упаковываем объекты по очереди, если размер объекта больше размера свободной части контейнера – разобьем на две части так, чтобы первая часть заполнила контейнер. После этого открываем новый контейнер и вторую часть туда упаковываем. Это очень простой алгоритм и имеет плохую эффективность
RNF=U/(U-2), U>=6
NFD, NFI (Next-Fit с ранее отсортированным списком объектов по размеру в убывающем/возрастающем порядке)
RNFD >= U/(U-2) если U=2n, n>=3
RNFD >= (U+1)/(U-1) если U=2n+1, n>=2
Но это только нижняя оценка, мы вполне сможем подобрать пример, когда NFD и NFI работают тоже плохо, как и NF.
FFD-I и FFI-I (Iterative First-Fit Decreasing/Increasing with Item fragmentation)
Попробуем упаковать все объекты списка L в фиксированное количество m контейнеров. Сортируем список объектов по размеру в невозрастающем порядке. Каждый объект будем упаковывать в первый подходящий контейнер, если такого нет, разобьем объект на две части. Первая часть должна заполнить первый свободный контейнер, а вторую часть положим в отсортированный список объектов. Если не удалось упаковать все объекты в m контейнеров, увеличиваем m и повторяем.
Пусть s(L) – сумма всех объектов в списке L.
1) Взять m=[s(L)/U]
2) FFD()
3) Если успешно, останавливаем
4) Иначе m=m+1 и goto 2)
Для алгоритма FFD-I:
RFFD-I <= U/(U-1) если U<=15
U/(U-1) < RFFD-I < U/(U-2) если U>=16
Получаем, что FFD-I лучше NFD/NFI и NF.
Алгоритм упаковки в контейнеры без разбиения показывает хорошие результаты, но не учитывает параллелизм внутри блоков (исходит из последовательной постановки). Так как алгоритм упаковки в контейнеры с разбиением исходит из идеального распараллеливания на мультикомпьютере – без обменов, то, в условиях необходимости синхронизации в процессе счета подзадачи, он не даёт ответа на вопрос составления итогового расписания, расположения объектов внутри контейнера, а также не учитывает необходимость разбиения объекта на равные части.
4.3 Алгоритмы EVAH
В 2001-ом году на международной конференции по параллельной обработке, организованной IEEE (Институтом Инженеров по Электротехнике и Радиоэлектронике) Джомери и Рупак Бизвас предложили ряд новых алгоритмов для решения задачи балансировки в приложениях гидрогазодинамики [2]. Эти алгоритмы описаны в статье “Task Assignment Heuristics for Distributed CFD Applications”. Этой статьи нет в свободном доступе, но идею алгоритма можно взять в другой статье этих же самых авторов.
В рамках этой работы будем использовать один алгоритм из этой серии, который называется Largest Task First with Minimum Finish Time and Available Communication Costs” (LTF_MFT_ACC, в первую очередь большие задачи с наименьшим временем выполнения и известными затратами на коммуникации). Позже EVAH был интегрирован другими разработчиками в реальных приложениях типа OVERFLOW-D (моделирование подвижных объектов в аэродинамике) и показал весьма неплохой результат.
Ядро алгоритма можно описать следующим образом:
Пусть:
zi – задача i
Xi – время выполнения zi
R(zi) – совокупность всех задач, от которых zi получает данных
D(zi) – совокупность всех задач, которые получают данные от задачи zi
C – время коммуникации
T(pi) – суммарное время выполнения задач на процессоре pi
1: Отсортируем список задач по весу (времени выполнения) в убывающем порядке
2: В начале время выполнения задач на каждом процессоре = 0 (процессоры свободные)
3: Для каждой отсортированной задачи zi выполнять:
3.1: Распределить задачу на процессор pj, у которого загрузка T(pj) наименьшая. Пересчитать T(pj) = T(pj) + Xi
3.2: Для каждой задачи zr в R(zi), назначенной на процессор pk != pj выполнить
T(pj) = T(pj) + Cir
Если задача zr (которая уже распределена на другой процессор) получает данные от задачи zi то надо добавить в T(pj) время коммуникации между zi и zr */
3.3: Для каждой задачи zd в D(zi), назначенной на процессор pm != pj выполнить
T(pm) = T(pm) + Cdi
Если задача zi получает данные от zd (которая уже распределена на процессор pm) то надо добавить в T(pm) время коммуникации */
4: Конец цикла
Для иллюстрации работы алгоритма рассмотрим следующий пример (рисунок 3).
Имеем четыре пересекающиеся сетки (блоки) zi (i=0..3). Надо распределить блоки по двум процессорам p0 и p1 так, чтобы минимизировать время выполнения.
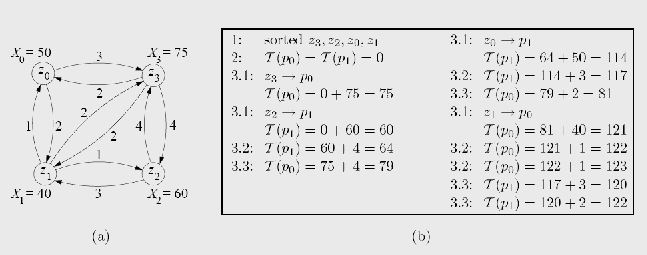
Рисунок 3. Иллюстрация работы алгоритма EVAH
Шаг 1. Четыре блока отсортированы в убывающем порядке по времени выполнения (Xi), получаем: z3, z2, z0, z1
Шаг 2. В начале суммарное время выполнения на процессорах равно 0, T(p0) = T(p1) = 0
Шаг 3. Самый большой блок z3 назначен на процессор p0. Получаем T (po) = 75 в шаге 3.1. Так как никакие другие блоки не были еще назначены на процессоры, пропустим шаги 3.2 и 3.3 для z3.
Повторяем шаг 3 для задачи z2. По предложенному алгоритму z2 должна быть назначена на процессор, где нагрузка наименьшая и поэтому z2 назначена на процессор p1. Получаем T(p1) = 60 в шаге 3.1. На шаге 3.2 очевидно, что z3 получает от z2 данные и поэтому T(p1) = 60 + 4 = 64. На шаге 3.3 наоборот, z2 получает данные от z3 и поэтому T(p0) = 75 + 4 = 79.
Аналогично повторяем шаг 3 для распределения задач z0 и z1.
В результате распределения T(p0)=123, T(p1)=122. Значит, время параллельного выполнения будет 123 а время последовательного 225 (сумма всех Xi без затрат времени на коммуникации)
Заметим, что алгоритм EVAH имеет большое преимущество перед традиционными алгоритмами на неориентированных графах именно в силу возможной обработки ориентированного графа. Для многоблочных задач объем коммуникации между соседними блоками не всегда симметричный.
Алгоритм EVAH учитывает время на коммуникации, но не пытается распределить блоки на несколько процессоров, используя параллелизм внутри блока.
5 Исследование и построение решения задачи
5.1 Первоначальные предложения по отображению
Попытаемся свести нашу задачу отображения многоблочных задач на процессоры к задаче упаковки в контейнеры с дроблением грузов первого типа – дроблением с увеличением груза (накладными расходами).
Первый вариант:
Квантуем время на достаточно малые равные промежутки dt. Будем считать, что каждый контейнер имеет вместимость N (количество процессоров в вычислительной системе), а количество заполненных контейнеров обозначает время счета совокупности подзадач (если заполнено T контейнеров, то совокупное время счета распределенных на вычислительную систему подзадач будет T*dt). Будем считать, что каждый груз уже раздроблен на части весом Kmax (максимальное возможное количество процессоров для счета подзадачи, для каждого груза этот показатель свой). При дроблении количество частей в зависимости от веса каждой части будем получать по формуле [Time(K)/dt]+1, где Time(K) – время счета подзадачи на K процессорах.
Остается лишь ввести следующие ограничения:
При дроблении груза веса частей всегда равны между собой
В контейнере не может быть более одной части одного груза
После появления части i-го груза в контейнере если i-ый груз не полностью выложен в контейнеры, то в следующем контейнере обязана появится часть i-го груза.
Этот вариант плох тем, что имеет отрицательную динамику роста общего веса груза при его дроблении – то есть полное время выполнения (равное времени выполнения, умноженному на количество задействованных процессоров) подзадачи уменьшается с увеличением количества частей, на которые разбивается соответствующий ей груз. Считаю, что данная отрицательная динамика не позволяет полностью свести нашу задачу к задаче упаковки в контейнеры с дроблением первого типа, а также делает известные методики упаковки неприменимыми.
Второй вариант:
Считаем, что каждый контейнер обозначает процессор. Груз – подзадачу. Будем считать, что каждый груз уже раздроблен на Kmin (минимальное возможное количество процессоров для подзадачи) частей (для каждого груза этот показатель свой). При дроблении вес частей в зависимости от количества будем получать по формуле Time(K), где K – количество частей, на которые раздроблен груз, а Time(K) – время выполнения подзадачи с использованием K процессоров. Далее для получения ответа будем варьировать вместимости контейнеров в поиске минимальной возможной вместимости для размещения всех грузов в данных N контейнерах.
Здесь также вводятся дополнительные ограничения:
При дроблении веса частей всегда равные
В контейнере не может быть более одной части одного груза
А также ограничение, которое заметно сложнее выполнить:
После полной упаковки учитывая ограничения 1 и 2, должна существовать расстановка частей грузов в каждом контейнере (возможно, с добавлением в контейнеры фиктивных грузов для занятия места) такая, что все части одного груза имели бы равные начальные времена (начальное время для части груза в контейнере с упорядоченными частями грузов есть суммарный вес всех частей грузов с номерами меньшими данного). При этом возможно переполнение контейнеров и данное распределение считается неудовлетворяющим ограничению 3.
Второй вариант кажется предпочтительнее своей естественностью, однако поддержание ограничения 3 создает сильное препятствие для работы алгоритма отображения.
5.2 Эволюция предложений по отображению
Рассмотрим сначала второй вариант из подраздела 5.1
Выше изложенный принцип на данный момент не был использован для отображения с учетом параллелизма, однако был использован для отображения без учета параллелизма внутри подзадач. Был реализован и отлажен алгоритм, основанный на данном принципе и названный «Жадное Отображение», принято решение использовать жадную стратегию заполнения контейнеров – такую, при которой следующий груз-кандидат попадает в самый незаполненный контейнер.
Описание алгоритма:
Сортируем задачи по сложности в невозрастающем порядке
Помечаем все, как нераспределенные
Находим самую сложную нераспределенную задачу t
Находим самый незанятый процессор (с самым ранним финишным временем) p
Ставим задачу t на процессор p и помечаем ее, как распределенную
Если есть нераспределенные задачи, то переходим к пункту 3
Алгоритмическая сложность реализованного алгоритма есть O(N*logN + N*M), где N – количество подзадач, а M – количество процессоров.
По этому алгоритму были получены приемлемые отображения модельных и реальных многоблочных задач.
Главная проблема данного подхода в том, что его сложно применить в условиях разрешенного параллелизма внутри подзадачи, поэтому данный подход не был развит.
Теперь рассмотрим первый вариант из подраздела 5.1
Данный ранее изложенный принцип был использован для построения эффективного алгоритма отображения многоблочной задачи с учетом параллелизма ее независимых подзадач на процессоры – алгоритма под названием «Транспонированное Отображение». Была использована «непрерывная» модель при стремлении dt к нулю. Таким образом, уже нет контейнеров, а есть некая неограниченная полоса, поделенная на M (количество процессоров) полос вдоль. Был реализован и отлажен алгоритм, основанный на данной модели, принято решение использовать жадно-переборную стратегию.
Опишем основные принципы работы алгоритма и свойства отображения, поддерживаемые им в процессе работы.
Сначала введем несколько определений:
Интегральное время подзадачи на заданном количестве процессоров есть Time(K) * K, где Time(K) – время счета подзадачи на количестве процессоров K.
Минимальное интегральное время подзадачи есть Time(Kmin) * Kmin (здесь работает предположение невозрастающей эффективности распараллеливания)
Первый основной принцип – отображение подзадач в порядке невозрастания их минимального интегрального времени – жадная стратегия. Смысл этого принципа в том, чтобы сначала отобразить наиболее крупные подзадачи, а затем «заткнуть» свободные места задачами поменьше.
Второй основной принцип – для каждой подзадачи перебор ее возможных расположений – переборная стратегия. Была выбрана именно переборная стратегия, ибо чисто жадная стратегия давала слишком неэффективные отображения. Этот принцип позволяет более полно рассмотреть варианты отображения каждой конкретной подзадачи.
Третий основной принцип – отсечение перебора:
Если текущее промежуточное отображение позволяет отобразить рассматриваемую в данный момент подзадачу на k процессоров, дав ей стартовое время x, то алгоритм не будет исследовать возможность ее отображения на k процессоров с более поздним стартовым временем y, большим x.
Пусть tMax – максимальное по всем процессорам время освобождения процессора (по сути – промежуточный вариант итогового времени). Вариант расположения следующей рассматриваемой подзадачи назовём хорошим, если для него curStartTime + curTime <= tMax, где curStartTime – допустимое стартовое время для рассматриваемой подзадачи на k процессоров, а curTime – время ее исполнения на некотором рассматриваемом количестве процессоров k.
Если для подзадачи есть хорошее расположение, то выбираем в качестве результата хорошее расположение с минимальным стартовым временем, а среди хороших расположений с минимальным стартовым временем – хорошее расположение с минимальным количеством используемых процессоров.
Если хороших расположений нет, то выбираем то (предпочтение более раннему стартовому времени, а среди расположений с равным стартовым временем – расположению с меньшим количеством используемых процессоров), которое минимизирует выражение max((curStartTime + curTime) * M, tOccupied + curTime * k + tRestMin), где tOccupied – уже занятое отображенными подзадачами интегральное время, k – допустимое количество процессоров для рассматриваемой подзадачи, tRestMin – сумма минимальных интегральных времен еще не отображенных подзадач (не включая рассматриваемую в данный момент подзадачу)
Также стоит отметить, что данный алгоритм транспонированного отображения при запрете параллелизма подзадач переходит в описанный выше алгоритм жадного отображения, основанный на втором варианте модели.
6 Описание практической части
Практическая реализация служит для предоставления программистам Fortran-DVM и C-DVM возможности эффективно исполнять многоблочные задачи. Представляет собой статическую библиотеку, предоставляющую вызовы для генерации отображения, а также исполняемый файл для генерации отображения в диалоговом режиме.
6.1 Обоснование выбранного инструментария
Для реализации был выбран стандартный Си++ с использованием компилятора GCC [7], ибо важна была кроссплатформенность, так как библиотека встраивается в систему поддержки времени исполнения LibDVM, и должна работать в том числе под управлением ОС семейства GNU/Linux.
6.2 Общая архитектура разработанного средства
Разработанное программное средство представляет собой набор из исходных текстов на языке Си++, shell-скрипт для сборки библиотеки и исполняемого файла, примеры входных файлов с описаниями блоков для работы в диалоговом режиме. Общий объём исходных текстов составляет 1086 строк, из них 1034 – Си++ код, а 52 – shell-скрипт. Архитектура программного средства такова, что допускает простое добавление другого алгоритма отображения и предоставляет удобные интерфейсы для построения отображения, а также механизм самопроверки корректности построенного отображения. Оно позволяет гибко менять характеристики каждой подзадачи, такие как минимально-допустимое количество процессоров, необходимое для запуска подзадачи, равно как и максимально-допустимое количество процессоров, на котором подзадача может выполняться, а также время (в условных единицах), необходимое для завершения подзадачи.
Ниже, на рисунке 4 приведена диаграмма классов, иллюстрирующая архитектуру приложения, где «Жадное Отображение» и «Транспонированное Отображение» суть не классы, а отдельные функции, реализующие описанные в предыдущем разделе алгоритмы отображения. Также «DVM Адаптер» суть не класс, а отдельная функция для генерации представления, используемого в системе поддержки времени исполнения LibDVM.
Класс «Данные Подзадачи» предназначен для хранения основных характеристик исходной подзадачи, таких как минимальное допустимое количество процессоров, максимальное допустимое количество процессоров, базовый способ вычисления времени на основе использования формулы Амдала, параметризованной значениями времени исполнения последовательной части и времени исполнения параллельной части на одном процессоре. Основным методом в интерфейсе является получение времени исполнения подзадачи в зависимости от количества процессоров, на которых планируется ее запустить.
Класс «Подзадача» предназначен для описания подзадачи с уже назначенным конкретным числом процессоров.
Класс «Квант Загрузки Процессора» предназначен для описания интервала времени на одном из процессоров, занимаемых конкретной подзадачей.
Класс «Загрузка Процессора» предназначен для хранения структуры загрузки одного процессора, в какие времена и на какие длительности какие подзадачи планируется запустить. Также он занимается проверкой корректности построенного отображения в рамках одного процессора.
Класс «Отображение Подзадачи» предназначен для сбора информации о том, на какие процессоры какая задача отображена, ее стартовое время, ее финишное время. Также он занимается проверкой корректности построенного отображения в рамках одной подзадачи – ее стартовые, равно как и финишные, времена на всех процессорах, на которых планируется ее счет, должны совпадать.
Класс «Отображение» предназначен для сбора информации обо всём отображении в целом, вывода результатов, получения агрегированных данных об отображении.
При добавлении нового алгоритма необходимо знание небольшого интерфейса классов «Отображение», «Данные Подзадачи», «Подзадача».
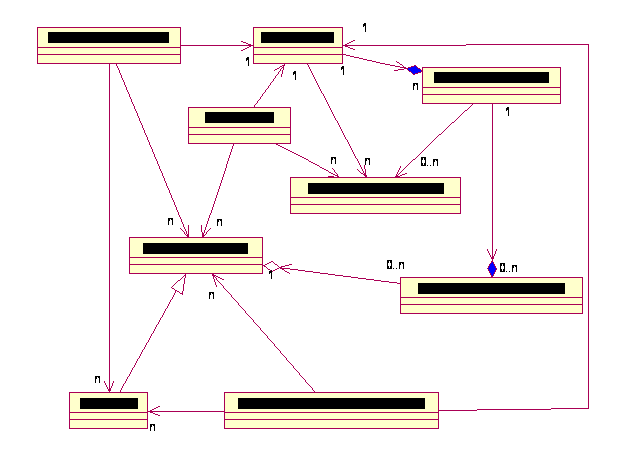
Рисунок 4. Диаграмма классов разработанного средства
6.3 Схема работы средства
Разработанное программное средство предлагается использовать C-DVM и Fortran-DVM программистам вместо ручного отображения [1]. Следует вместо вызова функции ручного отображения сделать следующее:
Завести массив типа int размером на, как минимум, количество блоков (назовем его renum)
Узнать количество процессоров в системе (например, вызовом NP = NUMBER_OF_PROCESSORS( ) )
В зависимости от размерности блоков вставить вызов mproc_adv1_ для одномерных блоков, mproc_adv2_ для двумерных и так далее. Функции вида mproc_adv##n##_ имеют следующий прототип:
int mproc_adv##n##_ (int *low_proc,