Прогнозирование с учетом фактора старения информации
На продолжительность существования полезной для прогноза информации оказывает влияние колебание (изменение) цен на товары и услуги, динамика бюджета потребителя, изменение объема спроса на товар и других в общем случае ограниченного числа факторов.
В связи с этим представляется целесообразным при формировании математической модели старения информации использовать теоретико-вероятностную схему формирования законов распределения микроэкономических показателей как сумм небольшого случайного числа случайных величин.
К первым работам о суммах случайного числа случайных слагаемых относятся работы А.Н. Колмогорова и Ю.В. Прохорова, Вальда, Вольфовица и др. В основном в этих работах представлены результаты, касающиеся моментов для рассматриваемых сумм (теоремы вальдовского типа) и вопросы теории предельных распределений. В ряде работ (В.М. Круглов, Д. Саас и др.) для сумм случайного числа случайных слагаемых доказан ряд теорем, в которых предполагается существование предельных распределений случайного числа случайных слагаемых и при соответствующих дополнительных условиях утверждается существование предельного (в некоторых случаях нормального) распределения для сумм случайного числа случайных слагаемых. Такого рода теоремы в теории предельных распределений для сумм случайного числа случайных величин называются теоремами переноса. Полученные результаты (теоремы вальдовского типа и теоремы переноса) хотя важны для разнообразных применений, но в основном для рассматриваемого вопроса имеют ограниченный интерес.
Решение практических задач анализа и прогнозирования времени существования полезной информации в микроэкономике требует применения методов построения непредельных распределений сумм случайного числа случайных величин, нахождения их квантильных функций и оценки с их помощью предпрогнозного фона.
Основываясь на свойствах характеристической функции
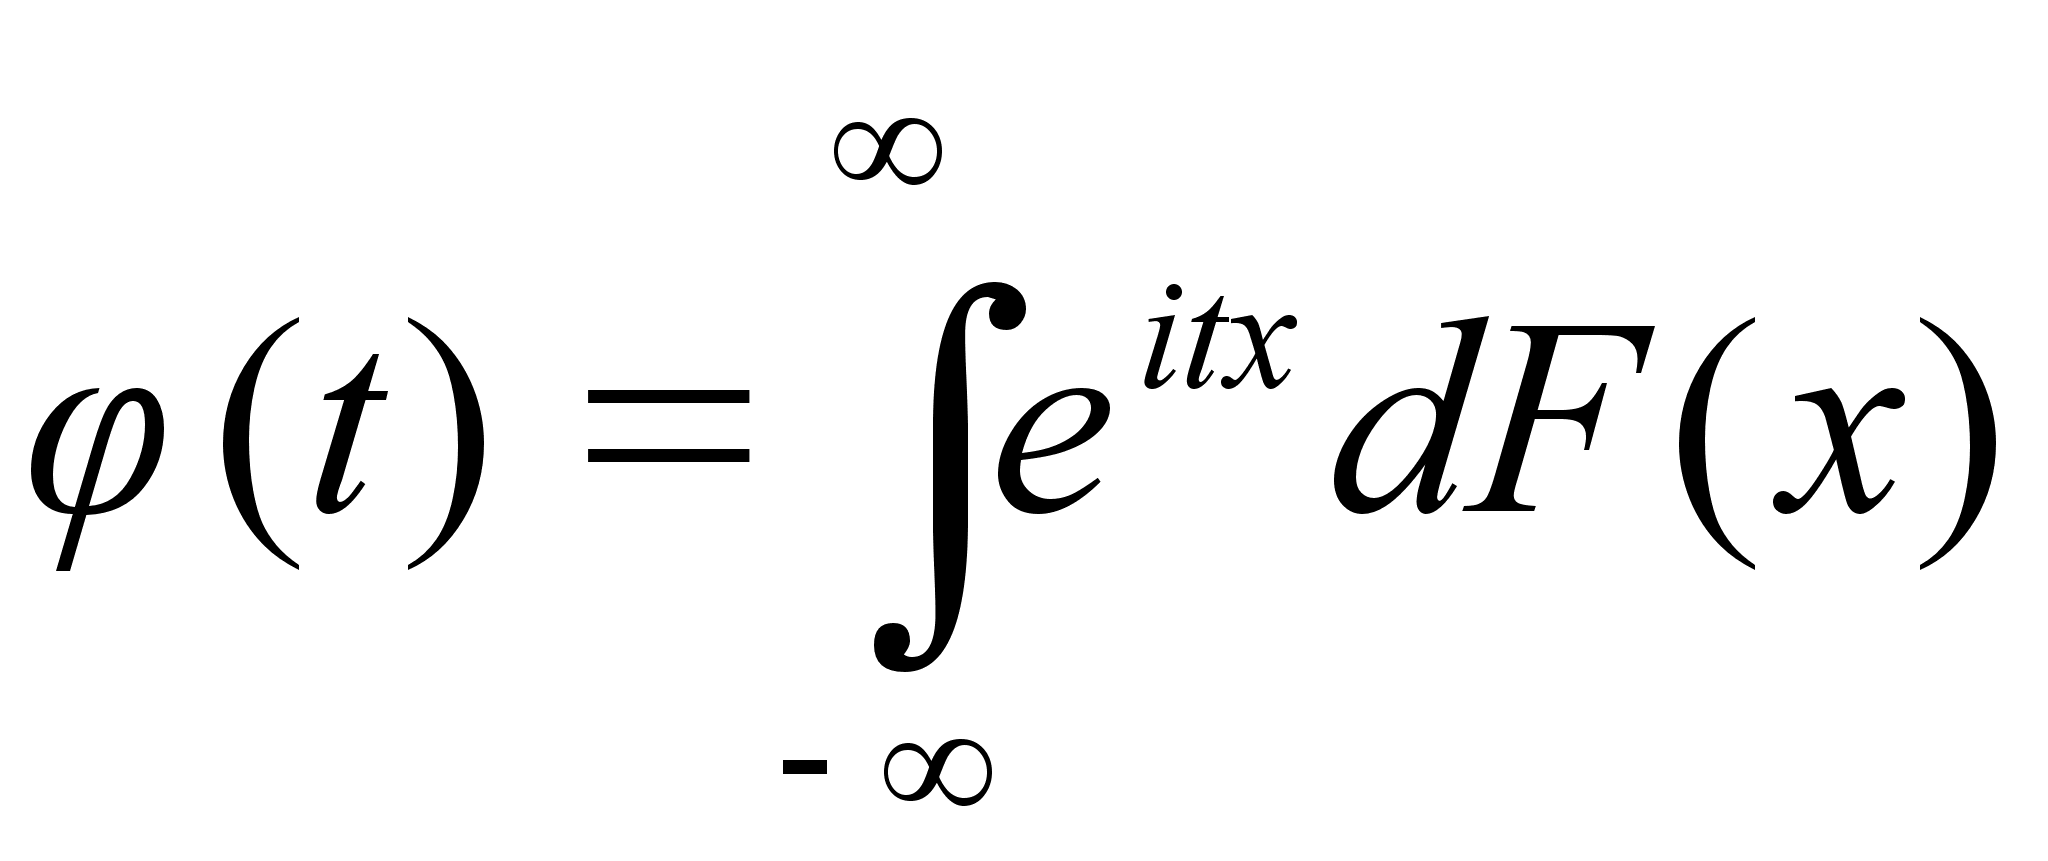 (2.16)
и используя ее основные свойства, приведем некоторые результаты, касающиеся законов распределения для сумм
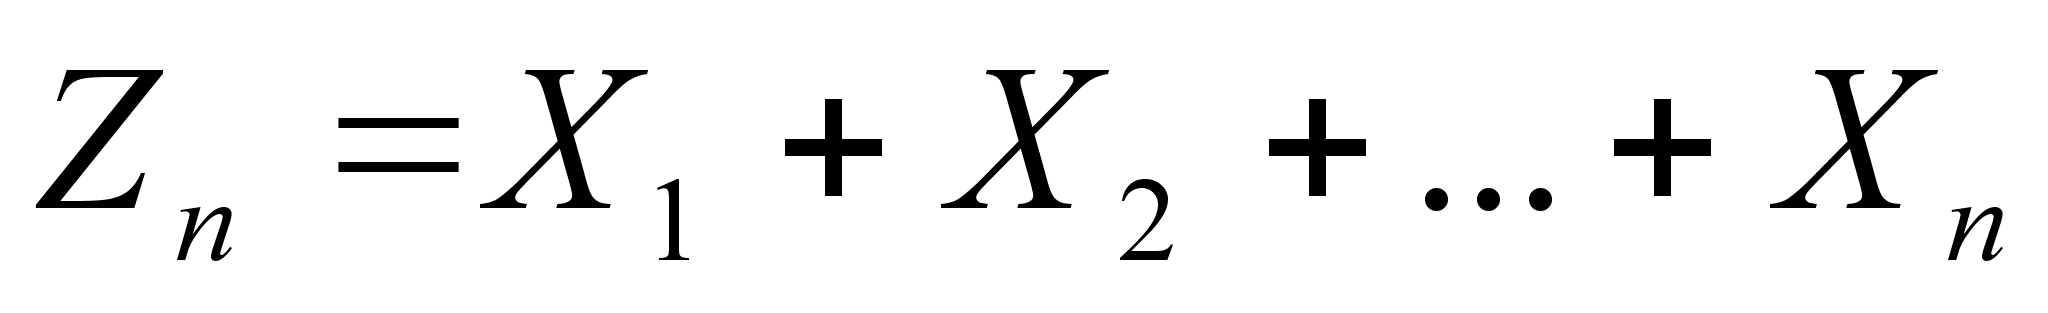
n первых случайных величин из бесконечной последовательности
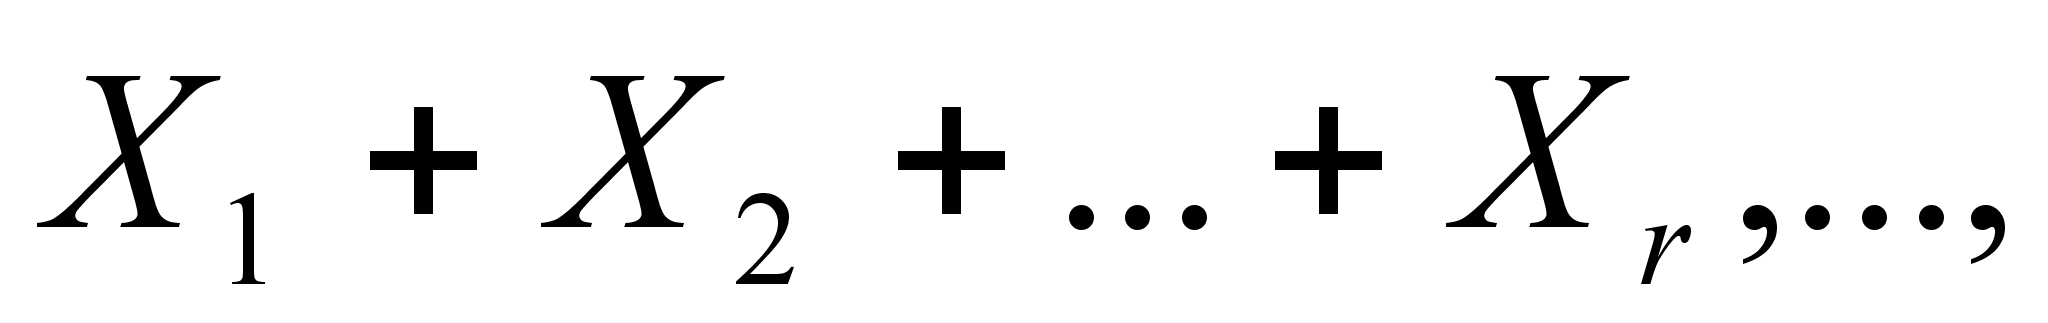
где само число слагаемых n есть случайная величина. В дальнейшем r будем обозначать случайную величину, способную принимать неотрицательные значения в зависимости от схематизации стохастического эксперимента
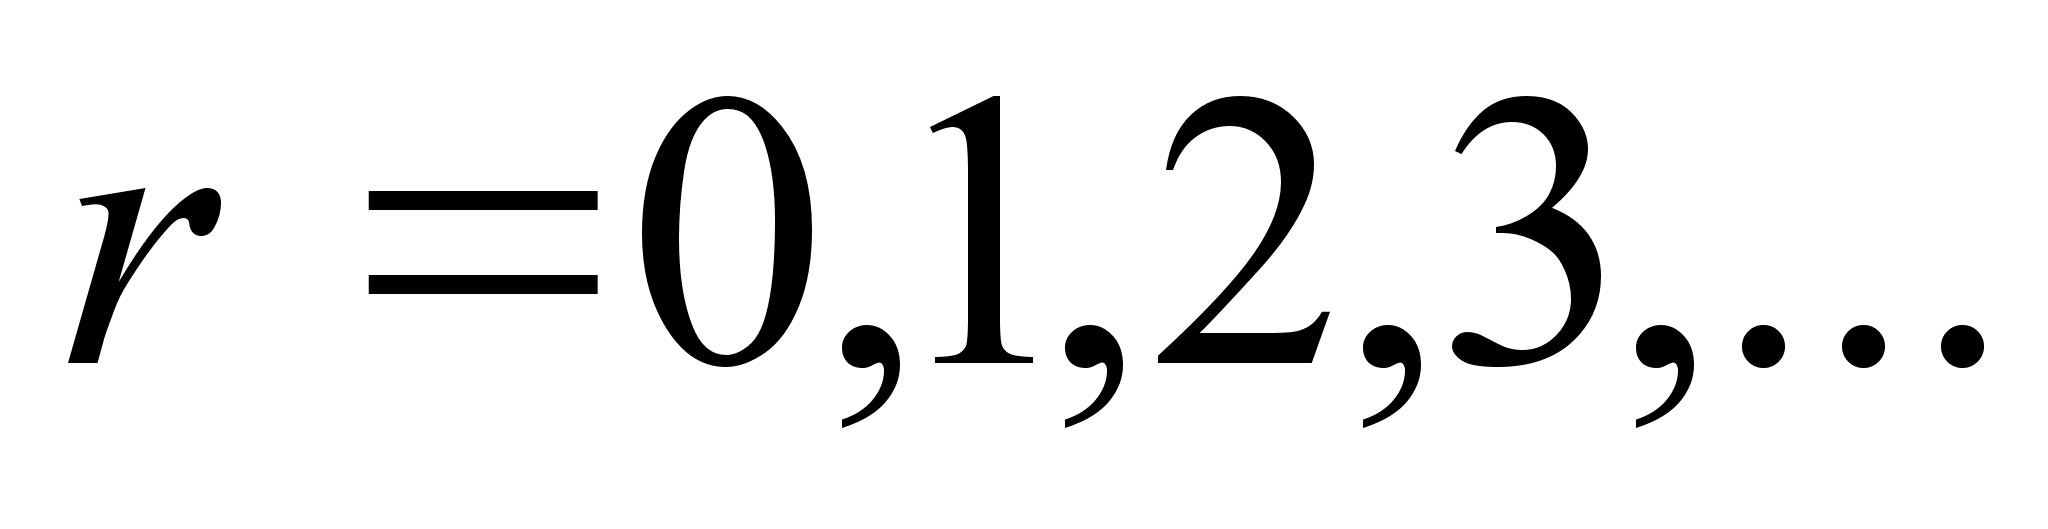
Вероятность
события заключающуюся
в том, что
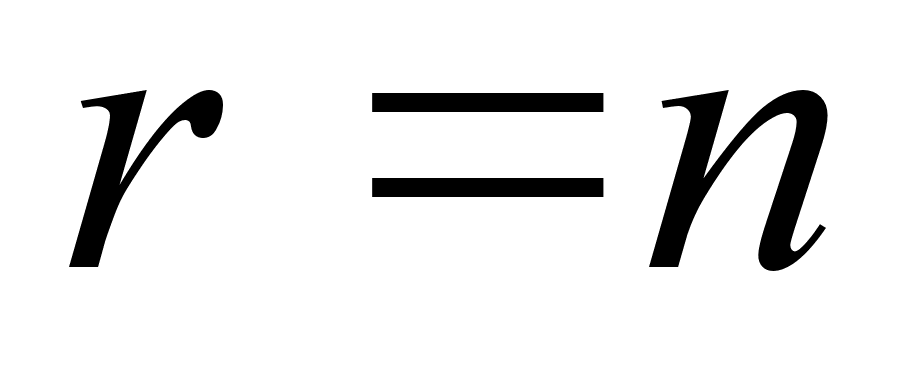 ,
обозначим
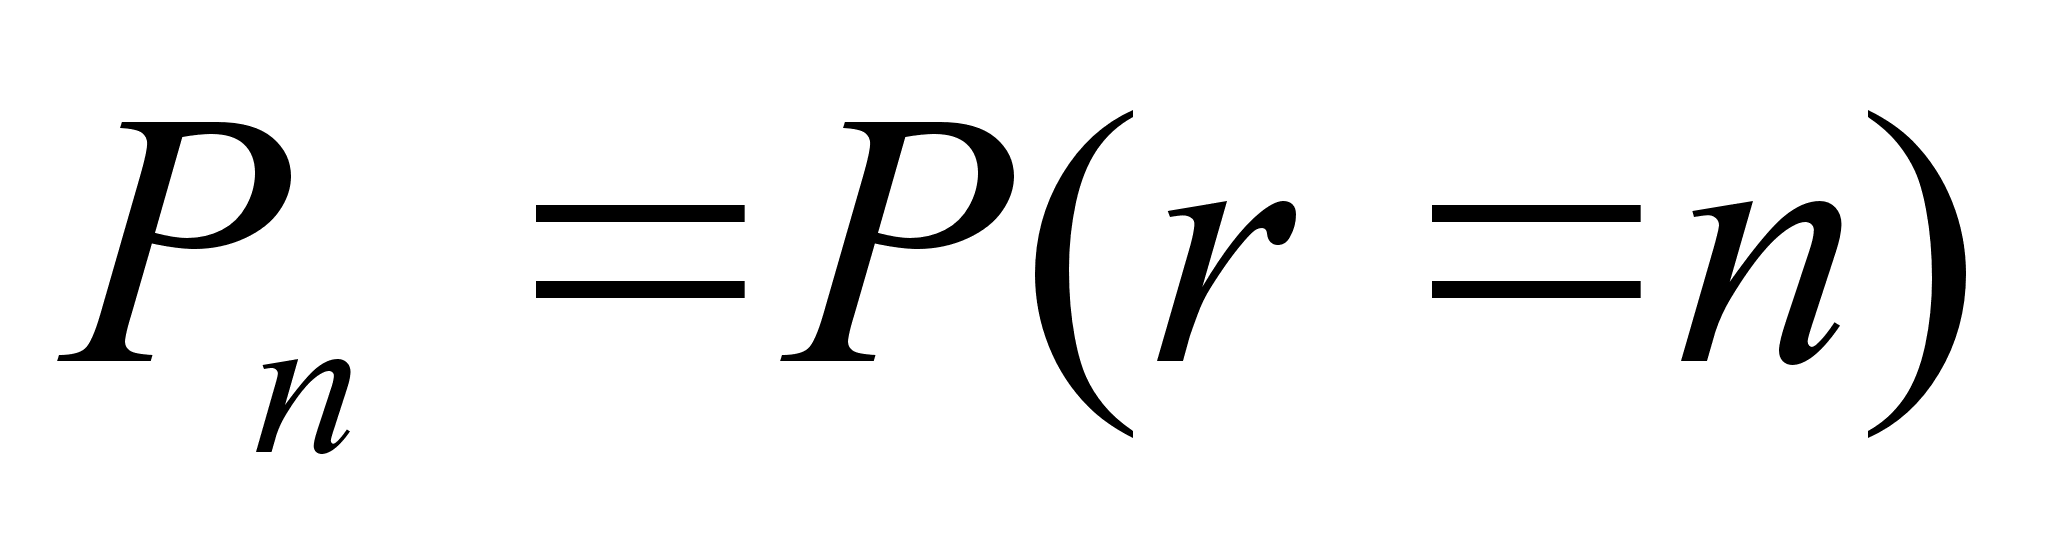
Кроме
того будем
предполагать,
что случайные
величины
независимы,
одинаково
распределены
и независимы
от случайной
величины п.
Будем
также предполагать
существование
математических
ожиданий
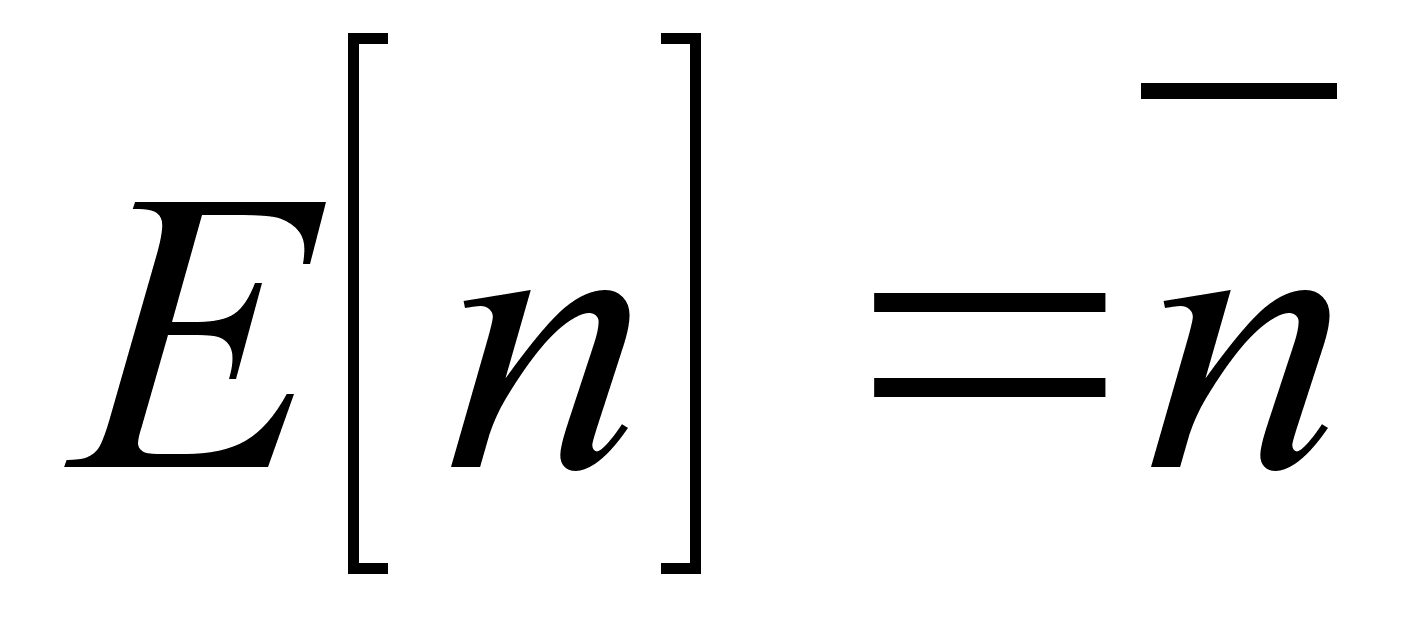 и
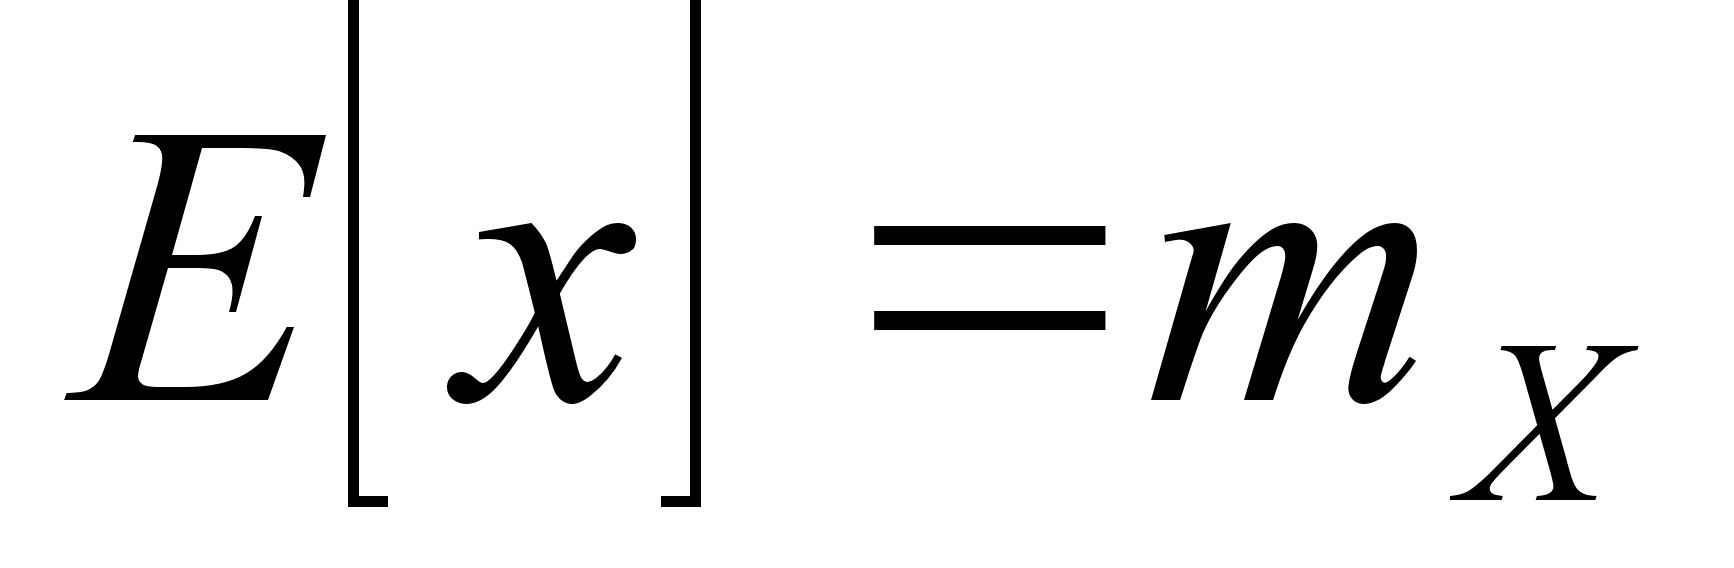 (2.17)
Функция
распределения
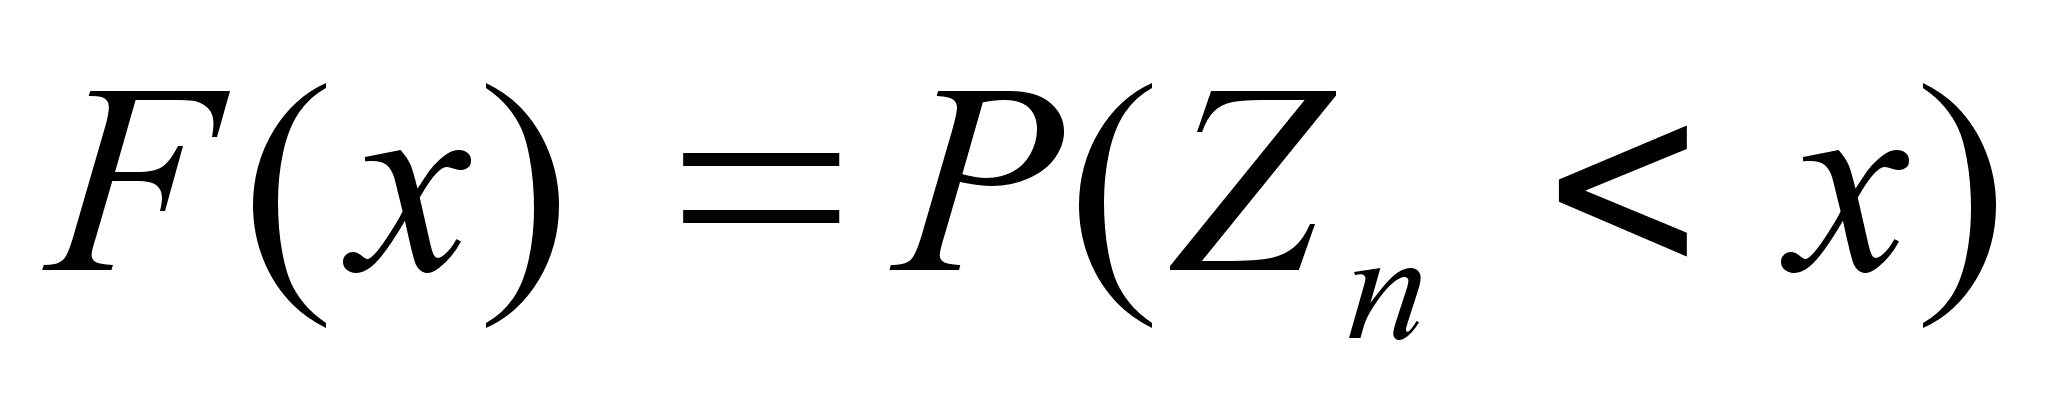 суммы случайного
числа n
случайных
величин Хi,
на
основании
мультипликативного
свойства
характеристической
функции определяется
характеристической
функцией
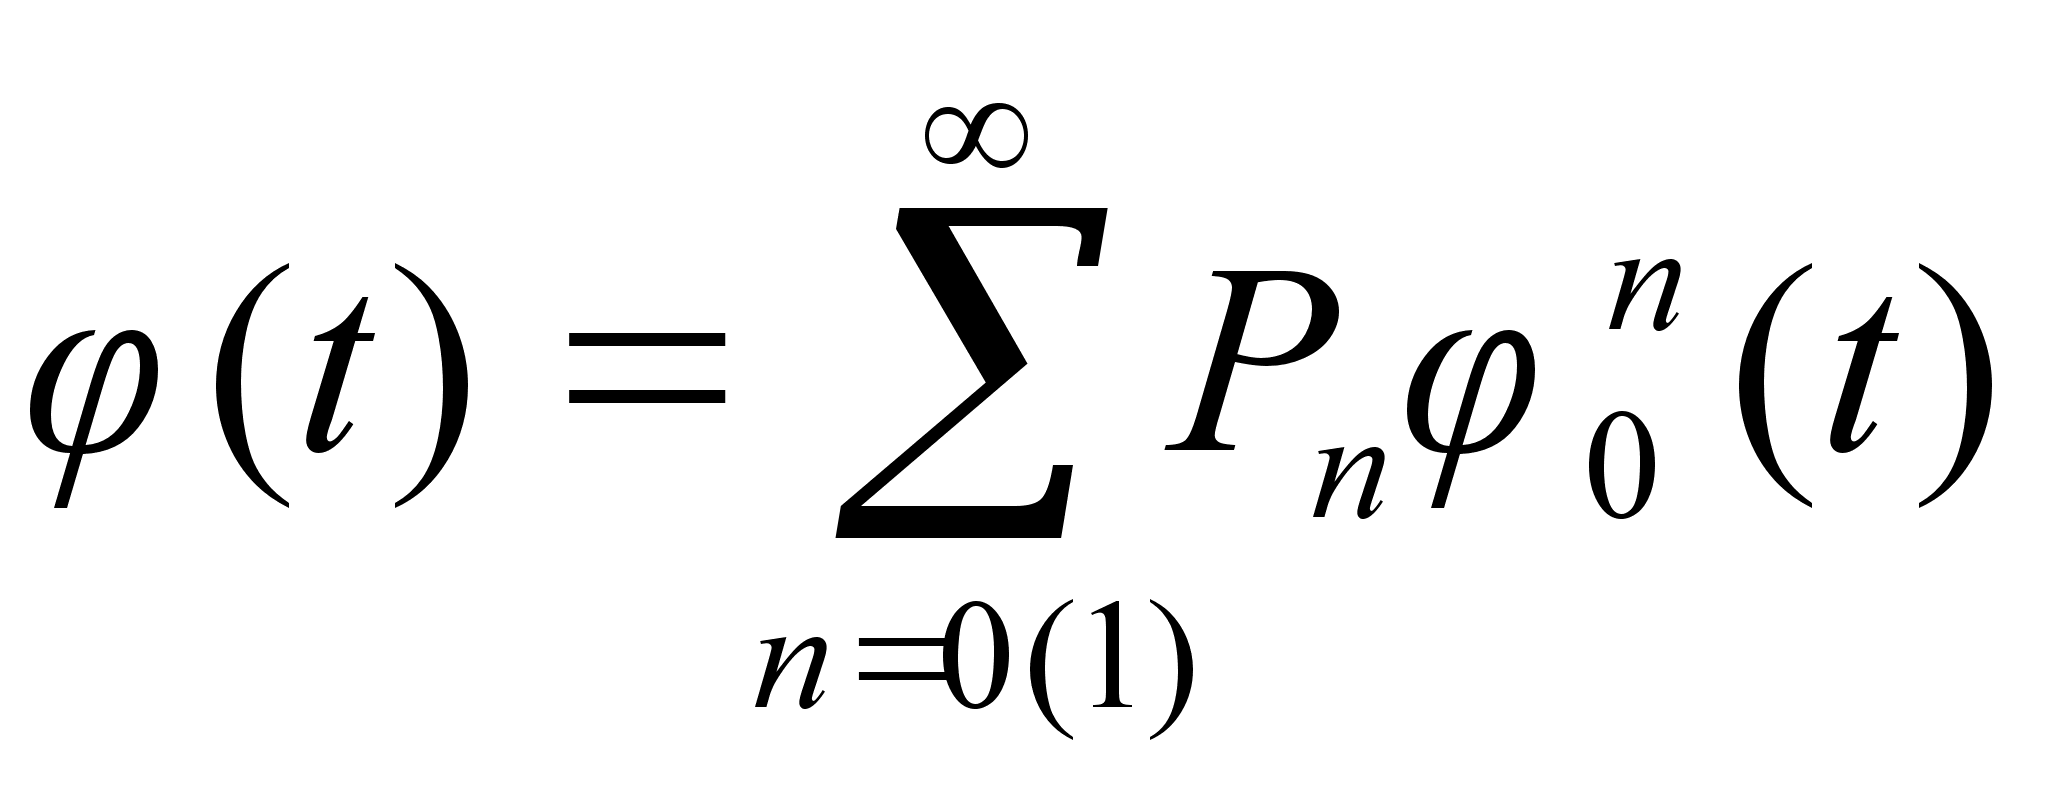 , (2.18)
где
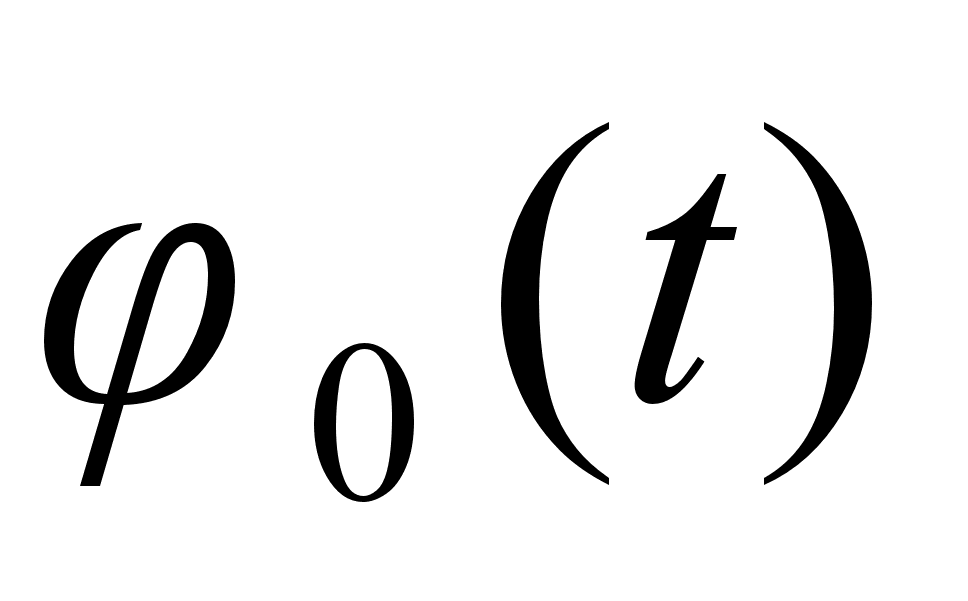 характеристическая
функция случайной
величины Х.
С
помощью формулы
обращения
запишем формулу
для плотности
распределения
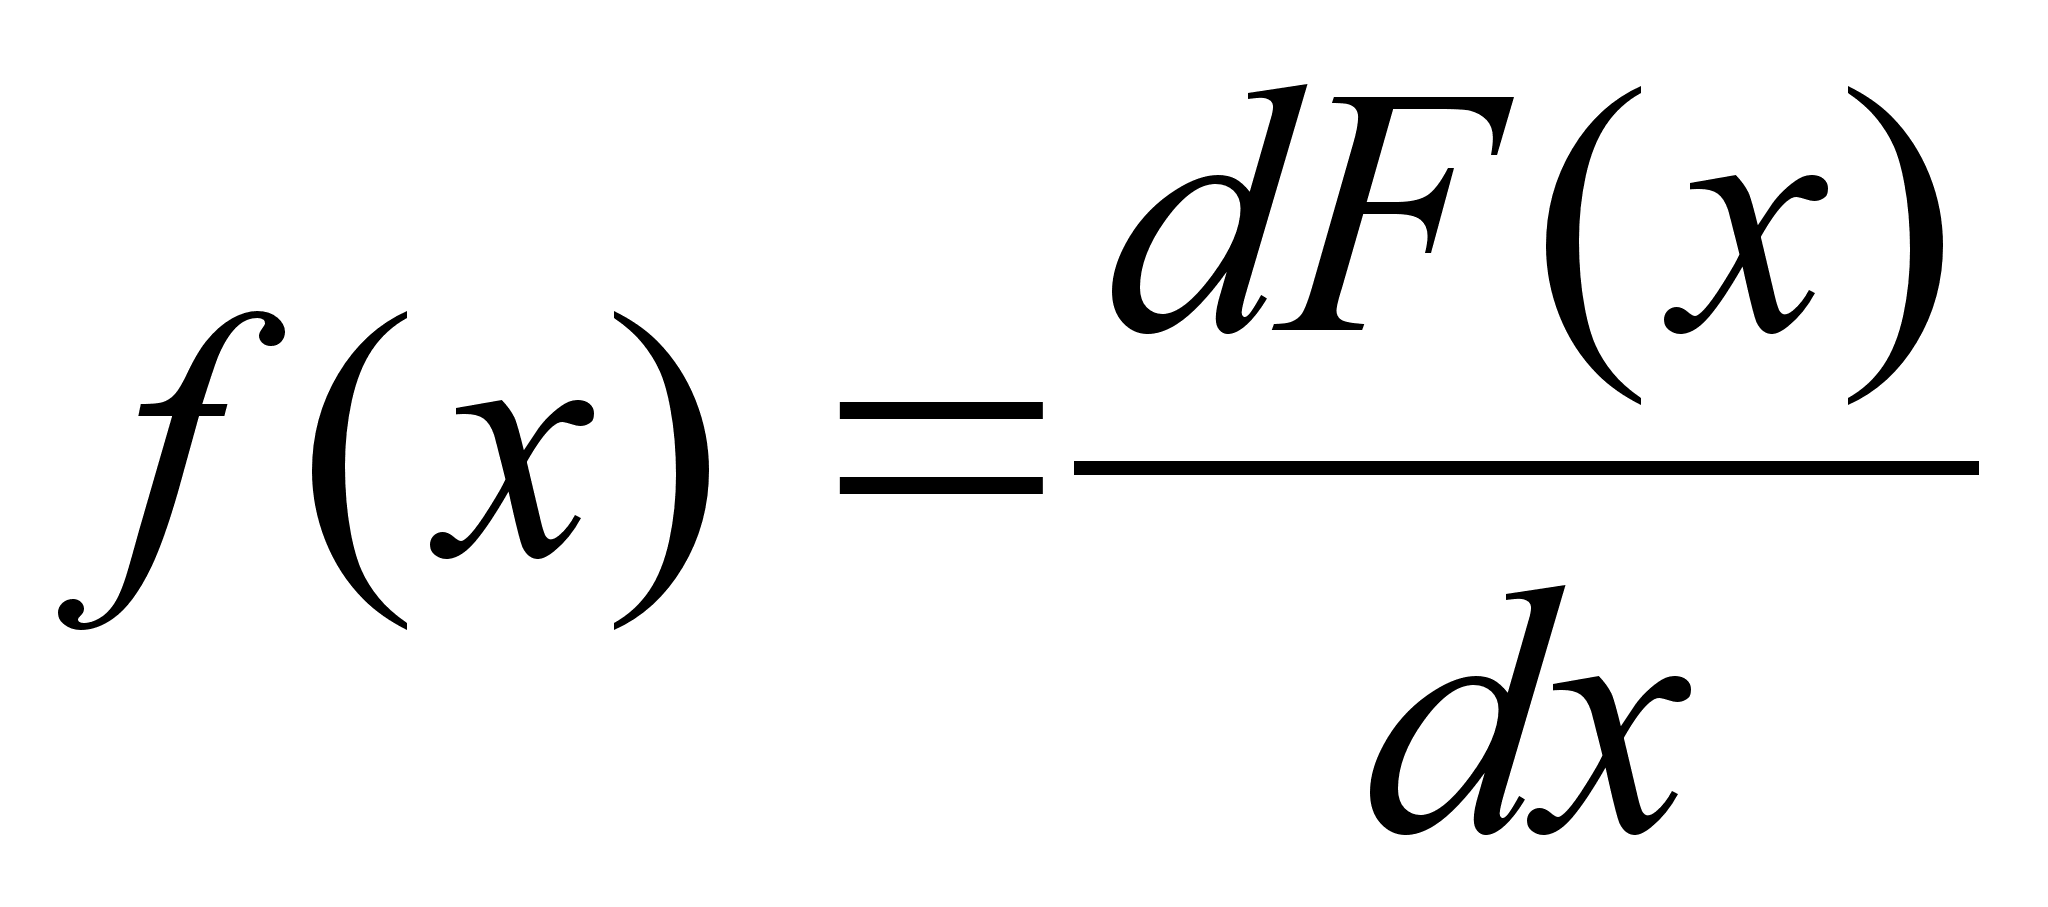
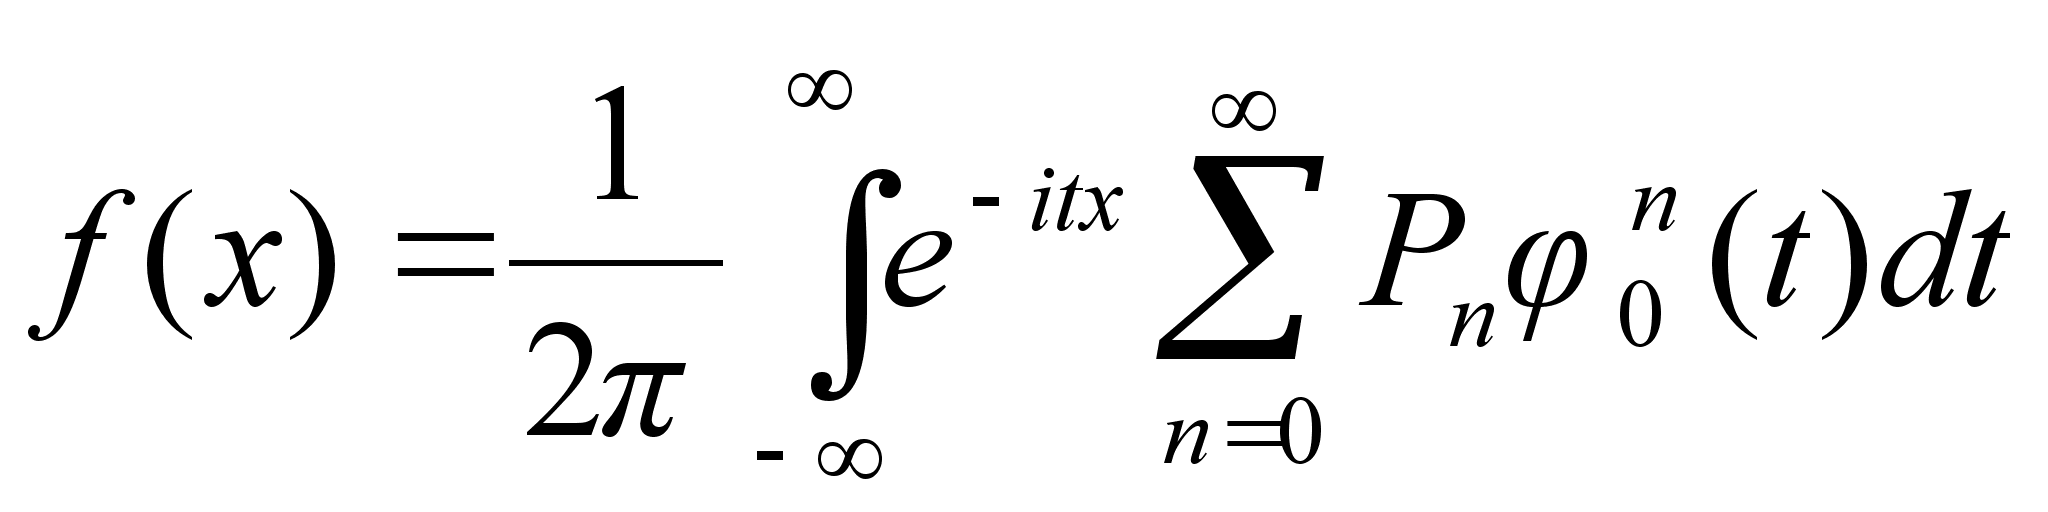 (2.19)
Конечность выражения
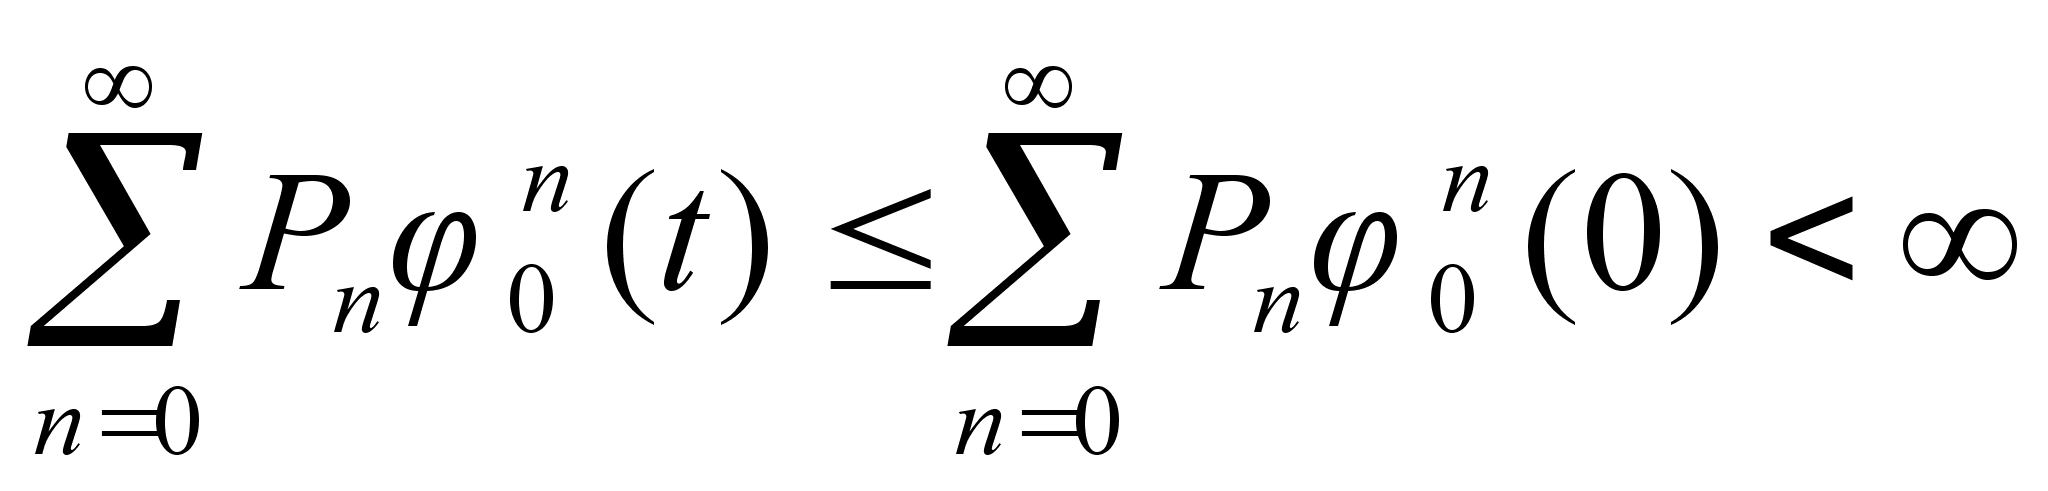
гарантирует замену порядка суммирования и интегрирования, следовательно
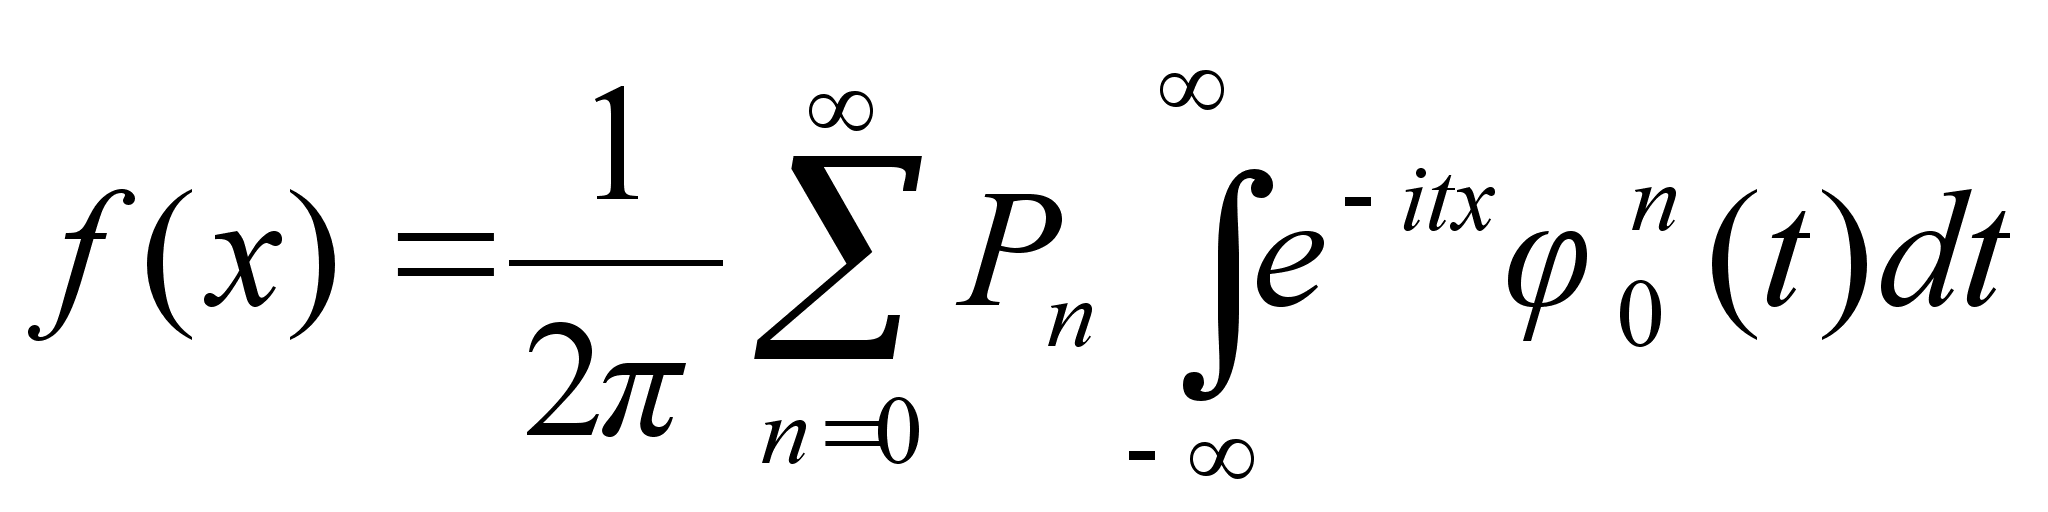 (2.20)
В силу мультипликативности свойства функции (2.16) и теоремы единственности
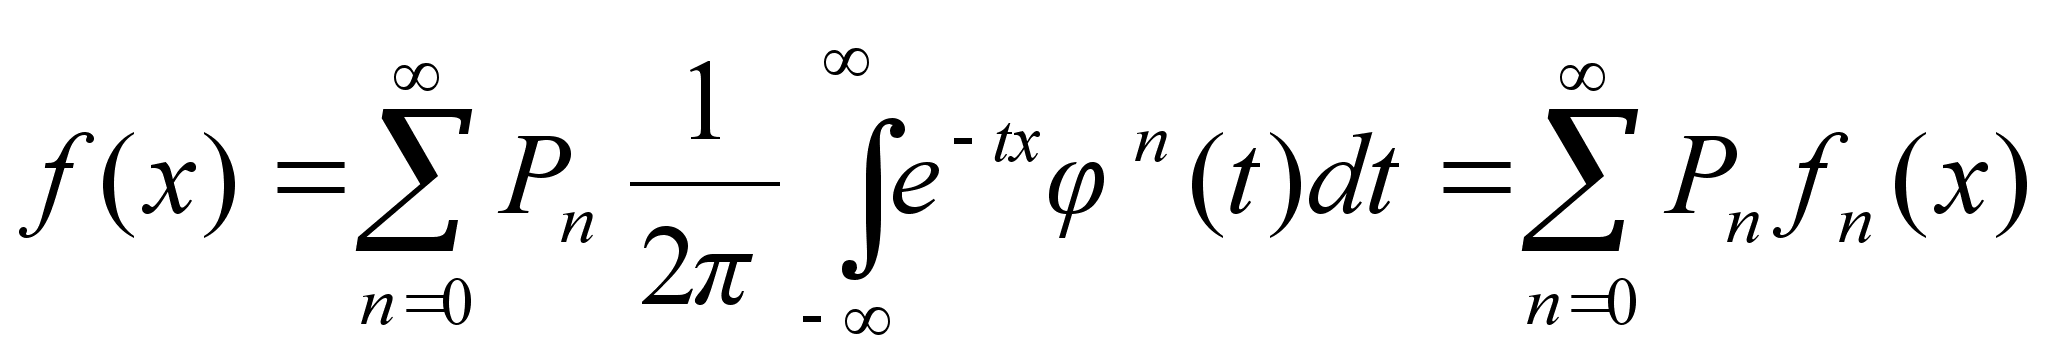 (2.21)
где
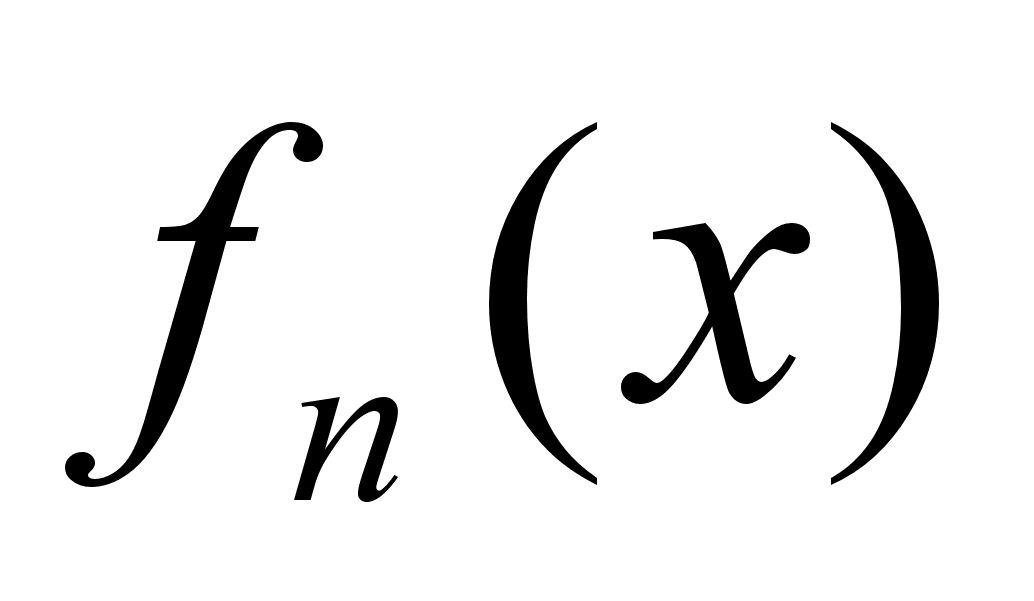 - плотность
распределения
сумм
n случайных
величин Xi/
Таким образом, плотность непредельного распределения случайного числа случайных величин представляет собой смесь распределений с плотностью fn(x) вероятность появления которых в случайной выборке (удельный вес наблюдений в общей генеральной совокупности) равна Рn. Следует заметить, что такого рода комбинации распределений удобны в методологическом плане и могут найти применение в прикладной статистике при анализе генеральных совокупностей, объединяющих в себе несколько подсовокупностей, каждая из которых, в определенном смысле, однородна и описывается основным модельным распределением, например, нормальным, экспоненциальным и т.д. В рассматриваемой проблеме подсовокупности могут описывать статистику промежутков между квантами информации.
В качестве примера рассмотрим распределение суммы пуассоновского числа стандартных нормальных величин.
Характеристическая функция стандартного нормального распределения
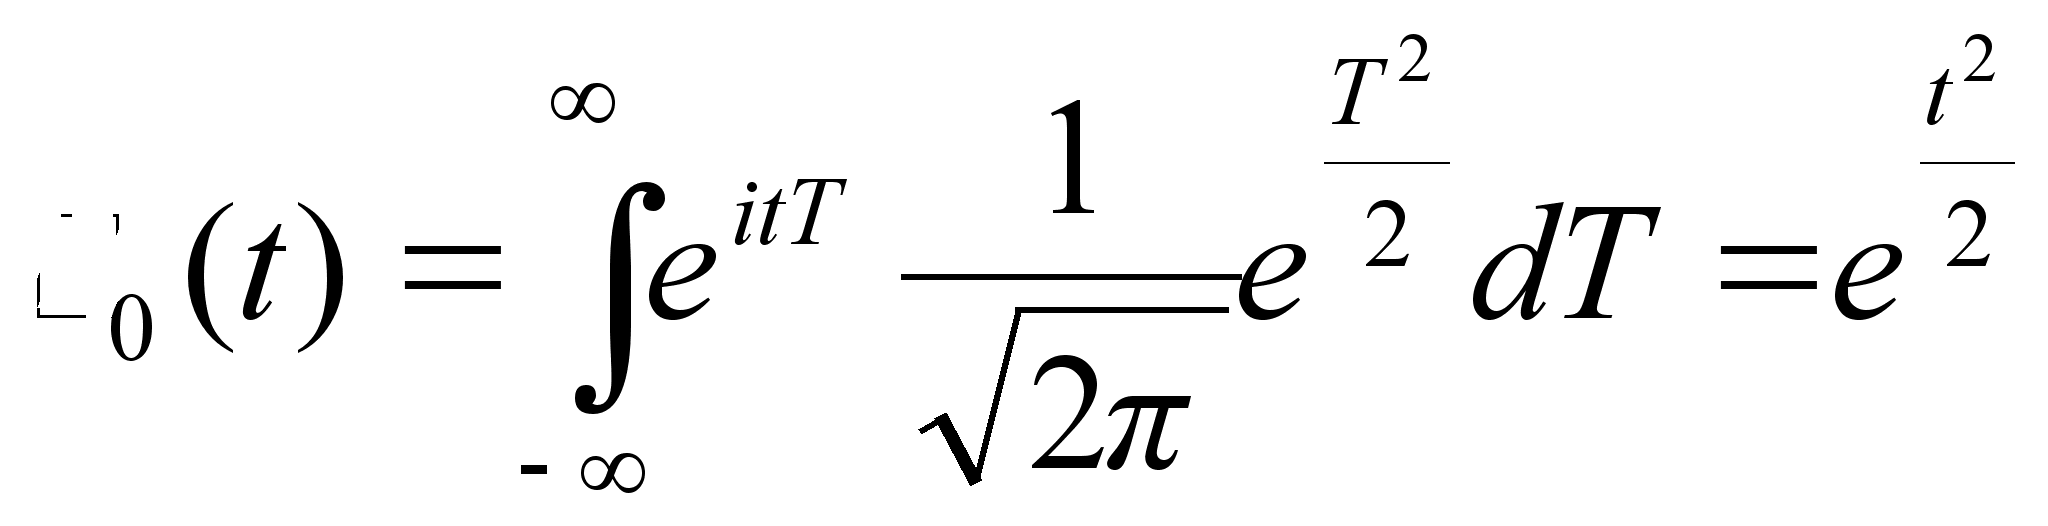 (2.22)
Отсюда характеристическая функция распределения суммы пуассоновского числа стандартных нормальных величин имеет вид
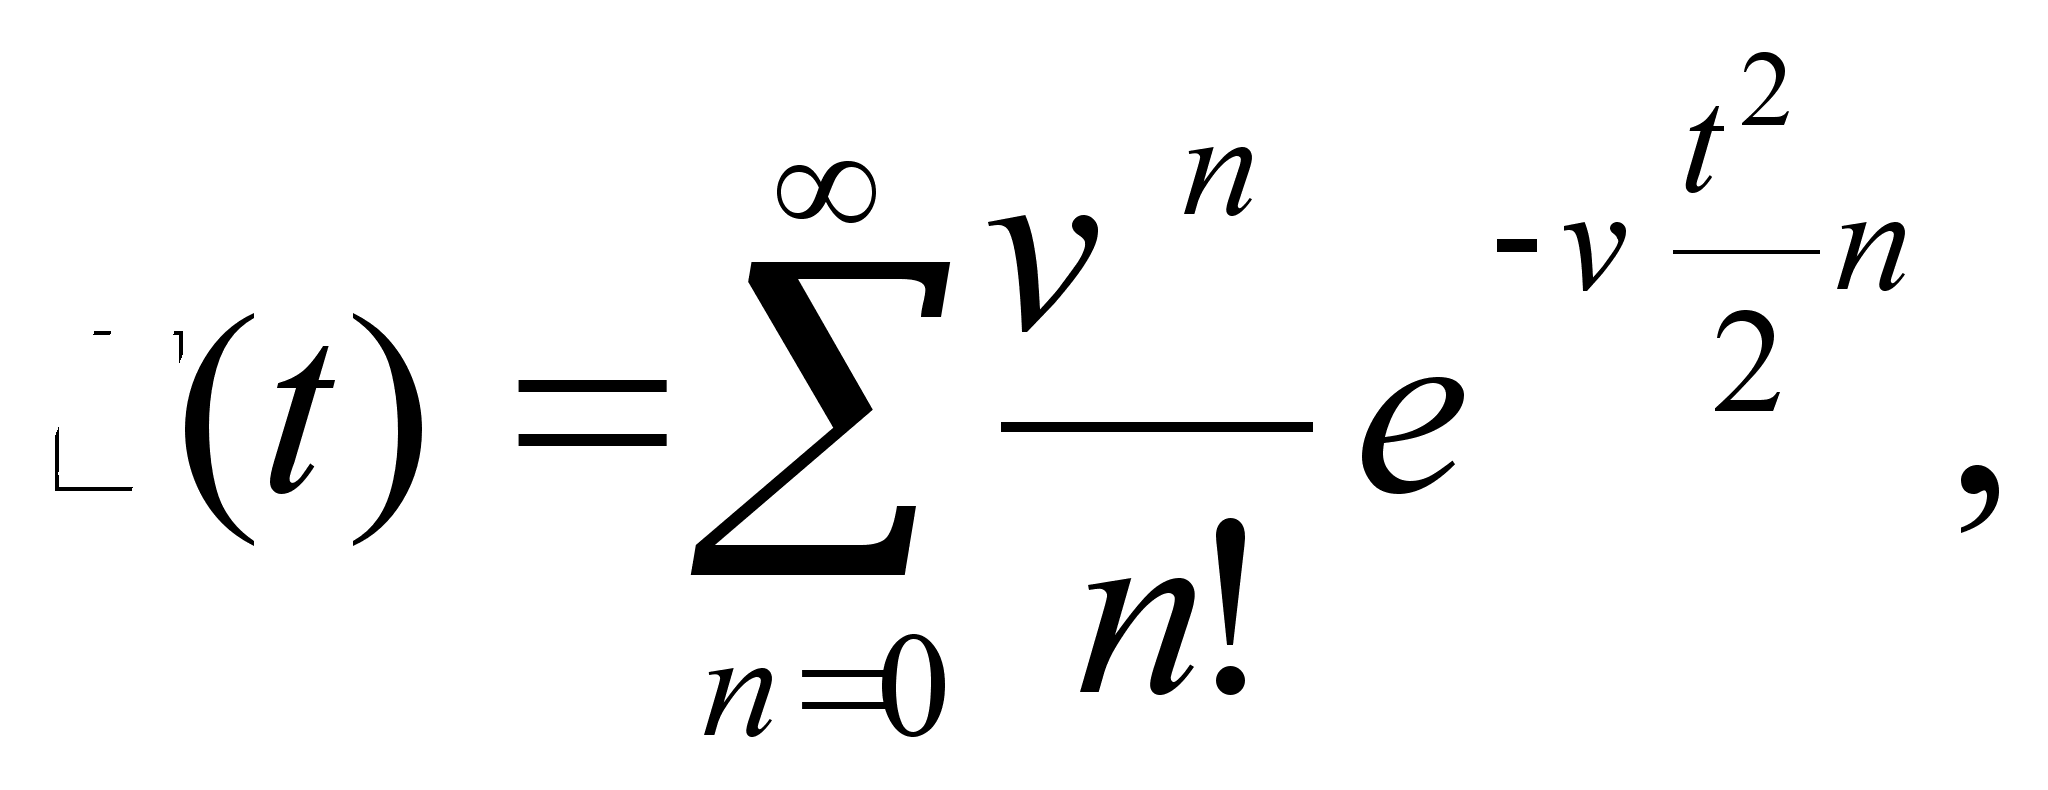 (2.23)
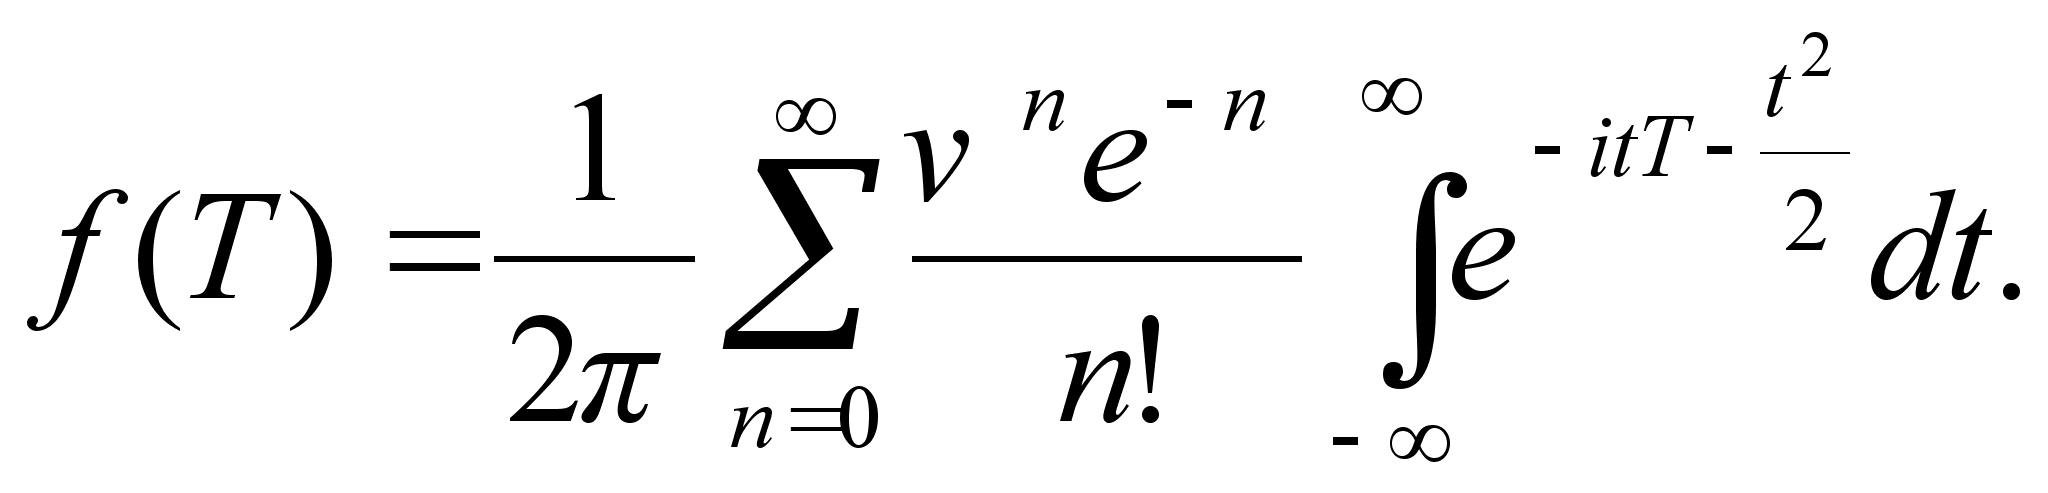 (2.24)
В результате интегрирования получим
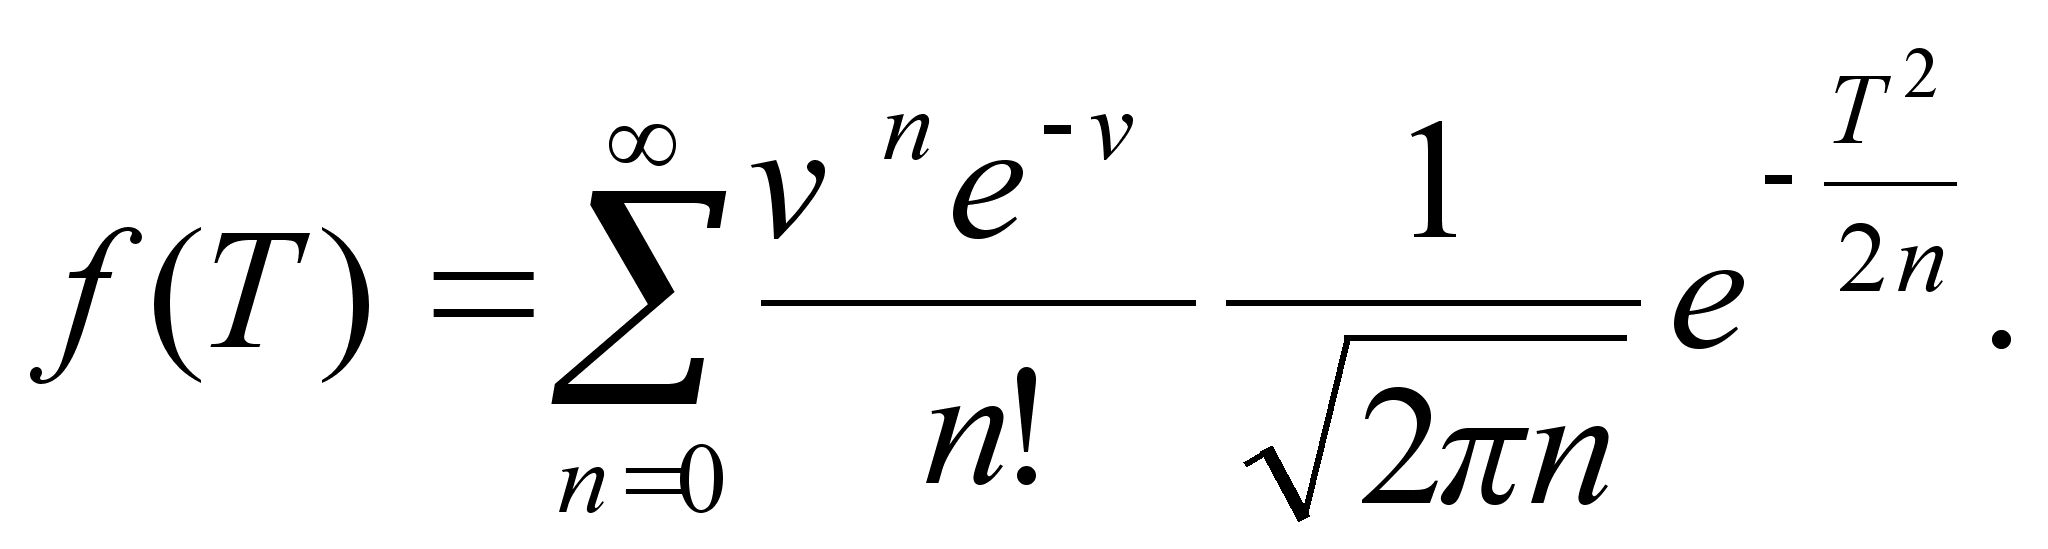 (2.25)
Полученная плотность распределения претерпевает значительную деформацию по сравнению с предельным нормальным распределением. Сумма случайного числа случайных величин, как видно из формулы (2.25), распределена по закону, отличного от нормального, и это отличие тем существенней, чем больше удельный вес имеют вероятности получения малых значений случайных чисел п. Это обстоятельство имеет весьма важное значение для решения вопроса отбраковки устаревшей информации.
К аналогичному выводу можно прийти, рассматривая сумму пуассоновского числа экспоненциально распределенных случайных величин. В этом случае плотность распределения имеет вид
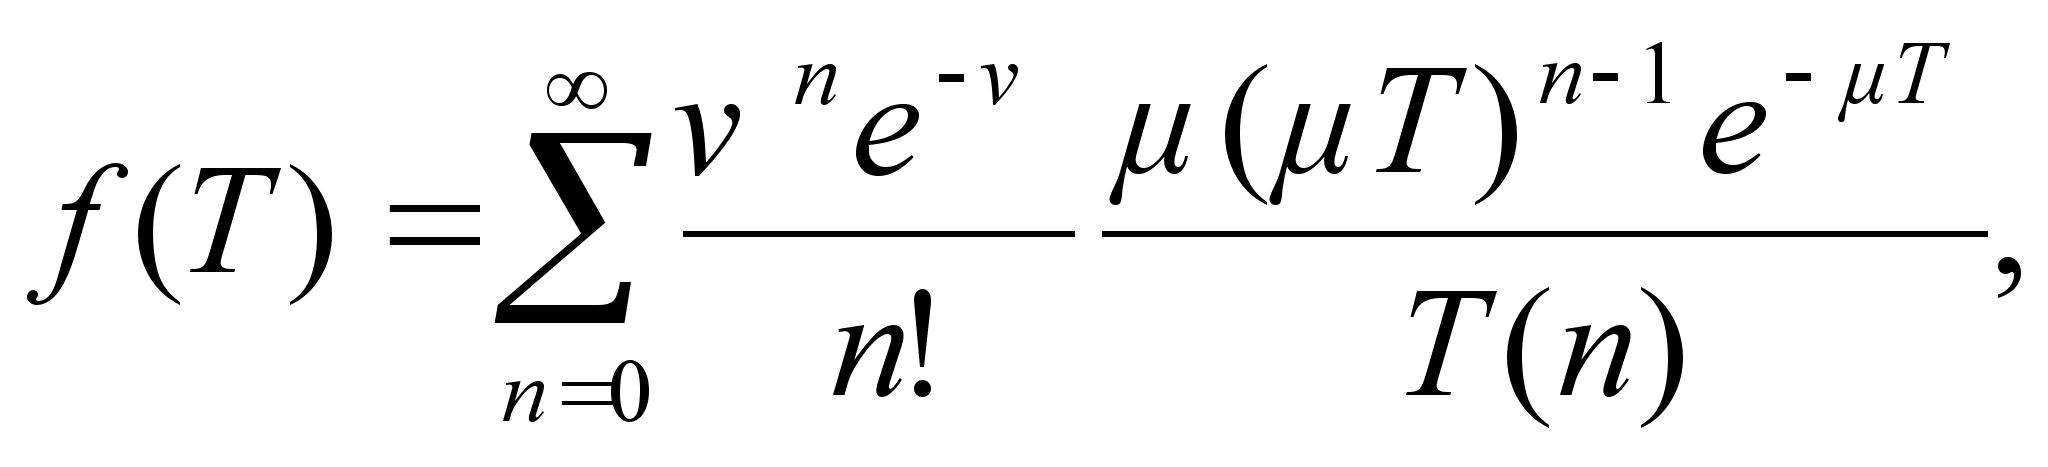 (2.26)
где – величина, обратная среднему значению случайной величины Т.
Таким образом, применение предложенного подхода позволит более объективно выявить статистическую закономерность формирования времени существования полезной информации и решить ряд задач отбраковки устаревших данных при прогнозировании микроэкономических показателей.
4.4. Определение глубины предпрогнозной ретроспекции с учетом старения информации
Наиболее общая постановка задачи сравнения результатов прогнозных расчетов, полученных с использованием различной глубины ретроспекции, заключается в следующем. С целью выявления периода старения информации определяется k значений глубины ретроспекции (Т2, Т3, …, Тk+1). Значение Т1=0 целесообразно принять за контрольную точку, так как вполне очевидно, что в этой точке информация еще не устарела и ее можно считать наиболее ценной и достоверной. В ходе прогнозных исследований определяется … значений точечных оценок прогноза Xj(Tj). Если ввести в рассмотрение разность точечных оценок
Z1=X2(T2)-X1(T1),
Z2=X3(T3)-X3(T2),…,Zj=
=Xj+1(Tj+1)-Xj(Tj),…Zk=Xk+1(Tk+1)-Xk(Tk), (2.27)
то значения Zj(j=1, …, k) можно считать независимыми случайными величинами, поведение которых описывается некоторым неизвестным законом распределения F(Z).
Ограниченный объем используемой информации не позволяет достаточно надежно его определить методами математической статистики. Поэтому требуется разработка специальных методов решения задачи сравнения результатов прогнозов по ограниченному набору ретроспекций.
Следует заметить, что выборочные моменты (математическое ожидание, дисперсия и др.) могут быть определены по выборке Zj(j=1, …, k).
Определение закона распределения случайной величины Z и его анализ позволяют дать статистическую и смысловую интерпретацию результатов сравнения прогнозных исследований, определить коэффициент доверия (или построить доверительную область), проверить статистическую гипотезу о непротиворечивости данных прогноза и контрольного значения динамического ряда.
Традиционно для описания подобного рода случайных величин обращаются прежде всего к нормальному (гауссовскому) распределению, которое играет фундаментальную роль в вероятностно-статистических исследованиях.
Традиционная универсальность нормального закона, как было отмечено выше, объясняется, прежде всего, полнотой теоретических исследований, относящихся к нему. При самых широких предположениях суммы случайных величин ведут себя асимптотически нормально (соответствующие условия и составляют содержание так называемой предельной теоремы). Во многих случайных величинах можно видеть суммарный аддитивный эффект большого числа независимых причин и т.д. В силу изложенных обстоятельств этот закон распределения широко используется в качестве модели для различных статистических совокупностей. В тех случаях, когда гипотеза о принадлежности статистической совокупности генеральной нормальной совокупности не подтверждается опытными данными или когда теоретико-вероятностная схематизация вероятностного эксперимента порождает другую модель, представляется целесообразным в силу универсальности нормального закона обратиться к теории суммирования случайного числа нормальных случайных величин.
Теоретической основой процедуры уточнения математической модели формирования закона распределения случайной величины Z является аппарат характеристических функций.
В этом случае функция распределения F(Z) суммы случайного числа n случайных величин Z, на основании мультипликативного свойства характеристических функций определяется характеристической функцией
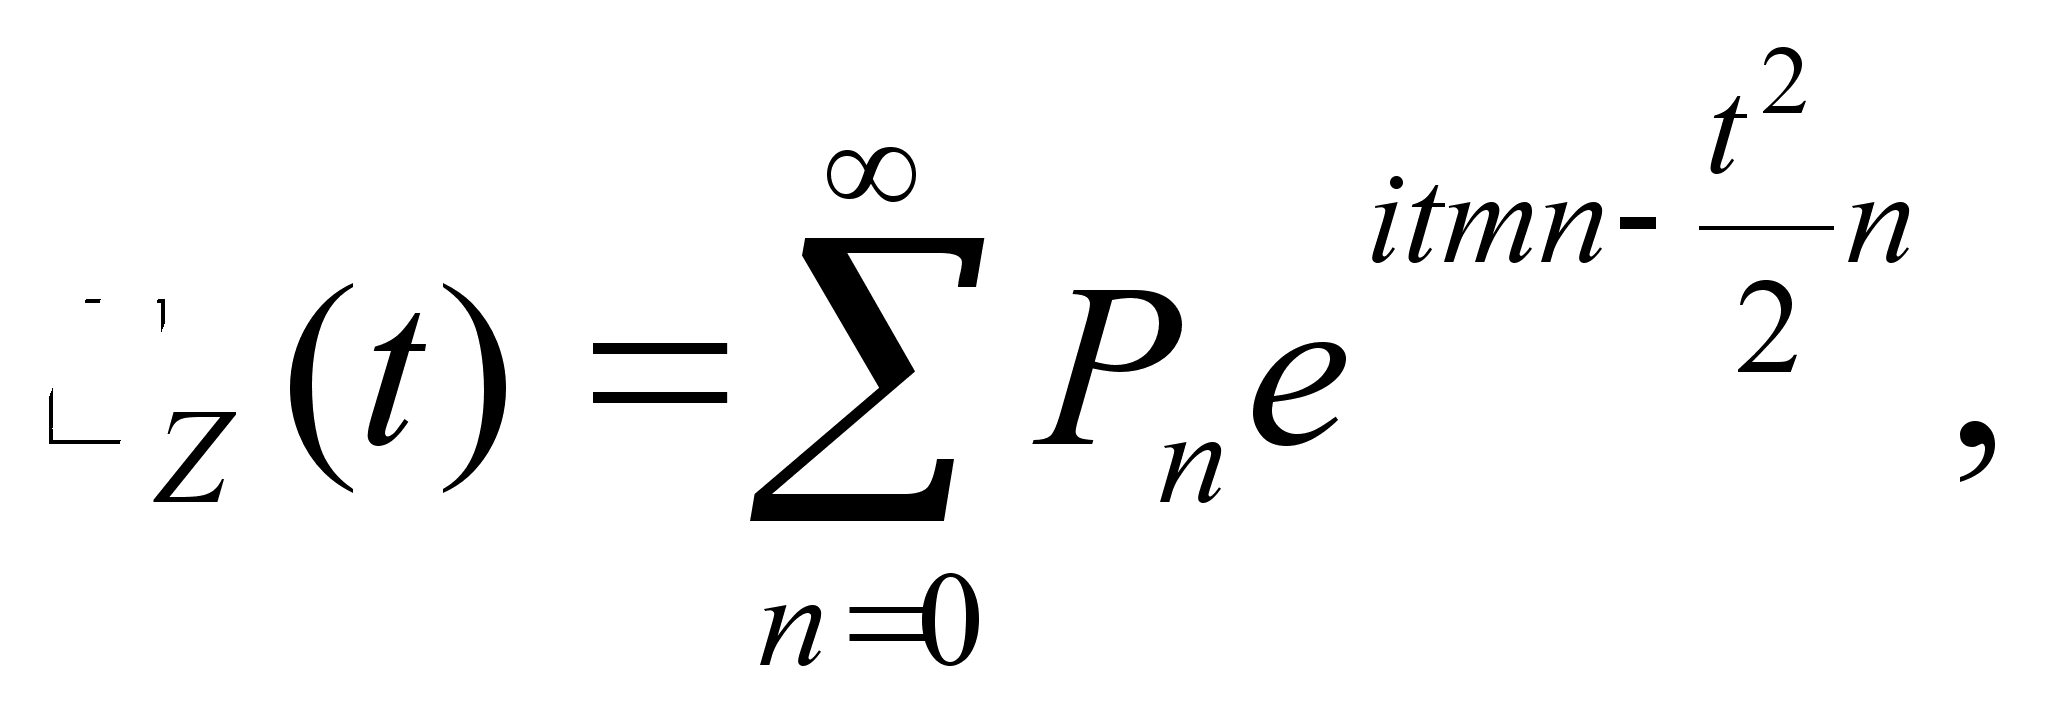 (2.28)
где
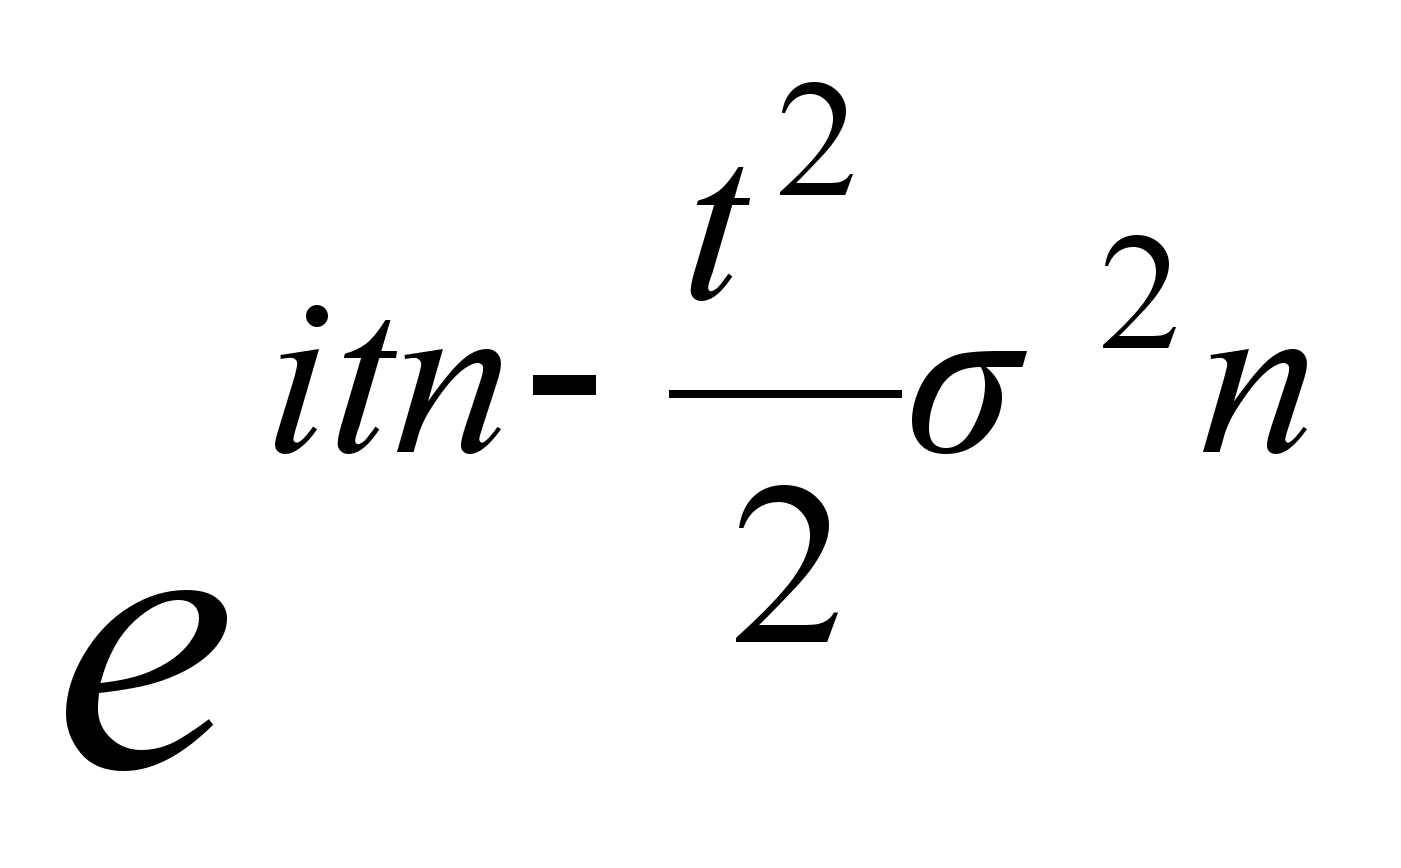 характеристическая
функция нормальной
случайной
величины с
параметрами
m
и .
В качестве примера, имеющего прикладное значение в рассматриваемой области, рассмотрим распределение суммы пуассоновского числа нормально распределенных случайных величин. С этой целью составим уравнение
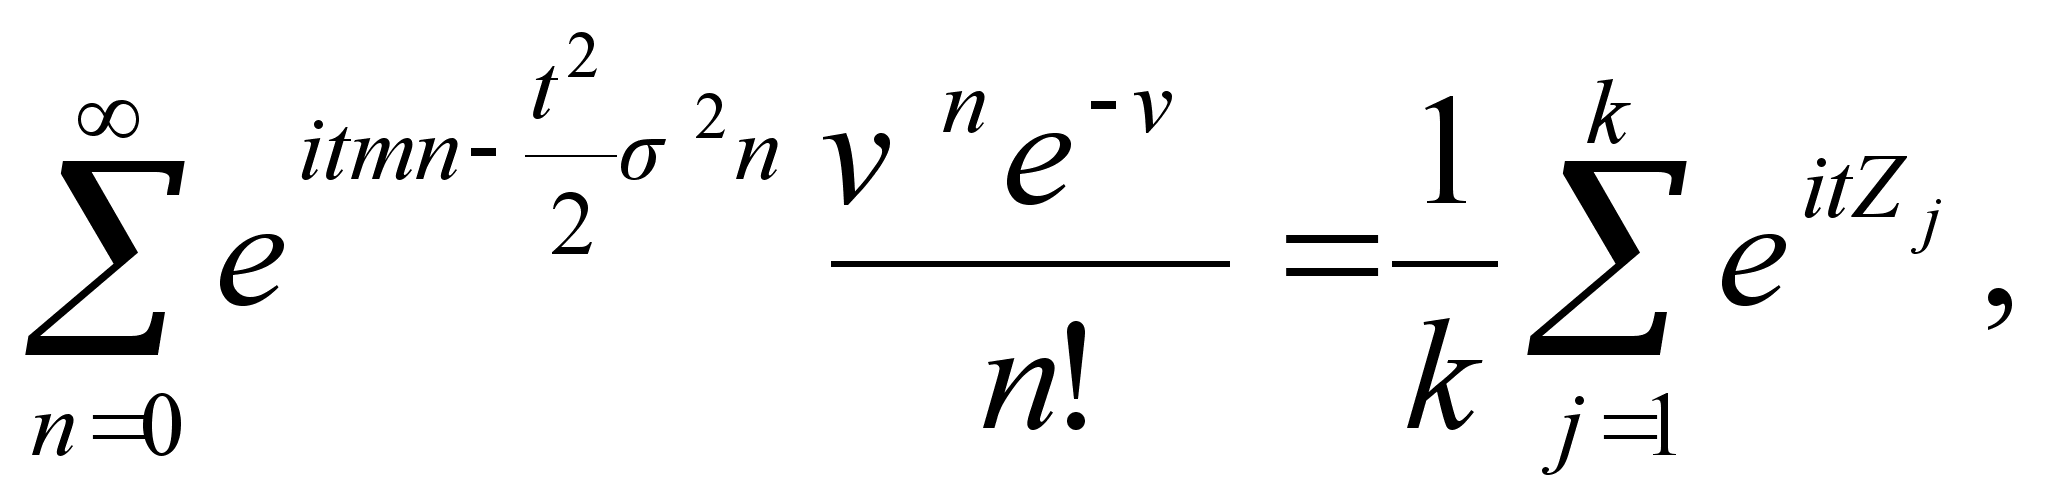 (2.29)
правая часть которого равна эмпирической характеристической функции. Параметры нормального закона распределения m и и закона Пуассона v могут быть определены в результате минимизации невязки или с помощью моментов. Метод моментов применительно к рассматриваемому уравнению заключается в приравнивании некоторого количества выборочных моментов, оцениваемых по правой части уравнения (2.29), к соответствующим теоретическим, определяемым по характеристической функции левой части уравнения в соответствии с зависимостью
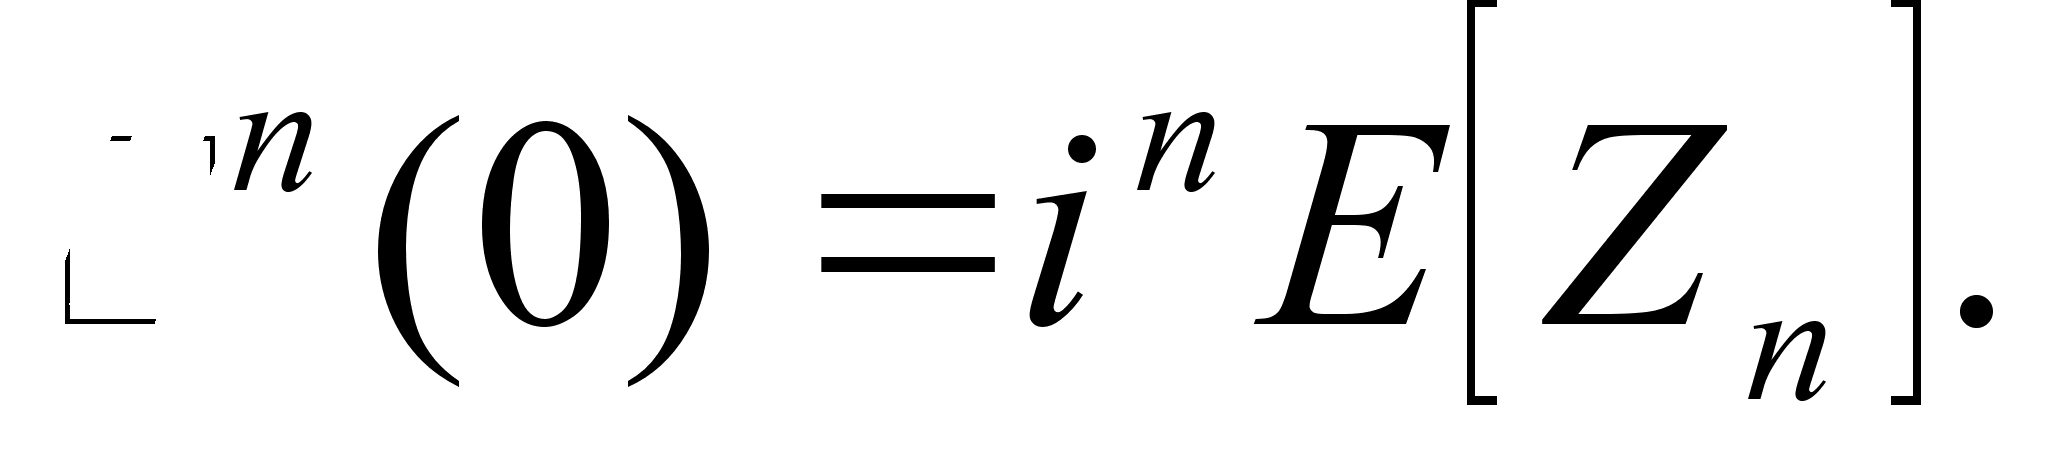 (2.30)
Естественно, что число получаемых в этом случае уравнений должно быть равным числу оцениваемых параметров (в данном случае трем).
Последовательно дифференцируя характеристические функции по t и приравнивая в полученных производных значения t нулю, можно составить следующую систему уравнений
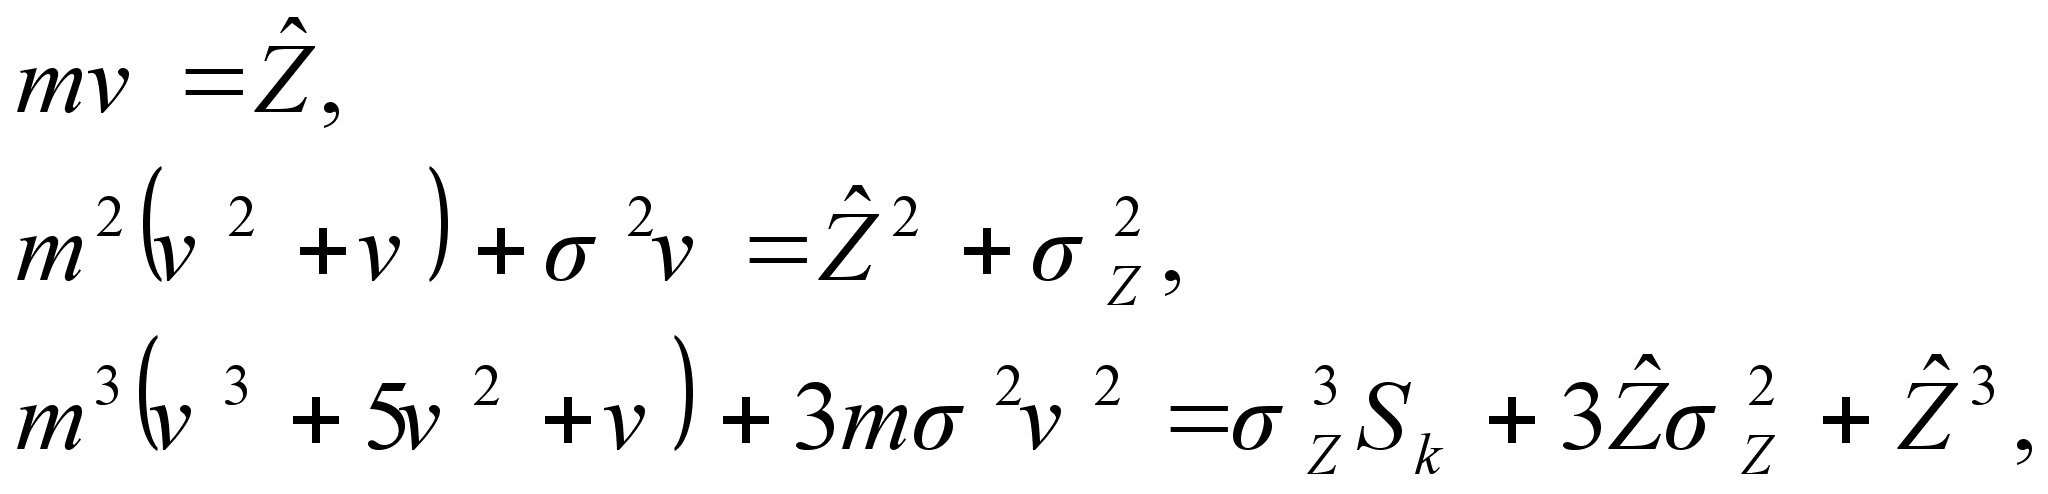 (2.31)
где Sk-асимметрия закона распределения, равная центральному моменту третьего порядка.
После некоторых алгебраических преобразований из системы уравнений (2.31) можно определить среднее число суммируемых случайных величин (параметр закона Пуассона).
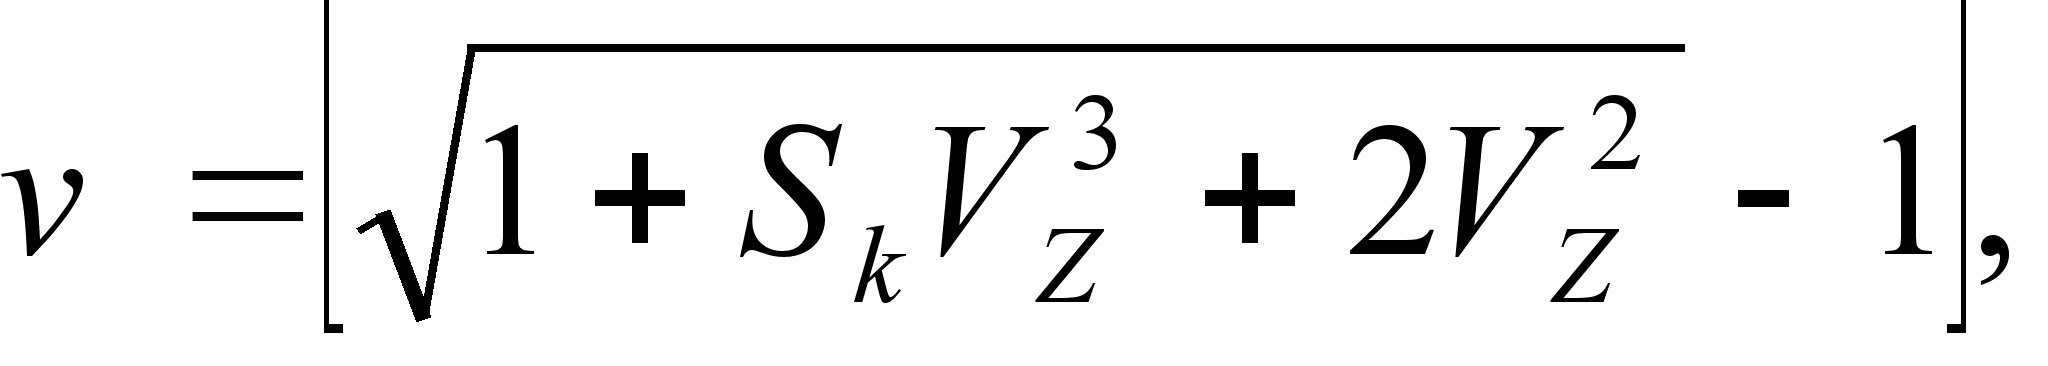 (2.32)
математическое ожидание и среднеквадратическое отклонение суммируемой нормальной случайной величины
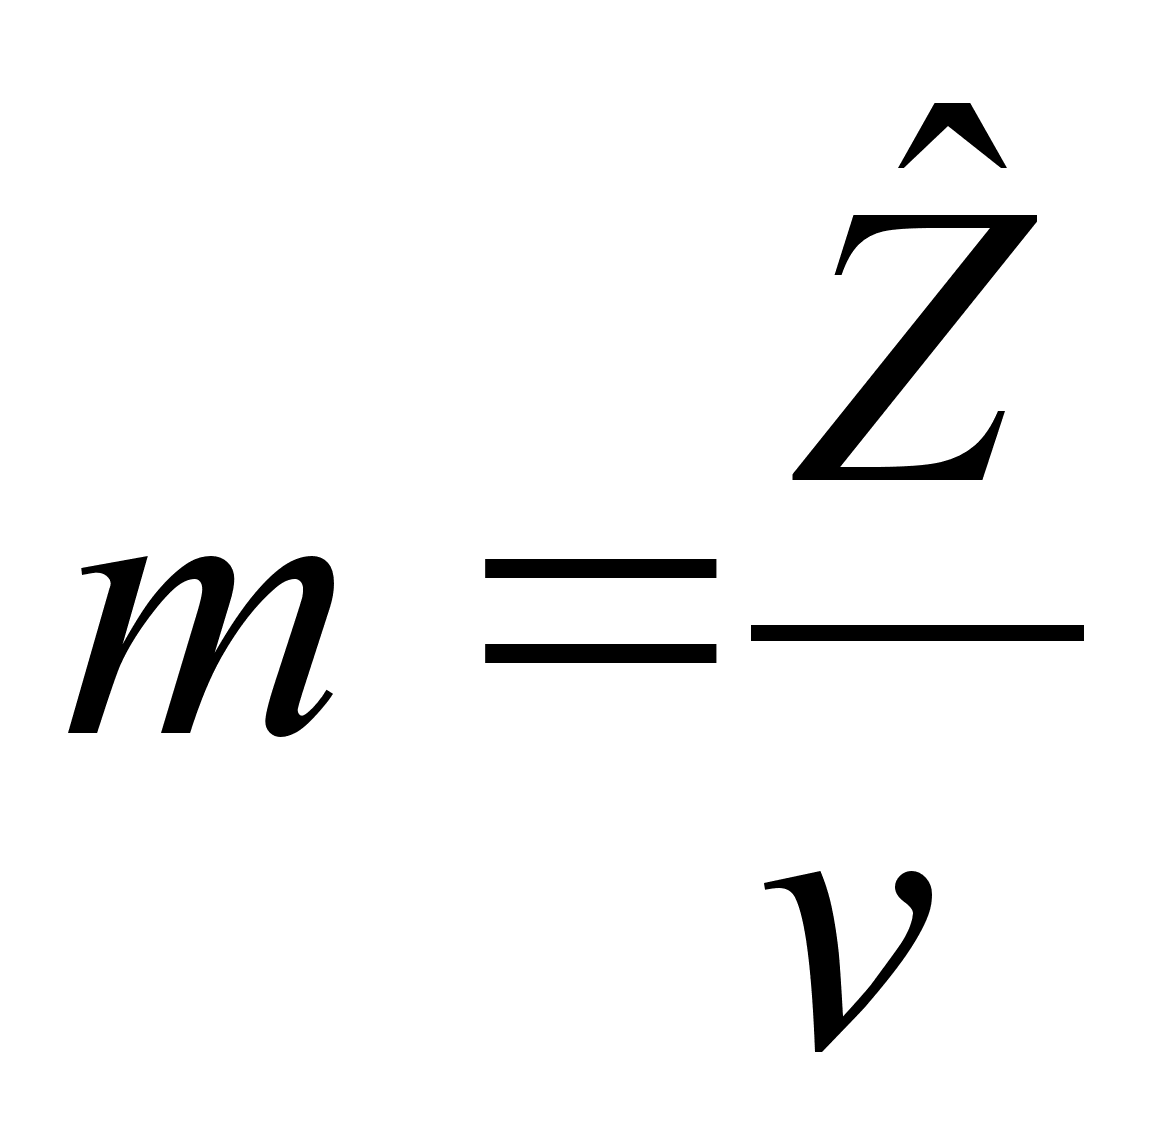 и
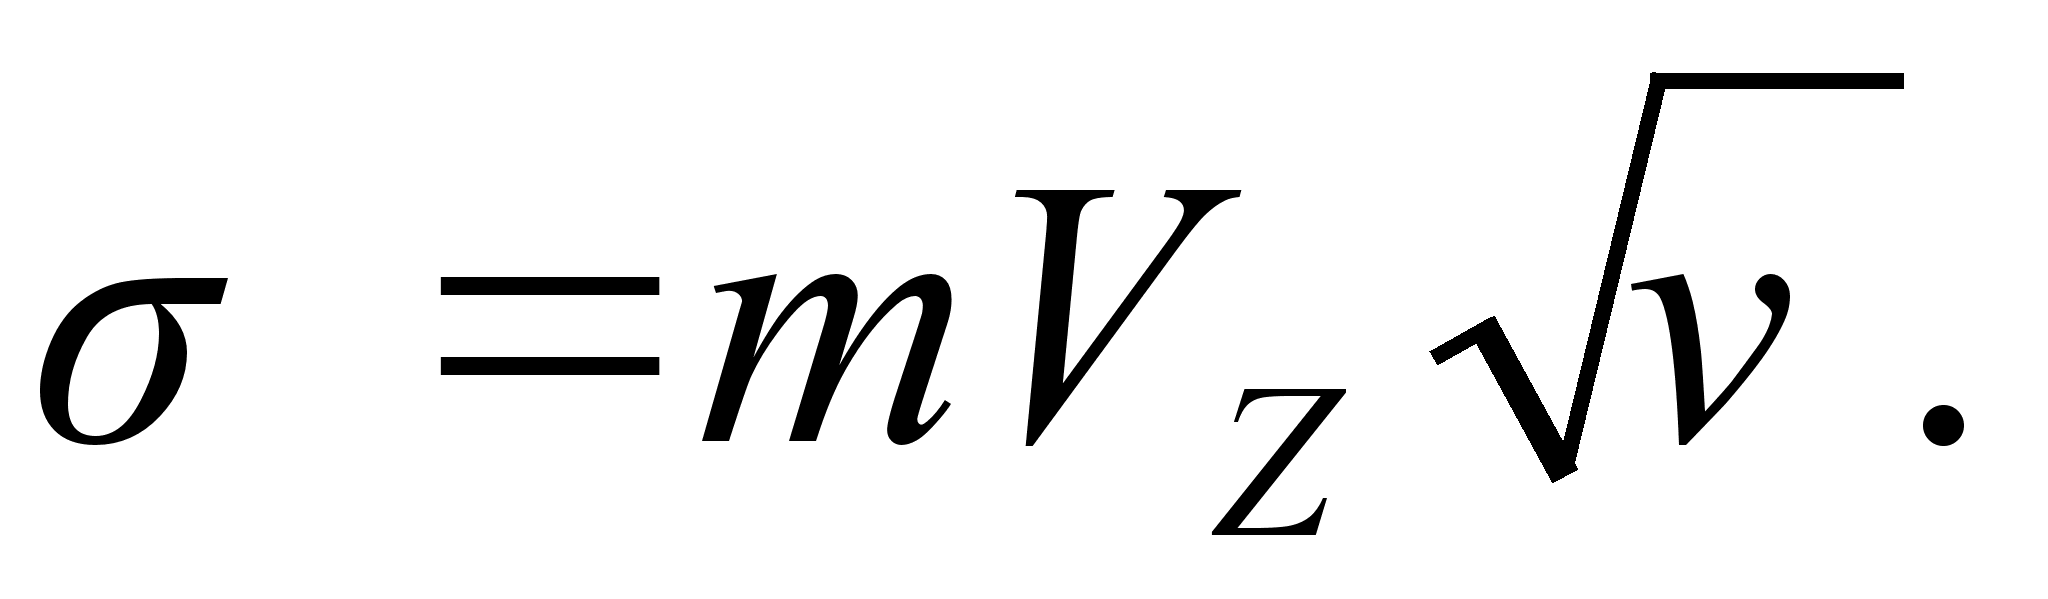 (2.33)
В
формулах (2.32)
и (2.33)
коэффициент
вариации Vz
определяется
по первым двум
моментам
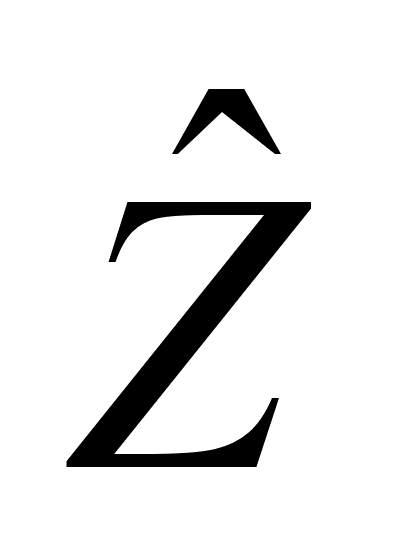 и
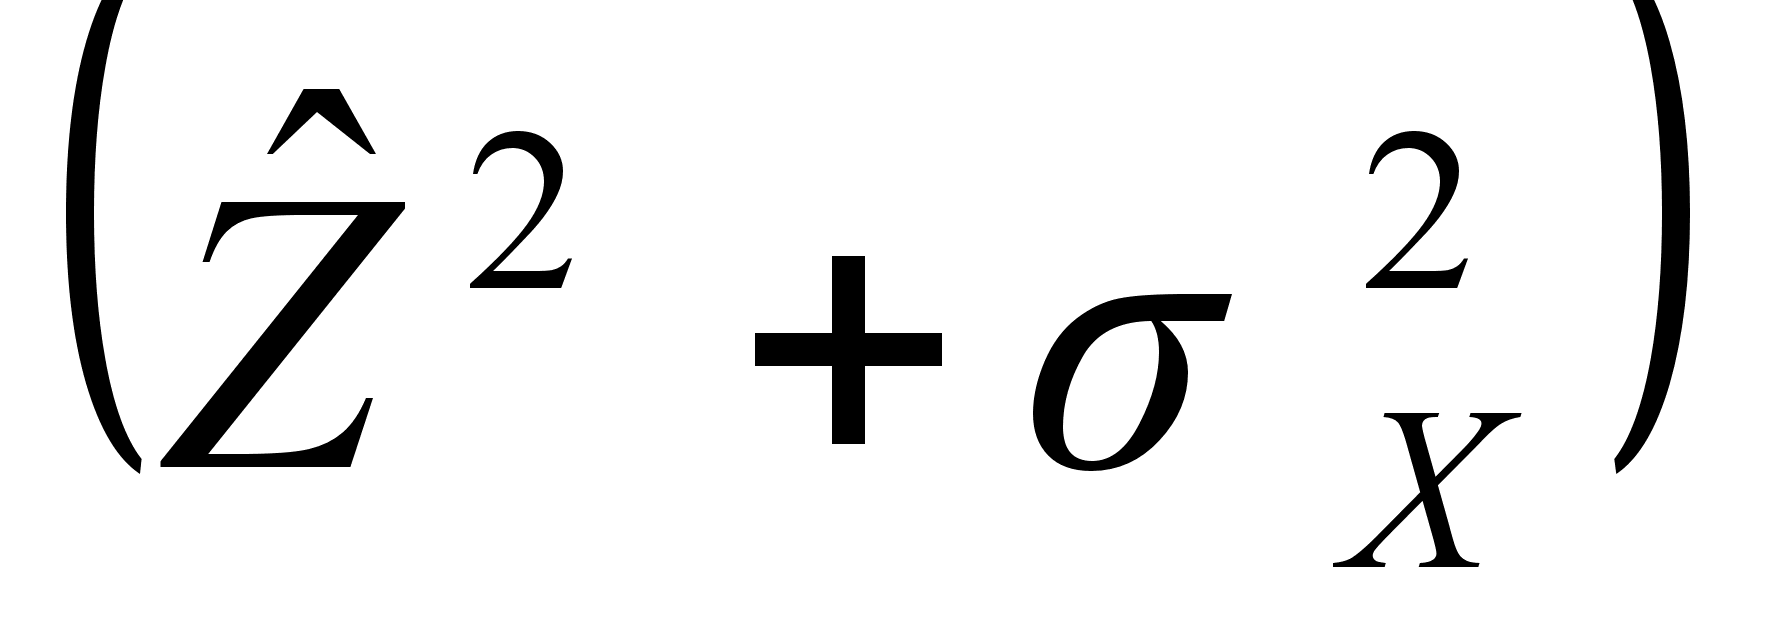
Используя формулу обращения
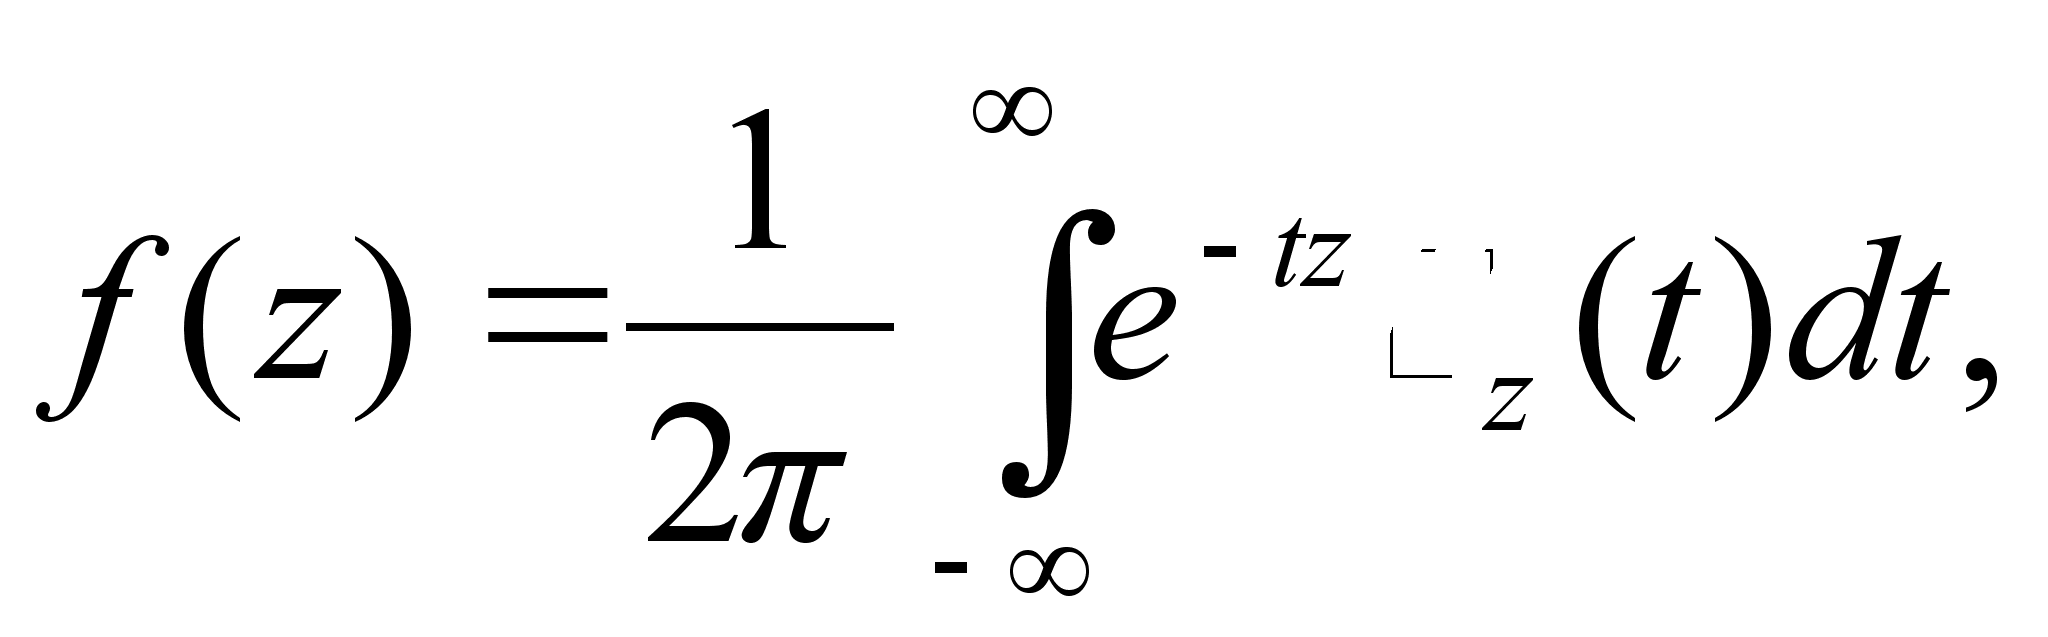
можно получить плотность распределения пуассоновского числа нормальных случайных величин
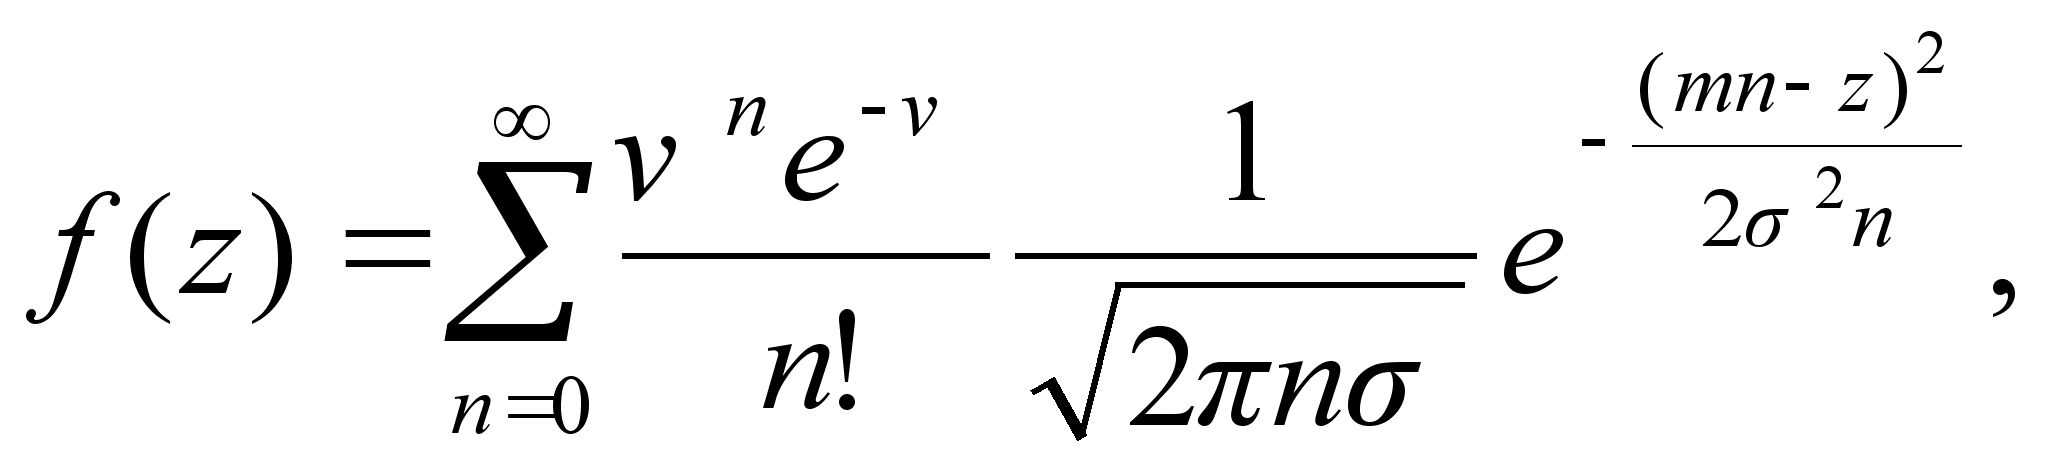 (2.34)
Очевидно, что плотность распределения (2.34), а точнее параметры v, m и , зависят от объема выборок случайных величин {Zj}, j=1,…,k; j=1, k=1, k-1 и т.д. Последовательно от этапа к этапу анализируя ретроспективную информацию, можно построить семейство плотностей распределения fj(z) (j=k, k-1, …). Задачу отбраковки устаревшей информации в этом случае сводится к решению последовательного ряда задач проверки статистических гипотез о принадлежности контрольного значения параметра Z0 генеральной совокупности, описываемой законом распределения с плотностью (2.34). При этом следует учесть, что в силу проведенной схематизации процесса Z0=0. Тогда, задаваясь уровнем значимости и учитывая симметричный характер закона распределения (2.34), можно найти такое значение индекса j, при котором выполнилось бы одно из следующих неравенств
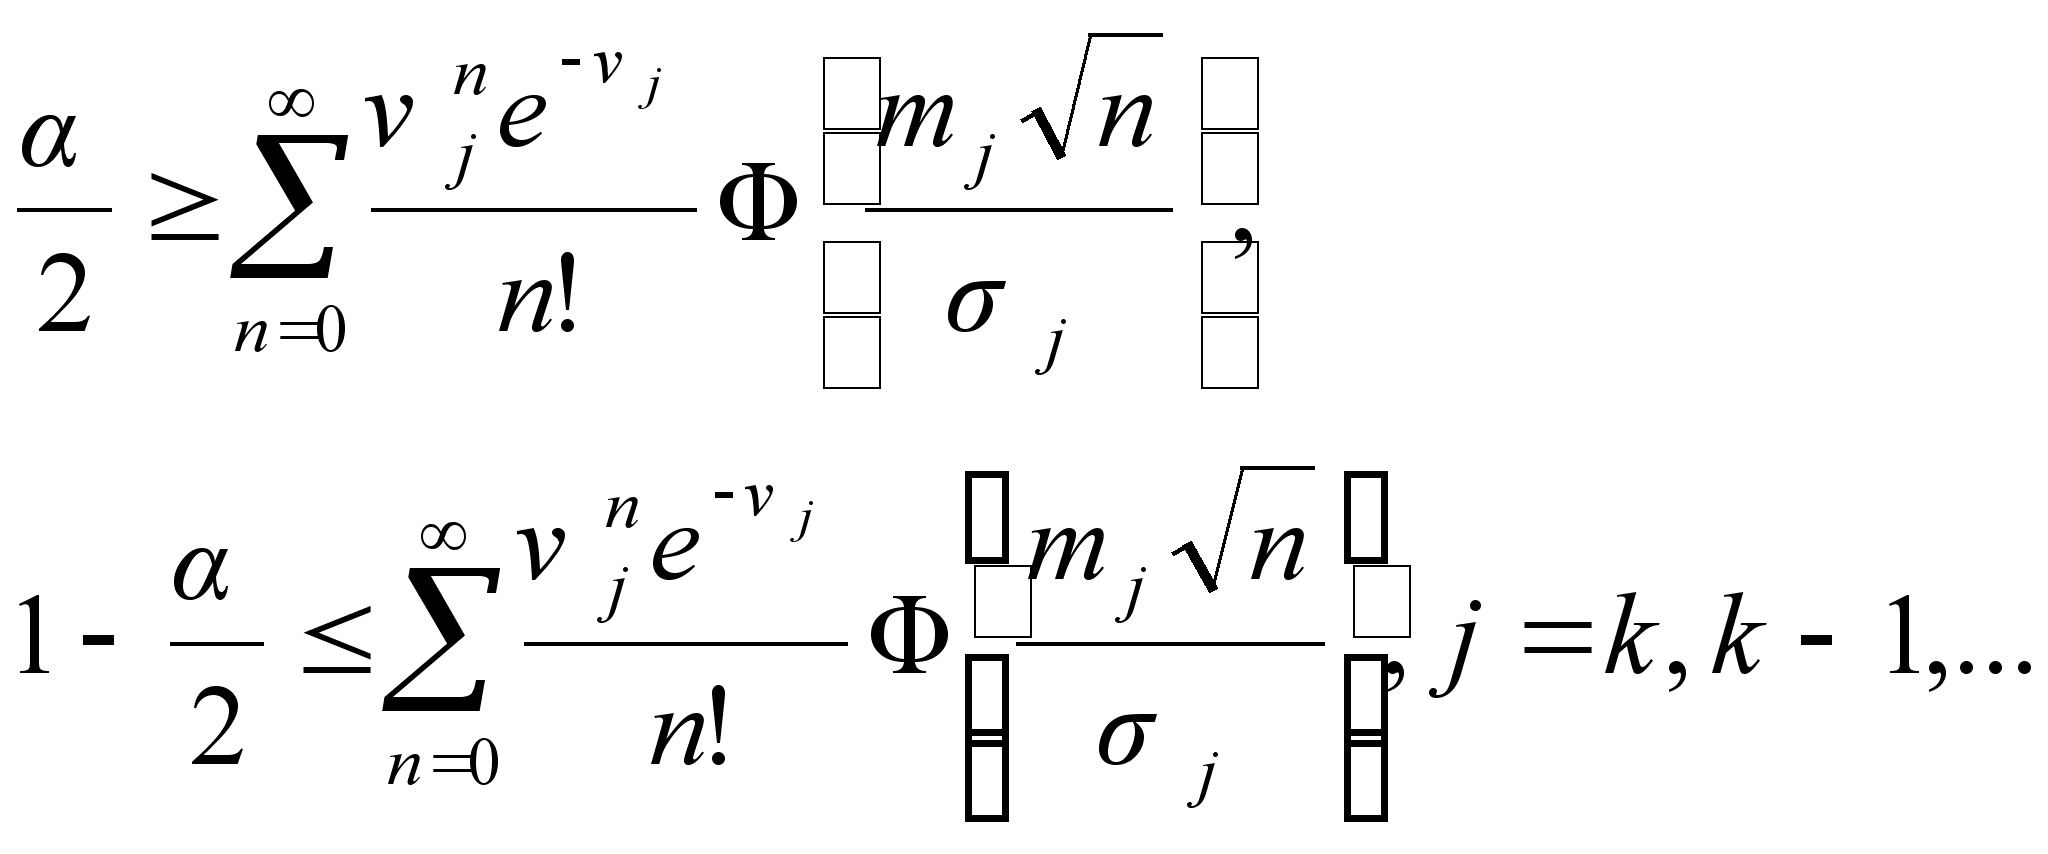 (2.35)
где
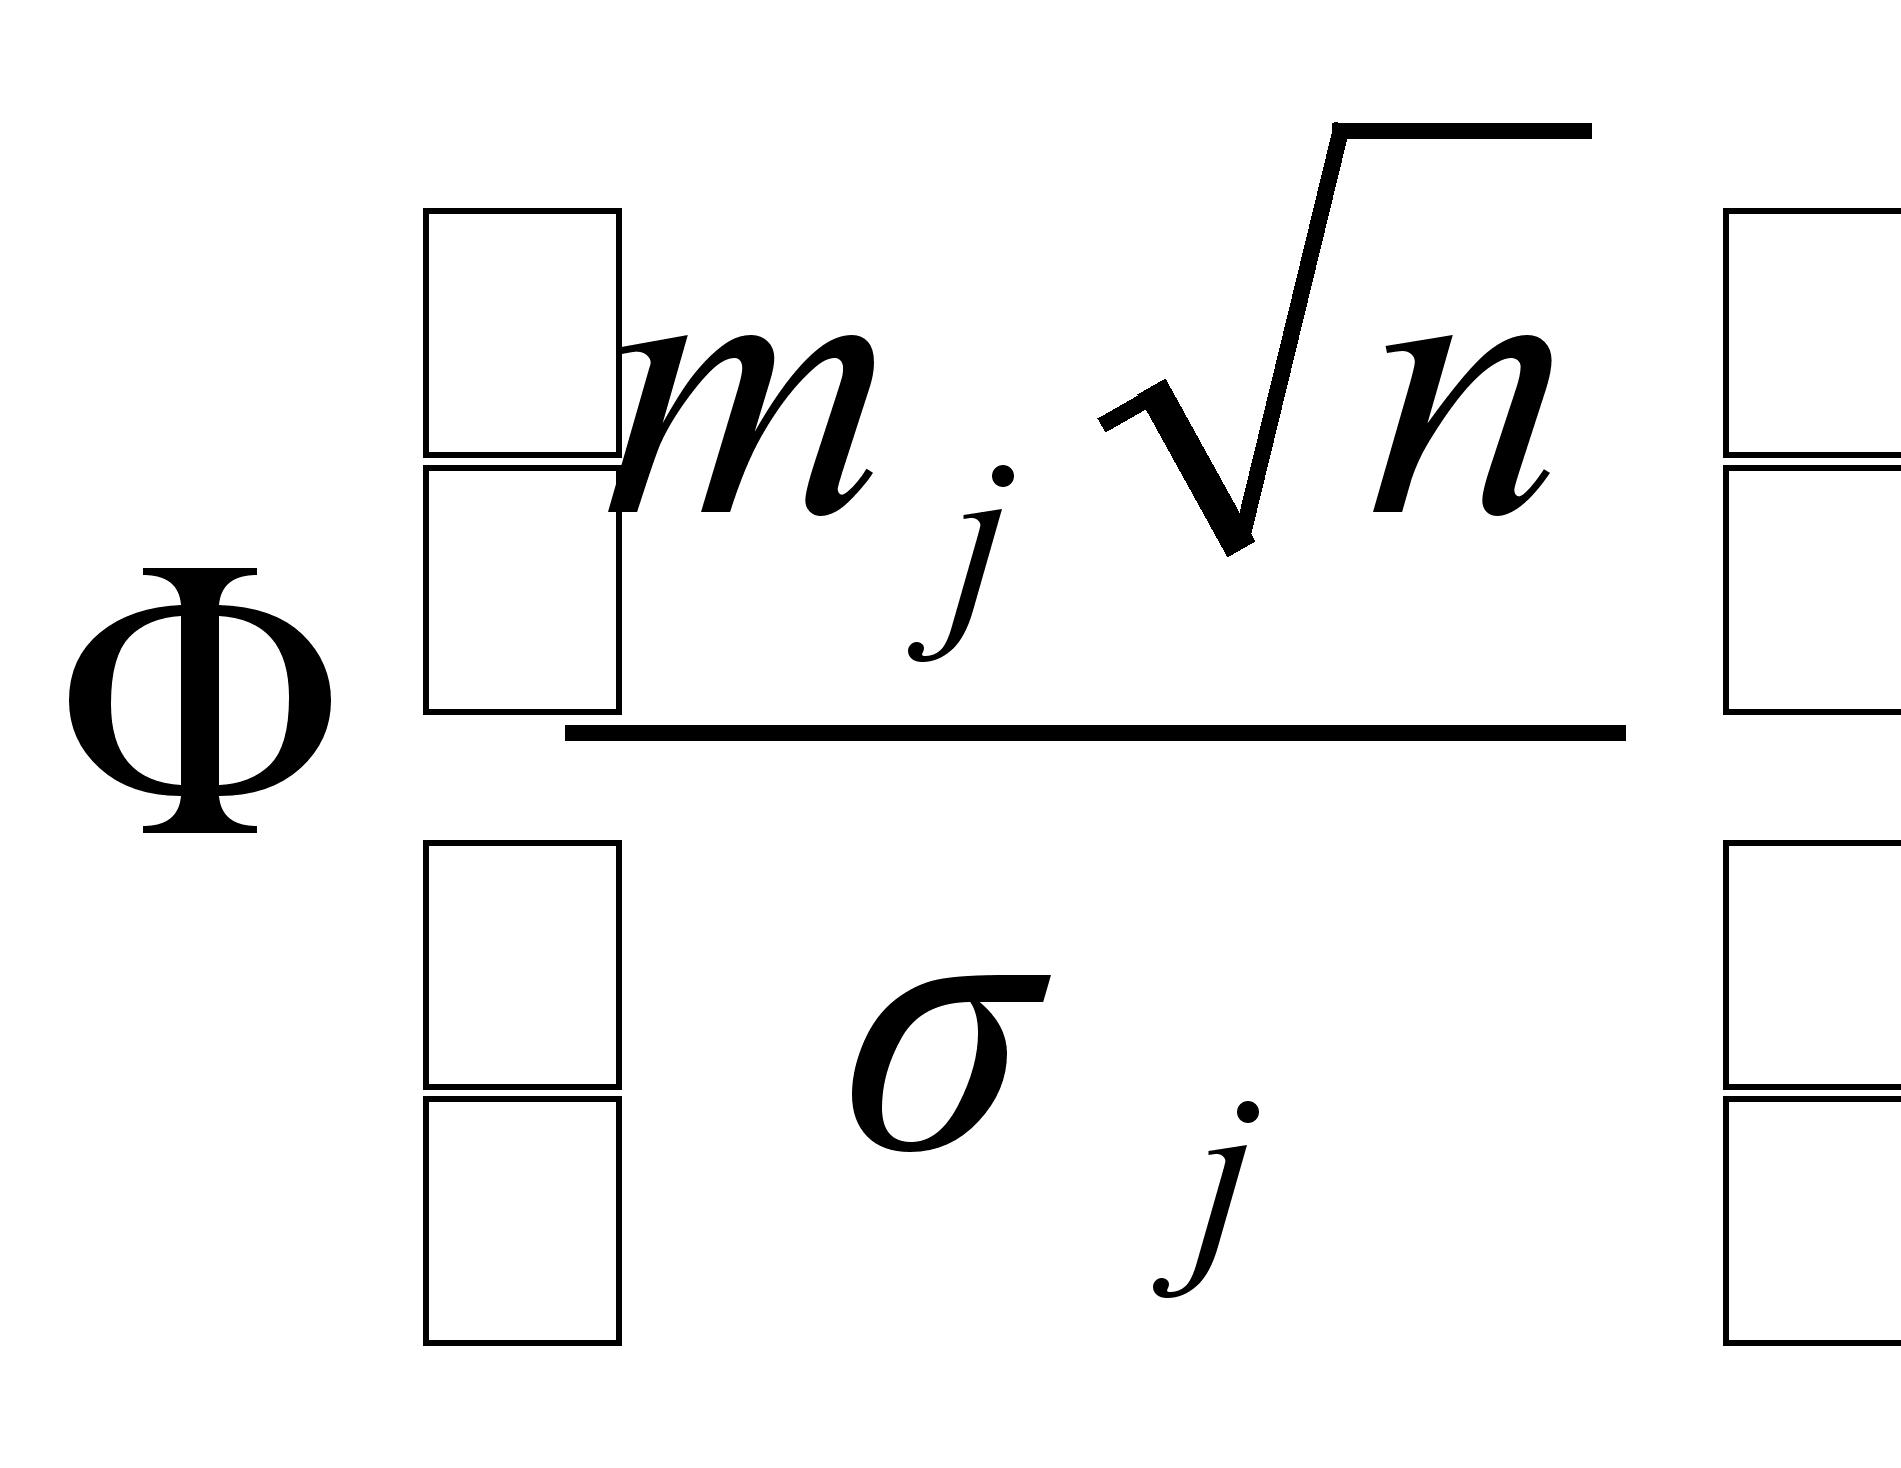 – функция Лапласа.
Справедливость соотношений (2.35) вытекает из очевидной процедуры вычисления функции распределения через плотность (2.34)
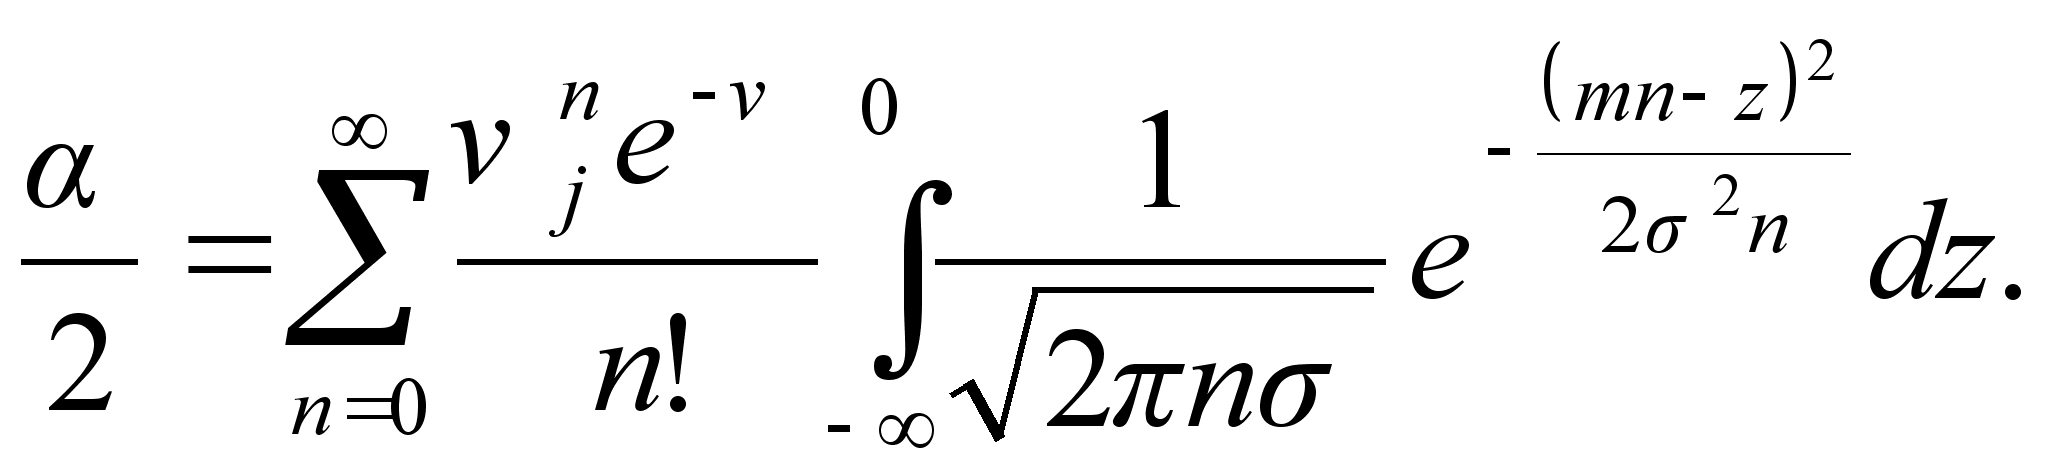 (2.36)
Таким образом, задача определения глубины предпрогнозной ретроспекции с учетом старения информации может быть достаточно надежно решена традиционными методами математической статистики с помощью математической модели (распределения сумм пуассоновского числа нормально распределенных случайных величин).
ЗАКЛЮЧЕНИЕ
В данной курсовой работе рассмотрены основные методы прогнозирования экономической среды с учетом фактора старения информации на примере рыночного механизма спрос-предложение.
Проанализировав полученную информацию, можно сделать выводы о том, что для различных наук, отраслей, экономических сфер старение информации понятие растяжимое. Для одних информация, полученная десять лет назад, все еще представляется важной, а для других, неважной является информация, полученная в течении последних суток.
Также для различных отраслей применяют различные методы учета фактора старения информации. С помощью таких методов можно из имеющейся в наличии информации для прогнозирования выжать максимум полезной информации.
Список литературы
Б.П Ивченко, Л.А. Мартыщенко, И.Б. Иванцов. «Информационная микроэкономика». Часть 1. Методы анализа и прогнозирования, СПб.: «Нордмед-Издат», 1997. – 160 с.
Романенко И.В. Социальное и экономическое прогнозирование: Конспект лекций. – СПб.: Издательство Михайлова В.А., 2000 г. – 64 с.
Прогнозирование и финансирование экономики в условиях рыночных отношений. – М.: Мысль, 1970. – 448 с.
Рябушкин Б.Т. Применение статистических методов в экономическом анализе и прогнозировании. – М.: Финансы и статистика, 1987. – 75 c.
Статистическое моделирование и прогнозирование: под ред. А.Г. Гранберга. – М.: Финансы и статистика, 1990. – 382 с.
Грисеев Ю.П. Долгосрочное прогнозирование экономических процессов: – Киев: Наукова думка, 1987 – 131 с.
Шибалкин О.Ю. Проблемы и методы построения сценариев социально-экономического развития. – М.: Наука, 1992 – 176 с.
Суворов А.В. Методы построения макроэкономических сценариев социально-экономического развития// Проблемы прогнозирования. – 1993. – №4 – сс. 27-39
Калинина А.В. Современный экономический анализ и прогнозирование (микро- и макроуровень): Учебное пособие // А.В. Калинина и др., Межрегиональная Академия управления персоналом, 2-е изд. –Л.: МАУП, 1998.
Глущенко В.В. Прогнозирование –2-е изд., Испр. и доп. –СПб: СПГУВК, 1999. –245 с.
Приложение А:
Таблица 1
|
Этапы |
Стадии |
| Общая постановка задачи |
|
| Построение конструкций для решения задачи |
|
| Решение задачи |
|
| Интерпретация решений |
|
Приложение В:
Таблица 2
Принципы системного подхода
|
Наименование принципа |
Его содержание |
| Целостности | Проблема анализа рыночного спроса рассматривается как самостоятельная проблема или как часть другой, более общей, проблемы, в которую она входит. Система. Выделенная для самостоятельного исследования, должна иметь возможность изменять своё состояние (движение) в зависимости от состояния старших или младших (в иерархическом смысле) систем. |
| Многомерности | Проблема анализа рыночного спроса рассматривается с позиции таких концепций, которые учитывают основные существенные факторы и взаимовлияние на спрос сопутствующих и конкурирующих видов товаров. |
|
Неопределённости
и |
Изменение рыночного спроса происходит под влиянием различных воздействий. Анализ показателей спроса должен производиться своевременно (в реальном масштабе времени), а математические зависимости, описывающие закономерности рыночного спроса, должны содержать в своей структуре модель прогнозирования. Кроме того, необходимо учитывать, что исходная информация, которую реально удастся собрать и подготовить для решения проблемы, оказывается, как правило, в значительной степени неполной и неточной. Статистическому анализу может быть подвергнута лишь некоторая часть всей совокупности микроэкономических параметров (характеристик), статистическое обследование всей генеральной совокупности затрудняется малым объёмом наблюдений. |
Приложение С:
Таблица 3
Направления и методы прогнозных исследований в микроэкономике.
|
№ |
Методы прогнозирования |
Краткосрочное |
Среднесрочное |
Долгосрочное |
| 1 | Корреляционно-регресионный анализ временных тенденций ** |
++ |
++ |
- |
| 2 | Метод экспоненциального сглаживания ** |
+ |
++ |
- |
| 3 | Экстраполяция временных тенденций по отшибающим кривым ** |
- |
- |
+ |
| 4 | Метод статистического моделирования временных тенденций ** |
++ |
++ |
- |
| 5 | Анкетные опросы экспертов |
+ |
++ |
- |
| 6 | Выработка коллективного мнения экспертов |
- |
++ |
+ |
| 7 | Системный анализ результатов фундаментальных исследований * |
- |
+ |
++ |
| 8 | Структурные схемы целей развития экономической системы и ее отдельных подсистем |
- |
- |
+ |
| 9 | Сценарий действий экономических структур |
- |
+ |
++ |
| 10 | Игровое моделирование ** |
- |
++ |
+ |
| 11 | Генерация идей в ходе «мозговой атаки» |
- |
++ |
+ |
| 12 | Морфологический анализ * |
- |
+ |
++ |
| 13 | Историческая аналогия * |
- |
- |
+ |
«-» - применение метода прогнозирования невозможно или нецелесообразно;
«+» - применение метода прогнозирования целесообразно и обосновано;
«++» - метод находит преимущественное применение при прогнозировании;
* - метод прогнозирования требует периодического учета фактора старения информации;
** - устаревшая исходная информация может оказать существенное влияние на конечный результат (учет фактора старения информации требует постоянного учета в реальном масштабе времени).