Разработка программного обеспечения для голосового управления трехмерными моделями функционирования промышленных роботов
где х(n-1),...,х(n-р) - предыдущие значения речевого сигнала. Получаемая при этом ошибка предсказания εр называется иногда остатком предсказания и равняется
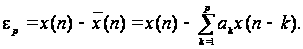 (2.24)
Коэффициенты линейного предсказания а вычисляются из условия минимума среднеквадратичного значения ошибки на интервале анализа. На этом интервале полная среднеквадратичная ошибка складывается для каждого отсчета сигнала, представленного линейной комбинацией р предыдущих значений сигнала
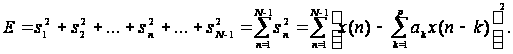 (2.25)
Здесь n – номер предыдущего отсчета сигнала на анализируемом интервале; k – номер предыдущего отсчета сигнала при построении линейной комбинации, представляющей текущий отсчет.
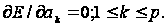 (2.26)
Коэффициенты линейного предсказания, минимизирующие полную ошибку предсказания Е, находятся после того, как выражение для полной ошибки продифференцировать по всем коэффициентам (полная ошибка предсказания может рассматриваться как функция параметров аk) и приравнять нулю все частные производные.
Частными производными называются производные сложной функции по одной из переменных с учетом того, что остальные переменные при таком дифференцировании считаются константами.
Результатом дифференцирования по а, является система из линейных уравнений с неизвестными коэффициентами линейного предсказания, минимизирующими ошибку линейного предсказания на отрезке анализа
сигнала, где коэффициенты k считаются постоянными.
Основной принцип метода линейного предсказания состоит в том, что текущий отсчет речевого сигнала можно аппроксимировать линейной комбинацией предшествующих отсчетов. Коэффициенты предсказания при этом определяются однозначно минимизацией среднего квадрата разности между отсчетами речевого сигнала и их предсказанными значениями (на конечном интервале). Коэффициенты предсказания – это весовые коэффициенты, используемые в линейной комбинации.
Основные положения метода линейного предсказания хорошо согласуются с моделью речеобразования, где показано, что речевой сигнал можно представить в виде сигнала на выходе линейной системы с переменными во времени параметрами, возбуждаемой квазипериодическими импульсами (в пределах вокализованного сегмента) или случайным шумом (на невокализованном сегменте). Метод линейного предсказания позволяет точно и надежно оценить параметры этой линейной системы с переменными коэффициентами.
Идеи и методы линейного предсказания довольно давно обсуждаются в технической литературе. Эти идеи используются в теориях автоматического управления и информации, где их называют методами оценивания систем, или металлами идентификации систем. Под термином «идентификация» понимаются методы линейного предсказания (ЛП), основанные на оценивании параметров, однозначно описывающих систему при условии, что ее передаточная функция является полюсной. Применительно к обработке речевых сигналов методы линейного предсказания означают ряд сходных формулировок задачи моделирования речевого сигнала [1,2]. Эти формулировки часто отличаются в исходных предпосылках. Иногда они сводятся, к различным методам вычисления, используемым для оценки коэффициентов предсказания. Так, применительно к речевым сигналам существуют следующие методы вычисления (часто равноценные); ковариационный [3], автокорреляционный [1, 2, 9], лестничного фильтра [11, 12].
обратной фильтрации [1], оценки спектра [12], максимального правдоподобия [4, 6] и скалярного произведения [1].
Целесообразность использования линейного предсказания обусловлена высокой точностью описания речевого сигнала с помощью модели.
Модель речеобразования в дискретном времени представляется в форме, наиболее удобной для решения задач линейного предсказания. В этом случае общий спектр, обусловленный излучением, речевым трактом и возбуждением, описывается с помощью линейной системы с переменными параметрами и передаточной функцией
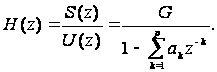 (2.27)
Эта система возбуждается импульсной последовательностью для вокализованных звуков речи и шумом для невокализованных. Таким образом, модель имеет, следующие параметры: классификатор вокализованных и невокализованных звуков, период основного тона для вокализованных сегментов, коэффициент усиления G и коэффициенты {аk} цифрового фильтра. Все эти параметры, разумеется, медленно изменяются во времени.
Определение периода основного тона и классификация тон/шум могут быть осуществлены на основе использования ряда методов, в том числе с помощью рассматриваемых ниже методов линейного предсказания. Для вокализованных звуков хорошо подходит модель, содержащая только полюса в своей передаточной функции (чисто полюсная), но для носовых и фрикативных звуков требуется учитывать и нули. Если порядок р модели достаточно велик, то полюсная модель позволяет получить достаточно точное описание почти для всех звуков речи. Главное достоинство этой модели заключается в том, что как параметр G так и коэффициенты можно оценить непосредственно с использованием очень эффективных с вычислительной точки зрения алгоритмов.
Отсчет речевого сигнала s(n) связан е сигналом возбуждения u(n) простым разностным уравнением
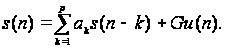 (2.28)
Линейный предсказатель с коэффициентами аk определяется как система, на выходе которой имеем
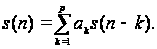 (2.29)
Системная функция предсказателя р-го порядка представляет собой полином вида
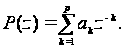 (2.30)
Погрешность предсказания определяется как
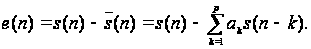 (2.31)
Из (2.31) видно, что погрешность предсказания представляет собой сигнал на выходе системы с передаточной функцией
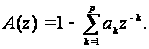 (2.32)
Сравнение (2.28) и (2.31) показывает, что если сигнал точно удовлетворяет модели (8.2), то e(n)=Gu(n). Таким образом, фильтр погрешности предсказания A (z) является обратным фильтром для системы H(z), соответствующей уравнению (2.27), т. е.
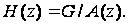 (2.33)
Основная
задача анализа
на основе линейного
предсказания
заключается
в непосредственном
определении
параметров
{ }
по речевому
сигналу с целью
получения
хороших оценок
его спектральных
свойств путем
использования
уравнения
(2.31). Вследствие
изменения
свойств речевого
сигнала во
времени коэффициенты
предсказания
должны оцениваться
на коротких
сегментах речи.
Основным подходом
является определение
параметров
предсказания
таким образом,
чтобы минимизировать
дисперсию
погрешности
на коротком
сегменте сигнала.
При этом предполагается,
что полученные
параметры
являются параметрами
системной
функции H(z)
в модели речеобразования.
То, что подобный подход приводит к полезным результатам, возможно, не сразу очевидно, но его полезность будет неоднократно подтверждена различными способами. Во-первых, пусть e(n)=Gu(n). Для вокализованной речи это означает, что е(n) будет состоять из последовательности импульсов, т.е. е(n) будет весьма мало почти все время. Поэтому в данном случае минимизация погрешности предсказания позволит получить требуемые коэффициенты. Другой повод, приводящий к тому же подходу, вытекает из того, что даже если сигнал формируется системой (2.28) с постоянными во* времени параметрами, которая возбуждается либо единичным импульсом, либо белым шумом, то можно показать, что коэффициенты предсказания, найденные по критерию минимизации среднего квадратического значения погрешности (в каждый момент времени), совпадают с коэффициентами в (2.28). Третьей, весьма важной для практики причиной является то, что подобная минимизация приводит к линейной системе уравнений, решение которых сравнительно легко приводит к получению параметров предсказания. Кроме того, полученные параметры, как это будет ясно из дальнейшего, составляют весьма плодотворную основу для точного описания сигнала. Кратковременная энергия погрешности предсказания
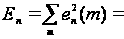 (2.35)
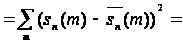 (2.36)
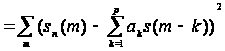 (2.37)
где
 -
сегмент речевого
сигнала, выбранный
в окрестности
отсчета n,
т. е.
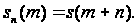
 (2.38)
Пределы
суммирования
справа в (2.35)-(2.37) пока
не определены,
но поскольку
предполагается
использовать
концепции
кратковременного
анализа, то эти
пределы всегда
предполагаются
конечными.
Кроме того, для
получения
среднего значения
необходимо
разделить
полученный
результат на
длину речевого
сегмента, Однако
эти константы
несущественны
с точки зрения
решения системы
линейных уравнений
и поэтому далее
опускаются.
Параметры ак
можно получить,
минимизируя
Еn
в (2.37) путем вычисления,
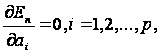 что
приводит к
системе уравнений
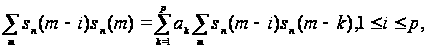 (2.38)
где
-
значения аК,
минимизирующие
Еn.
Если ввести
определение
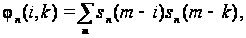 (2.39)
тогда (2.38) можно переписать в более компактном виде
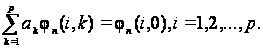 (2.40)
Эта
система из р
уравнений с
р
неизвестными
может быть
решена достаточно
эффективным
способом для
получения
неизвестных
коэффициентов
предсказания,
минимизирующих
средний квадрат
погрешности
предсказания
на сегменте
 .
Используя
(2.37) и (2.39), можно показать,
что средняя
квадратическая
погрешность
предсказания
имеет вид
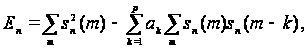 (2.41)
и, используя (2.40), можно выразить Еn в виде
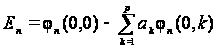 (2.42)
Таким образом, общая погрешность предсказания состоит из двух слагаемых, одно из которых является постоянным, а другое - зависит от коэффициентов предсказания.
Для
решения системы
уравнений
относительно
коэффициентов
предсказания
следует первоначально
вычислить
величины
 ,
1≤i≤р
и 1≤o≤р.
Только
после
этого можно
переходить
к решению (2.40) и
получению
оценок
Таким образом,
принципиально
анализ на основе
линейного
предсказания
очень простой.
Однако подробности,
связанные с
вычислением
и
последующим
решением системы
уравнений,
являются достаточно
запутанными
и нуждаются
в дальнейшем
обсуждении.
Хотя пределы суммирования в (2.35)-(2.37) и (2.39) не определены, в (2.39) они совпадают с соответствующими пределами в (2.35)-(2.37). Как было установлено, для кратковременного анализа соответствующие пределы должны охватывать конечный интервал. Имеется два подхода к этому вопросу, и в зависимости от пределов суммирования и выбора сегмента 8п(ш) различают два метода линейного предсказания: автокорреляционный метод и ковариационный метод.
В
зависимости
от определения
сегмента
анализируемого
сигнала можно
получить две
различные
системы уравнений.
Для автокорреляционного
метода сигнал
взвешивается
с использованием
N-точечного
окна и величины
получаются
на основе
кратковременной
автокорреляционной
функции. Полученная
матрица корреляций
является теплицевой
и приводит к
первой системе
уравнений для
параметров
предсказания.
При ковариационном
методе сигнал
предполагается
известным на
множестве
значений -p≤n≤N-1.
Никаких предположений
о сигнале вне
данного интервала
не делается,
поскольку
только этот
интервал необходим
для вычислений.
Полученная
матрица корреляций
в данном случае
симметричная,
но не теплицева
(симметричная
и такая, что
элементы на
любой диагонали
равны между
собой). В результате
два различных
метода вычисления
корреляции
приводят к двум
различным
системам уравнений
и к двум совокупностям
коэффициентов
предсказания
с различными
свойствами.
2.3 Цифровая обработка речи в системах речевого общения человека с машиной
2.3.1 Классификация систем речевого общения человека с машиной
Эта область является чрезвычайно важной, дающей все новые и новые приложения, область, которая только еще развивается и демонстрирует огромные возможности для широкого применения.
Системы речевого обмена между человеком и машиной можно подразделить на три класса: с речевым ответом, распознавания диктора и распознавали речи.
Системы с речевым ответом предназначаются для выдачи информации пользователю в форме речевого сообщения. Таким образом, системы с речевым ответом - это системы односторонней связи, т. е. от машины к человеку. С другой стороны, системы второго и третьего классов - это системы связи от человека к машине. В системах распознавания диктора задача состоит в верификации диктора (т. е. в решении задачи о принадлежности данного диктора к некоторой группе лиц) или идентификации диктора из некоторого известного множества. Таким образом, класс задач распознавания диктора распадается на два подкласса: верификации и идентификации говорящего.
Последний класс задач распознавания речи также можно разделить на подклассы в зависимости от таких факторов, как размер словаря, количество дикторов, условия произнесения слов и т. д. Основная задача распознающей системы сводится либо к точному распознаванию произнесенной на входе фразы (т.е. система фонетической или орфографической печати произнесенного текста), либо к «пониманию» произнесенной фразы (т. е. к правильной реакции на сказанное диктором). Именно задача понимания, а не распознавания наиболее важна для систем с достаточно большим словарем непрерывных речевых сигналов, в то время как задача точного распознавания более важна для систем с ограничением словарем, малым количеством дикторов, систем распознавания изолированных слов.
2.3.2 Системы с речевым ответом
Элементами общей структурной схемы системы с речевым ответом на базе ЭВМ являются блоки памяти для хранения словаря системы с речевым ответом; хранения правил синтеза сообщений по элементам словаря; программ формирования речевого ответа.
На вход системы с речевым ответом поступает сообщение о содержании вопроса, порождаемого либо другой системой обработки информации, либо непосредственно от человека, обратившегося с интересующим его вопросом к информационной системе. Откликом системы на поставленный вопрос служит выходное сообщение в виде речевой фразы. Простым примером такой системы является автоматическая справочная телефонная служба, которая обнаруживает неправильно набранный номер, определяет причину ошибки (например, телефон отключен или ему присвоен новый номер и т. д.) и посылает на выход системы с речевым ответом сообщение, содержащее необходимее абоненту указания. В таких системах словарь обычно состоит из ограниченного набора изолированных слов (например, цифр с различными окончаниями).
В качестве другого примера рассмотрим информационную систему о состоянии курса акций. Здесь абонент должен с помощью кнопочного набора ввести код интересующего его курса. Система декодирует набор, определяет текущий курс акций и затем выдает соответствующую информацию в систему с речевым ответом для составления требуемой фразы. В данном случае словарь должен содержать достаточно широкий набор различных слов и фраз.
Существуют два основных подхода к построению систем с речевым ответом. Один из них заключается в попытке построения системы, речевые возможности которой сравнимы с возможностями человека. В этом случае для синтеза достаточно хранить словарь произношений элементов. Сигналы, необходимые для управления речевым синтезатором, в соответствии с моделью речеобразования формируются на основе правил синтеза. Такие системы представляют интерес в том случае, если требуется словарь весьма большого объема. Реализация подобных систем - это проблема, требующая чрезвычайно трудоемких исследований, и на этапе синтеза сигнала имеются обширные возможности применения рассмотренных выше методов цифровой обработки сигналов.
В системах с речевым ответом второго типа используется ограниченный словарь, и сигнал на выходе таких систем формируется посредством сочленения отдельных элементов реального речевого сигнала, взятых из словаря. Сообщения конструируются в этом.случае путем отыскания требуемых слов и фраз в памяти и воспроизведения их в требуемой последовательности. При разработке систем подобного типа следует учитывать три основных соображения. Во-первых, способ представления и хранения словаря должен быть выбран таким образом, чтобы в разработанной системе имелась возможность свободного доступа к любому элементу словаря. Во-вторых, должен быть выбран способ редактирования речевого материала словаря совместно со способом записи его элементов в память. В-третьих, необходимо обеспечить заданную последовательность выбора и воспроизведения элементов словаря (т.е. способ формирования сообщения).
Поскольку назначение систем с речевым ответом состоит в формировании речевых сообщений, предназначенных для человека, Требование к разборчивости становится определяющим. Не менее важное, значение, однако, имеют и такие параметры речи, как качество восприятия и натуральность. Таким образом, в разрабатываемой системе необходимо с предельной полнотой реализовать все три основных условия с тем, чтобы добиться максимально возможной разборчивости и натуральности речевого сигнала.
Центральным фактором, определяющим сложность систем с речевым ответом, является выбор способа цифрового представления речи при составлении словаря. Выбор способа цифрового представления оказывает большое влияние на объем и тип цифровой памяти, а также на способ синтеза речевого сообщения.
При рассмотрении способа цифрового представления речевого сигнала применительно к системам с речевым ответом полезно остановиться на трех основных моментах:
скорость передачи информации (в битах в секунду), необходимая для получения приемлемого качества;
сложность способа кодирования и декодирования;
гибкость представления, т. е. возможность модификации элементов словаря.
Представление на основе кодирования речевого колебания требует наибольших скоростей передачи и, следовательно, максимального объема памяти для хранения элементов словаря. Эти способы являются простейшими с точки зрения алгоритмов кодирования-декодирования. С другой стороны, способы анализа-синтеза, которые буквально «разбивают речевой сигнал на части», обладают широкими возможностями полезной модификации элементов словаря. Два первых фактора, т.е. скорость передачи и сложность реализации, оказывают существенное влияние на технико-экономические показатели при разработке полностью цифровых систем речевого ответа.
Другой важной задачей, решаемой при построении систем с речевым ответом, являются создание и редактирование словаря. При решении этой задачи, т. е. подготовке элементов словаря и обеспечении высококачественного сигнала на выходе, цифровые методы оказываются чрезвычайно эффективными и гибкими. Обычно слова и фразы, включаемые в словарь, произносятся специально обученным диктором и записываются с высоким качеством. Затем слова или фразы подвергаются аналого-цифровому преобразованию и кодированию. Цифровое представление (которое может быть как описанием формы сигнала, так и основанным, на представлении типа, «анализ–синтез») оперативно хранится в цифровой форме в ЭВМ. Для исключения пауз между фразами используется специальный метод поиска начала и конца фразы. При высококачественной записи начало и конец каждой фразы можно определить с высокой точностью. При этом можно точно сказать, удовлетворяет ли протяженность данной фразы заданной. Фраза, кроме того, может быть воспроизведена для
проверки окончаний слов или фразы на слух. Записи можно легко повторять, пока не будут достигнуты требуемые длительность и окончание вводимой фразы.
Заключительным шагом в создании словаря являются сравнение энергетических уровней всех слов в словаре и соответствующее изменение уровней для получения некоторого единого уровня или такого распределения уровней, которое предопределяется предполагаемым использованием словаря. Это может быть сделано или на основе вычисления максимального значения сигнала, или на основе использования других мер, таких, как кратковременная энергия.
Если слово или фраза записаны с требуемым качеством, то они хранятся в определенном месте памяти словаря. Это достигается простой установкой файлов в речевой системе и указанием адресов, которые используются системой синтеза фраз для определения начала и окончания каждого элемента словаря.
Помимо рассмотренных методов создания словаря система с речевым ответом включает в себя методы синтеза фраз по элементам словаря. В этом случае методы цифрового представления также обладают значительными преимуществами. Если используется метод кодирования формы речевого колебания, то все, что здесь необходимо, - это сочленить речевые сигналы элементов словаря. Если элементом словаря является отдельное слово, то такой метод может привести к некоторой потере-натуральности звучания, но подобный подход обладает важным преимуществом, состоящим в том, что система синтеза фраз оказывается очень простой.
С другой стороны, представление, основанное на преобразовании типа «анализ-синтез», обладает большой гибкостью по отношению к изменяющимся свойствам элементов словаря, например временным соотношениям, окончаниям и т. д. Это свойство является даже более важным, чем малая скорость передачи (объем описания), которую можно достигнуть при использовании описания на основе преобразования «анализ-синтез».
Поскольку элементы словаря представлены в виде набора основных параметров речевого сигнала, можно, например, изменять период основного тона и длительность слов таким образом, чтобы привести их в соответствие с контекстом. Более интересной представляется возможность такого изменения параметров на границах слов, чтобы добиться как можно большего сходства между синтезированными и реальными речевыми сигналами. Достигнуть такого эффекта даже в простейших случаях можно лишь на основе использования правил для определения требуемого периода основного тона и протяжённости во времени, а также алгоритмов изменения параметров в соответствии с изменяющейся протяженностью слов и поглощением их границ в слитной речи [1,2].
2.3.3 Системы распознавания дикторов
При распознавании дикторов цифровая обработка речи является тем первым шагом, с которого начинается решение задачи распознавания образов. Речевой сигнал представляется с использованием таких методов цифровой обработки, которые сохраняют индивидуальные особенности диктора. Полученный образ сравнивается с предварительно подготовленными эталонными образами, а затем применяется соответствующая логика принятия решений для определения голоса заданного диктора среди возможного множества. Системы распознавания, дикторов подразделяются на два вида: идентификация и верификация. При верификации диктора требуется установить его идентичность данному эталону. Устройство верификации принимает одно из двух возможных решений: диктор является тем, за кого он себя выдает, или не является. Для вынесения такого решения используется совокупность параметров, содержащих необходимую информацию об индивидуальности диктора и измеряемых по одной или нескольким фразам. Измеренные значения сравниваются (часто с использованием некоторых существенно нелинейных метрик близости) с аналогичными параметрами эталонных образов подлежащего опознанию диктора.
Таким образом, при верификации диктора требуется однократное сравнение совокупности (совокупностей) измеренных значений со значениями параметров-ионов, на основе которого выносится решение о принятии или отклонении предполагаемой идентичности. В общем случае вычисляется расстояние между измеренными значениями и распределением эталонов. На основе распределения потерь между возможными типами ошибок (т. е. верификации «самозванца» и отклонении «подлинного» диктора) устанавливается соответствующий порог различимости (расстояния). Вероятность перечисленных выше ошибок практически не зависит от N (числа эталонов, хранимых в системе), поскольку все эталоны голосов других дикторов используются для формирования устойчивого распределения, характеризующего всех дикторов. Записывая сказанное выше в математической форме, обозначим распределение вероятности измеренных значении вектора х для диктора как рi(х), что приводит к простому решающему правилу вида
Верифицировать диктора i, если рi(х)>ci раv (х);
Отклонить диктора i, если рi(х)<ci раv (х); (2.43)
где ci - константа для i-го диктора, определяющая вероятности ошибок i-го диктора, а раv (х)–среднее (по всему ансамблю дикторов) распределение вероятности измеренных значений вектора х. Изменяя порог ci можно изменять вероятность ошибки, определяемую вероятностями ошибок обоих типов. Задача идентификации диктора существенно отличается от задачи верификации. В этом случае система должна точно указать одного из дикторов среди N дикторов данного множества. Таким образом, вместо однократного сравнения измеряемых параметров с хранимым в системе эталоном необходимо провести N сравнений, Решающее правило в этом случае сводится к выбору такого диктора I, для которого
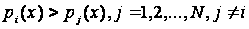 (2.44)
т.е. выбирается диктор с минимальной абсолютной вероятностью ошибки. С увеличением количества дикторов в ансамбле возрастает и вероятность ошибки. поскольку большое число вероятностных распределений в ограниченном пространстве параметров не может не пересекаться. Все более вероятным становится то, что два или более дикторов в общем ансамбле будут иметь распределения вероятностей, которые близки друг к другу. При таких условиях приемлемая идентификация дикторов становится практически невозможной. Приведенный выше анализ позволяет сделать вывод, что между задачами идентификации и верификации имеется много общего и много различий. В каждом случае диктор должен произнести одну или несколько тестовых фраз. По этим фразам проводятся некоторые измерения, и затем вычисляются одна или несколько мер различимости («расстояния») между предъявленным и эталонным векторами. Таким образом, с позиции методов цифровой обработки обе эти задачи сходны. Основное различие возникает на этапе вынесения решений [1,2].
2.3.4 Системы распознавания речи
Как и при распознавании диктора, методы цифровой обработки применяются при распознавании речевого сигнала для получения описания распознаваемого образа, которое затем сравнивается с хранимыми в памяти эталонами. Задача распознавания речевого сигнала состоит в определении того, какое слово, фраза или предложение были произнесены.
В отличие от областей машинного речевого ответа и распознавания диктора, где задача в общем случае достаточно определена, область распознавания слов является одной из тех, где, прежде чем поставить задачу, требуется ввести большое число предположений например:
тип речевого сигнала (изолированные слова, непрерывная речь и т.д.);
число дикторов (система для одного диктора, нескольких дикторов, неограниченного числа дикторов);
тип диктора (определенный, случайный, мужчина, женщина, ребенок);
условия произнесения фраз (звукоизолированное помещение, машинный зал, общественное место);
- система передачи (высококачественный микрофон, узконаправленный микрофон, телефон);
тип и число циклов обучения (без обучения, с ограниченным числом циклов обучения, с неограниченным числом циклов обучения);
размер словаря (малый объем 80—20 слов, средний объем 20-100 слов и большой объем - более 100 слов);
формат произносимых фраз (ограниченный по длительности текст, свободный речевой формат).
Из приведенного перечня условий следует, что при создании систем распознавания речи реализация некоторых из условий может оказаться более предпочтительной.
Существует много способов представления сигнала, которые можно использовать в системах распознавания речи, предоставления, применяемые в системах, инвариантных к диктору, должны быть достаточно устойчивыми. Измерения параметров должны быть простыми и однозначными, а их измеренные значения должны наиболее полно отражать различия в звуках речи. Кроме того, измерения должны допускать достаточно простую интерпретацию с позиций систем, инвариантных к диктору. Во многих таких системах использованы следующие параметры: среднее число переходов через нуль, энергия, коэффициенты линейного предсказания с использованием двухполюсной модели