Моделирование систем массового обслуживания


Разметим граф, т.е. проставим у стрелок интенсивности соответствующих потоков событий. Пусть система находится в состоянии S1. Как только закончится обслуживание заявки, занимающей этот канал, система переходит в состояние S0, интенсивность перехода m. Если занято 2 канала, а не один, то интенсивность перехода составит 2m.
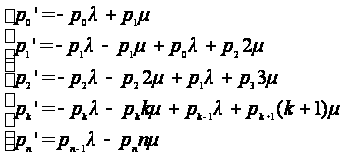
Предельные вероятности состояний p0 и pn характеризую установившийся режим работы системы массового обслуживания при t® Ґ.
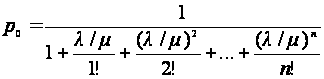
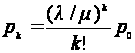
 - среднее
число заявок,
приходящих
в систему за
среднее время
обслуживания
одной заявки.
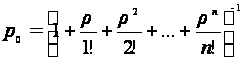

Зная все вероятности состояний p0 , … , pn , можно найти характеристики СМО:
вероятность отказа – вероятность того, что все n каналов заняты
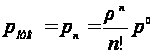
относительная пропускная способность – вероятность того, что заявка будет принята к обслуживанию

среднее число заявок, обслуженных в единицу времени

Полученные соотношения могут рассматриваться как базисная модель оценки характеристик производительности системы. Входящий в эту модель параметр l = 1 / tОБРАБОТКИ, является усредненной характеристикой пользователя. Параметр m является функцией технических характеристик компьютера и решаемых задач.
Эта связь может быть установлена с помощью соотношений, называемых интерфейсной моделью. Если время ввода/вывода информации по каждой задачи мало по сравнению со временем решения задачи, то логично принять, что время решения равно 1 / m и равно отношению среднего числа операций, выполненных процессором при решении одной задачи к среднему быстродействию процессора.
На практике далеко не все случайные процессы являются Марковскими или близкими к ним. В СМО поток заявок не всегда Пуассоновский, ещё реже наблюдается показательное или близкое к нему распределение времени обслуживания.
Для произвольных потоков сообщений, переводящих систему из одного состояния в другое, аналитическое решение получено только для отдельных частных случаев. Когда построение аналитической модели по той или иной причине трудно осуществимо, применяется другой метод моделирования – метод статистических испытаний (Монте-Карло). Широкое распространение метода связано с возможностью его реализации на компьютере.
Идея метода: вместо того, чтобы описывать случайное явление с помощью аналитической зависимости производится «розыгрыш», т.е. происходит моделирование случайного явления с помощью некоторой процедуры, дающей случайный результат. Произведя такой розыгрыш n раз, получаем статистический материал, т.е. множество реализаций случайного явления, которое потом можно обработать обычными методами математической статистики. Метод Монте-Карло предложил Фон-Нейман в 1948 году, как метод численного решения некоторых математических задач.
Суть метода:
Вводим в некотором единичном квадрате любую поверхность S.
Любым получаем 2 числа xi, yi, подчиняющиеся равномерному закону распределения случайной величины на интервале [0, 1].
Полагаем, что одно число определяет координату x, второе – координату y
Анализируем принадлежность точки (x, y) фигуре. Если принадлежит, то увеличиваем значение счетчика на 1.
Повторяем n раз процедуру генерации 2х случайных чисел с заданным законом распределения и проверку принадлежности точки поверхности S.
Определяем площадь фигуры как количество попавших точек, к количеству сгенерированных.
Фон-Нейман
доказал, что
погрешность
 .
Преимущества метода статистических испытаний в его универсальности, обуславливающей возможность всестороннего статистического исследования объекта, однако, для реализации этой возможности нужны довольно полные статистические сведения о параметрах элементов.
К недостаткам относится большой объем требуемых вычислений, равный количеству обращений к модели. Поэтому вопрос выбора величины n имеет важнейшее значение. Уменьшая n – повышаем экономичность расчетов, но одновременно ухудшаем их точность.
Способы получения последовательностей случайных чисел
На практике используются 3 основных способа генерации случайных чисел:
аппаратный (физический)
табличный (файловый)
алгоритмический (программный)Аппаратный способ.
Случайные числа вырабатываются специальной электронной приставкой (генератором случайных чисел). Реализация этого способа не требует дополнительных вычислительных операций по выбору случайных чисел. Необходимо только оперативное обращение к ВУ.
В качестве физического эффекта, лежащего в основе генератора, чаще всего используют шуму в электронных приборах.
Простейшие алгоритмы генерации последовательности псевдослучайных чисел
Одним из первых способов получения является выделение значения дробной части у многочлена первой степени:
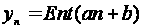
Если n пробегает значения натурального ряда числе, то поведение yn выглядит весьма хаотично.
К. Якоби доказал, что при рациональном коэффициенте a множество y конечно, а при иррациональном – бесконечно и всюду плотно в интервале [0, 1].
Критерий равномерности распределения любой функции: свойство эргамичности – среднее по реализациям псевдослучайное число равно среднему по всему их множеству с вероятностью 1.
1946 год, Фон Нейман.Каждое последующее случайное число образуется возведением в квадрат предыдущего и отбрасывание цифр с обоих концов. Способ оказался ненадежным.
Лемер.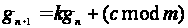 .
Для подборов
коэффициентов
k, c, m
были потрачены
десятки лет.
Подбор почти
иррациональных
чисел ничего
не дает.
Разумнее ввести вычисления с целыми числами.
при c = 0 и m = 2n наибольший период достигается при k=3+8i или k=5+8i и при нечетном начальном числе.
Для имитации равномерного распределения на [a, b] используется обратное преобразование функции плотности вероятности.
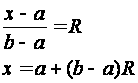
где R – равномерно распределенное псевдослучайное число на [0, 1].
В основе построения программы генерации случайной числа с законом распределения, отличным от равномерного, лежит метод преобразования последовательности случайных чисел с равномерным законом распределения в последовательность случайных чисел с заданным законом распределения.
Метод основан на том, что случайная величина x принимает значения, равные корню уравнения
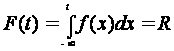
, имеет плотность распределения f(x). R – случайная величина, равномерно распределенная на [0, 1].
Значение случайной величины, распределенной по показательному закону может быть вычислено из данного уравнения следующим образом:
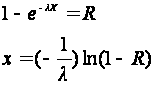
Распределение Пуассона относится к числу дискретных (переменная может принимать лишь целочисленные значения, включая 0, с математическим ожиданием и дисперсией l > 0). Для генерации Пуассоновских переменных можно использовать метод точек, в основе которого лежит генерируемое случайное значение Ri , равномерно распределенное на [0, 1], до тех пор, пока не станет справедливым
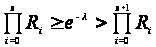
При получении случайной величины, функция распределения которой не позволяет найти решение уравнения
в явной форме, можно произвести кусочно-линейную аппроксимацию, а затем вычислить приближенное значение корня. Кроме того, при получении случайной величины часто используют те или иные свойства распределений.
Воспользуемся этим методом, чтобы сгенерировать случайную величину с законом распределения Эрланга. Распределение Эрланга характеризуется параметрами l и k.
При вычислении случайно величины воспользуемся тем, что поток Эрланга может быть получен путем прорешивания потока Пуассона k раз. Поэтому, достаточно получить k значений случайной величины распределенной по показательному закону и усреднить их.
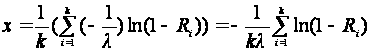
Нормальное распределение случайной величины может быть получено как сумма большого числа случайных величин, распределенных по одному и тому же закону распределения с одними и теми же параметрами.
Случайная величина X имеющая нормальное распределение с математическим ожиданием MX и среднеквадратичным отклонением sX может быть получена по следующей формуле:
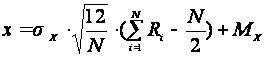
Для сокращения вычислений на практике принимаю N=12, что дает вполне относительно хорошее приближение к нормальному распределению.
Немарковские случайные процессы, сводящиеся к марковским
Реальные процессы часто обладают последствием и поэтому не являются марковскими. Иногда при исследовании таких процессов удается воспользоваться методами, разработанными для марковских процессов. Наиболее распространены два способа:
Метод разложения случайного процесса на фазы (метод псевдосостояний)
Метод вложенных цепей МарковаМетод псевдосостояний
Суть метода состоит в том, что состояния системы, потоки переходов из которых являются немарковскими, заменяются эквивалентной группой фиктивных состояний, потоки переходов из которых являются марковскими.
Условие статистической эквивалентности реального состояния и соответствующих ему фиктивных состояний в каждом конкретном случае выбирается по-разному. В качестве одного из критериев эквивалентности можно принять следующее условие:
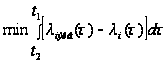
, где li экв(t) – эквивалентная интенсивность перехода в i-той группе переходов, заменяемой реальный переход обладающей интенсивностью li(t).
За счет расширения числа состояний системы, некоторые процессы удается точно свести к марковским. Созданная таким образом новая система по своим характеристикам статистически эквивалентна или близка реальной системе, но она должна быть обязательно подвергнута обычному исследованию на адекватность, с помощью хорошо проработанного математического аппарата с использованием уравнений Колмогорова.
К числу процессов, которые введением фиктивных состояний можно точно свести к марковским, относятся процессы, происходящие в системе под воздействием потока Эрланга.
В случае потока Эрланга k-го порядка интервал времени между сообщениями представляет собой сумму k независимых случайных интервалов распределенных по показательному закону. Поэтому сведение потока Эрланга k-го порядка к Пуассоновскому осуществляется введением k псевдосостояний. Интенсивности перехода между псевдосостояниями равны соответствующему параметру потока Эрланга.
Полученная таким образом эквивалентный случайный процесс является марковским, т.к. интервалы времени нахождения его в различных состояниях подчинены показательному закону распределения.
Пример.
Некоторое
устройство
S выходит из
строя с интенсивностью
l, причем
поток отказов
Пуассоновский.
После отказа
устройство
восстанавливается.
Время восстановления
распределено
по закону Эрланга
3-го порядка с
функцией плотности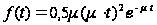 .
Найти предельные
вероятности
возможных
состояний
системы.
Система S может принимать два состояния:
S0 – устройство исправно
S1
– устройство
отказало и
восстанавливается

 S0
а
S1 – Пуассоновский
поток
 S1
а
S0 – поток Эрланга
Представим случайное время восстановления в виде суммы 3х интервалов, распределенных по показательному закону с интенсивностью m:

S1 заменяем эквивалентной цепочкой из трех псевдосостояний.




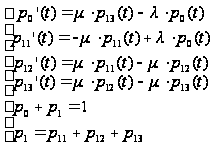
Последние 2 уравнения являются условием нормировки и условием эквивалентности замены состояния S1 псевдосостояниями.
Метод вложенных цепей Маркова.
Вложенные марковские цепи образуются следующим образом: в исходном случайном процессе выбираются такие моменты времени tk, в которых значения характеристик процесса образует марковскую цепь. Моменты времени tk обычно являются случайными и зависят от свойств самого процесса. Исходный процесс исследуется в выбранные моменты времени с помощью стандартных методов теории массового обслуживания.
Частным случаем вложенных цепей Маркова, являются полумарковские случайные процессы. Случайный процесс с конечным или счетным множеством состояний называется полумарковским, если заданны вероятности перехода системы из одного состояния в другое и распределение времени пребывания процесса в каждом состоянии (в виде функции распределения F(t) или в виде плотности распределения f(t))
Классификация систем массового обслуживания
В общем случае СМО классифицируется по следующим признакам:
закону распределения входного потока
числу обслуживающих приборов
закону распределения времени обслуживания в обслуживающих приборах
числу мест в очереди
дисциплине обслуживания
При определении любой системы обслуживания для сокращенной записи используется следующая система кодировки, в которой на месте букв ставится соответствующая характеристика СМО:
A | B | C | D | E
|
A |
Закон распределения интервалов времени между поступлением заявок. |
M – экспоненциальный E – Эрланга H – гиперэкспоненциальный Г – гамма-распределение D – детерминированное распределение G – произвольное распределение |
|
B |
Закон распределения времени обслуживания в приборах СМО. | |
|
C |
Число обслуживающих приборов. |
1 – для одноканальных систем l – для многоканальных систем |
|
D |
Число мест в очереди. Если число мест не ограничено, то поле можно опустить. |
r либо n – для конечного числа мест |
|
E |
Дисциплина обслуживания. По умолчанию LIFO – в этом случае поле может опускаться. |
FIFO, LIFO, RANDOM |
Примеры.
M | M | 1
СМО с одним обслуживающим прибором, бесконечной очередью, экспоненциальным законом распределения интервалов времени между поступлением заявок и временем обслуживания и дисциплиной обслуживания FIFO.
E | H | l | r | LIFO
CМО с несколькими обслуживающими приборами, конечной очередью, законом распределения Эрланга интервалов между поступлением заявок, гиперэкспоненциальным законом распределения времени обслуживания заявок в приборах и дисциплиной обслуживания LIFO.
G | G | l
СМО с несколькими приборами, бесконечной очередью, произвольными законами распределения времени между поступлением заявок и времени обслуживания, FIFO.
Для моделирования вычислительной системы наиболее часто используются следующие типы СМО:
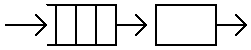
Одноканальная СМО с ожиданием.один обслуживающий прибор с бесконечной очередью
является наиболее распространенной при моделировании
может заменить практически любой узел вычислительной системы или ЛВС
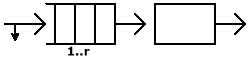
Одноканальная СМО с потерями.один обслуживающий прибор с конечным числом мест в очереди
если число заявок превышает число мест в очереди, то лишние заявки теряются
используется при моделировании каналов передач данных в ВС и ЛВС
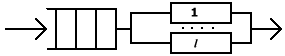
Многоканальная СМО с ожиданием.несколько параллельно работающих обслуживающих приборов с общей бесконечной очередью
используется при моделировании групп абонентских терминалов, работающих в диалоговом режиме
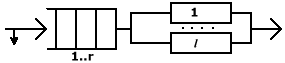
Многоканальная СМО с потерями.несколько параллельно работающих обслуживающих приборов с общей очередью, число мест в которой ограничено
часто используется, как и (2), при исследовании каналов связи
Одноканальная СМО с групповым поступлением заявокодин обслуживающий прибор с бесконечной очередью
перед обслуживанием заявки группируются в пакеты по определенном признаку или правилам
используется для моделирования центров коммутации
Одноканальная СМО с групповым обслуживанием заявокодин обслуживающий прибор с бесконечной очередью
заявки обслуживаются пакетами, составленными по определенному правилу
используется для моделирования центров коммутации
|
Наименование |
Обозначение |
Схема |
| Одноканальная с ожиданием |
G | G | 1 |
|
| Одноканальная с потерями |
G | G | 1 | r |
|
| Многоканальная с ожиданием |
G | G | l |
|
| Многоканальная с потерями |
G | G | l | r |
|
| Одноканальная с групповым поступлением заявок |
Gr | G | 1 r |
|
| Одноканальная с групповым обслуживанием заявок |
G | Gr | 1 r |
|
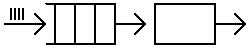
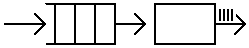
Вычислительные сети в целом могут быть представлены в виде СМО. Различают следующие типы сетей:
Открытые
Замкнутые
СмешанныеОткрытой называется СМО, состоящая из m узлов, причем хотя бы в один из узлов сети поступают извне входной поток заявок и обязательное имеется хотя бы один сток заявок из сети.
Для открытой системы характерно то, что интенсивность поступления заявок в сеть не зависит от состояния сети, т.е. от числа заявок уже поступивших в сеть. Такие сети как правило используются для моделирования ВС, работающих в неоперативном режиме.
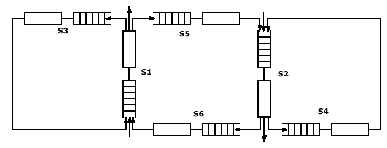
S1, S2 – моделируют работу узлов коммутации
S3, S4 – моделируют работу серверов
S5, S6 – моделируют работу межузловых каналов
В сети циркулируют 2 потока заявок. Каждая заявка поступает на вход соответствующего узла коммутатора, где определяется место её обработки. Затем заявка передается на свой сервер или по каналу связи на соседний сервер, где обрабатывается. После чего, возвращается к источнику и покидает сеть.
Замкнутой называется СМО с множеством узлов m без источника и стока, в которой циркулирует постоянное число заявок.
Замкнутые СМО используются для моделирования таких ВС, источником информации для которых служат абонентские терминалы, работающие в диалоговом режиме. В этом случае каждая группа абонентских терминалов представляется в виде многоканальной СМО с ожиданием и включается в состав устройств сети.
Простой режим работы диалоговых абонентов: абонент не производит никаких действий, кроме посылки заданий в ВС и обслуживания полученного ответа.
S01, S02 – группа абонентских терминалов
S7, S8 – каналы связи с абонентами
S1, S2 – узлы коммутации
S3, S4 – серверы
S5, S6 – каналы межузловой связи
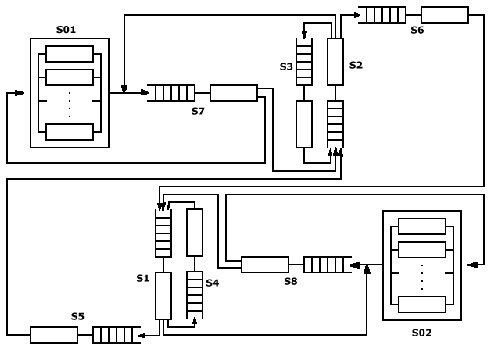
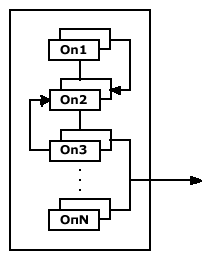
Абоненты с терминалов посылают запросы, которые по каналам связи поступают на узлы коммутатора, а оттуда на обработку на свой или соседний сервер.
При сложном режиме диалога работа абонентов представляется в виде совокупности операций некоторого процесса, называющимся технологическим. Каждая операция технологического процесса моделируется соответствующей СМО. Причем, часть операций может предусматривать обращение к ВС, а другая часть может замыкаться сама на себя.
Схема представленная на рисунке находится на месте S01 и S02.
Cмешанной называется СМО, в которой циркулируют несколько различных типов заявок (трафика). Причем относительно одних типов заявок сеть замкнута, а относительно других – открыта.
С помощью смешанных сетей моделируются такие ВС, часть абонентов которых работает в диалоговом режиме, а часть в неоперативном. Для диалоговых абонентов различают также простой и сложный режимы работы. Часто смешанные СМО используются в сетях, в которых сервер дополнительно загружается задачами, решаемыми на фоне работы самой сети.
48